Cohere เปิดตัว Parse (v5.0) โมเดล Vision Language 2.3B เปลี่ยนเอกสารองค์กรเป็น Markdown แม่นยำสูงtag: Cohere, LlamaIndex, Markdown, Parse v5.0, RAG, Vision-Language ModelAug 29, 2026 · By: NatapolKCohere เปิดตัว Parse (v5.0) โมเดลขนาด 2.3 พันล้านพารามิเตอร์ที่เปลี่ยนไฟล์ PDF สไลด์ และรูปภาพเป็น Markdown พร้อมรองรับตาราง HTML และการระบุพิกัดวัตถุ ในราคาเริ่มต้น 1.50 ดอลลาร์ต่อ 1,000 หน้า
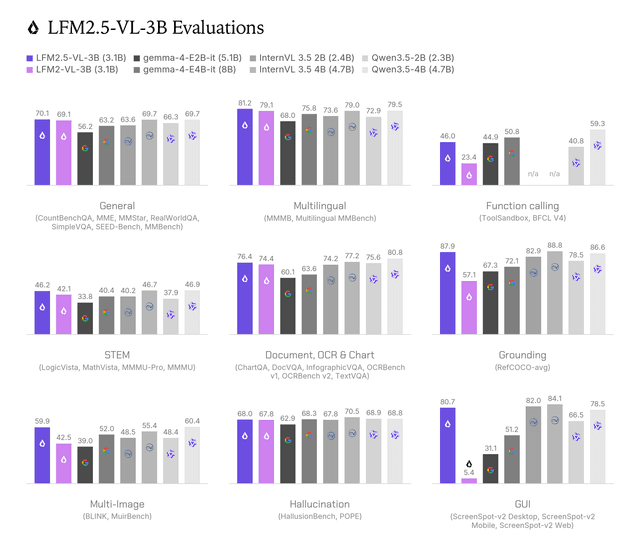
Liquid AI เปิดตัว LFM2.5-VL-3B โมเดล Vision ขนาดเล็ก 3B ที่อ่านหน้าจอและเรียกใช้เครื่องมือได้ในตัวtag: LFM2.5-VL-3B, Liquid AI, Machine Learning, On-device AI, Vision-Language ModelAug 14, 2026 · By: SirilukPLiquid AI เปิดตัวโมเดล vision-language ขนาด 3.1 พันล้านพารามิเตอร์ ออกแบบมาเพื่อทำงานบนอุปกรณ์โดยเฉพาะ โดดเด่นด้านการวิเคราะห์หน้าจอ UI การระบุพิกัดวัตถุ และการเรียกใช้ฟังก์ชันที่มีประสิทธิภาพสูงขึ้น
Liquid AI เปิดตัว LFM2.5-VL-3B โมเดล Vision-Language ไซส์จิ๋วแต่ทรงพลังสำหรับ Edge Devicetag: Edge AI, LFM2.5-VL-3B, Liquid AI, On-device AI, Open-Source, Vision-Language ModelAug 12, 2026 · By: SirilukPLiquid AI เผยโฉม LFM2.5-VL-3B โมเดล Vision-Language ขนาด 3 พันล้านพารามิเตอร์ ชูจุดเด่นด้านการประมวลผลบนอุปกรณ์ที่รวดเร็วแบบเรียลไทม์ พร้อมความสามารถในการเข้าใจหน้าจอและเรียกใช้เครื่องมือที่เหนือกว่าคู่แข่งในระดับเดียวกัน