
รู้จัก LEANN: Vector Index ชูจุดเด่นลดพื้นที่จัดเก็บ RAG ได้ถึง 97%
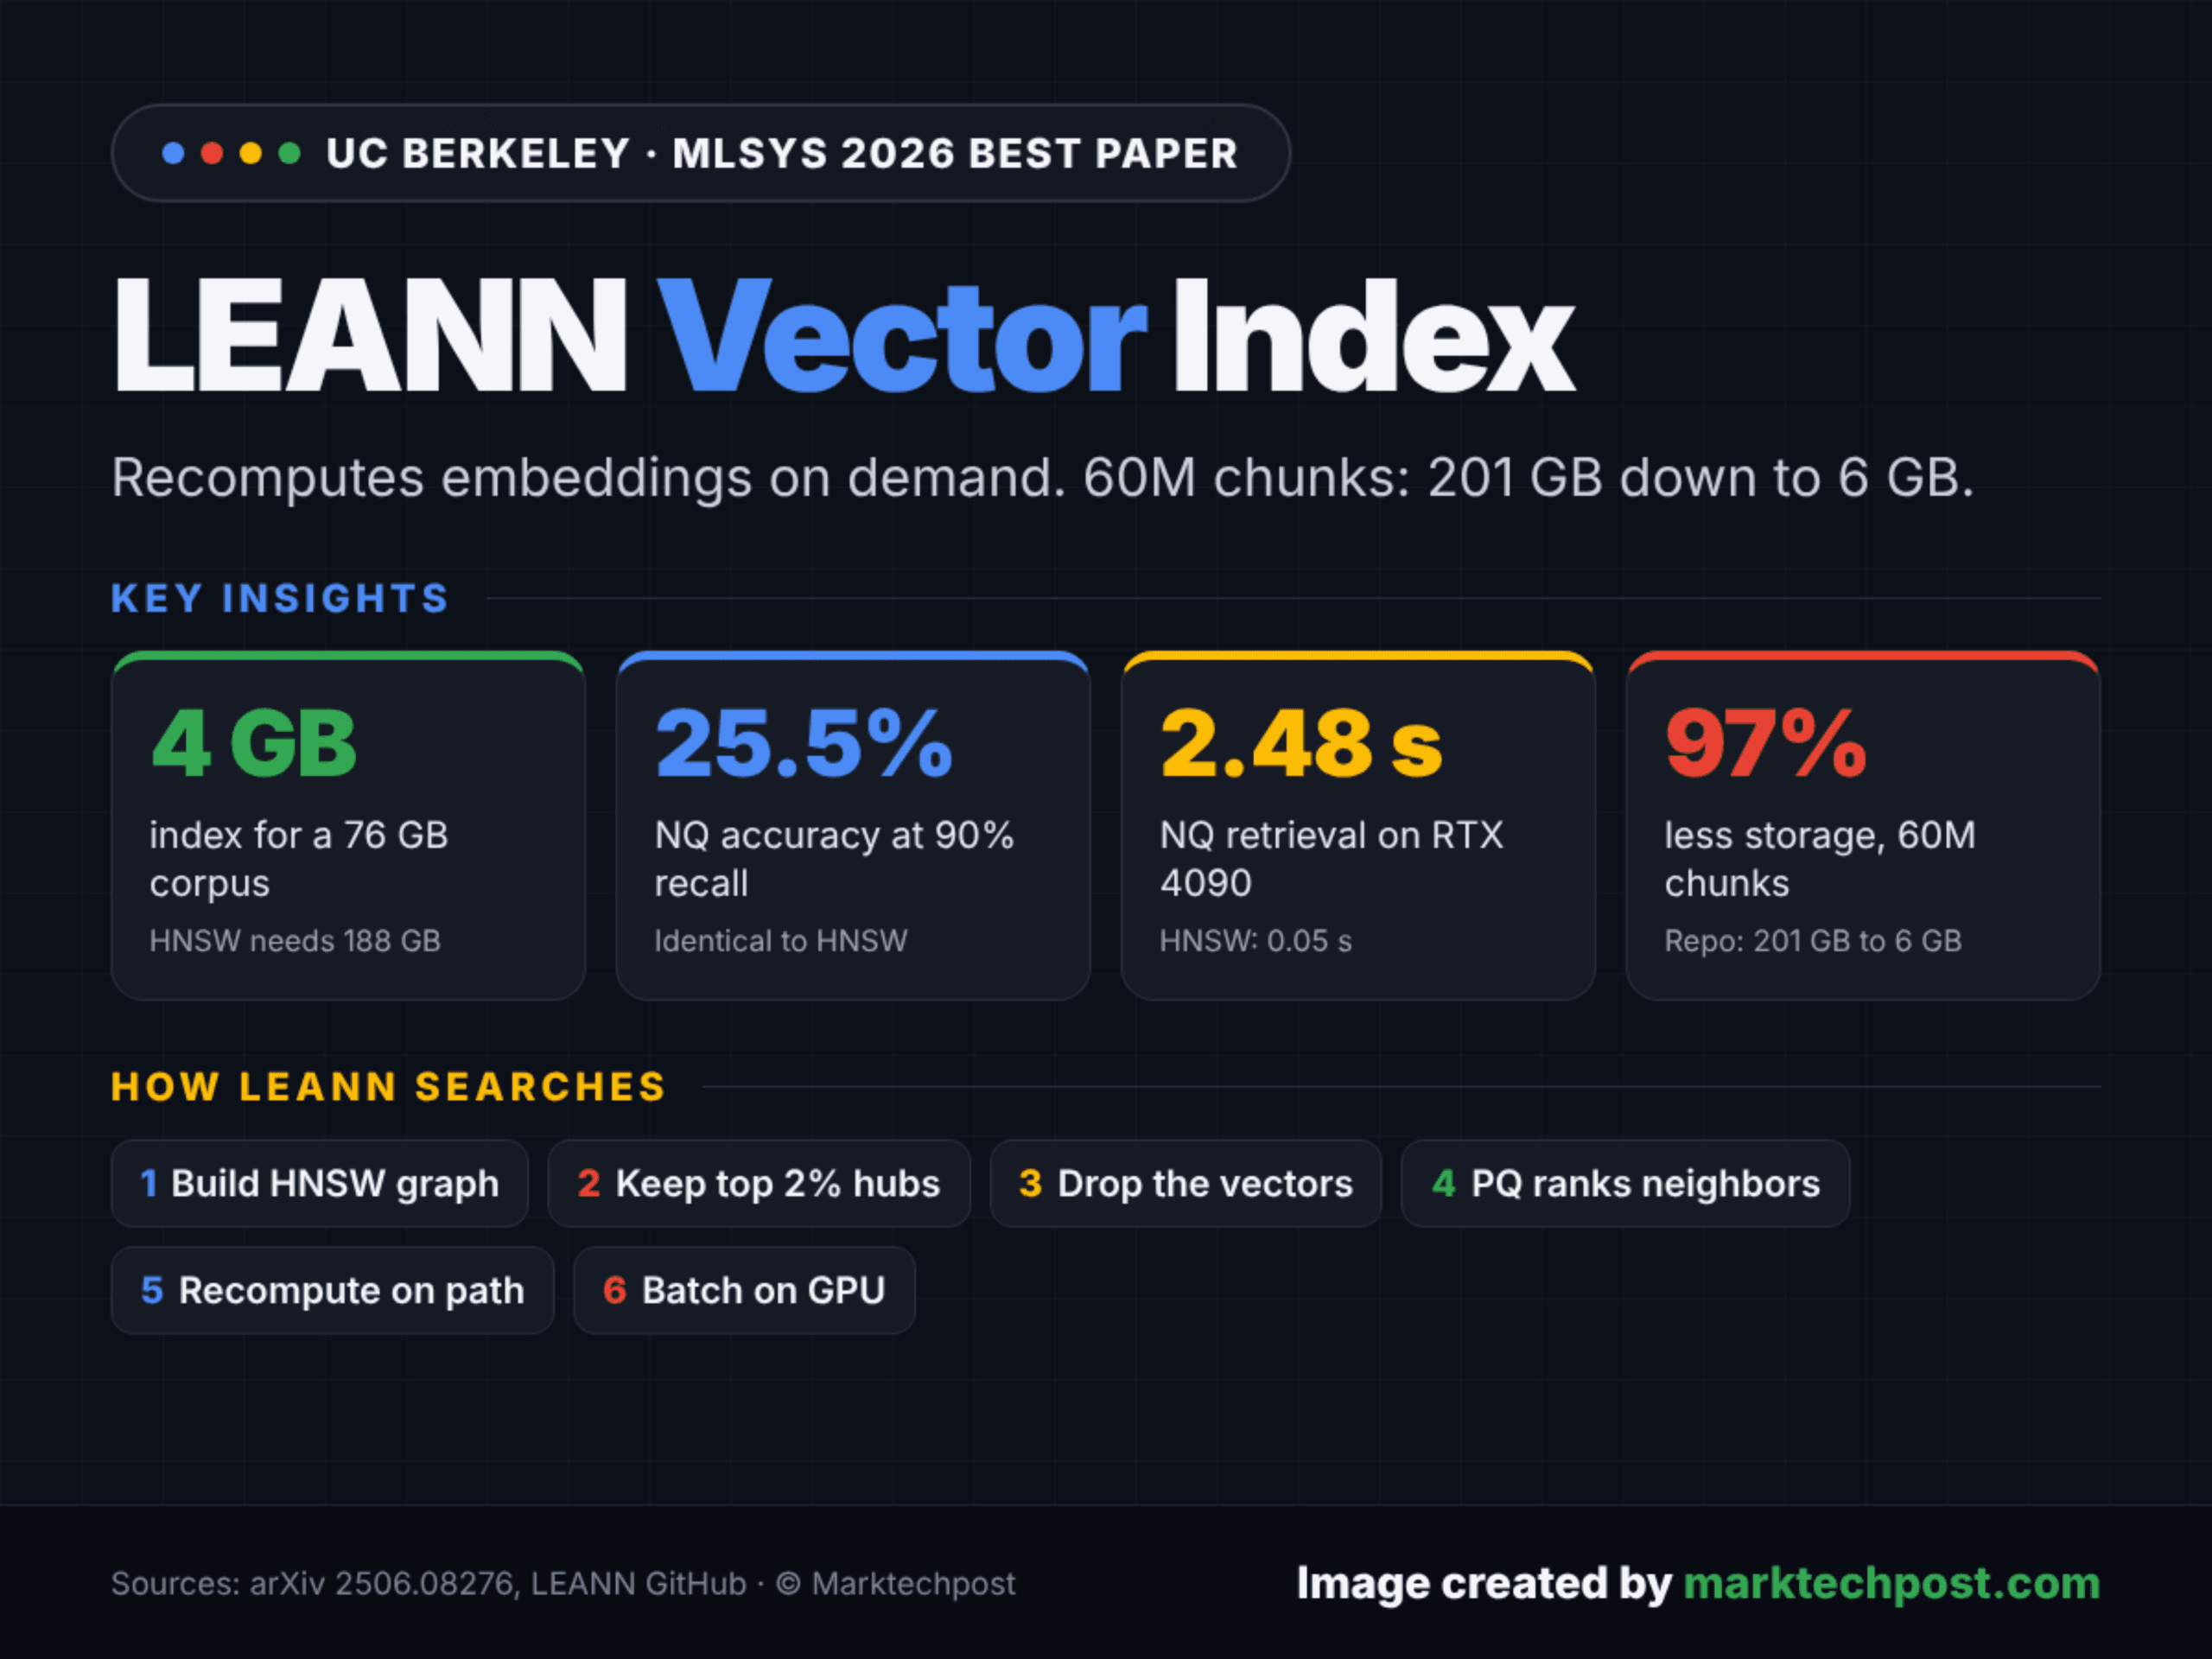
Sky Computing Lab จาก UC Berkeley เปิดตัว LEANN (Low-storage Embedding-Agnostic Nearest Neighbor) ซึ่งเป็น Vector Index แบบโอเพนซอร์สที่แหวกแนวด้วยการแทบไม่เก็บ Embeddings ไว้ในระบบ แต่ใช้วิธีคำนวณใหม่ในขณะทำการค้นหา (Query Time) แทนการบันทึกลงดิสก์
ผลการทดสอบประสิทธิภาพพบว่าดัชนีของ Wikipedia ขนาด 60 ล้าน Chunk สามารถลดขนาดลงจาก 201 GB เหลือเพียง 6 GB งานวิจัยชิ้นนี้ยังได้รับรางวัล Best Research Paper จากงาน MLSys 2026 ซึ่งถือเป็นกุญแจสำคัญที่ช่วยให้การทำ Semantic Search และ RAG บนข้อมูลส่วนตัวทำได้ง่ายขึ้นผ่านแล็ปท็อปทั่วไป
TL;DR
- ขนาด: ลดลงเหลือ 6 GB สำหรับ 60 ล้าน Chunk (ตาม Repo) หรือ 4 GB สำหรับข้อมูล Wikipedia 76 GB ในงานวิจัย โดยใช้ Contriever (110M params) เป็นตัว Embedder เริ่มต้น
- การรองรับ: ใช้งานได้บนแล็ปท็อปและ Workstation ผ่านการทดสอบบน RTX 4090 (RAM 32 GB) และ M1 Ultra Mac รวมถึงรองรับ Linux แบบใช้ CPU
- ประสิทธิภาพ: ให้ความแม่นยำเท่ากับ HNSW ที่ 90% Recall โดยใช้พื้นที่จัดเก็บน้อยกว่า 5% ของข้อมูลดิบ
- จุดเด่น: สามารถทำความแม่นยำ NQ ได้ 25.5% เท่ากับ HNSW แต่ใช้พื้นที่เพียง 4 GB แทนที่จะเป็น 188 GB
- ข้อจำกัด: การค้นหาข้อมูล HotpotQA ใช้เวลา 44.80 วินาทีบนเครื่อง Mac ซึ่งคิดเป็นครึ่งหนึ่งของเวลาใน Pipeline ทั้งหมด
LEANN คืออะไร?
LEANN คือดัชนีสำหรับ Approximate Nearest Neighbor (ANN) ที่เน้นประหยัดพื้นที่จัดเก็บ พัฒนาต่อยอดจาก FAISS โดยมุ่งแก้ปัญหา Vector Index ที่มักมีขนาดใหญ่กว่าตัวข้อมูลจริง งานวิจัยชี้ให้เห็นว่าคลังข้อมูลขนาด 76 GB อาจต้องการ Embedding ถึง 173 GB และ HNSW Graph อีก 15 GB ซึ่งรวมแล้วใหญ่กว่าข้อมูลดิบถึง 2 เท่า
LEANN จะเก็บเฉพาะ Graph ที่ผ่านการตัดแต่ง (Pruned Graph) และตัด Vector ตัวเต็มออกเพื่อสร้างใหม่ตามความต้องการเท่านั้น ตัวโปรเจกต์ใช้ลิขสิทธิ์ MIT และติดตั้งง่ายผ่านคำสั่ง uv pip install leann
LEANN คำนวณ Embeddings ใหม่โดยไม่ทำให้การค้นหาหยุดชะงักได้อย่างไร?
กลไกของ Graph Index อย่าง HNSW จะตรวจสอบเฉพาะชุดโหนดเพียงไม่กี่ชุดต่อหนึ่งคำถาม LEANN จึงใช้ประโยชน์จากจุดนี้ด้วยการเก็บ Graph คู่กับตาราง Product Quantization (PQ) ขนาดเล็ก และจะทำ Re-embed เฉพาะโหนดที่อยู่บนเส้นทางการค้นหาเท่านั้น
เทคนิคหลัก 3 ประการที่ทำให้ระบบทำงานได้จริงประกอบด้วย:
- Two-level search: ใช้ระยะทางจาก PQ ที่ประหยัดทรัพยากรเพื่อจัดลำดับเพื่อนบ้านก่อน จากนั้นจึงคำนวณเฉพาะตัวเลือกอันดับต้นๆ แบบละเอียด (Exact Recomputation)
- Dynamic batching: นำตัวเลือกจากหลาย Hop มาจัดกลุ่ม (เช่นครั้งละ 64 ตัว) เพื่อดึงประสิทธิภาพสูงสุดจาก GPU
- High-degree preserving pruning: เก็บเส้นทางเชื่อมต่อ (Edges) ของโหนดส่วนใหญ่ไว้เพียงไม่กี่เส้น แต่จะคงเส้นทางจำนวนมากไว้ในโหนดที่เป็นกลุ่ม "Hub" ชั้นนำ 2%
จากการทดสอบพบว่า Two-level Search ช่วยเพิ่มความเร็วได้ 1.4 เท่า และเมื่อใช้ร่วมกับ Batching จะเร็วขึ้นเป็น 1.8 เท่า อย่างไรก็ตาม การคำนวณ Embedding ใหม่ยังคงครองสัดส่วนเวลาถึง 76% ของความหน่วงในการค้นหา
ประสิทธิภาพของ LEANN บน Benchmark
ทีมวิจัยทดสอบกับชุดข้อมูล NQ, TriviaQA, GPQA และ HotpotQA บนคลังข้อมูล RPJ-Wiki ขนาด 60 ล้าน Passage โดยวัดผลที่ 90% Recall@3
ในชุดข้อมูล NQ เมื่อใช้ร่วมกับ Qwen3-4B บน RTX 4090 พบว่าทั้ง LEANN และ HNSW ทำความแม่นยำได้ 25.5% เท่ากัน แต่ LEANN ใช้พื้นที่เพียง 4 GB ขณะที่ HNSW ต้องใช้ถึง 188 GB อย่างไรก็ตามแลกมาด้วยเวลาค้นหาที่เพิ่มขึ้นจาก 0.05 วินาที เป็น 2.48 วินาที ส่งผลให้ความหน่วงรวม (End-to-End) เพิ่มจาก 20.95 วินาที เป็น 23.34 วินาที
นอกจากนี้ใน GitHub ยังรายงานการประหยัดพื้นที่กับข้อมูลส่วนตัว เช่น ข้อความแชท 400,000 ข้อความ ลดพื้นที่จาก 1.8 GB เหลือ 64 MB และประวัติเบราว์เซอร์ลดจาก 130 MB เหลือ 6.4 MB
LEANN เปรียบเทียบกับ vector index อื่นๆ
| คุณสมบัติ | LEANN | HNSW (FAISS) | DiskANN | IVF-Recompute | PQ compression |
|---|---|---|---|---|---|
| แนวทาง | Pruned graph, recompute on demand | Graph พร้อม vectors ทั้งหมดใน RAM | Graph และ vectors บน SSD | IVF clusters, recompute on demand | Compressed vectors พร้อม graph |
| พื้นที่ (คลังข้อมูล 76 GB) | 4 GB | 188 GB | 270 GB | ต่ำกว่า 5% ของข้อมูลดิบ | 20 GB |
| ความหน่วง NQ (RTX 4090) | 2.48 s | 0.05 s | 0.03 s | 307.61 s | ไม่ถึง 90% Recall |
| ความแม่นยำ NQ | 25.5% | 25.5% | ไม่ระบุ | ไม่ระบุ | 17.9% |
| รองรับ RAM 32 GB | ใช่ | ไม่ใช่ (OOM) | ใช่ | ใช่ | ใช่ |
การนำไปใช้งานสำหรับนักพัฒนา
ปัจจุบันมีแอปพลิเคชันที่รองรับ LEANN แล้วมากมาย ทั้งการค้นหาในเอกสาร, Apple Mail, Chrome History, WeChat, iMessage และการจัดการข้อมูลจาก ChatGPT/Claude นอกจากนี้ยังสามารถรันเป็น Semantic Search MCP Server สำหรับ Claude Code ได้
ระบบรองรับการสร้างคำตอบร่วมกับ Ollama, Hugging Face และ API ของ OpenAI โดยใช้งานได้บน Ubuntu, Arch, WSL, macOS และ Windows (บางฟีเจอร์จำกัดเฉพาะ macOS) ช่วยให้การพัฒนา AI Agent บนเครื่องท้องถิ่นมีประสิทธิภาพและประหยัดทรัพยากรมากขึ้นอย่างมีนัยสำคัญ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร