
Liquid AI เปิดตัว LFM3 ตระกูลโมเดล 2B แบบ Open-Weight ถึง 6 รุ่น
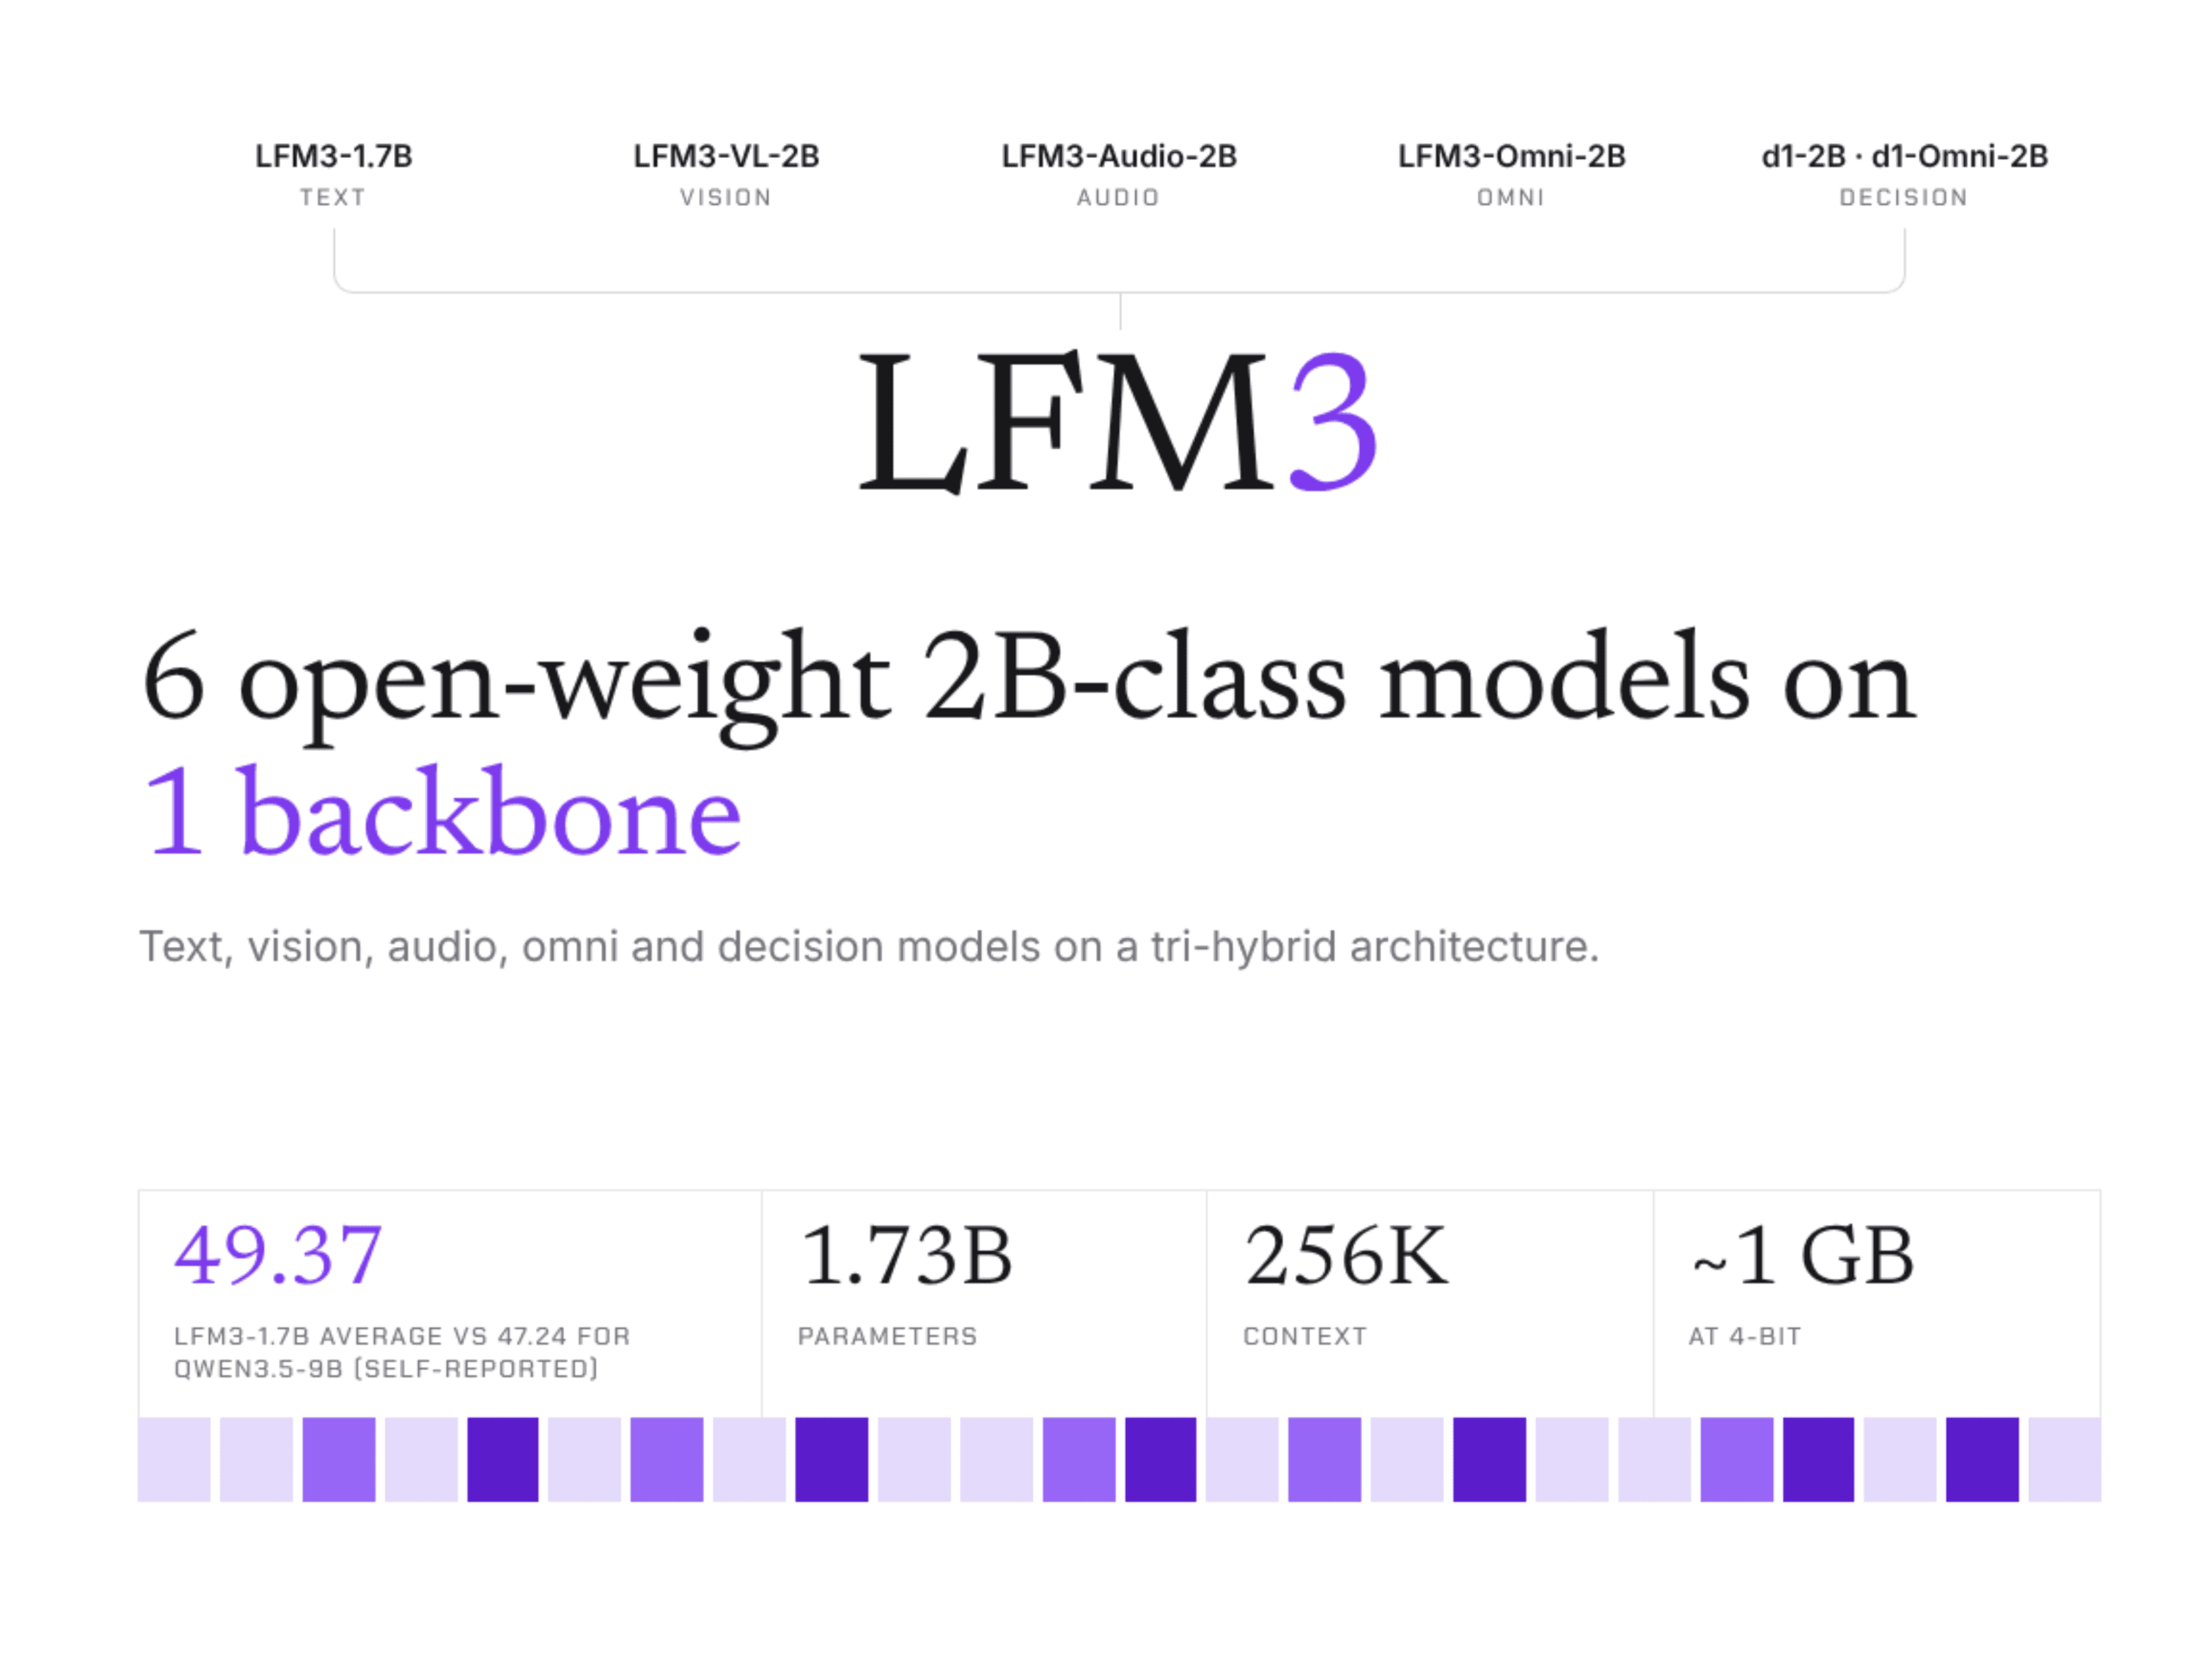
Liquid AI เปิดตัว LFM3 เจเนอเรชันล่าสุดของ Liquid Foundation Models ซึ่งเป็นตระกูลโมเดลขนาด 2B แบบ open-weight จำนวน 6 รุ่นที่พัฒนาขึ้นบนโครงสร้างหลักชุดเดียวกัน โดยครอบคลุมการใช้งานที่หลากหลายตั้งแต่ข้อความ (text), ภาพ (vision), เสียง (audio), omni ไปจนถึงการตัดสินใจ (decision)
จุดเด่นของ LFM3 คือความคล่องตัวที่สามารถทำ fine-tune ได้ด้วย GPU เพียงตัวเดียว ช่วยให้นักพัฒนาปรับใช้โมเดลบนอุปกรณ์ที่หลากหลายได้สะดวก ไม่ว่าจะเป็นสมาร์ทโฟน แล็ปท็อป เซิร์ฟเวอร์ส่วนตัว หรือระบบคลาวด์ โดยรองรับรูปแบบ checkpoint ทั้ง GGUF, MLX, ONNX, FP8 และ NVFP4 เพื่อการใช้งานที่ยืดหยุ่น
ในด้านประสิทธิภาพ LFM3-1.7B ทำคะแนนเฉลี่ย 49.37 จาก 29 benchmark ซึ่งสูงกว่า Qwen3.5-9B ที่ทำได้ 47.24 จากการประเมินของ Liquid เอง โดยเฉพาะใน IFEval ที่ได้คะแนนสูงถึง 96.66 และ AutomationBench ที่ทำได้ 41.29 คะแนน อย่างไรก็ตาม ในด้านความรู้ทั่วไปอย่าง Humanity’s Last Exam (แบบไม่ใช้เครื่องมือ) และ RULER 128K ยังคงมีประสิทธิภาพตามหลังโมเดลคู่แข่งอยู่
Liquid AI LFM3 คืออะไร?
LFM3 คือตระกูลโมเดล multimodal ที่แตกแขนงออกมา 6 รุ่นจากฐานเริ่มต้นเดียวกันคือ LFM3-1.7B-Base ประกอบด้วย:
- LFM3-1.7B: โมเดลข้อความสำหรับ local agents ที่รองรับเฟรมเวิร์กอย่าง Hermes Agent, Pi และ OpenClaw
- LFM3-VL-2B: โมเดล vision รุ่นแรกที่รองรับวิดีโอ ประมวลผลที่ 2 fps
- LFM3-Audio-2B: รองรับ input และ output เสียง 18 ภาษา พร้อมความสามารถ tool calling
- LFM3-Omni-2B: รวมภาพ เสียง และภาษาไว้ในหนึ่งเดียว สามารถตอบโต้ได้ทั้งข้อความและคำพูด
- d1-2B และ d1-Omni-2B: โมเดลด้านการตัดสินใจที่ตอบคำถามหลายข้อได้ในการประมวลผล (forward pass) เพียงครั้งเดียว
สถาปัตยกรรม tri-hybrid ทำงานอย่างไร?
โครงสร้างหลักของ LFM3 ผสมผสาน 3 operator เข้าด้วยกันใน 24 เลเยอร์ ได้แก่ gated short convolutions 13 เลเยอร์, sliding-window attention (SWA) 5 เลเยอร์ และ global attention 6 เลเยอร์ โดยมีขนาดหน้าต่าง SWA อยู่ที่ 256 tokens และมีการขยายขนาด convolution kernels จาก 3 เป็น 7
ทีม Liquid AI พัฒนาส่วนผสมนี้ผ่านการค้นหาสถาปัตยกรรมแบบ hardware-in-the-loop โดย LFM3 ถูกปรับจูนผ่านอุปกรณ์และ backend ถึง 14 รูปแบบ ซึ่งรวมถึง Raspberry Pi 5 และ Qualcomm Hexagon NPU เพื่อให้มั่นใจว่าทำงานได้ดีบนฮาร์ดแวร์ที่หลากหลาย
นอกจากนี้ยังมีการปรับปรุงทางเทคนิค เช่น การใช้ head-wise sigmoid gates บน attention และ partial RoPE บนเลเยอร์ global โดยโมเดลผ่านการเทรนด้วย 22T tokens ซึ่งในช่วง 3.5T tokens สุดท้ายเน้นการฝึกฝนด้าน agent โดยเฉพาะ ทำให้สามารถขยาย context window ได้กว้างถึง 256K
ประสิทธิภาพของ LFM3-1.7B บน Benchmark
Liquid AI ระบุว่า LFM3-1.7B สามารถเอาชนะ LFM2.5-2.6B ได้แม้มีพารามิเตอร์น้อยกว่าถึง 35% โดยเฉพาะงานด้าน agent ที่ทำคะแนนใน WebArena-Verified ได้ 38.42 และ BFCL V4 ได้ 71.39 คะแนน ซึ่งสูงกว่า Qwen3.5-9B ในทั้งสองการทดสอบ
อย่างไรก็ดี ขนาดโมเดลที่เล็กยังคงส่งผลต่อความลึกของความรู้และการเขียนโค้ด โดยทำคะแนน GPQA Diamond ได้ 63.37 และ SWE-bench Verified ที่ 43.40 ซึ่งยังน้อยกว่า Qwen3.5-9B แต่หากมีการใช้เครื่องมือค้นหาเข้ามาช่วย จะสามารถยกระดับคะแนนในบางการทดสอบให้สูงขึ้นได้เกือบเท่าตัว
ความสามารถด้าน Vision, Audio และ Decision
LFM3-VL-2B ทำคะแนนเฉลี่ย 71.4 จาก 62 vision benchmarks ซึ่งใกล้เคียงกับโมเดลขนาดใหญ่อย่าง Gemma 4 12B โดยโดดเด่นมากในเรื่อง visual grounding และการทำความเข้าใจ GUI ส่วน LFM3-Audio-2B ก็มีอัตราความผิดพลาดของคำพูด (WER) ต่ำเพียง 6.2 ขณะที่โมเดลตัดสินใจอย่าง d1-2B ก็ทำคะแนนได้ดีขึ้นในพารามิเตอร์ที่น้อยลง
แนวทางการใช้งานสำหรับนักพัฒนา
นักพัฒนาสามารถดาวน์โหลด weights ได้ทาง Hugging Face, Liquid AI Playground และ Liquid API โดยรองรับรันไทม์ยอดนิยมอย่าง llama.cpp, MLX, vLLM, SGLang, Ollama และ Transformers
สำหรับการใช้งานบนอุปกรณ์พกพา LFM3-1.7B ใช้หน่วยความจำเพียง 1 GB ที่ระดับ 4-bit และใช้ KV cache เพียง 1.6 GB สำหรับ context 128K ซึ่งประหยัดทรัพยากรกว่าโมเดลคู่แข่งอย่างเห็นได้ชัด นอกจากนี้ยังสามารถนำไปปรับแต่งเฉพาะทางได้อย่างรวดเร็ว เช่น การฝึกฝนเพื่อจำแนกข้อบกพร่องของกังหันลมที่ใช้เวลาเพียงไม่กี่ชั่วโมงบน GPU A100 เครื่องเดียว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร