
7 สุดยอดเครื่องมือและ API สำหรับ Web Crawling แห่งปี 2026
Crawling ไม่ใช่ Scraping
หลายคนมักสับสนระหว่าง web scraping กับ web crawling แต่ทั้งสองอย่างมีความแตกต่างกัน โดยทั่วไป Web scraping จะเน้นการดึงเนื้อหาจากหน้าเว็บเฉพาะเจาะจงตาม URL ที่ระบุ เพื่อแปลงข้อมูลให้อยู่ในรูปแบบที่สะอาดขึ้น
ในขณะที่ Web crawling ทำงานได้ลึกกว่านั้น เพียงแค่ระบุ URL เริ่มต้น เครื่องมือจะติดตามลิงก์ต่างๆ ทั่วทั้งเว็บไซต์เพื่อรวบรวมเนื้อหาจากหน้าที่เกี่ยวข้องทั้งหมด เหมาะอย่างยิ่งสำหรับการดึงข้อมูลเอกสาร (documentation), หน้ารายการสินค้า หรือบทความในศูนย์ช่วยเหลือที่กระจายอยู่หลายหน้า
Web crawling ในยุคปัจจุบันเริ่มเปลี่ยนผ่านสู่ความเป็น AI-native มากขึ้น แทนที่จะดึงเพียงลิงก์หรือ HTML ดิบ เครื่องมือสมัยใหม่รองรับทั้งการใช้ prompt, การดึงข้อมูลแบบมีโครงสร้าง (structured extraction) ไปจนถึงการส่งออกไฟล์ในรูปแบบ Markdown หรือ JSON เพื่อรองรับ pipeline แบบ retrieval-augmented generation (RAG) และ AI agents ได้ทันที
บทความนี้จะพาไปทำความรู้จักกับ 7 สุดยอดเครื่องมือและ API สำหรับ web crawling ในปี 2026 ซึ่งมีทั้งแบบ managed API, เครื่องมือ AI-native และเฟรมเวิร์กโอเพนซอร์ส
1. Olostep
Olostep คือตัวเลือกอันดับหนึ่งที่น่าสนใจ เนื่องจาก Crawling API สามารถเริ่มต้นจาก URL เดียวแล้วติดตามหน้าย่อยที่เชื่อมต่อกันทั้งหมดเพื่อคืนค่าเนื้อหาที่สะอาด พร้อมใช้งานสำหรับ RAG หรืองานวิจัยข้อมูลแบบมีโครงสร้างโดยไม่ต้องดึงข้อมูลทีละหน้าด้วยตัวเอง
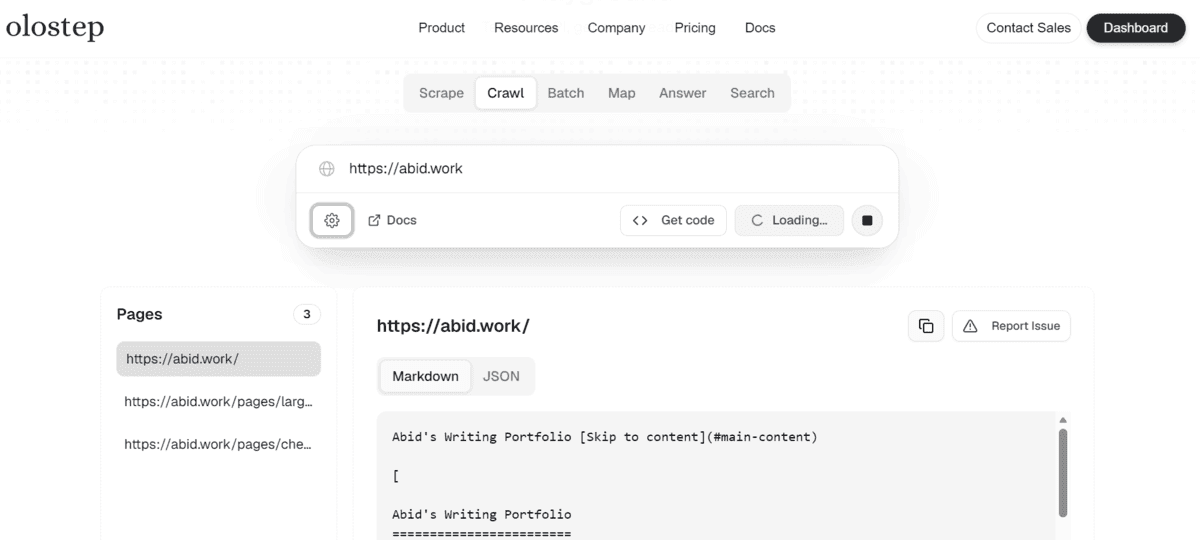
ภาพหน้าจอจาก Olostep Playground
จากการทดสอบเปรียบเทียบกับผู้ให้บริการรายอื่น Olostep โดดเด่นในเรื่องความคุ้มค่า ความเร็ว และความแม่นยำ โดยเฉพาะการจัดการข้อมูลจากบล็อกหรือหน้าสินค้าที่มีข้อมูลกระจายอยู่จำนวนมาก
นอกจากนี้ Olostep ยังรองรับ model context protocol (MCP) และ CLI ทำให้เชื่อมต่อกับเครื่องมือนักพัฒนาอย่าง Claude Code, Cursor หรือ VS Code ได้อย่างราบรื่น
เหมาะสำหรับ: การ crawl ทั้งเว็บไซต์ในราคาประหยัด, งานวิจัยข้อมูล, RAG pipelines และเวิร์กโฟลว์ AI ที่ต้องการขยายขนาด
2. Firecrawl
Firecrawl เป็นหนึ่งใน crawling API ที่มีชื่อเสียงที่สุดในวงการ AI โดยเน้นความง่ายในการใช้งาน เพียงระบุ URL เริ่มต้น ระบบจะทำการ crawl หน้าที่เชื่อมต่อกันและแปลงเนื้อหาให้เป็นฟอร์แมตที่พร้อมใช้งานกับ LLM ทันที
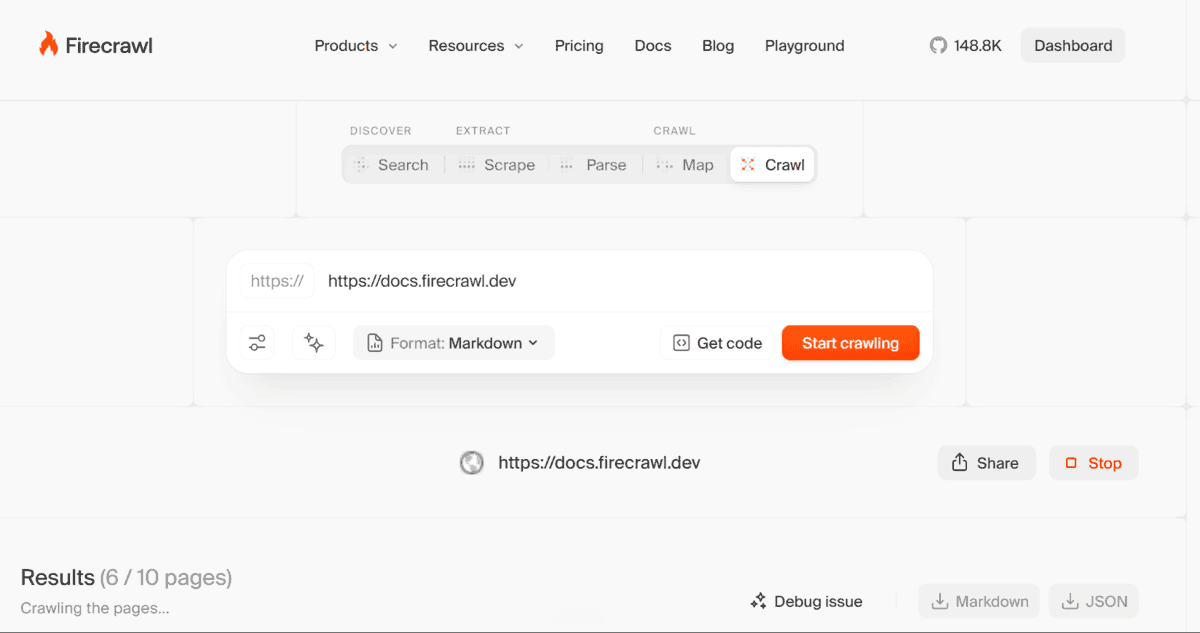
ภาพหน้าจอจาก Firecrawl
เครื่องมือนี้ช่วยลดภาระในการสร้าง crawler เองสำหรับไซต์เอกสารคู่มือหรือฐานความรู้ ผลลัพธ์ที่ได้มีความสะอาดสูง เหมาะสำหรับระบบค้นหาภายในและ AI agents
แม้ว่า Olostep จะมีราคาที่ย่อมเยากว่าในการทดสอบบางรายการ แต่ Firecrawl ก็ยังคงทำผลงานได้ดีเยี่ยมและในบางกรณีอาจมีความเร็วหรือความแม่นยำที่สูงกว่า ขึ้นอยู่กับโครงสร้างของเว็บไซต์นั้นๆ
เหมาะสำหรับ: การดึงข้อมูลเอกสารคู่มือ, ไฟล์ Markdown ที่สะอาด, RAG pipelines และ AI agents
3. ScrapeGraphAI
ScrapeGraphAI เป็นทางเลือกที่แข็งแกร่งสำหรับผู้ที่ต้องการเครื่องมือแบบโอเพนซอร์สเพื่อรันในเครื่อง (local) โดยใช้ตรรกะแบบ graph-based ร่วมกับ LLM ในการดึงข้อมูลจากเว็บไซต์และไฟล์ต่างๆ เช่น HTML, XML และ JSON
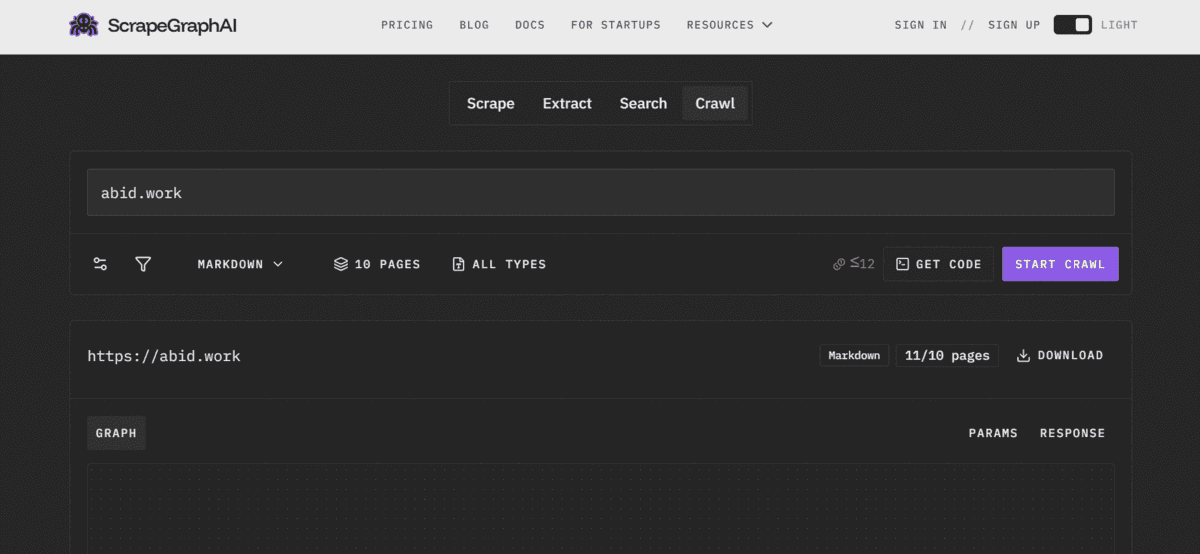
ภาพหน้าจอจาก ScrapeGraphAI Playground
ข้อควรพิจารณาคือผู้ใช้ต้องเตรียม LLM มาเอง ไม่ว่าจะเป็นการเชื่อมต่อผ่าน API ของ OpenAI, Gemini หรือรันผ่าน Ollama ในเครื่อง ซึ่งแม้จะยุ่งยากในการตั้งค่ามากกว่าเครื่องมือแบบ managed แต่ก็แลกมาด้วยการควบคุมที่เบ็ดเสร็จ
เหมาะสำหรับ: การ crawling แบบโอเพนซอร์ส, การ scraping ด้วย AI ในเครื่อง และการสร้าง custom pipelines
4. Scrapling
Scrapling คือเฟรมเวิร์ก web crawling บน Python ที่โดดเด่นด้วยระบบ adaptive parser ซึ่งสามารถเรียนรู้และปรับตัวตามการเปลี่ยนแปลงเลย์เอาต์ของเว็บไซต์ได้ ทำให้ crawler มีความทนทานไม่พังง่าย
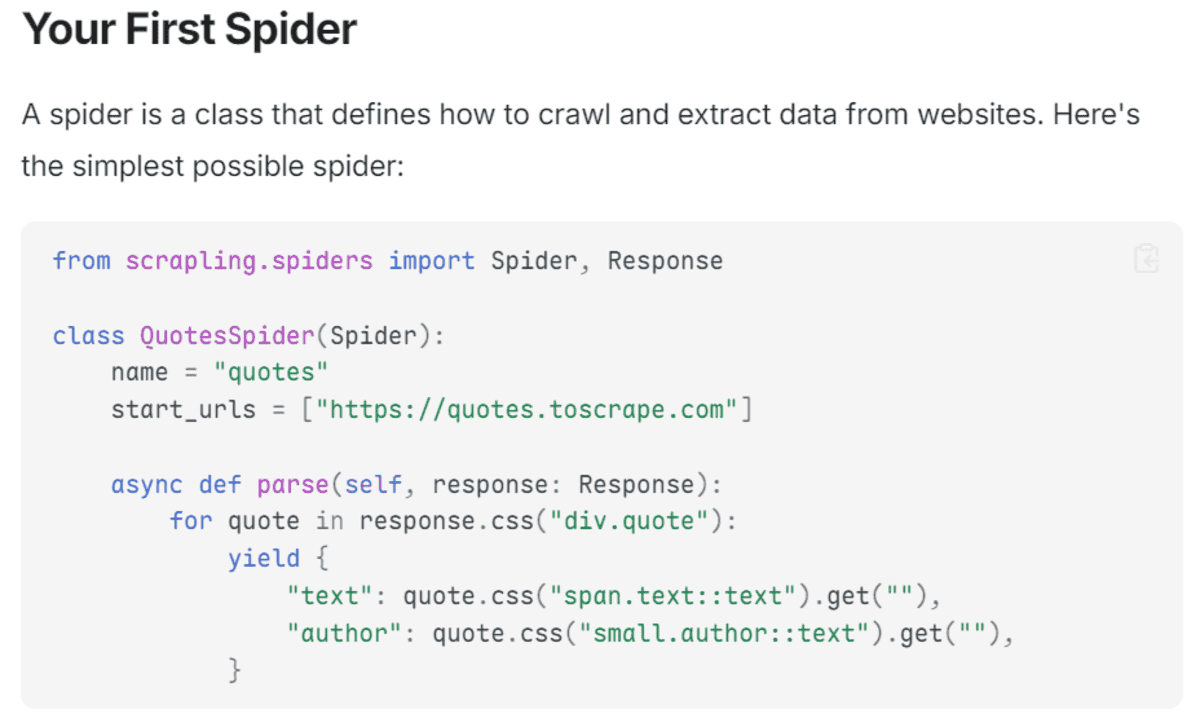
ภาพหน้าจอจาก Getting started - Scrapling
ฟีเจอร์เด่นประกอบด้วยการ crawling พร้อมกัน, ระบบหยุดและเริ่มงานใหม่ได้ (resume) รวมถึงการสลับ proxy อัตโนมัติ เหมาะสำหรับนักพัฒนาที่ต้องการเฟรมเวิร์กที่ยืดหยุ่นและจัดการทุกอย่างได้เอง
เหมาะสำหรับ: นักพัฒนา Python, งาน adaptive scraping และการจัดการ pipeline ข้อมูลเว็บด้วยตัวเอง
5. Crawl4AI
Crawl4AI เป็นเครื่องมือโอเพนซอร์สฟรีที่ออกแบบมาเพื่อเวิร์กโฟลว์ AI โดยเฉพาะ โดยสามารถแปลงเว็บไซต์ให้เป็น Markdown ที่พร้อมสำหรับ LLM ได้อย่างรวดเร็ว
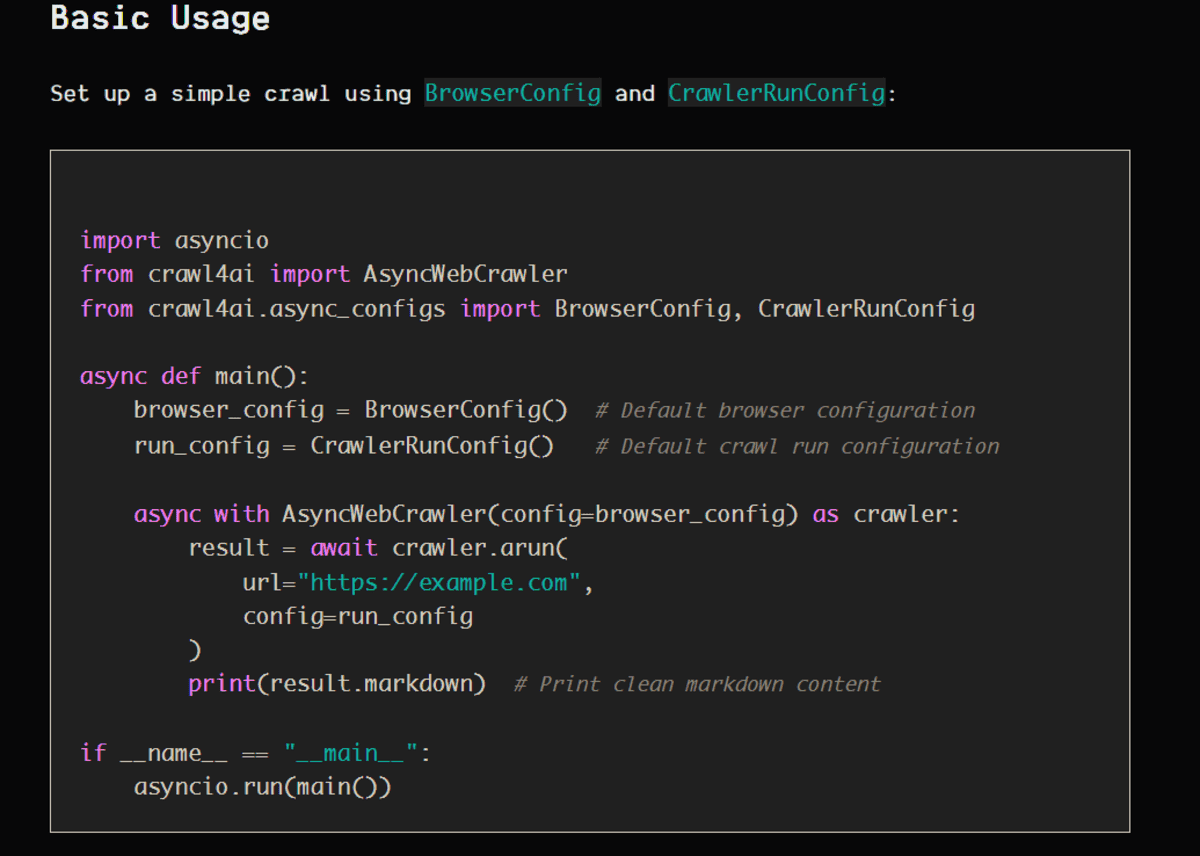
ภาพหน้าจอจาก Simple Crawling
เครื่องมือนี้ให้อิสระในการควบคุมสูง ทั้งการเรนเดอร์เบราว์เซอร์ การใช้พร็อกซี และการดึงข้อมูลผ่าน CSS หรือ XPath อย่างไรก็ตาม ผู้ใช้จำเป็นต้องมีความรู้ในการจัดการโครงสร้างพื้นฐานและการปรับขนาดการใช้งานด้วยตนเอง
เหมาะสำหรับ: การ crawling แบบ self-hosted และการสร้างชุดข้อมูลสำหรับ RAG pipelines
6. Scrapy
Scrapy คือหนึ่งในเฟรมเวิร์กที่เสถียรที่สุดสำหรับ Python ซึ่งถูกใช้งานมาอย่างยาวนาน เหมาะสำหรับการสร้าง crawler เฉพาะทางที่เน้นโครงสร้างข้อมูลที่ซ้ำเดิมและต้องการประสิทธิภาพในระดับโปรดักชัน
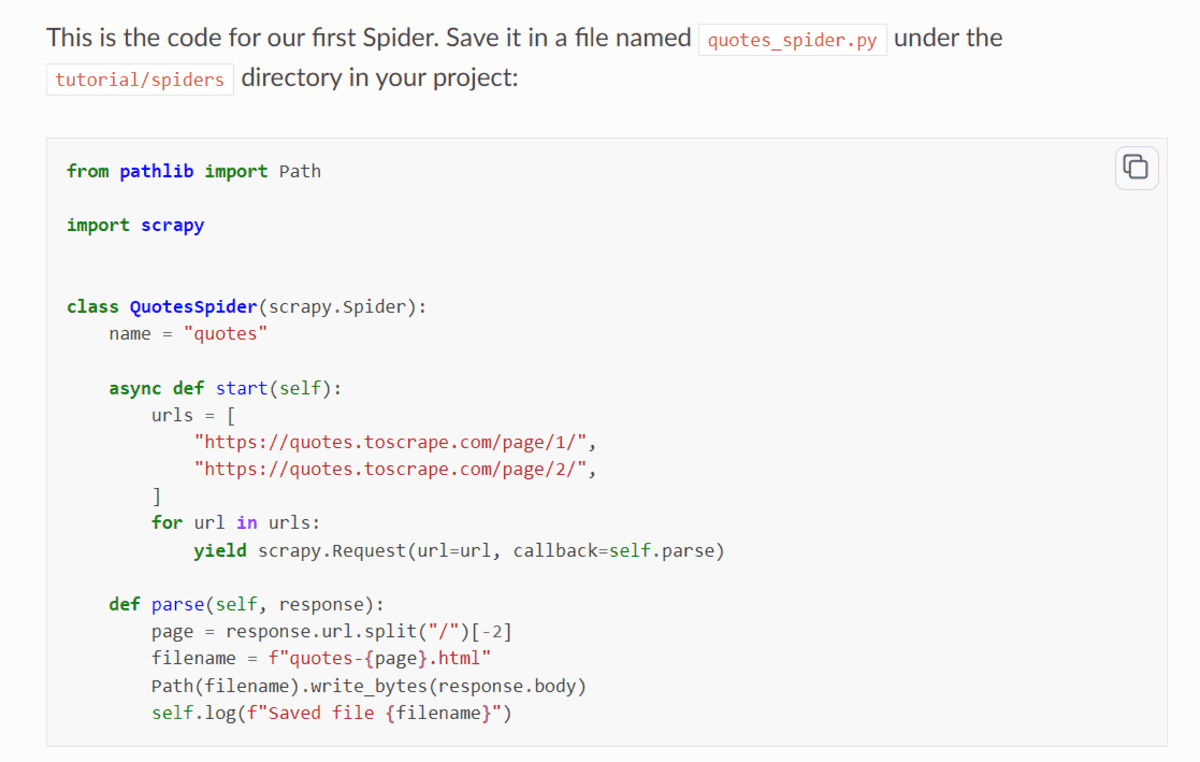
ภาพหน้าจอจาก Scrapy Tutorial
จุดด้อยเพียงอย่างเดียวคือไม่ได้เป็น AI-native ตั้งแต่เริ่ม หากต้องการผลลัพธ์ที่พร้อมสำหรับ AI หรือ Markdown ที่สะอาด ผู้ใช้อาจต้องเขียนโค้ดเพิ่มเลเยอร์ LLM เข้าไปเสริมเอง
เหมาะสำหรับ: การดึงข้อมูลขนาดใหญ่ระดับมืออาชีพ และทีมที่ต้องการควบคุมทุกขั้นตอนอย่างละเอียด
7. Crawlee
Crawlee เป็นห้องสมุดโอเพนซอร์สที่รองรับทั้ง JavaScript, TypeScript และ Python โดยเน้นแก้ปัญหาพื้นฐานของการ crawling เช่น คิวการร้องขอ การลองใหม่ (retries) และการเลี่ยงการถูกบล็อกด้วยพร็อกซี
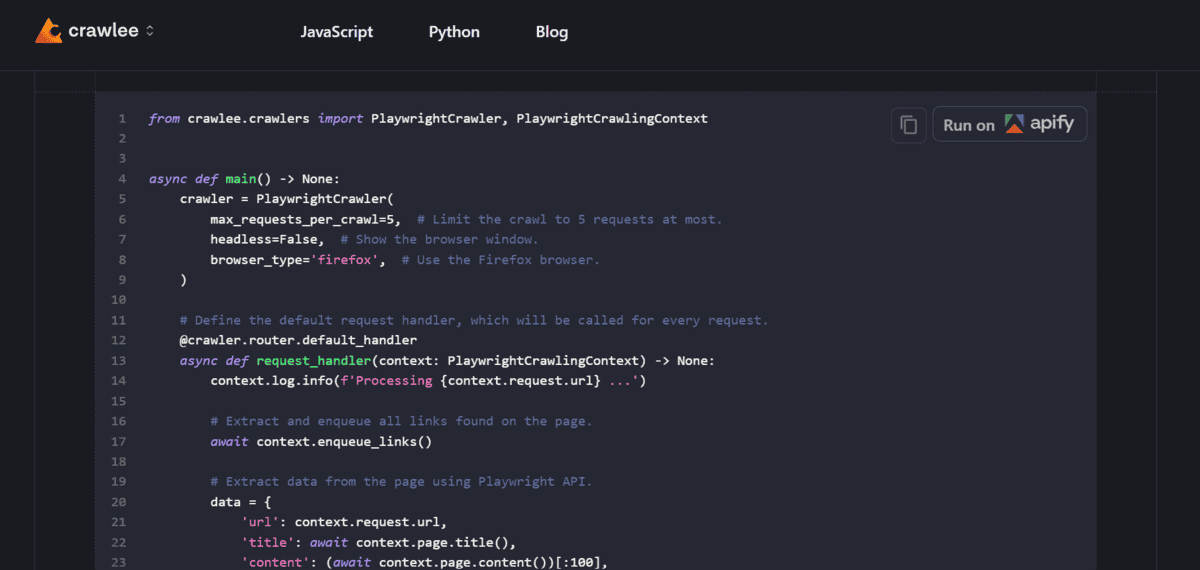
ภาพหน้าจอจาก Crawlee · Build reliable crawlers. Fast.
Crawlee เหมาะสำหรับทีมที่ต้องการสร้าง crawler ของตัวเองแต่ไม่ต้องการเริ่มจากศูนย์ โดยยังคงความยืดหยุ่นในการเขียนโค้ดและจัดการโครงสร้างพื้นฐานเองทั้งหมด
เหมาะสำหรับ: ทีมพัฒนาสาย JS/TS และ Python ที่ต้องการสร้างระบบ crawling ประสิทธิภาพสูงเอง
ความคิดเห็นทิ้งท้าย
การเลือกเครื่องมือที่เหมาะสมขึ้นอยู่กับระดับการควบคุมและงบประมาณของคุณ หากต้องการความเร็วและง่าย Olostep และ Firecrawl คือคำตอบที่ดีที่สุดสำหรับยุค AI
แต่หากคุณให้ความสำคัญกับความเป็นส่วนตัวหรือต้องการประหยัดค่า API เครื่องมือโอเพนซอร์สอย่าง ScrapeGraphAI หรือ Crawl4AI ก็เป็นตัวเลือกที่ยอดเยี่ยม โดยหัวใจสำคัญคือการเลือกเครื่องมือที่ให้ข้อมูลที่สะอาดและรวดเร็วที่สุดเพื่อไม่ให้กลายเป็นคอขวดในเวิร์กโฟลว์ของคุณ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร