
จาก RAG สู่ Agentic AI: วิวัฒนาการสู่ระบบจัดการความรู้ในองค์กรที่ฉลาดและแม่นยำกว่าเดิม
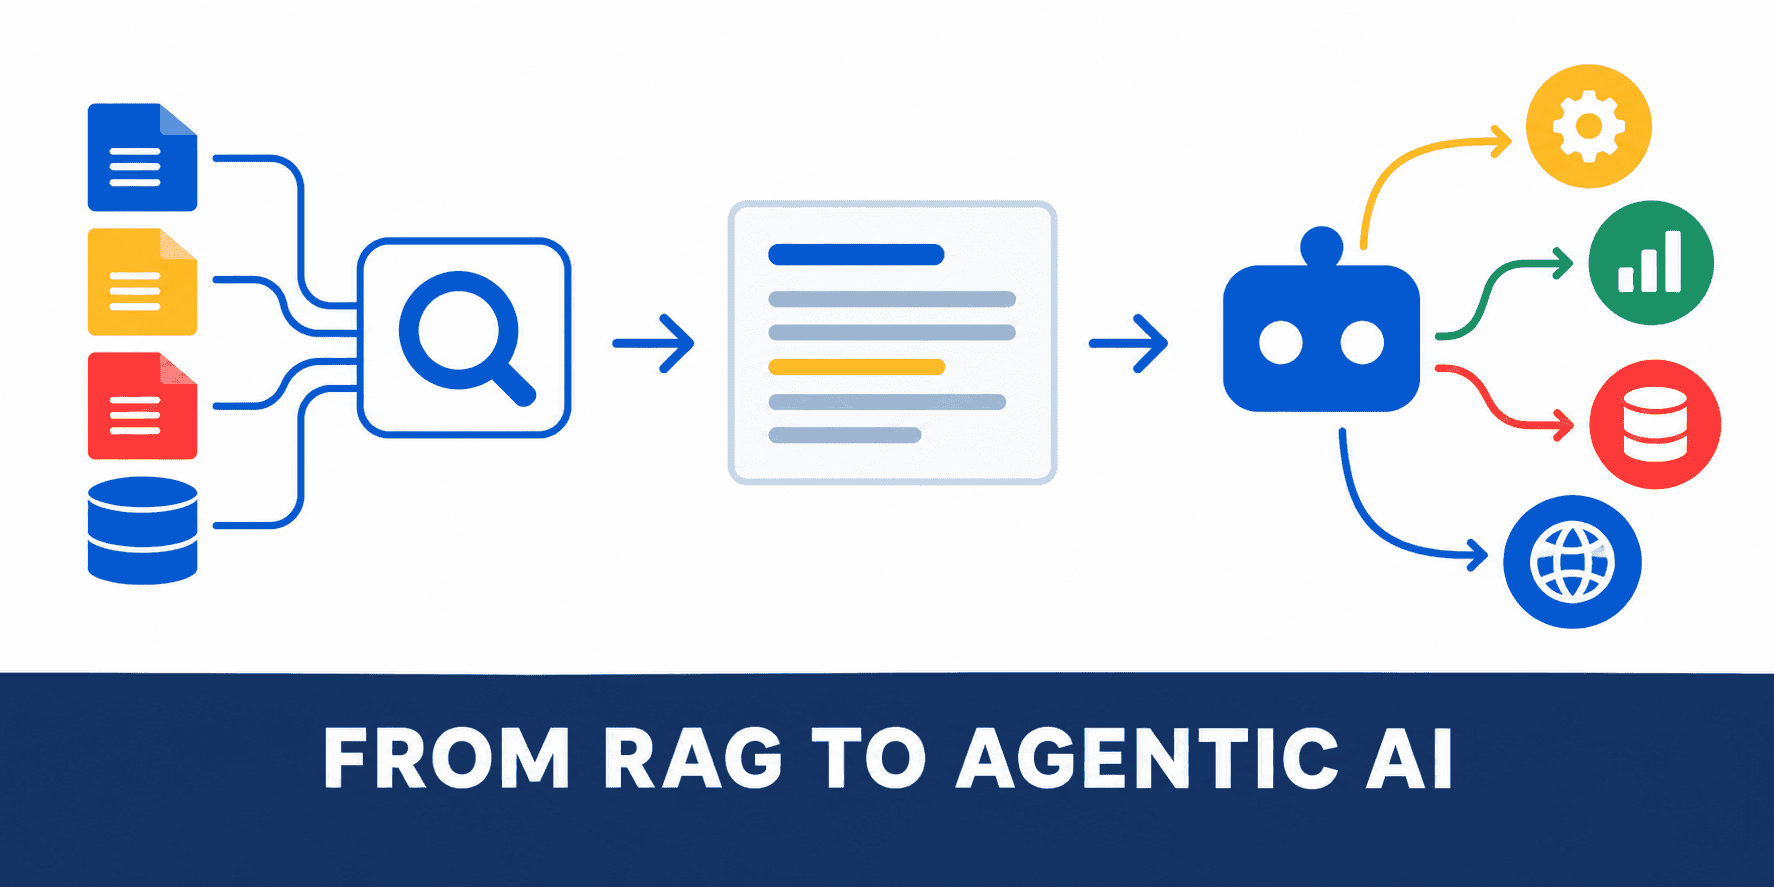
ปัญหาของ "แค่ RAG"
Retrieval-Augmented Generation (RAG) ได้เข้ามาเปลี่ยนโฉมหน้า AI สำหรับองค์กร จากเดิมที่ต้องหวังพึ่งพาความจำของ Large Language Model ระหว่างการฝึกสอน RAG ช่วยให้ AI อ้างอิงคำตอบจากเอกสารภายในได้โดยตรงผ่านกระบวนการทำ Embedding และค้นหาข้อมูลที่คล้ายคลึงกันใน Vector Database วิธีนี้ดูสง่างามและใช้งานได้ดีกับคำถามที่ตรงไปตรงมา
แต่สำหรับระบบระดับองค์กร คำว่า "เพียงพอ" มักจะถึงขีดจำกัดอย่างรวดเร็ว ปัญหาที่พบบ่อยคือระบบ RAG มาตรฐานมักขาดกลไกการขอคำชี้แจงเมื่อเจอคำศัพท์เฉพาะทางที่มีหลายความหมาย อีกทั้งการค้นหาด้วยความคล้ายคลึงของเวกเตอร์เพียงอย่างเดียวอาจพลาดเอกสารสำคัญที่ใช้คำต่างกัน และที่ร้ายแรงที่สุดคือระบบไม่สามารถระบุ "ระดับความมั่นใจ" ของคำตอบได้ ทำให้คำตอบที่ AI ปรุงแต่งขึ้นเอง (Hallucination) ดูน่าเชื่อถือพอๆ กับคำตอบที่มีหลักฐานอ้างอิง
นี่ไม่ใช่กรณีขอบเขตที่เกิดขึ้นนานๆ ครั้ง แต่มันคือความเป็นจริงที่ต้องเจอทุกวันในการทำ AI องค์กร ตลอดหลายปีที่ผ่านมาผมได้พัฒนาระบบการค้นคืนอัจฉริยะมาแล้ว 3 รุ่น โดยแต่ละรุ่นถูกสร้างขึ้นเพื่อปิดจุดอ่อนของรุ่นก่อนหน้า และนี่คือบทเรียนที่สรุปได้ครับ
รุ่นที่หนึ่ง: Hybrid Retrieval — ทำไมวิธีการค้นหาแบบเดียวถึงไม่เคยพอ
การปรับปรุงขั้นแรกเหนือ Vanilla RAG คือการยอมรับว่าไม่มีวิธีการค้นคืนใดที่ตอบโจทย์ได้สมบูรณ์แบบ แม้การค้นหาด้วยเวกเตอร์ (Vector search) จะจับใจความหมายได้ดี เช่น เชื่อมโยงคำว่า "สินค้าขาดสต็อก" กับ "สินค้าคงคลังเป็นศูนย์" ได้ แต่ในโลกขององค์กรที่เต็มไปด้วยรหัสสินค้าและศัพท์เฉพาะ การพลาดการจับคู่คำสำคัญ (Keyword) ที่ตรงเป๊ะอาจนำไปสู่ความล้มเหลว
ทางออกคือการใช้ Hybrid Retrieval ซึ่งเป็นการรัน Vector Search ควบคู่ไปกับ Keyword Search (เช่น BM25) แล้วนำผลลัพธ์มารวมกันอย่างชาญฉลาด แต่การจะทำให้ระบบใช้งานได้จริงในระดับโปรดักชันนั้นมีรายละเอียดทางวิศวกรรมที่สำคัญ ดังนี้:
- การกำจัดข้อมูลซ้ำ (Deduplication) สำคัญกว่าที่คุณคิด: เมื่อค้นหาจากสองระบบ ผลลัพธ์มักทับซ้อนกัน การเชื่อมต่อข้อมูลแบบทื่อๆ จะทำให้เนื้อหาซ้ำซ้อนจนบดบังข้อมูลอื่น เราจึงต้องมีกลยุทธ์กำจัดข้อมูลซ้ำหลายชั้น ทั้งตาม ID, แหล่งที่มา และลายนิ้วมือเนื้อหา (Content fingerprint) เพื่อให้มั่นใจว่าข้อมูลที่จะส่งไปให้ Reranker มีความหลากหลายเพียงพอ
- การรวมอันดับ (Rank fusion) ต้องใช้ความระมัดระวัง: Reciprocal Rank Fusion (RRF) คือมาตรฐานที่ใช้รวมคะแนนจากระบบที่ต่างกันโดยไม่ต้องปรับมาตรฐานคะแนนใหม่ ช่วยให้เอกสารที่ติดอันดับสูงในระบบใดระบบหนึ่งมีโอกาสได้รับเลือกมากขึ้น
- Latency คือฟีเจอร์หนึ่ง: การรันการค้นหาทั้งสองแบบขนานกัน (Asynchronous execution) แทนที่จะทำทีละขั้นตอน สามารถลดความล่าช้าลงได้ถึง 40% หรือมากกว่า ซึ่งสำคัญมากเพราะผู้ใช้จะเลิกใช้งานทันทีหากระบบตอบสนองช้าเกินไป
นอกจากนี้ การใช้ Cross-encoder reranker ในขั้นตอนสุดท้ายจะช่วยกรองความแม่นยำได้ดีกว่าการค้นคืนเพียงอย่างเดียว แต่ถึงกระนั้น แม้การดึงข้อมูลจะสมบูรณ์แบบ ระบบก็อาจยังไม่เข้าใจ "โครงสร้าง" ความสัมพันธ์ของข้อมูลในองค์กร
รุ่นที่สอง: เมื่อ Knowledge Graphs พบกับ RAG
RAG มาตรฐานมักมองชิ้นส่วนเอกสารเป็นเกาะที่โดดเดี่ยว โดยไม่เข้าใจความสัมพันธ์ระหว่างเอนทิตี (Entities) หรือลำดับชั้นของผลิตภัณฑ์ การนำ Knowledge Graph เข้ามาเสริมหรือที่เรียกว่า "GraphRAG" จึงช่วยปิดช่องว่างนี้ได้ โดยมีปัจจัยการออกแบบที่สำคัญสองประการคือ:
การสกัดเอนทิตีแบบ Deterministic เทียบกับ Named Entity Recognition โดยใช้ LLM
แม้บทเรียนส่วนใหญ่จะแนะนำให้ใช้ LLM สกัดเอนทิตี แต่ในความเป็นจริงวิธีนี้มีปัญหาทั้งเรื่อง Latency, ค่าใช้จ่าย API และความไม่แน่นอนของผลลัพธ์ (Non-determinism) ซึ่งทำให้การ Debug ทำได้ยาก การหันกลับมาใช้เทคนิค NLP ดั้งเดิมอย่าง Rule-based multi-pass ที่เน้นการจับคู่คำที่ยาวที่สุดก่อน (Longest-first phrase matching) ให้ผลลัพธ์ที่คงเส้นคงวากว่าในระดับไมโครวินาทีและไม่มีค่าใช้จ่ายเพิ่ม
การค้นคืนที่เสริมด้วยกราฟผ่าน Rank Fusion
เราสามารถให้คะแนนเอกสารตามจำนวนเอนทิตีที่เกี่ยวข้องกับคำถามได้ โดยใช้กลไก RRF รวมสัญญาณจากกราฟเข้ากับคะแนนเวกเตอร์และคำสำคัญ วิธีนี้ช่วยให้เอกสารที่พูดถึงเอนทิตีที่ถูกต้องแม้จะใช้คำต่างออกไปปรากฏขึ้นมาได้ ซึ่งระบบเวกเตอร์เพียวๆ มักจะมองข้าม
สำหรับการใช้งานจริง การจัดการดัชนีข้อมูลแบบ Zero-downtime ผ่านกระบวนการ Delta processing สำหรับการอัปเดต และ Atomic swaps สำหรับการซิงค์ใหม่ทั้งหมด เป็นสิ่งจำเป็นเพื่อให้ระบบยังคงทำงานได้ต่อเนื่องในขณะที่มีการปรับปรุงข้อมูล
รุ่นที่สาม: Agentic AI — ระบบที่รู้จักใช้เหตุผล
ในขณะที่รุ่นก่อนหน้าเน้นการค้นคืน แต่คำถามในองค์กรส่วนใหญ่มักซับซ้อนกว่านั้น เช่น การเปรียบเทียบข้อมูลหรือการวางแผนแก้ไขปัญหา สถาปัตยกรรมแบบ Agentic จึงเข้ามาแทนที่ไปป์ไลน์แบบคงที่ด้วยระบบการให้เหตุผลแบบไดนามิกที่ตัดสินใจเองได้ในแต่ละขั้นตอน
จากการสร้างระบบ Agentic ที่ใช้งานจริง ผมพบว่านอกจากเรื่องการใช้เครื่องมือหรือการจัดการหน่วยความจำแล้ว สิ่งที่ขาดไม่ได้สำหรับองค์กรคือ "ความปลอดภัยในฐานะขอบเขตทางสถาปัตยกรรม"
ปลอดภัยไว้ก่อน — เสมอ
ในระดับองค์กร การตรวจสอบความปลอดภัยต้องเป็นขั้นตอนแรกสุด ไม่ใช่แค่ตัวกรองปลายน้ำ หากตรวจพบข้อมูลละเอียดอ่อนในคำถาม ระบบควรปฏิเสธทันทีก่อนจะเริ่มกระบวนการค้นคืนใดๆ นี่คือการออกแบบเชิงปรัชญาที่สำคัญที่สุดในการสร้าง AI องค์กรที่น่าเชื่อถือ
การแก้ความคลุมเครือก่อนการค้นคืน
คำศัพท์ในองค์กรมักกำกวม แทนที่จะให้ LLM เดาสุ่ม การใช้ระบบแก้ความคลุมเครือที่มีฐานข้อมูลรองรับและใช้สถิติความถี่ของคำจะช่วยให้ระบุเจตนาได้แม่นยำกว่าด้วย Latency ที่ต่ำกว่ามาก ซึ่งเป็นหลักการเดียวกับการออกแบบ NLP บนอุปกรณ์ที่เน้นความเร็วเป็นหลัก
การวางแผน การย่อยงาน และการทำงานขนาน
สำหรับคำถามที่ซับซ้อน LLM ควรย่อยงานออกเป็นส่วนๆ และแสดงแผนงานให้ผู้ใช้ตรวจสอบก่อนเริ่ม (Human-in-the-loop) เพื่อสร้างความมั่นใจ ซึ่งสอดคล้องกับมาตรฐาน Model Context Protocol (MCP) นอกจากนี้ การรันการค้นหาหลายแหล่งข้อมูลพร้อมกันจะช่วยลดเวลาในการประมวลผลคำถามยากๆ ได้อย่างมีนัยสำคัญ
การให้คะแนนความเชื่อมั่นแบบอนุรักษนิยม
จุดตายของ RAG ส่วนใหญ่คือการเฉลี่ยค่าความเชื่อมั่นซึ่งอาจบดบังจุดบอดบางจุด ผมแนะนำให้ใช้การให้คะแนนแบบทวีคูณ (Multiplicative scoring) หากขั้นตอนใดขั้นตอนหนึ่งมีความเชื่อมั่นต่ำ คะแนนรวมจะดิ่งลงทันที วิธีนี้ช่วยให้ระบบมีความสามารถที่จะบอกว่า "ฉันไม่รู้" แทนที่จะเดาสุ่ม ซึ่งเป็นหัวใจสำคัญของ AI ที่ใช้งานจริง
การแก้ไขตัวเองผ่านการสะท้อนคิด (Reflection)
หากคะแนนความเชื่อมั่นต่ำกว่าเกณฑ์ ระบบควรสามารถวิเคราะห์ตัวเองและวนกลับไปวางแผนใหม่ด้วยบริบทที่มากขึ้นได้ แต่ต้องมีการจำกัดจำนวนครั้งในการลองใหม่เพื่อไม่ให้กระทบต่อประสิทธิภาพโดยรวม
หลักการที่ปรับใช้ได้ทั่วไป
บทเรียนที่ตกผลึกจากทั้ง 3 รุ่น ได้แก่:
- ความเป็นระเบียบ (Determinism) มีค่าสูงกว่าความยืดหยุ่น: ใช้ LLM เฉพาะงานที่ต้องใช้เหตุผลสร้างสรรค์ ส่วนงานสกัดข้อมูลหรือคำนวณความเชื่อมั่นให้ใช้ตรรกะที่คาดเดาผลลัพธ์ได้
- Latency คือฟีเจอร์: ทุกมิลลิวินาทีที่ประหยัดได้คือโอกาสที่ผู้ใช้จะยอมรับระบบมากขึ้น
- ความเชื่อมั่นและความเป็นส่วนตัว: ต้องถูกสร้างไว้ในโครงสร้างหลักตั้งแต่วันแรก ไม่ใช่ฟีเจอร์เสริมที่มาเติมทีหลัง
มองไปข้างหน้า
ทิศทางของ AI องค์กรกำลังก้าวจากไปป์ไลน์การค้นคืนที่ตายตัว ไปสู่ระบบการให้เหตุผลแบบไดนามิกที่รู้จักประเมินและแก้ไขตัวเองได้ ปราการด่านถัดไปคือ Multi-agent orchestration ที่เอเจนต์เฉพาะทางสามารถทำงานร่วมกันได้อย่างไร้รอยต่อผ่านโปรโตคอลอย่าง MCP องค์กรที่วางรากฐานทางสถาปัตยกรรมเหล่านี้ไว้ตั้งแต่วันนี้ จะมีความได้เปรียบมหาศาลเมื่อเทคโนโลยีเติบโตเต็มที่
RAG คือจุดเริ่มต้น แต่ Agentic AI คือปลายทางที่ระบบความรู้ของทุกองค์กรกำลังมุ่งไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร