
เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดเล็กประสิทธิภาพสูง
หลังจากที่เราได้เปิดตัว EmbeddingGemma ไปเมื่อปีที่ผ่านมาเพื่อเป็นทางเลือกน้ำหนักเบาสำหรับการทำ Text Embeddings คุณภาพสูง ผลตอบรับจากนักพัฒนานั้นยอดเยี่ยมเกินคาดด้วยยอดดาวน์โหลดกว่า 20 ล้านครั้ง ซึ่งถูกนำไปใช้ขับเคลื่อนระบบค้นหาบนอุปกรณ์และระบบ Retrieval Augmented Generation (RAG) ที่เน้นความเป็นส่วนตัว
วันนี้เราต่อยอดความสำเร็จด้วยการเปิดตัว EmbeddingGemma 2 ที่ขยายขีดความสามารถจากเพียงข้อความไปสู่การรวมโค้ด รูปภาพ วิดีโอ และเสียงเข้าไว้ในพื้นที่ Embedding เดียวกัน โดยสร้างขึ้นบนสถาปัตยกรรม Gemma 4 ภายใต้สัญญาอนุญาต Apache 2.0 ที่ใช้งานในเชิงพาณิชย์ได้
ด้วยพารามิเตอร์เพียง 740 ล้านตัว ทำให้ EmbeddingGemma 2 เหมาะสมอย่างยิ่งสำหรับการทำ Inference บนอุปกรณ์ โดยสามารถค้นหาคลิปวิดีโอจากเสียง หรือค้นหาข้อมูลในบันทึกเสียงยาวหลายชั่วโมงผ่านคำค้นหาที่เป็นข้อความ ซึ่งทั้งหมดนี้ประมวลผลผ่านโมเดล Multimodal แบบ Native เพียงตัวเดียว
EmbeddingGemma 2 พัฒนาจากเทคโนโลยีเดียวกับโมเดล Gemini Embedding โดยมีจุดเด่นที่น่าสนใจดังนี้:
- ดีที่สุดในรุ่นสำหรับขนาดเดียวกัน: ทำคะแนนสูงสุดในกลุ่ม Multimodal Embedder ที่มีพารามิเตอร์ต่ำกว่า 1 พันล้านตัว (sub-1B) จากการทดสอบ MTEB Code และ MAEB โดยให้ประสิทธิภาพเทียบเท่าหรือดีกว่าโมเดลขนาดใหญ่ในงานด้านข้อความและการมองเห็น
- การออกแบบที่เป็นโมดูล (Modular by design): ใช้พารามิเตอร์เพียง 270 ล้านตัวสำหรับงานเฉพาะข้อความ และมีตัวเลือกเสริมสำหรับ Vision Encoder (170 ล้าน) และ Audio Encoder (300 ล้าน) เพื่อรองรับ Multimodal เต็มรูปแบบ
- ประหยัดพื้นที่จัดเก็บ: ใช้เทคนิค Matryoshka Representation Learning (MRL) ช่วยให้นักพัฒนาตัดทอน Output Vectors จาก 768 มิติ เหลือเพียง 128 มิติได้แบบไดนามิก ลดการใช้หน่วยความจำและพื้นที่จัดเก็บได้สูงสุดถึง 6 เท่า
- ปรับแต่งเพื่อประสิทธิภาพบนอุปกรณ์: เมื่อทดสอบบน Google Pixel 11 Pro พบว่าต้องการ RAM ใช้งานเพียง 191MB สำหรับข้อความ และประมาณ 567MB สำหรับโหมด Multimodal เต็มรูปแบบ
- รองรับ Context ที่กว้างขึ้น: มี Context Window ขนาด 8K token ซึ่งใหญ่กว่ารุ่นแรกถึง 4 เท่า สามารถประมวลผลเสียงได้นาน 5.5 นาที รูปภาพ 29 รูป หรือวิดีโอ 58 เฟรมบนฮาร์ดแวร์ในเครื่องโดยตรง
บรรลุคุณภาพระดับแนวหน้าสำหรับโค้ด, การมองเห็น และเสียง
EmbeddingGemma 2 ยังคงประสิทธิภาพด้านข้อความที่แข็งแกร่งและพัฒนาด้านโค้ดเพิ่มขึ้นถึง 9.92 จุด (จาก 68.76 เป็น 78.68 ใน MTEB Code) เหมาะสำหรับการทำดัชนีฐานรหัสในเครื่องและการค้นหาโค้ดเชิงความหมายสำหรับ Coding Agent
สำหรับงานด้านภาพและเสียง โมเดลนี้สร้างมาตรฐานใหม่ในแง่คุณภาพต่อจำนวนพารามิเตอร์สำหรับโมเดลระดับ sub-1B และยังทำผลงานได้ดีกว่าโมเดลเฉพาะทางที่มีขนาดใหญ่กว่าเท่าตัวในบางการทดสอบ
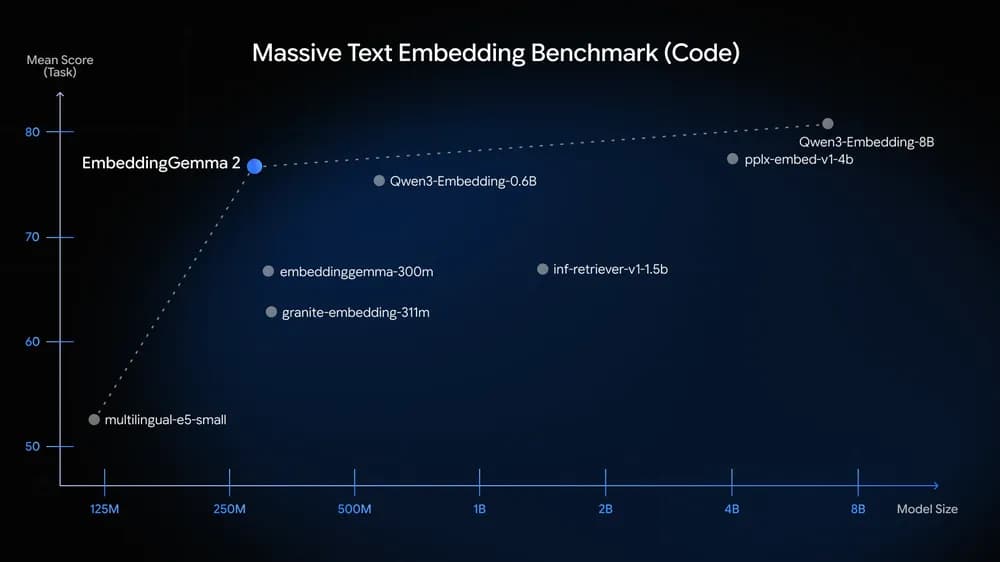
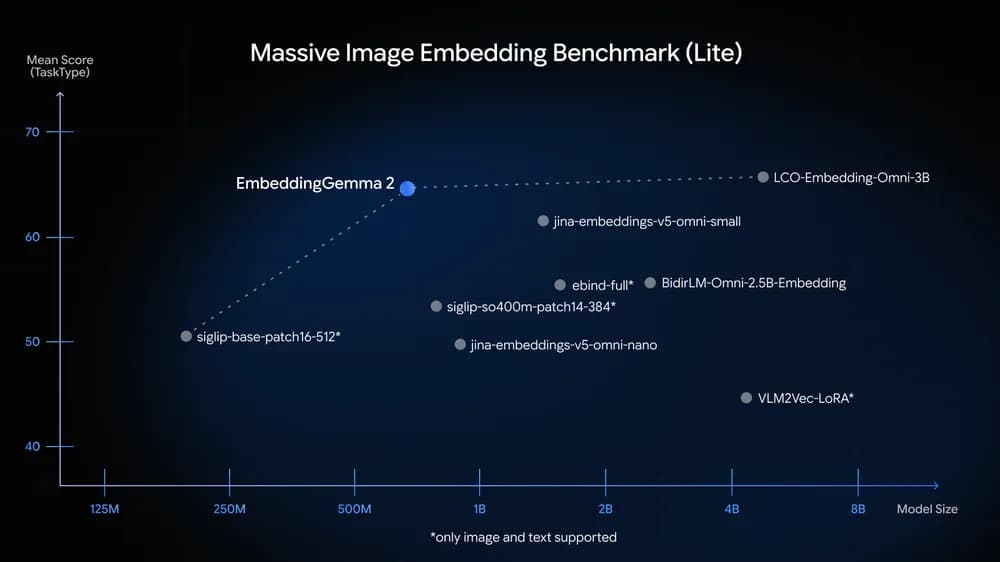
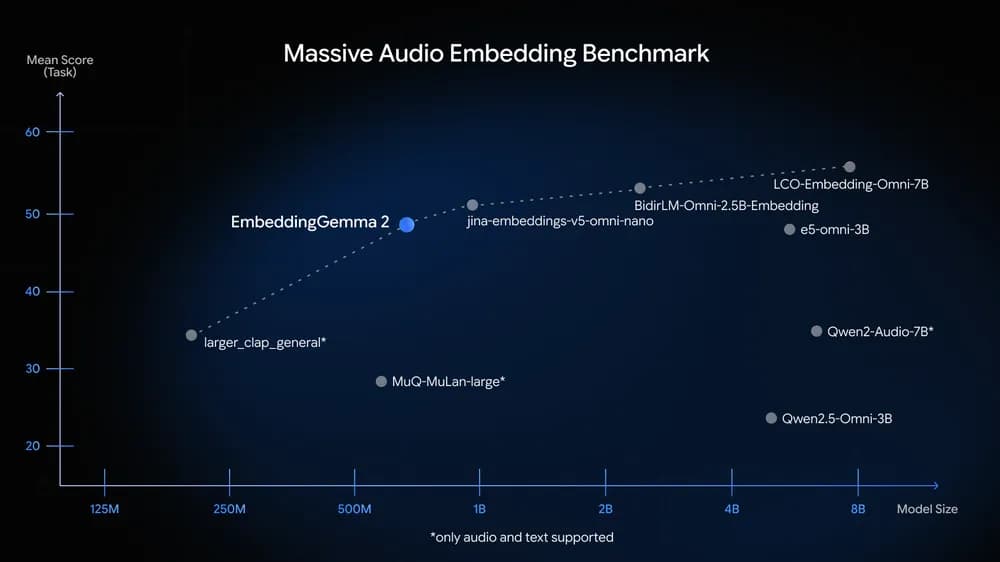
คุณสามารถตรวจสอบตัวชี้วัดและข้อมูลทางเทคนิคทั้งหมดได้ที่ EmbeddingGemma 2 model card
เปิดใช้งานการค้นหาเชิงความหมายและการดึงข้อมูลบนอุปกรณ์อย่างสมบูรณ์
การนำความสามารถมาสู่ฮาร์ดแวร์ระดับ Edge โดยตรงช่วยรับรองความเป็นส่วนตัวของข้อมูลและลดความหน่วง ระบบนี้ทำให้นักพัฒนาสร้างการค้นหาแบบข้ามโหมด (cross-modal) ที่ทำงานออฟไลน์ได้สมบูรณ์
เมื่อใช้งานร่วมกับโมเดล Generative อย่าง Gemma 4 ตัว EmbeddingGemma 2 จะช่วยให้ระบบ RAG บนอุปกรณ์เข้าใจข้อมูล Multimodal ที่ซับซ้อนได้ดียิ่งขึ้น เนื่องจากทั้งสองโมเดลใช้ Text Tokenizer และ Audio Encoder ร่วมกัน ทำให้นักพัฒนาสามารถรันทั้งสองระบบพร้อมกันโดยใช้พื้นที่หน่วยความจำรวมน้อยลง
- ค้นหาสื่อในคลังด้วยข้อความหรือรูปภาพผ่าน Instant Media Search ใน Google AI Edge Gallery
- ค้นหาช่วงเวลาเฉพาะในวิดีโอได้ใน Video Moments Finder ของ Google AI Edge Gallery
- ใช้งานร่วมกับแอป Google AI Edge Foresight เพื่อดึงข้อมูลไฟล์ในเครื่อง
- สร้างเอนจินการตัดสินใจแบบเรียลไทม์ผ่าน MediaPipe Decision Task API
สำหรับผู้ที่ต้องการสร้างระบบการค้นหาและ RAG บนอุปกรณ์ด้วย LiteRT สามารถศึกษาเพิ่มเติมได้ที่ โพสต์บล็อก Google AI Edge
เริ่มต้นใช้งาน EmbeddingGemma 2
เราได้ร่วมมือกับพันธมิตรต่างๆ เพื่อให้มั่นใจว่า EmbeddingGemma 2 จะพร้อมใช้งานได้ทันทีในทุกแพลตฟอร์ม:
- ดาวน์โหลดโมเดล: ใช้งานได้แล้วบน Hugging Face และ Kaggle รวมถึงโมเดลปรับแต่งพิเศษใน LiteRT Community บน Hugging Face
- การปรับใช้บนอุปกรณ์: พัฒนาผ่าน MediaPipe หรือ LiteRT และรองรับเบราว์เซอร์ผ่าน transformers.js หรือ WebGPU
- เครื่องมือพัฒนา: รองรับทั้ง transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama และ LMStudio
- การ Fine-tuning: สามารถทำตามคำแนะนำจาก Unsloth เพื่อปรับแต่งโมเดลให้เข้ากับกรณีการใช้งานเฉพาะของคุณ
ศึกษารายละเอียดเพิ่มเติมได้ที่ คู่มือนักพัฒนา และเอกสารประกอบการทำ Inference หรือ Fine-tuning
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร