
เจาะลึกเฟรมเวิร์กตอบคำถามสัมภาษณ์งาน AI System Design สำหรับวิศวกรรุ่นใหม่
เป็นเวลาหลายปีที่การสัมภาษณ์งานด้าน System Design มักจะวนเวียนอยู่กับโจทย์อย่าง "Design YouTube", "Design Uber" หรือ "Design WhatsApp" แต่ปัจจุบันบริษัทที่กำลังมองหา AI Engineer, Applied Scientist และ GenAI Engineer เริ่มเปลี่ยนมาใช้ชุดคำถามที่ทันสมัยขึ้น เช่น "Design ChatGPT", "Design ระบบ AI สำหรับซัพพอร์ตลูกค้า" หรือ "Design GitHub Copilot"
แม้ว่าวิศวกรส่วนใหญ่จะสามารถเรียกใช้งาน LLM API ได้ แต่มีเพียงส่วนน้อยที่สามารถอธิบายสถาปัตยกรรมโดยรอบและปกป้องทางเลือกในการออกแบบภายใต้แรงกดดันได้ ทักษะนี้คือหัวใจสำคัญที่ผู้สัมภาษณ์ใช้ทดสอบ บทความนี้จะนำเสนอเฟรมเวิร์กที่นำไปประยุกต์ใช้ได้กับทุกโจทย์ เพื่อให้คุณไม่ต้องท่องจำคำตอบแยกตามหัวข้ออีกต่อไป
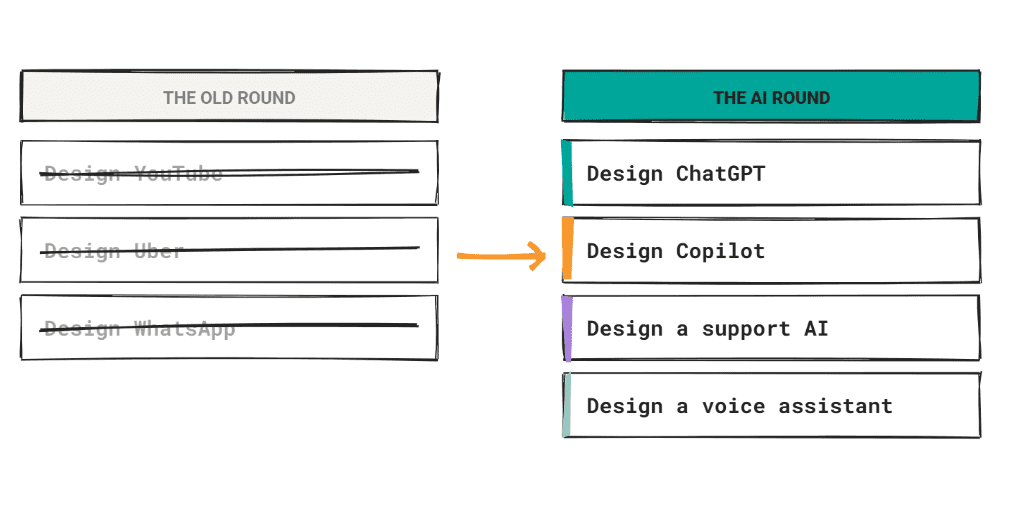
ทำไมคำถามถึงเปลี่ยนไป
การจ้างงานด้าน AI เติบโตอย่างรวดเร็วจนเปลี่ยนโฉมกระบวนการสัมภาษณ์งาน โดยตำแหน่ง AI Engineer ถูกจัดเป็นอาชีพที่เติบโตเร็วที่สุดอันดับ 1 ในสหรัฐฯ สองปีซ้อน ด้วยยอดประกาศรับสมัครงานที่พุ่งสูงขึ้นถึง 143% เมื่อเทียบเป็นรายปี ในปี 2025
ข้อมูลจาก LinkedIn เผยว่า มีการประกาศรับสมัครงานตำแหน่งนี้เพิ่มขึ้นถึง 75,000 ตำแหน่งในช่วงปี 2023-2025 ส่งผลให้สัดส่วนงาน AI และ Machine Learning ในตลาดเทคโนโลยีพุ่งจาก 10% ไปสู่ 50%
ด้วยแนวโน้มนี้ คำถามสัมภาษณ์จึงมุ่งเน้นไปที่ซอฟต์แวร์ที่ใช้ AI เป็นแกนหลัก IGotAnOffer รายงานว่า การสัมภาษณ์ในปัจจุบันเน้นวิธีที่คุณนำ Large Language Models (LLMs) มาพัฒนาเป็นผลิตภัณฑ์ เช่น การออกแบบ Agentic Loops, การทำระบบ Retrieval และการบริหารจัดการต้นทุน โดยความรู้เชิงลึกเกี่ยวกับโครงสร้างภายในโมเดลเริ่มมีความสำคัญน้อยลงกว่าวิธีการนำไปใช้จริง
คู่มือการทำงานในช่วงปี 2025-2026 ระบุโจทย์ที่พบบ่อยที่สุด ได้แก่ การออกแบบ AI Chatbot, ระบบตอบคำถามจากเอกสาร (RAG), AI Coding Agent และผู้ช่วยสั่งงานด้วยเสียง
สิ่งที่ผู้สัมภาษณ์ประเมิน
Educative อธิบายการเปลี่ยนแปลงนี้ว่า การสัมภาษณ์จะทดสอบความสามารถในการให้เหตุผลกับระบบที่เน้นความน่าจะเป็น (Probabilistic) และมีข้อจำกัดด้านต้นทุน ซึ่งต่างจากบริการแบบกำหนดผลลัพธ์แน่นอน (Deterministic) อย่าง CRUD ทักษะหลักคือการจัดการ Trade-offs ระหว่าง Latency, ต้นทุน, คุณภาพ และความปลอดภัย
ผู้สมัครที่โดดเด่นจะสามารถอธิบายเหตุผลของการมีอยู่ของแต่ละเลเยอร์ในระบบได้ชัดเจน รวมถึงวิเคราะห์ได้ว่าหากขาดเลเยอร์ใดไปจะส่งผลเสียอย่างไร การระบุชื่อเลเยอร์โดยไม่มีเหตุผลรองรับจะถูกมองว่าขาดความเข้าใจที่แท้จริง
รายงานระดับ Senior ระบุว่าผู้สัมภาษณ์มักเลือก 3-5 หัวข้อเพื่อเจาะลึกถึง Failure Modes และบทเรียนจากความผิดพลาดในอดีต สิ่งที่สร้างความแตกต่างคือประสบการณ์ทำงานจริง (Production Experience) และความสามารถในการถ่ายทอดสิ่งที่เคยส่งมอบงานไปแล้ว
เฟรมเวิร์กการออกแบบ (The Framework)
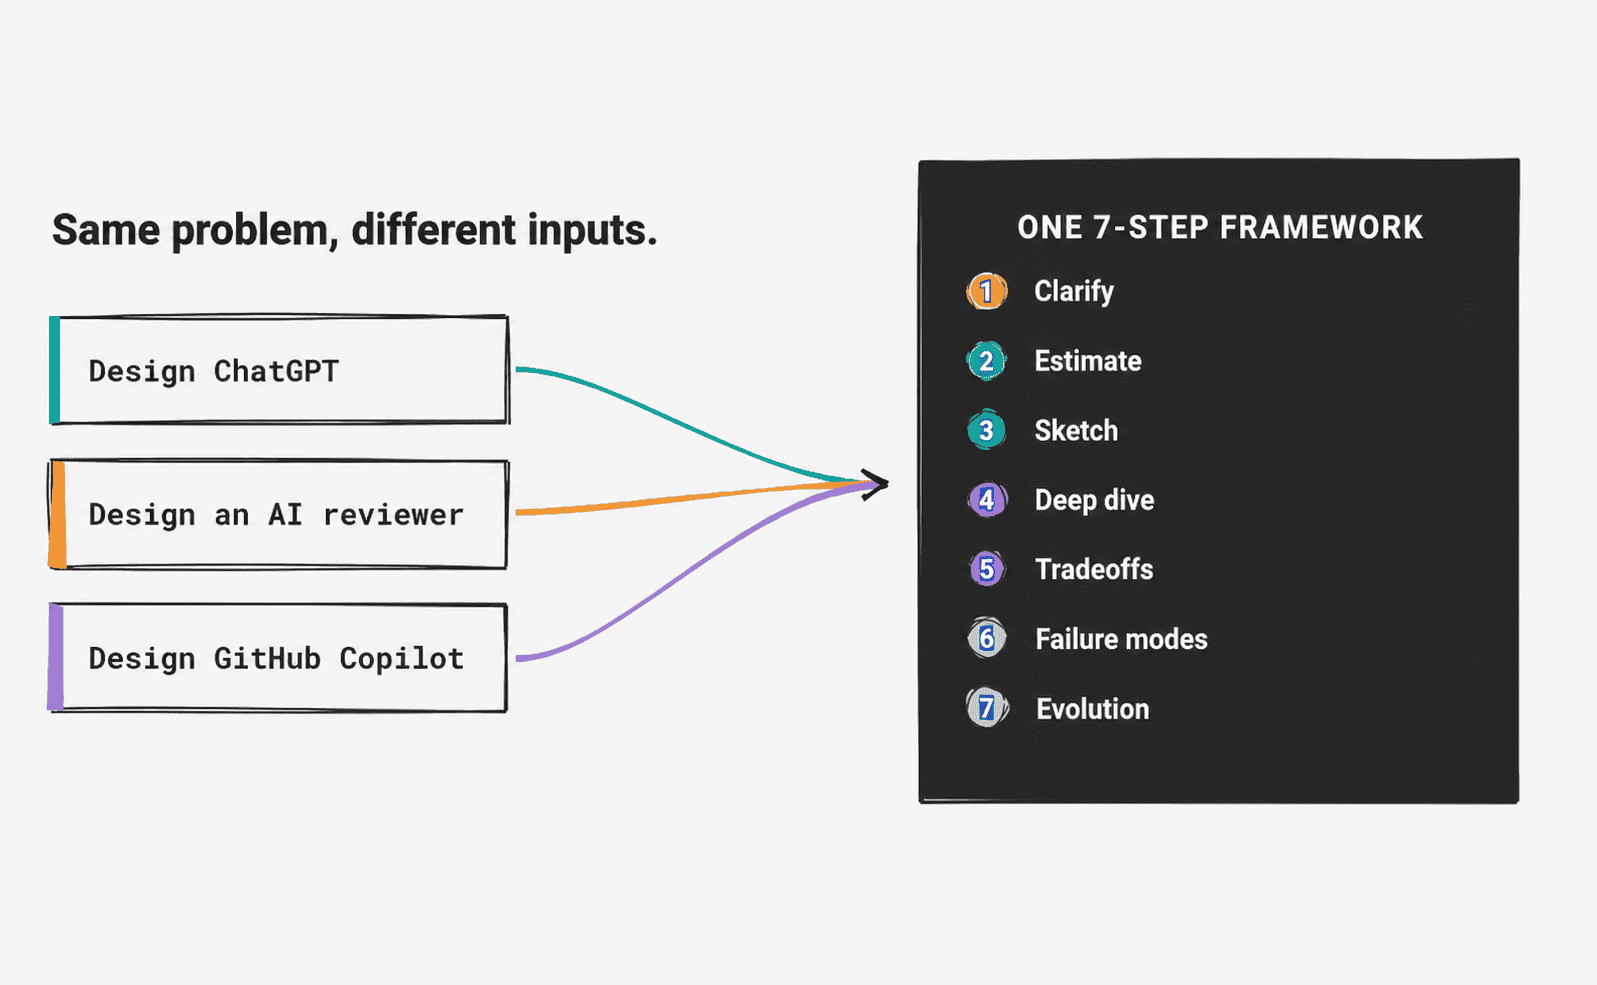
แม้ว่า The System Design Handbook จะเสนอไว้ 8 ขั้นตอน แต่เราสรุปให้เหลือ 7 ขั้นตอนที่กระชับและใช้งานได้จริง ดังนี้:
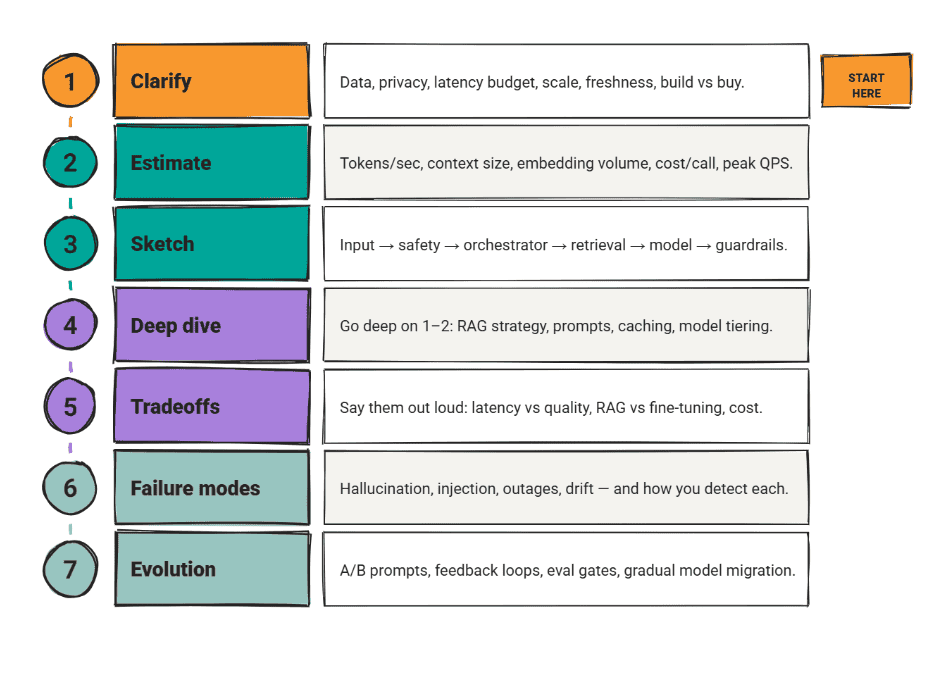
- Clarify (สร้างความชัดเจน): ระบุแหล่งข้อมูล, นโยบายความเป็นส่วนตัว, งบประมาณ Latency, ความแม่นยำที่ยอมรับได้, ขนาดของระบบ และเงื่อนไขการใช้ API ภายนอกเทียบกับการโฮสต์เอง
- Estimate (ประเมินตัวเลข): คำนวณ Tokens ต่อวินาที, ขนาด Context Window, ปริมาณ Embedding, ต้นทุนต่อ Call และจุดสูงสุดของ QPS (Queries Per Second)
- Sketch the Architecture (ร่างสถาปัตยกรรม): วางโครงสร้างมาตรฐานที่ประกอบด้วยเลเยอร์อินพุต, ระบบความปลอดภัย (PII), Orchestrator, ส่วนการดึงข้อมูล (Vector DB & Reranker), โมเดล, Guardrails, Streaming Response และ Observability
- Deep Dive (เจาะลึกรายละเอียด): เลือก 1-2 คอมโพเนนต์มาลงลึก เช่น กลยุทธ์ RAG (Chunking, Hybrid Search), การออกแบบ Prompt หรือกลไกการทำ Caching
- Trade-offs (การแลกเปลี่ยน): วิเคราะห์ข้อดีข้อเสียให้ชัดเจน เช่น Latency เทียบกับคุณภาพ, การใช้ RAG เทียบกับการ Fine-tuning หรือการใช้โมเดลสำรองเมื่อระบบโหลดหนัก
- Failure Modes and Observability (รูปแบบความล้มเหลว): เตรียมแผนรับมืออาการหลอน (Hallucinations), Prompt Injection, บริการล่ม และวิธีการตรวจจับปัญหาเหล่านี้
- Evolution (วิวัฒนาการ): วางแผนการทำ A/B Testing สำหรับ Prompt, Feedback Loops และแนวทางการย้ายโมเดลในอนาคต
ข้อผิดพลาดที่ ถูกรายงานมากที่สุด คือการรีบเสนอโซลูชันก่อนที่จะเข้าใจข้อจำกัดของโจทย์ ดังนั้นควรให้ความสำคัญกับขั้นตอน Clarify ในช่วงนาทีแรกให้มากที่สุด
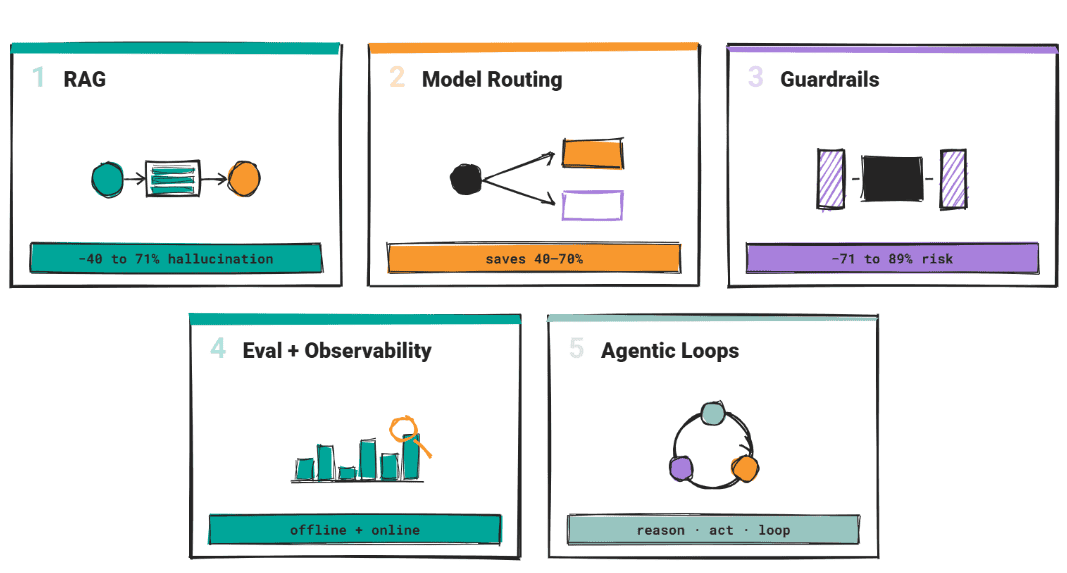
5 องค์ประกอบพื้นฐานที่ต้องรู้ (The Primitives)
// Retrieval-Augmented Generation (RAG)
ระบบ RAG ประกอบด้วย Query Encoder, Retriever สำหรับดึงข้อมูล และ Generator การใช้งานจริงจะเพิ่มเรื่อง Chunking, Embedding Pipelines และการควบคุมสิทธิ์เข้าถึงข้อมูล ซึ่ง RAG ช่วยลดอาการหลอนได้ประมาณ 40 ถึง 71%
// Model Routing
เนื่องจากต้นทุนและ Latency เป็นข้อจำกัดสำคัญ โมเดลระดับ GPT-4 มีต้นทุน สูงถึง $10-$30 ต่อล้านโทเค็น การทำ Model Routing เพื่อส่งคำขอทั่วไปไปยังโมเดลราคาถูกจะช่วย ประหยัดต้นทุนได้ 40 ถึง 70%
// Guardrails
แบ่งเป็น Pre-LLM (ตรวจสอบอินพุต, ปกปิดข้อมูล PII) และ Post-LLM (บังคับ Schema, ตรวจเช็คข้อเท็จจริง) ซึ่งสามารถ ลดความเสี่ยงจากการหลอนได้ถึง 71-89%
// Evaluation and Observability
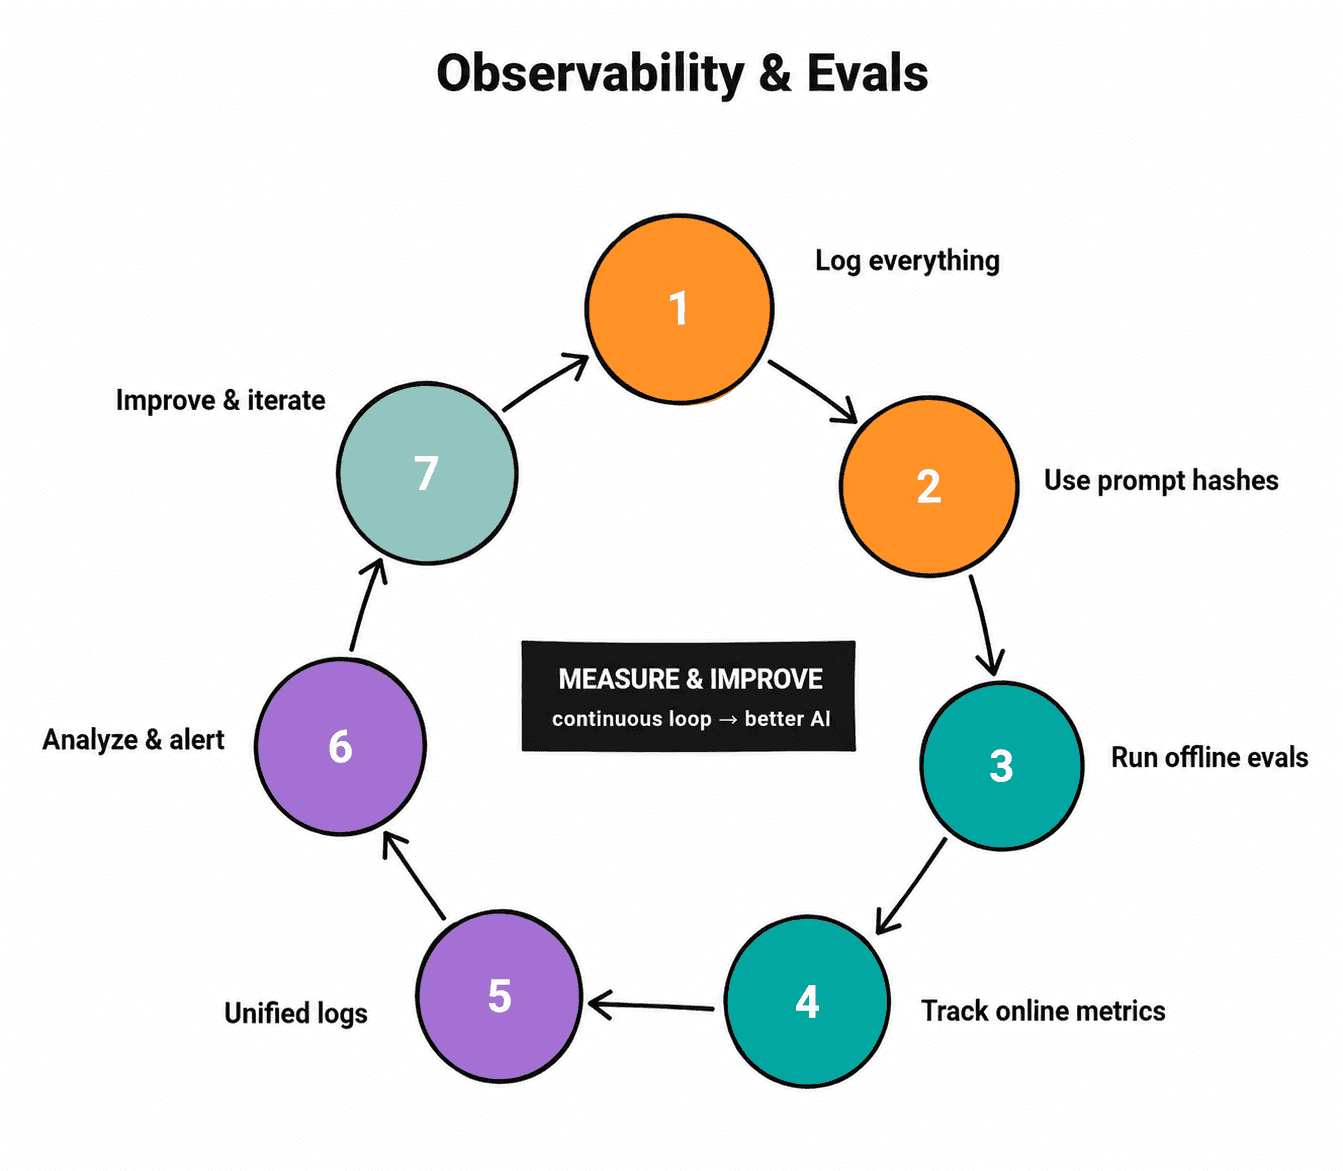 การเก็บบันทึกเวอร์ชันโมเดล, Metadata และการใช้ LLM-as-judge เพื่อประเมินความซื่อตรงของข้อมูล (Faithfulness) จะช่วยให้การแก้บั๊กและความปลอดภัยทำได้ดีขึ้น
// Agentic Loops
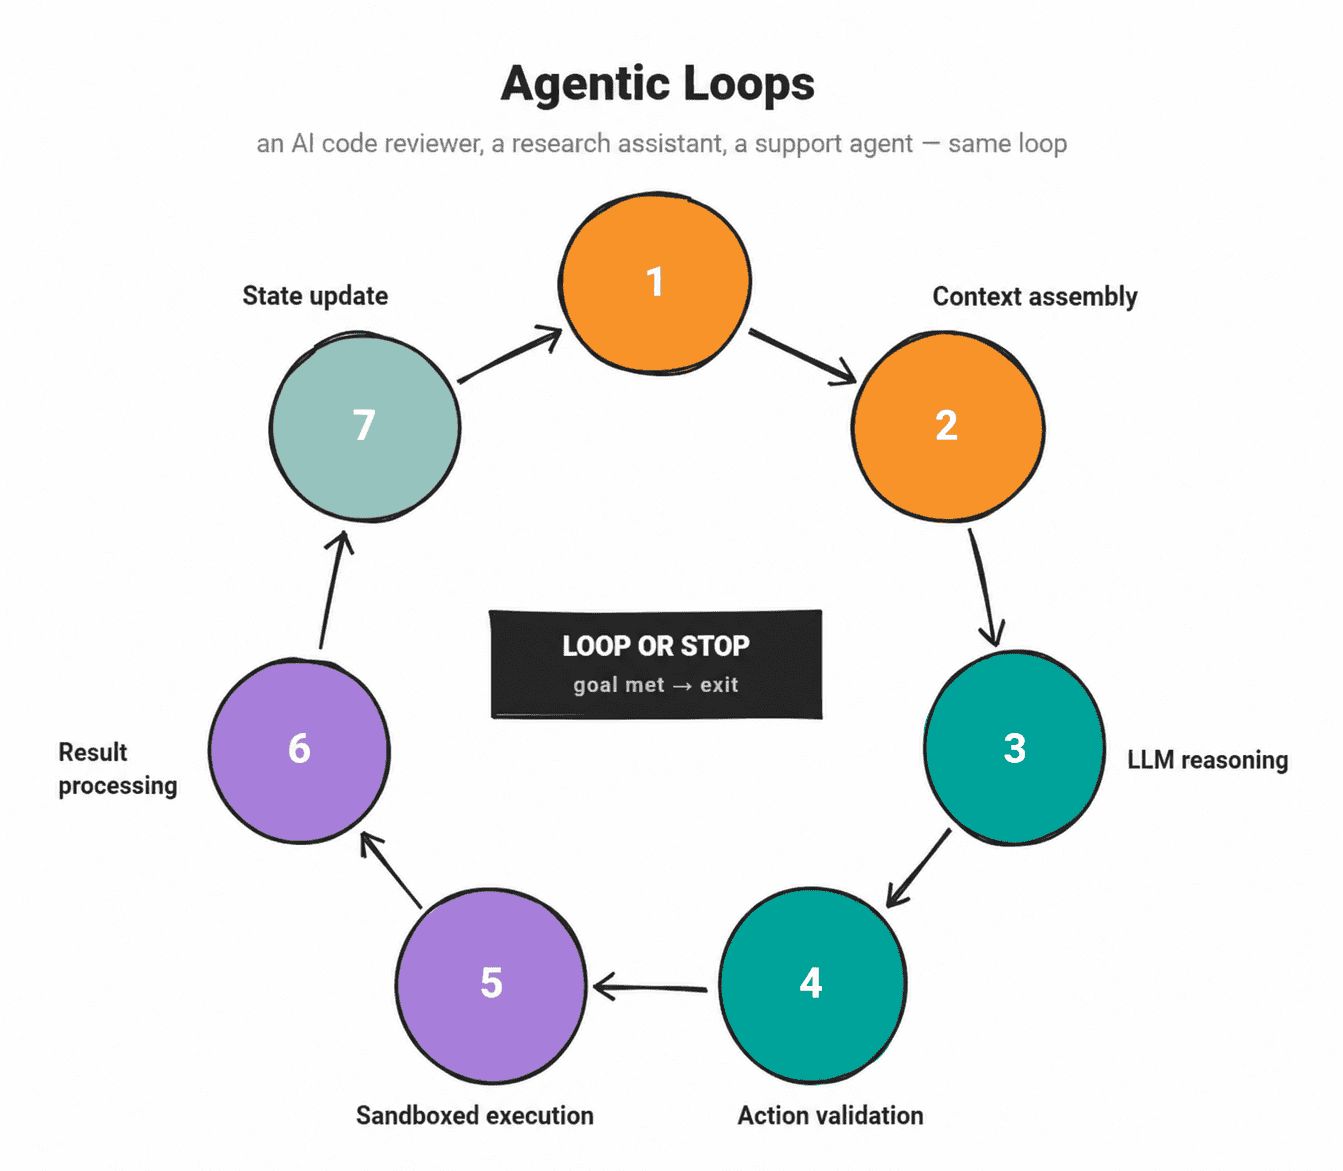 สำหรับงานที่ซับซ้อน ระบบจะทำงานวนซ้ำ (Reasoning Loop) ระหว่าง LLM ที่ใช้เหตุผล, Orchestrator ที่ควบคุมงาน และ Sandbox ที่ใช้ประมวลผล
สถาปัตยกรรมอ้างอิงและข้อควรระวัง
การอ้างถึงระบบจริงอย่าง GitHub Copilot ที่ใช้เทคนิค Fill-in-the-Middle (FIM) เพื่อช่วยให้การเขียนโค้ด ดีขึ้น 10% จะช่วยเพิ่มความน่าเชื่อถือให้คำตอบของคุณ นอกจากนี้ยังมีเคสของ Uber, Airbnb และ Anthropic ที่น่าศึกษาเพิ่มเติม
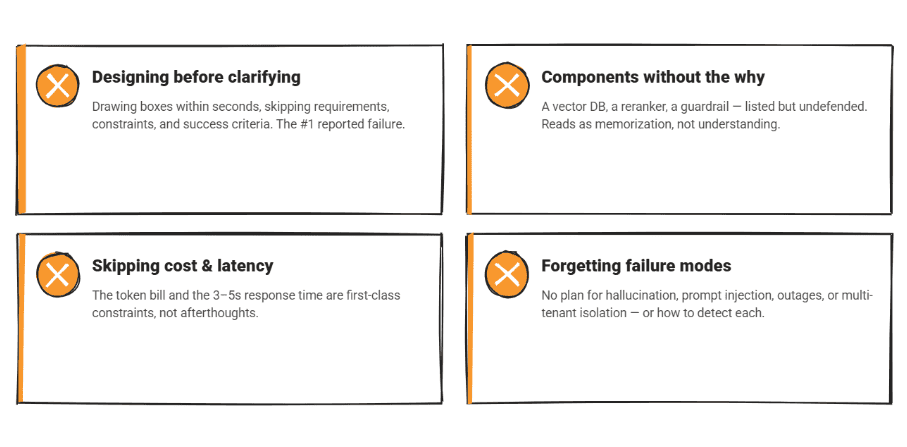
จำไว้ว่าอย่ารีบออกแบบก่อนถามรายละเอียด อย่าระบุคอมโพเนนต์โดยไม่อธิบายเหตุผล อย่ามองข้ามเรื่องต้นทุน/Latency และห้ามลืมเรื่อง Failure Modes หากคุณฝึกฝนตามเฟรมเวิร์กนี้ ไม่ว่าโจทย์จะเปลี่ยนไปอย่างไร คุณจะมองเห็นโครงสร้างที่เชื่อมโยงกันและตอบคำถามได้อย่างมั่นใจ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร