
LangChain vs LlamaIndex vs สร้างเอง: เลือกแบบไหนดีสำหรับแอป LLM
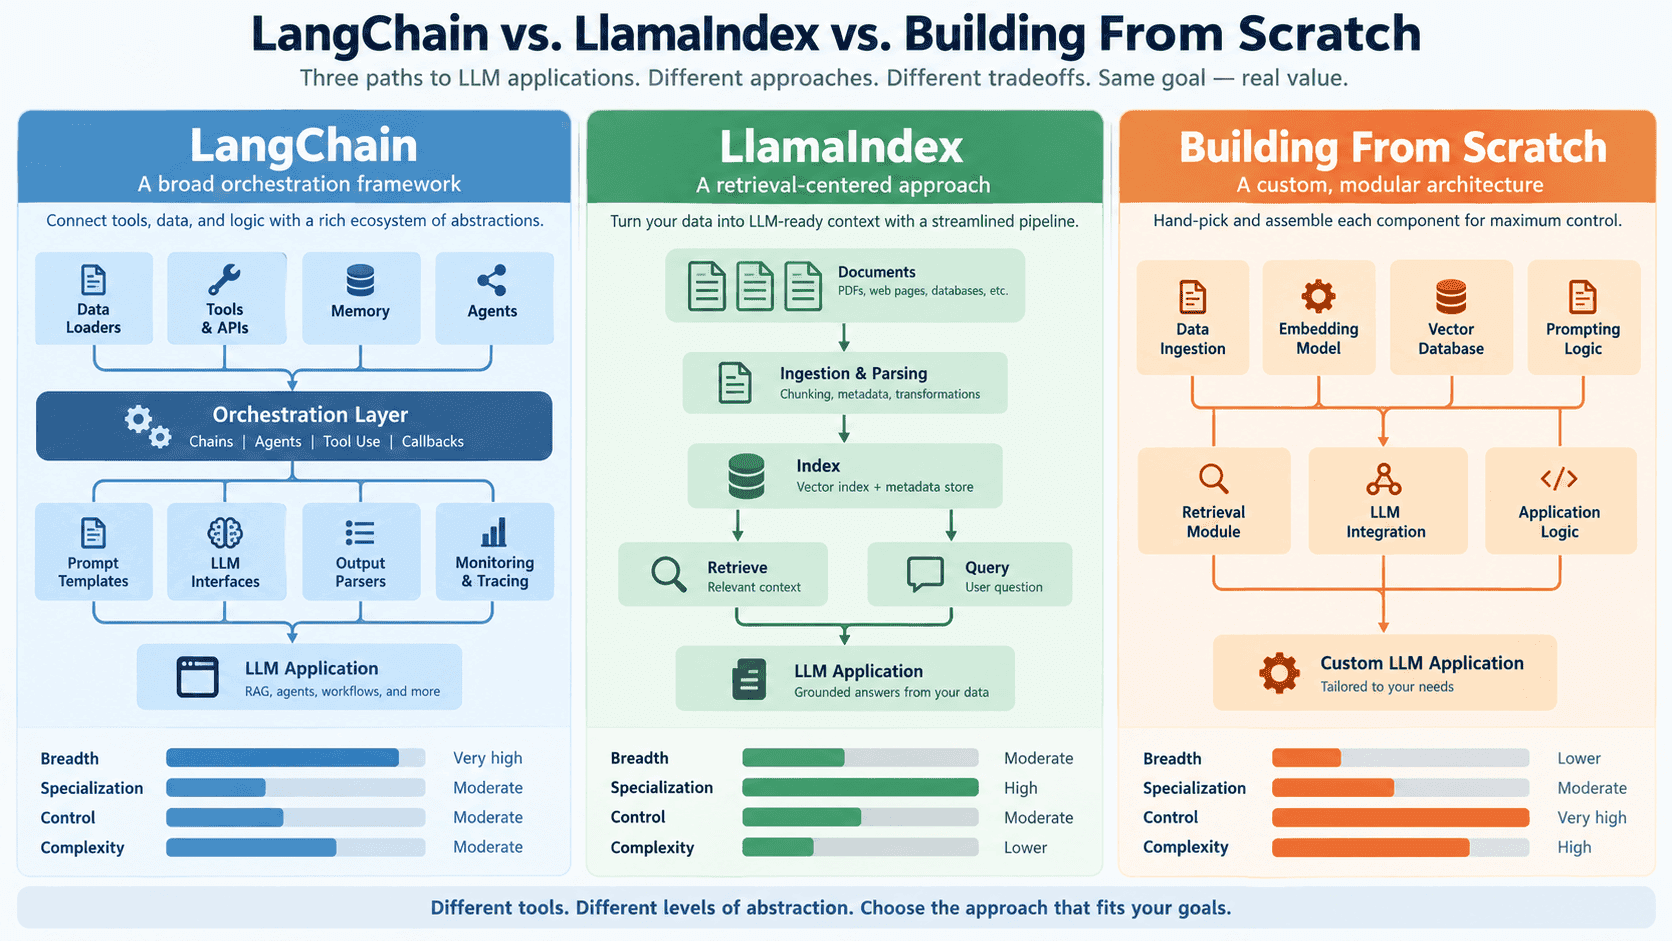
ระบบนิเวศของเครื่องมือรอบตัว Large Language Models (LLMs) ขยายตัวรวดเร็วจนตามแทบไม่ทัน โดยมีสองชื่อที่ครองความสนใจมากที่สุดคือ LangChain และ LlamaIndex ทั้งคู่ช่วยลดอุปสรรคในการพัฒนาและมีชุมชนสนับสนุนขนาดใหญ่ แต่นั่นไม่ได้หมายความว่าจะเป็นคำตอบที่ถูกต้องสำหรับทุกโปรเจกต์
ในปัจจุบัน เส้นทางที่สามอย่างการสร้างขึ้นเอง (building from scratch) เริ่มได้รับความนิยมมากขึ้น โดยเน้นการใช้เพียง base API และโครงสร้างนามธรรม (abstractions) ของตนเอง บทความนี้จะเจาะลึกข้อดีข้อเสียของแต่ละแนวทาง เพื่อให้คุณตัดสินใจเลือกได้อย่างเหมาะสมแทนที่จะเลือกตามความนิยมบน GitHub
ทำความเข้าใจว่าเครื่องมือเหล่านี้ทำอะไรได้จริง โดยธรรมชาติแล้ว LLM คือตัวทำนายข้อความแบบไร้สถานะ (stateless) ซึ่งไม่จดจำข้อมูลใดๆ การสร้างแอปพลิเคชันที่มีประสิทธิภาพ เช่น ระบบตอบคำถามจากเอกสารหรือ agent ที่ทำงานหลายขั้นตอน จำเป็นต้องมีการจัดการ (orchestration) ทั้งเรื่องบริบท, การดึงข้อมูล และการเชื่อมโยงระบบเข้าด้วยกัน
LangChain และ LlamaIndex ทำหน้าที่เป็นชั้นการจัดการ (orchestration layer) เพื่อช่วยให้นักพัฒนาจดจ่อกับ logic ของแอปพลิเคชันได้โดยไม่ต้องกังวลเรื่องโครงสร้างพื้นฐาน ส่วนการสร้างจากศูนย์หมายถึงการที่คุณต้องเขียนระบบจัดการเหล่านั้นขึ้นมาด้วยตัวเองทั้งหมด
LangChain: กว้างขวาง ยืดหยุ่น และบางครั้งก็น่าปวดหัว
LangChain เป็นผู้เล่นรายแรกๆ ในตลาดที่มีขอบเขตการทำงานกว้างขวางมาก โดยให้โครงสร้างสำหรับทั้ง chains, agents, memory และการเชื่อมต่อ (integrations) กับบริการภายนอกนับสิบรายการ
จุดที่ทำงานได้ดี
เหมาะสำหรับทีมที่ต้องการเชื่อมต่อ LLM กับแหล่งข้อมูลและเครื่องมือที่หลากหลาย เพราะมีคลังการเชื่อมต่อที่ครอบคลุมตั้งแต่ vector databases ไปจนถึง search engines นอกจากนี้ยังจัดการเวิร์กโฟลว์ของ agent ที่มีหลายขั้นตอนได้ดี ช่วยให้ LLM ตัดสินใจเลือกเครื่องมือและทำงานวนซ้ำได้โดยไม่ต้องสร้างลูปเอง
จุดที่สร้างความยุ่งยาก
ความกว้างขวางกลายเป็นดาบสองคม เพราะชั้นของ abstraction ที่ซ้อนกันหนาเตอะทำให้การ debug ทำได้ยากเมื่อเกิดปัญหา อีกทั้ง framework นี้ยังพัฒนาเร็วมากจนเอกสารบางส่วนล้าสมัย และการอัปเกรดเวอร์ชันมักพบ breaking changes ซึ่งอาจไม่เหมาะกับระบบ production ที่ต้องการความเสถียรสูง
LlamaIndex: มุ่งเน้น ชัดเจน สร้างมาเพื่อ Retrieval โดยเฉพาะ
LlamaIndex (เดิมคือ GPT Index) มุ่งเน้นไปที่การสร้างระบบ retrieval-augmented generation (RAG) ให้เป็นเรื่องง่าย ซึ่งยังคงเป็นจุดเด่นที่สุดของ framework นี้
จุดที่ทำงานได้ดี
หากแอปพลิเคชันของคุณเน้นการดึงข้อมูลจากเอกสารมาเป็นบริบท LlamaIndex จะตอบโจทย์มาก ด้วยเครื่องมือ RAG ขั้นสูงอย่างการจัดลำดับใหม่ (re-ranking) และการดึงข้อมูลแบบลำดับชั้น (hierarchical retrieval) พร้อมทั้งมีเครื่องมือประเมิน (evaluation) ที่ช่วยตรวจสอบคุณภาพของข้อมูลก่อนถึงมือผู้ใช้
จุดที่สร้างความยุ่งยาก
LlamaIndex จะเริ่มทำงานลำบากหากแอปพลิเคชันของคุณขยายขอบเขตเกินกว่าการดึงข้อมูล เช่น การใช้ agent ที่ซับซ้อน หรือเวิร์กโฟลว์ที่ไม่ได้มีศูนย์กลางอยู่ที่เอกสาร นอกจากนี้ยังมีภาระของ abstraction (abstraction overhead) ที่อาจขัดขวางการปรับแต่งสถาปัตยกรรมที่เฉพาะตัว
การสร้างขึ้นเอง: เข้าถึงได้ง่ายกว่าที่เห็น
การสร้างขึ้นเองหมายถึงการเรียก API ของผู้ให้บริการ model โดยตรง และใช้ logic การดึงข้อมูลของคุณเอง ซึ่งปัจจุบันทำได้ง่ายขึ้นเพราะผู้ให้บริการอย่าง OpenAI หรือ Anthropic มี SDK ที่แข็งแกร่ง ส่วน vector database เช่น Pinecone, Weaviate และ Qdrant ก็มีเครื่องมือรองรับครบครัน
จุดที่ทำงานได้ดี
ช่วยให้คุณควบคุมระบบได้ทุกขั้นตอน ไม่มี prompt ที่ซ่อนอยู่หรือ logic ที่ไม่คาดคิด การควบคุมนี้มีค่ามากในระดับ production เพราะช่วยให้การ debug และการเพิ่มประสิทธิภาพการทำงาน (performance optimization) ทำได้ง่ายกว่า อีกทั้งยังช่วยป้องกันปัญหา over-engineering โดยให้คุณสร้างเฉพาะสิ่งที่จำเป็นต้องใช้จริงๆ เท่านั้น
จุดที่สร้างความยุ่งยาก
ต้องใช้เวลาและทรัพยากรในช่วงแรกสูงกว่า เพราะต้องเขียนโค้ดและตัดสินใจเรื่องโครงสร้างพื้นฐานเองทั้งหมด นอกจากนี้ยังต้องการทีมที่มีความเข้าใจลึกซึ้งเรื่อง embedding models, การแบ่งส่วนข้อมูล (chunking) และการจัดการ context window ซึ่ง framework ทั่วไปมักจะช่วยปกปิดความซับซ้อนเหล่านี้ไว้
วิธีการเลือก
การตัดสินใจเลือกขึ้นอยู่กับสามปัจจัยหลัก ดังนี้:
หากอยู่ในช่วงเริ่มต้นสำรวจ: แนะนำให้ใช้ framework อย่าง LangChain หรือ LlamaIndex เพื่อทดสอบสมมติฐานให้เร็วที่สุด โดย LangChain เหมาะกับงานทั่วไป ส่วน LlamaIndex เหมาะกับงานที่เน้นการดึงข้อมูลเป็นหลัก
หากทำระบบ production ที่เน้นการดึงข้อมูลหนักมาก: LlamaIndex เป็นตัวเลือกที่คุ้มค่าเพราะมีเครื่องมือจัดการ RAG และการประเมินผลที่แม่นยำ
หากมีความต้องการเฉพาะเจาะจงและทีมวิศวกรรมแข็งแกร่ง: การสร้างขึ้นเองคือการลงทุนระยะยาวที่คุ้มค่าที่สุด เพื่อความคล่องตัวในการ debug และการปรับแต่งในอนาคต
หากต้องการการปรับแต่งเชิงลึก (deep customization): ควรวางแผนสร้างเองตั้งแต่ต้น หรือเตรียมใจไว้ว่าสุดท้ายคุณอาจต้องถอดชั้น framework ออกเพื่อเขียนเองในที่สุด
แหล่งเรียนรู้ที่แนะนำ เพื่อศึกษาข้อมูลเพิ่มเติมในแต่ละแนวทาง:
- เอกสารของ LangChain - เรียนรู้เรื่อง chains, agents และการเชื่อมต่อต่างๆ
- เอกสารของ LlamaIndex - เจาะลึกรูปแบบ RAG และกลยุทธ์การทำ indexing
- คู่มือ prompt engineering ของ Anthropic และ OpenAI Cookbook - ทำความเข้าใจพื้นฐาน base API
- ศูนย์การเรียนรู้ของ Pinecone - อธิบายแนวคิด vector search โดยไม่ยึดติดกับ framework
บทสรุป
LangChain, LlamaIndex และการสร้างเองไม่ใช่สิ่งที่ต้องห้ำหั่นกัน แต่เป็นเครื่องมือที่มีข้อดีข้อเสียต่างกันตามบริบท ทีมที่ประสบความสำเร็จคือทีมที่เข้าใจปัญหาของตนเองก่อนเลือกเครื่องมือ การเริ่มต้นด้วยความเข้าใจว่าแอปพลิเคชันต้องการอะไร จะช่วยให้คุณเลือกแนวทางที่ถูกต้องได้แม่นยำกว่าการดูเพียงผลทดสอบประสิทธิภาพทั่วไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร