
Perplexity เปิดตัว pplx-embed-v2-late โมเดลจิ๋ว 0.6B และ 9B
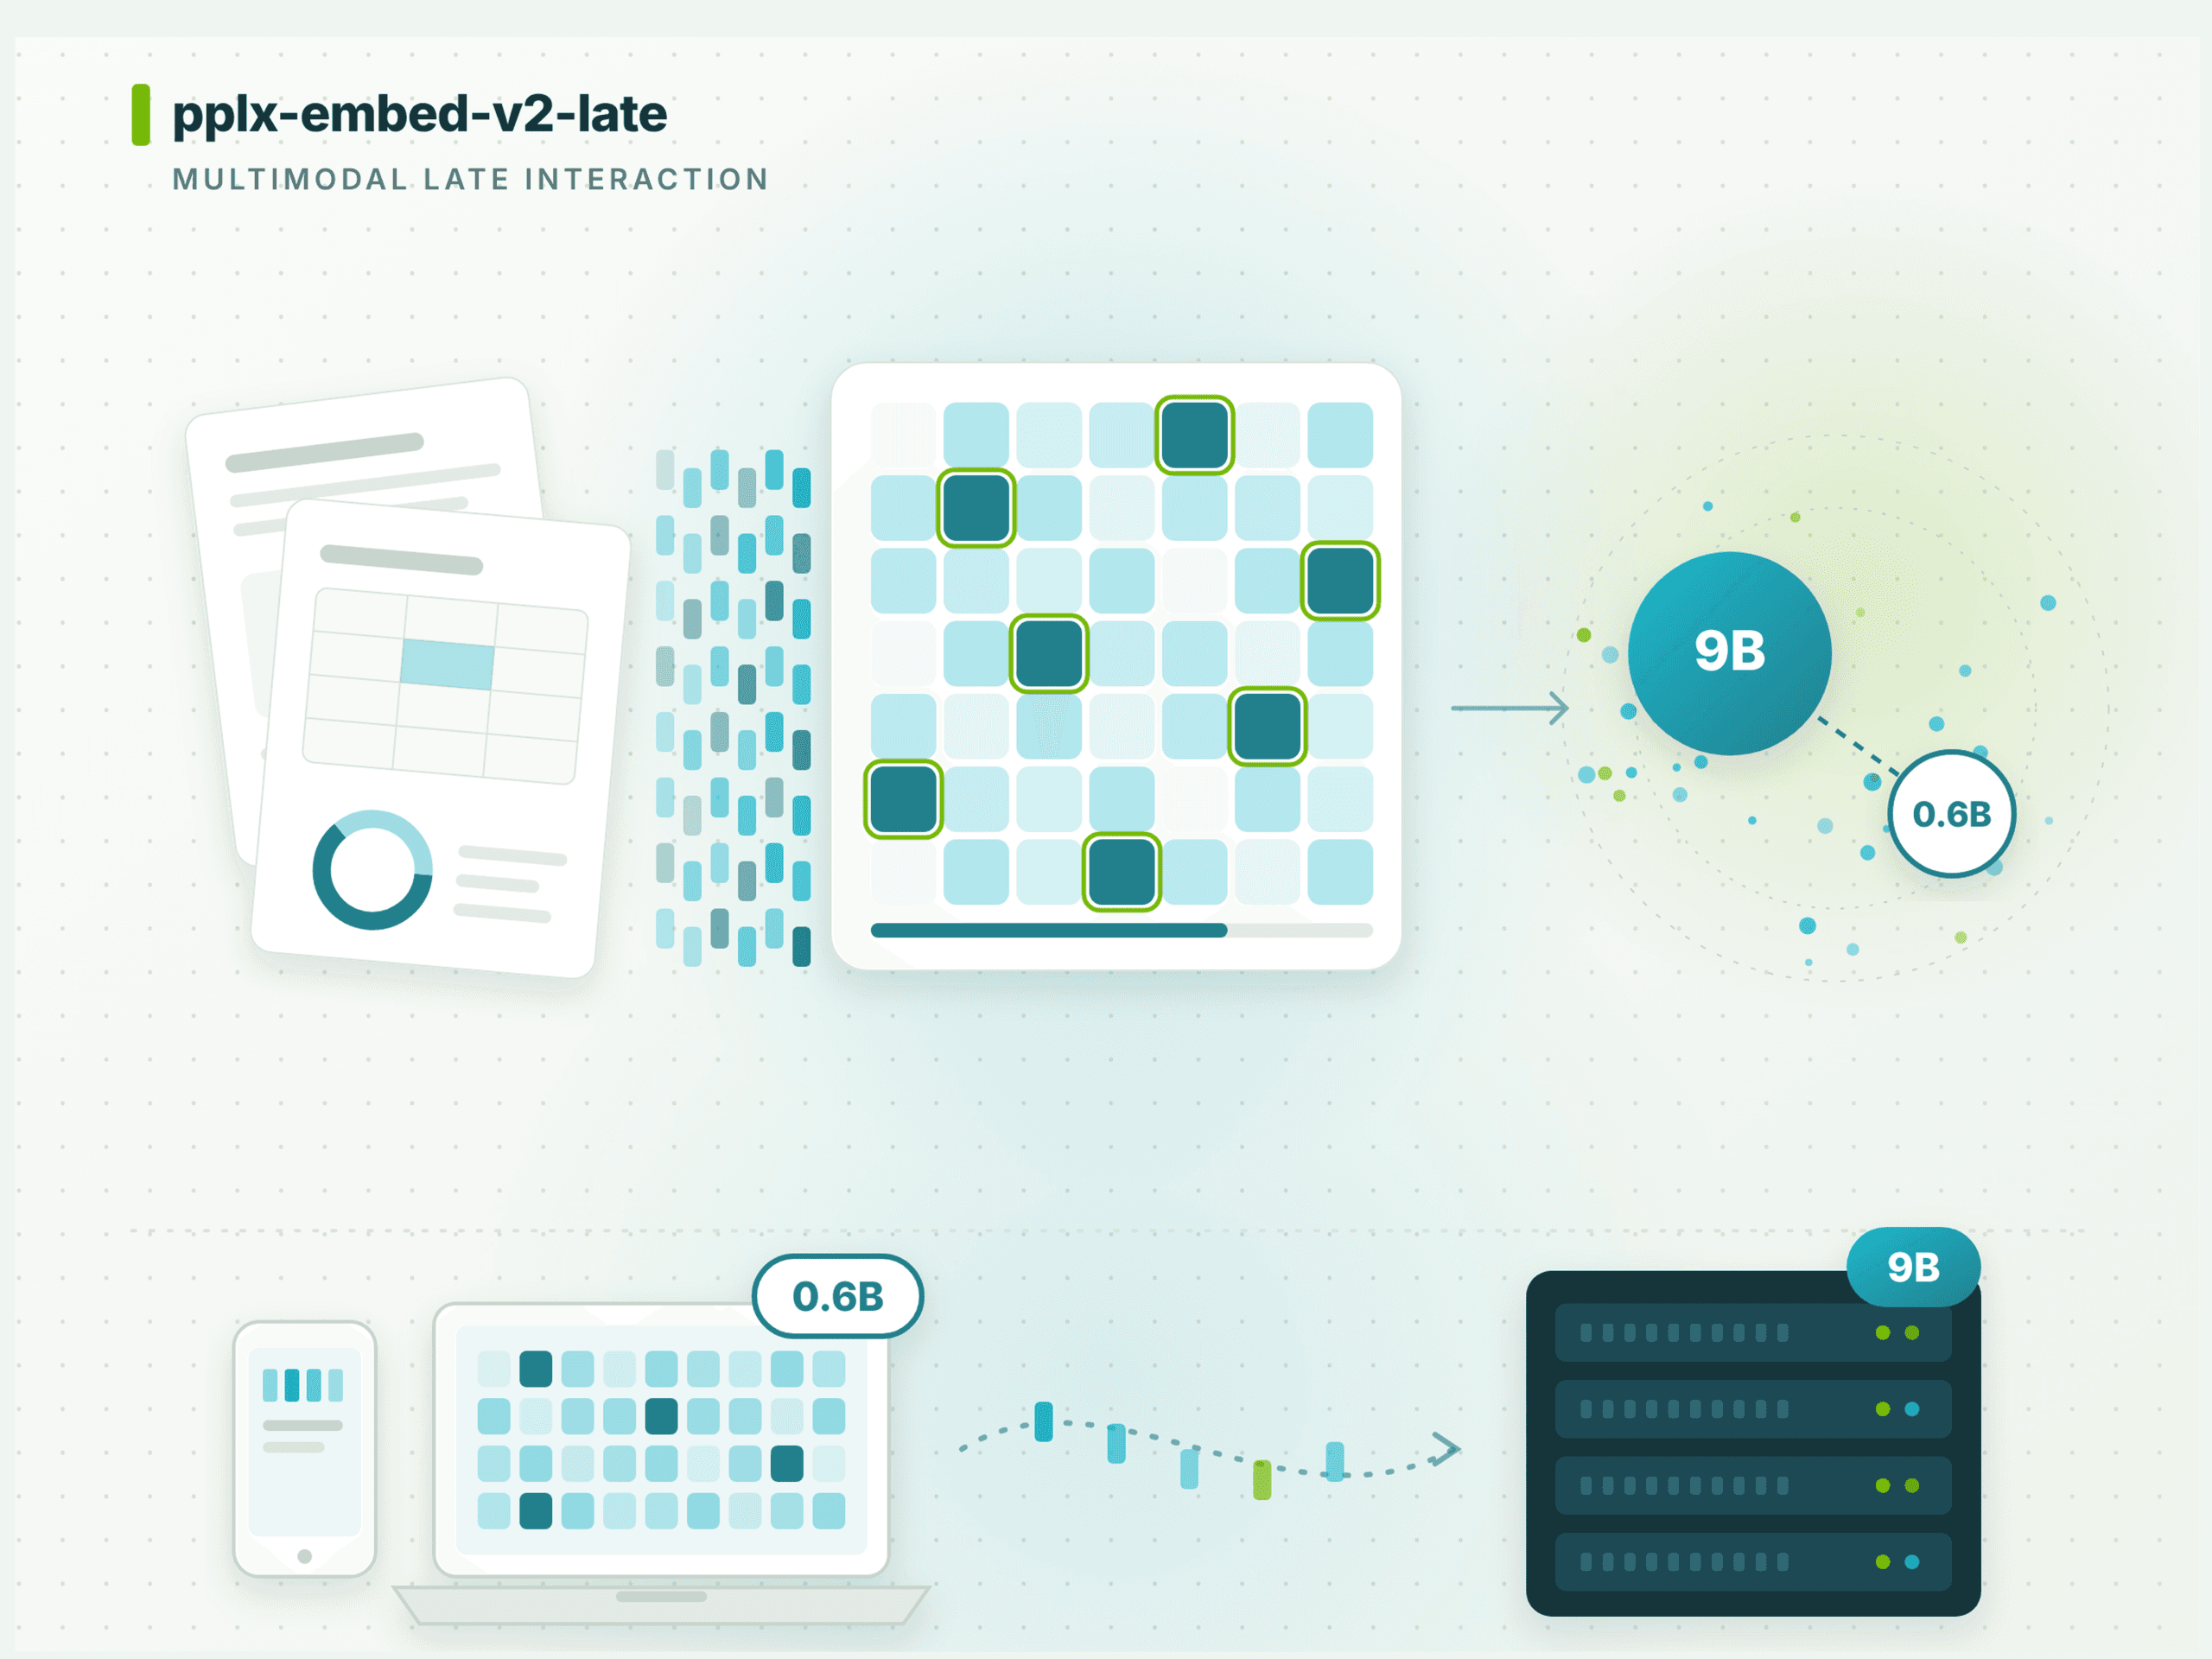
Perplexity เปิดตัว pplx-embed-v2-late คู่หูโมเดล multimodal embedding สไตล์ ColBERT ที่มาพร้อมกัน 2 ขนาด คือ 0.6B สำหรับการสืบค้นที่เน้นความเร็วและประหยัดงบ และขนาด 9B สำหรับงานคุณภาพสูง ทั้งสองรุ่นรองรับการดึงข้อมูลทั้งข้อความ รูปภาพ และหน้าเอกสาร PDF ที่ถูกเรนเดอร์ โดยใช้ embedding space ร่วมกันอย่างมีประสิทธิภาพ
สำหรับผู้ที่สนใจใช้งาน โมเดลทั้งสองเปิดให้ดาวน์โหลดผ่าน Hugging Face ภายใต้สัญญาอนุญาตแบบ MIT ทำให้สามารถนำไปโฮสต์ใช้งานเองหรือใช้ในเชิงพาณิชย์ได้ทันที ส่วนบริการผ่านเอนด์พอยต์ Perplexity API นั้นยังอยู่ในแผนการดำเนินงานและจะเปิดตัวตามมาในภายหลัง
TL;DR
ข้อดี
- โมเดล 0.6B มีพารามิเตอร์ที่ทำงาน (active parameters) เพียง 340M สำหรับรูปภาพ แต่ให้ประสิทธิภาพใกล้เคียงกับคู่แข่งที่มีขนาดถึง 8B
- สามารถใช้โมเดล 0.6B สืบค้นบน index ที่สร้างจากโมเดล 9B ได้ ซึ่งช่วยลดช่องว่างด้านคุณภาพลงครึ่งหนึ่งในราคาต้นทุนการสืบค้นที่ต่ำลงมาก
- token vector ขนาด 128 มิติ มีความแคบกว่าคู่แข่ง 16 ถึง 32 เท่า เมื่อเทียบกับขนาดทั่วไปที่ 2,048 ถึง 4,096 มิติ
- สัญญาอนุญาต MIT อนุญาตให้ใช้ในเชิงพาณิชย์ได้อย่างเสรี
ข้อเสีย
- ใช้การจัดเก็บแบบ 1 vector ต่อ 1 token ส่งผลให้ขนาดของ index เพิ่มขึ้นตามความยาวของเอกสาร
- ประสิทธิภาพการดึงข้อมูลรูปภาพบน ViDoRe v3 ยังเป็นรองโมเดล EVIE ของ Tencent
- ไม่สามารถผสมข้อความและรูปภาพในอินพุตเดียวกันได้
- ตัวเลขประสิทธิภาพทั้งหมดเป็นการรายงานโดยผู้พัฒนาเอง และยังไม่มีรายงานทางเทคนิคฉบับเต็มออกมา
ขนาดโมเดลและข้อกำหนดการใช้งาน
| เกณฑ์วัด | pplx-embed-v2-late-0.6b | pplx-embed-v2-late-9b |
|---|---|---|
| พารามิเตอร์ทั้งหมด | 594M | 9B (Hugging Face ระบุ 8B) |
| พารามิเตอร์ที่ทำงาน | ~240M ข้อความ, 340M รูปภาพ | 7.4B |
| โมเดลฐาน | Qwen3.5-0.8B, ตัดเหลือ 12 text layers | Qwen3.5 |
| เอาต์พุต | 128 มิติต่อ token | 128 มิติต่อ token |
| Weights ในหน่วยความจำ (bf16, จากการประมาณการ) | ~1.2 GB | ~16 ถึง 18 GB |
| เครื่องที่เหมาะสม | แล็ปท็อป, อุปกรณ์ edge หรือ GPU ขนาดเล็ก | Datacenter หรือ GPU หน่วยความจำสูง |
| บทบาทที่ Perplexity แนะนำ | ตัวเข้ารหัสการสืบค้นแบบสด, โลคัล 100% | การสร้าง index ของเอกสาร |
Perplexity ออกแบบโมเดล 0.6B ให้เป็นตัวเข้ารหัสการสืบค้นที่เบาพอจะรันบนอุปกรณ์ปลายทางได้ โดยข้อมูลจาก model cards ระบุว่ารองรับ CUDA GPU และต้องการ sentence-transformers >= 6.0.0 ร่วมกับ transformers >= 5.4.0 ทั้งนี้ ขนาดหน่วยความจำที่ระบุเป็นการประมาณการจากน้ำหนักโมเดลเท่านั้น แต่ checkpoint ที่เผยแพร่จริงใช้รูปแบบ F32 ซึ่งจะทำให้ขนาดดาวน์โหลดเพิ่มขึ้นเป็นสองเท่า
ประสิทธิภาพ: คะแนนที่ดีที่สุดและจุดที่ต้องพิจารณา
ตัวเลขประสิทธิภาพอ้างอิงจากประกาศของ Perplexity:
| Benchmark | 0.6B | 9B | สถานะปัจจุบัน |
|---|---|---|---|
| MADQA (agentic PDF QA, ความแม่นยำ) | 90.1% | 92.4% (ดีที่สุด) | ชนะ retriever ของ Mixedbread (88.9%); ตามหลัง Mixedbread Agentic Search (93.4%) |
| ข้อความเฉพาะทาง (72 งาน, nDCG@10) | 78.0% | 81.3% | 9B นำกลุ่มที่ทดสอบ 1.6pp; 0.6B ตามหลัง gemini-embedding-2 เพียง 0.3pp |
| Q2D-Web (Recall@1000) | 73.6% | 74.8% | ทั้งคู่ทำลายสถิติเดิมที่ 69.3% |
| รูปภาพ ViDoRe v3 (nDCG@10) | 62.3% | 65.2% | 0.6B ทำคะแนนใกล้เคียงกับ nemotron-colembed-v2-8b; EVIE ยังคงเป็นผู้นำ |
| ViDoRe v3 Markdown (nDCG@10) | 61.2% (ต่ำสุด) | 64.7% | ชนะโมเดลภายนอกทุกตัวที่นำมาทดสอบ |
| BrowseComp+ (ความแม่นยำ) | ไม่ระบุ | 64.0% (ต่ำสุด) | สูงกว่าโมเดล ColBERT อันดับถัดไป 4.9pp |
ผลลัพธ์ที่โดดเด่นที่สุดคือความแม่นยำ 92.4% บน MADQA โดยโมเดลขนาด 9B และยังทำส่วนต่างได้ดีเยี่ยมบน BrowseComp+ ซึ่งสูงกว่าโมเดล dense ที่ดีที่สุดถึง 8.7pp อย่างไรก็ตาม จุดที่อ่อนที่สุดคือการทดสอบ ViDoRe v3 Markdown ที่โมเดล 0.6B ทำได้ 61.2% แม้จะเป็นคะแนนต่ำสุดแต่ยังถือเป็นอันดับ 2 ในกลุ่มการทดสอบนั้น ส่วนด้านการสืบค้นรูปภาพ Gemini Embedding 2 ยังคงมีชัยเหนือโมเดล 9B ในหลายบททดสอบ
ความน่าสนใจอยู่ที่เทคนิคการผสมผสานขนาดโมเดล โดยพบว่าหากใช้โมเดล 0.6B สืบค้นบน index ของ 9B จะได้คะแนนบน ViDoRe v3 ที่ 63.5% ซึ่งสูงกว่าการใช้โมเดล 0.6B เพียวๆ ทั้งระบบ (62.3%) โดยที่ภาระในการประมวลผลคำค้นหายังคงเท่าเดิม
กลไกการทำงาน
ต่างจากโมเดลแบบ dense ที่บีบอัดเอกสารเหลือเพียง 1 vector แต่ pplx-embed-v2-late จะเก็บ vector ขนาด 128 มิติไว้สำหรับทุก token และใช้ MaxSim ในการให้คะแนน ซึ่งจะหาคู่ token ที่เหมาะสมที่สุดแล้วนำค่าสูงสุดมาบวกกัน นอกจากนี้ยังเข้ารหัสหน้าเอกสารเป็นรูปภาพโดยตรง ทำให้ไม่จำเป็นต้องผ่านกระบวนการ OCR
ทั้งสองโมเดลถูกสร้างขึ้นผ่านกระบวนการกลั่นกรอง (distilled) จากโมเดลครู (teacher) ขนาด 18B โดยใช้การฝึกระดับ token ตามแนวทาง LEAF ซึ่งช่วยสร้าง embedding space ร่วมกันให้โมเดลต่างขนาดทำงานสอดประสานกันได้
กรณีการใช้งานที่แนะนำ
โมเดลนี้เหมาะอย่างยิ่งสำหรับการค้นหาเอกสารที่มีองค์ประกอบทางภาพสูง เช่น ไฟล์ PDF, สไลด์นำเสนอ หรือรายงานที่มาจากการสแกน รวมถึงระบบที่ต้องการความหน่วงต่ำโดยการสร้าง index ไว้บนคลาวด์ด้วยโมเดล 9B แล้วปล่อยให้อุปกรณ์พกพาสืบค้นด้วยโมเดล 0.6B นอกจากนี้ยังตอบโจทย์งาน Agentic RAG ที่ต้องจัดการกับฐานข้อมูลเอกสารหรือหน้าเว็บขนาดใหญ่
การเปรียบเทียบกับคู่แข่ง
| ฟีเจอร์ | pplx-embed-v2-late | NVIDIA nemotron-colembed-vl-8b-v2 | TopK topk-embed-v1 | Google Gemini Embedding 2 |
|---|---|---|---|---|
| ขนาด | 0.6B, 9B | ~8.8B | 0.8B, 2B แบบเปิด | ไม่เปิดเผย |
| ความกว้างของ Vector | 128 ต่อ token | 4,096 ต่อ token | 2,048 ต่อ token | 128-3,072 (1 vector) |
| อินพุต | ข้อความ, รูปภาพ, การเรนเดอร์หน้า | ข้อความ, รูปภาพหน้าเอกสาร | ข้อความ, รูปภาพหน้าเอกสาร | ข้อความ, ภาพ, วิดีโอ, เสียง, PDF |
| การติดตั้ง | GPU ทั่วไป, Edge (0.6B) | NVIDIA A100/H100 | CUDA GPU (Ampere+) | Google API |
| ใช้ space ร่วมกัน | ใช่ | ไม่ระบุ | ไม่ระบุ | N/A |
| สัญญาอนุญาต | MIT | CC-BY-NC-4.0 | Apache 2.0 | Proprietary |
ประเด็นสำคัญที่นักพัฒนาควรคำนึงคือ แม้โมเดล 0.6B จะเหมาะกับงาน edge และ 9B จะเด่นเรื่องคุณภาพ index แต่การใช้เทคนิคเก็บ vector แยกตาม token จะแลกมาด้วยพื้นที่จัดเก็บข้อมูลที่เพิ่มขึ้นอย่างรวดเร็ว รวมถึงควรพิจารณาผลคะแนนที่รายงานโดย Perplexity ควบคู่ไปกับการทดสอบจริงในอนาคต
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร