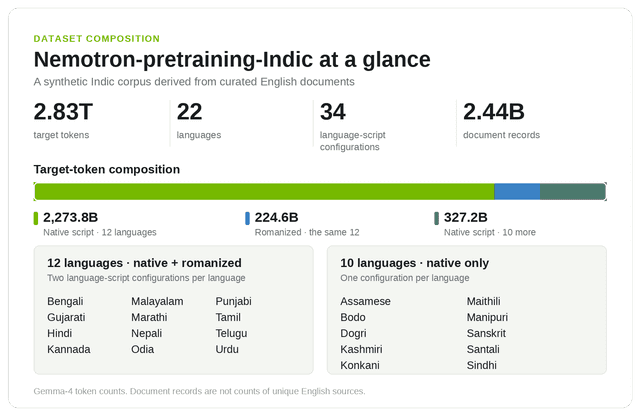
Scaling Indic Pretraining: เปิดชุดข้อมูล 2.8 ล้านล้านโทเค็นtag: Dataset, GPU Acceleration, Indic Pretraining, Natural Language ProcessingOct 16, 2026 · By: TanasakPโครงการ Scaling Indic Pretraining เปิดตัวชุดข้อมูลมหาศาลกว่า 2.8 ล้านล้านโทเค็น ครอบคลุมภาษาท้องถิ่นและรูปแบบอักษรโรมัน พร้อมเปิดพิมพ์เขียว Pipeline การประมวลผลข้อมูลผ่าน GPU
เจาะลึก SmolLM3: โมเดลภาษาขนาดเล็กประสิทธิภาพสูง พร้อมวิธีสร้างระบบ Support Ticket อัจฉริยะtag: Fine-tuning, Hugging Face, Natural Language Processing, SLM, SmolLM3, TransformersAug 7, 2026 · By: SirilukPSmolLM3 คือโมเดลขนาด 3B จาก Hugging Face ที่ออกแบบมาเพื่อทำงานเฉพาะทางแทนโมเดลใหญ่ 70B ด้วยต้นทุนที่ถูกกว่ามาก โดยรองรับการเรียกใช้เครื่องมือ การให้เหตุผล และการจัดการภาษาที่หลากหลาย