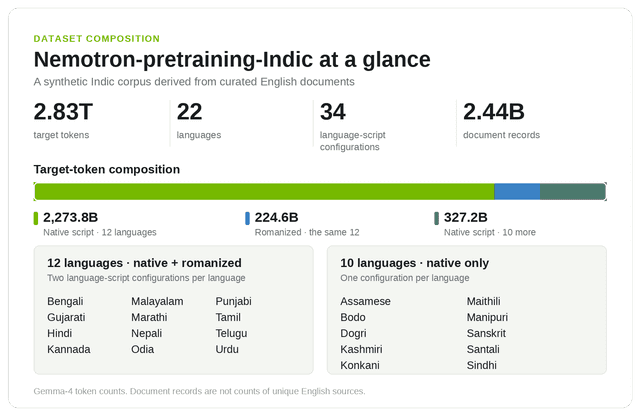
Scaling Indic Pretraining: เปิดชุดข้อมูล 2.8 ล้านล้านโทเค็นtag: Dataset, GPU Acceleration, Indic Pretraining, Natural Language ProcessingOct 16, 2026 · By: TanasakPโครงการ Scaling Indic Pretraining เปิดตัวชุดข้อมูลมหาศาลกว่า 2.8 ล้านล้านโทเค็น ครอบคลุมภาษาท้องถิ่นและรูปแบบอักษรโรมัน พร้อมเปิดพิมพ์เขียว Pipeline การประมวลผลข้อมูลผ่าน GPU