
Scaling Indic Pretraining: เปิดชุดข้อมูล 2.8 ล้านล้านโทเค็น
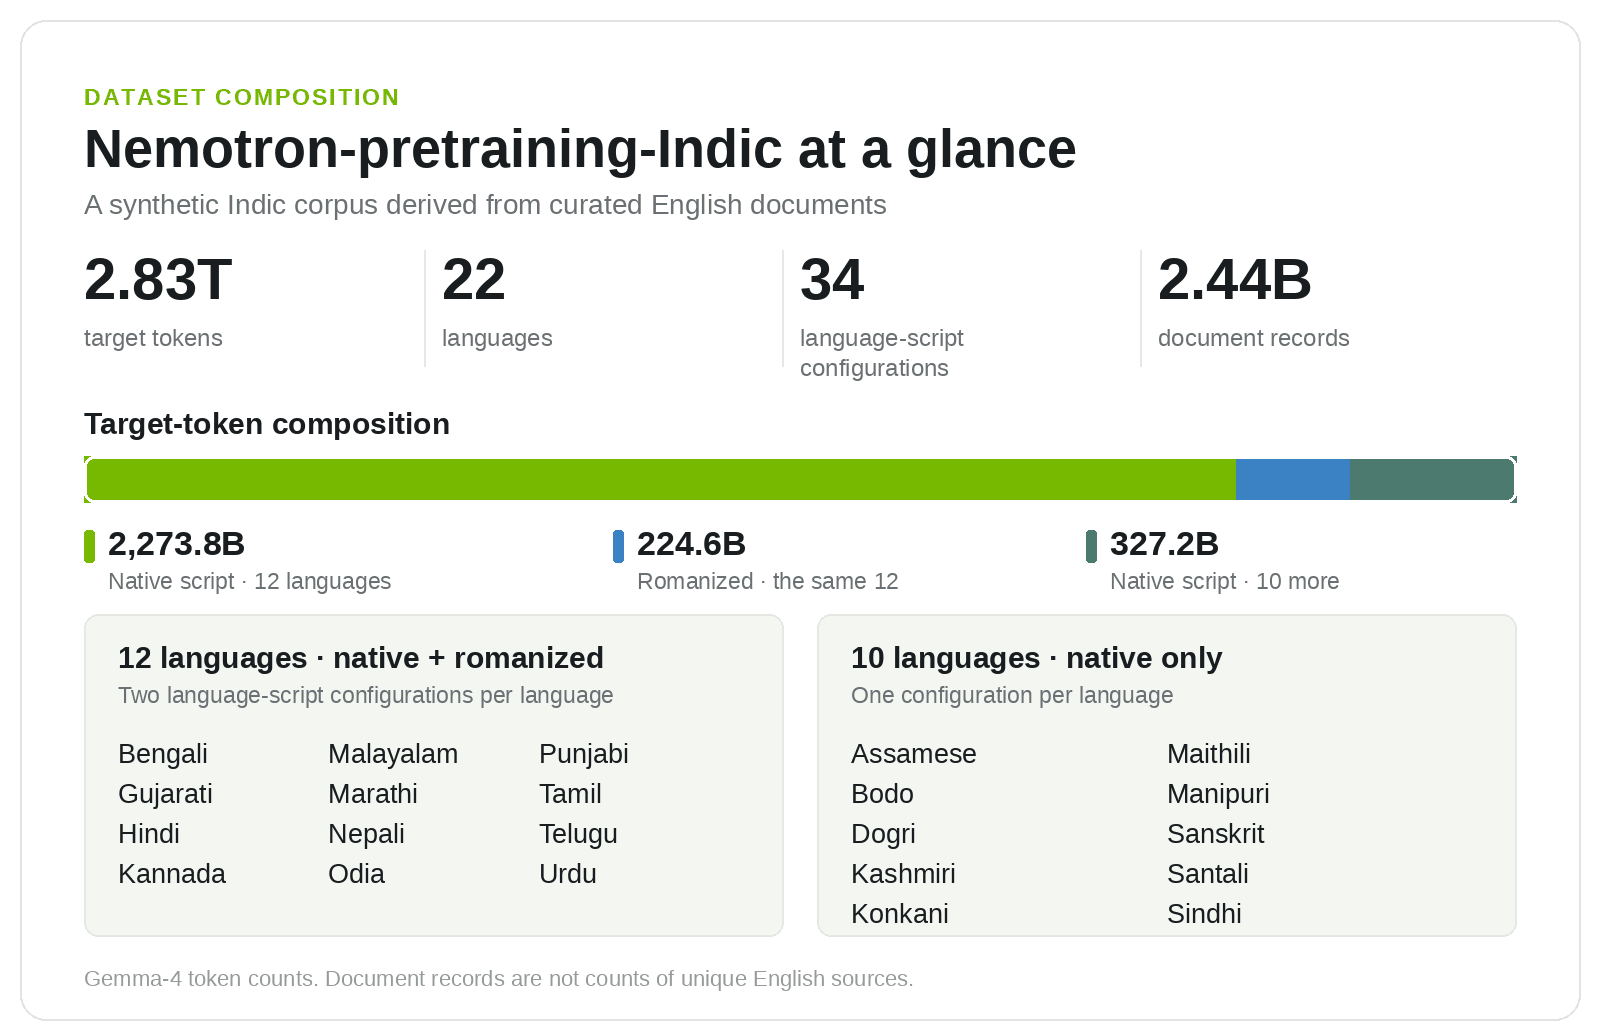
โครงการ Scaling Indic Pretraining ประสบความสำเร็จในการรวบรวมและจัดการข้อมูลขนาดใหญ่ถึง 2.8 ล้านล้านโทเค็น โดยครอบคลุมข้อมูลในสคริปต์ท้องถิ่นสำหรับ 22 ภาษา และข้อมูลในรูปแบบอักษรโรมัน (Romanized data) สำหรับอีก 12 ภาษา
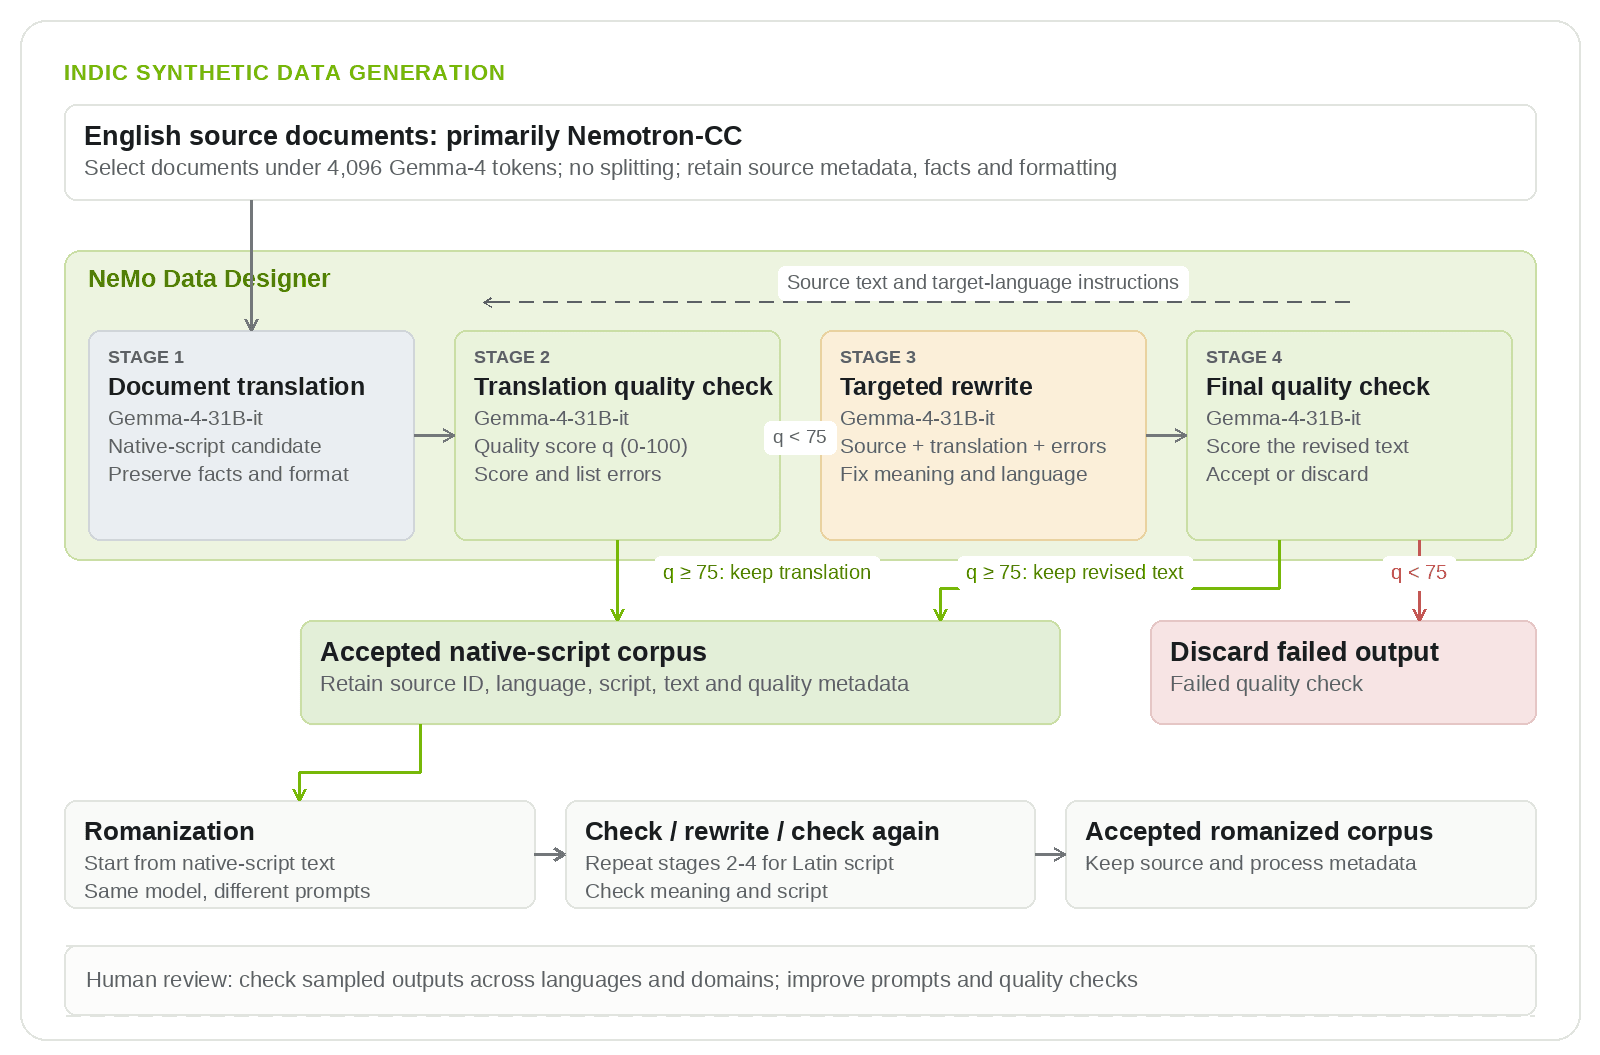
หัวใจสำคัญของความสำเร็จนี้คือการใช้ pipeline ที่เร่งการประมวลผลด้วย GPU ซึ่งถูกออกแบบมาให้นำกลับมาใช้ใหม่ได้ (reusable) ครอบคลุมทั้งกระบวนการแปล การประเมินคุณภาพ และการซ่อมแซมข้อมูล เพื่อเพิ่มประสิทธิภาพในการเตรียมข้อมูลสำหรับโมเดลภาษาขนาดใหญ่
Source: Hugging Face Blog
ดูแลงานแปลและเรียบเรียงโดย TanasakP
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร