
NVIDIA จับมือ Hugging Face เปิดตัว NeMo Automodel ยกระดับการ Fine-tune โมเดลวิดีโอและรูปภาพระดับสเกล
โพสต์ร่วมจาก NVIDIA และ Hugging Face ขอขอบคุณ Sayak Paul จาก Hugging Face เป็นพิเศษสำหรับส่วนร่วมในงานผสานรวมและสำหรับการร่วมเขียนบล็อกนี้
โมเดล Diffusion กลายเป็นหัวใจสำคัญของโปรเจกต์โอเพนซอร์สที่น่าจับตามองที่สุดในช่วงสองปีที่ผ่านมา ไม่ว่าจะเป็น FLUX.1-dev สำหรับการสร้างภาพจากข้อความ (text-to-image) หรือ Wan 2.1 และ HunyuanVideo สำหรับการสร้างวิดีโอ (text-to-video) โดยไลบรารี 🤗 Diffusers ได้กลายเป็นมาตรฐานหลักที่ช่วยให้นักวิจัยและผู้สร้างมีอินเทอร์เฟซเดียวในการทำ inference, adaptation และ pipeline composition
ปัจจุบันความต้องการในการเทรนและการ Fine-tuning โมเดล diffusion เพิ่มสูงขึ้นอย่างต่อเนื่อง ซึ่งจำเป็นต้องมีเครื่องมือที่รองรับการจัดการหน่วยความจำที่มีประสิทธิภาพ (memory-efficient sharding), การทำ latent caching, multiresolution bucketing และการขยายสเกลจาก GPU ตัวเดียวไปจนถึงหลายร้อยตัวได้อย่างราบรื่น เพื่อตอบโจทย์เหล่านี้ เราจึงเปิดตัวไลบรารีโอเพนซอร์ส NVIDIA NeMo Automodel ซึ่งเป็นความร่วมมือระหว่าง NVIDIA และ Hugging Face เพื่อนำการเทรนแบบ distributed diffusion ระดับโปรดักชั่นมาสู่โมเดลตระกูล Diffusers บน Hugging Face Hub โดยไม่จำเป็นต้องแปลง checkpoint หรือเขียนโค้ดโมเดลใหม่ การผสานรวมนี้ถูกบันทึกไว้ใน Diffusers training guide และเปิดใช้งานเป็นโอเพนซอร์สภายใต้ Apache 2.0
สารบัญ
- NeMo Automodel คืออะไร?
- โมเดล diffusion ที่รองรับ
- ความร่วมมือนี้ช่วยปลดล็อกอะไรบ้าง
- ภาพรวมของขั้นตอนการ Fine-tuning
- ตัวอย่างการ Fine-tune/LoRA อื่นๆ
- ทดลองใช้งานวันนี้
- สิ่งที่จะตามมา: Pythonic recipe APIs
- ทรัพยากร
NeMo Automodel คืออะไร?
NeMo Automodel เป็นไลบรารีการเทรนแบบ PyTorch DTensor-native โอเพนซอร์ส ซึ่งเป็นส่วนหนึ่งของ NVIDIA NeMo framework ที่สร้างขึ้นด้วยหลักการสำคัญ 2 ประการสำหรับระบบนิเวศ Diffusers:
- Hugging Face native: เพียงระบุ
pretrained_model_name_or_pathไปยัง model ID ของ Diffusers บน Hub ก็เริ่มเทรนได้ทันที โดยใช้คลาสโมเดลของ Diffusers (เช่นWanTransformer3DModel) ในการโหลด และใช้ Diffusers pipelines (WanPipeline) ในการสร้างภาพ ทำให้สามารถนำ checkpoint กลับมาใช้งานในระบบนิเวศของ Diffusers ได้อย่างไร้รอยต่อ - โปรแกรมเดียว รองรับทุกระดับสเกล: สูตร (recipes) และสคริปต์การเทรนสามารถปรับแต่งได้ง่ายเพื่อรองรับการเทรนในทุกระดับสเกล โดย Parallelism เป็นเพียงตัวเลือกในการตั้งค่า (configuration) ไม่ต้องเขียนโค้ดใหม่ คุณสามารถสลับระหว่าง FSDP2, tensor parallel, expert parallel, context parallel และ pipeline parallel ได้ผ่านการประกาศค่าในไฟล์ตั้งค่า
ปัจจุบัน AutoModel รองรับเฉพาะโมเดล flow-matching โดยใช้เทคนิค flow matching เป็นเป้าหมายการเทรน ร่วมกับการเทรนใน latent-space (ผ่านเอาต์พุต VAE ที่ pre-encoded ไว้) และการโหลดข้อมูลแบบ multiresolution bucketed เพื่อเพิ่มความเร็วในการทำงาน (throughput)
โมเดล diffusion ที่รองรับ
NeMo Automodel มาพร้อมกับสูตรการ fine-tuning ที่พร้อมใช้งานสำหรับโมเดล diffusion ดังนี้ (รายการตามสูตรปัจจุบันใน examples/diffusion/finetune):
| โมเดล | Hugging Face ID | งาน | พารามิเตอร์ | สูตร LoRA |
|---|---|---|---|---|
| Wan 2.1 T2V 1.3B / 14B | Wan-AI/Wan2.1-T2V-1.3B-Diffusers Wan-AI/Wan2.1-T2V-14B-Diffusers | Text-to-Video | 1.3B (รองรับ A100 40GB ตัวเดียว) / 14B | มี |
| Wan 2.2 T2V A14B | Wan-AI/Wan2.2-T2V-A14B-Diffusers | Text-to-Video | รวม 27B (MoE), 14B ขณะทำงาน | ไม่มี |
| FLUX.1-dev | black-forest-labs/FLUX.1-dev | Text-to-Image | 12B | มี |
| FLUX.2-dev | black-forest-labs/FLUX.2-dev | Text-to-Image | 32B | มี |
| HunyuanVideo 1.5 | hunyuanvideo-community/HunyuanVideo-1.5-Diffusers-720p_t2v | Text-to-Video | 13B | มี |
| Qwen-Image | Qwen/Qwen-Image | Text-to-Image | 20B (MMDiT) | มี |
ความร่วมมือนี้ช่วยปลดล็อกอะไรบ้าง
สำหรับผู้ใช้ Diffusers ความร่วมมือนี้มุ่งเน้นการเพิ่มขีดความสามารถที่จับต้องได้จริงดังนี้:
ไม่ต้องแปลง checkpoint: สามารถใช้น้ำหนักโมเดล (weights) จาก Hub ได้ทันที ไม่ต้องมีขั้นตอนการแปลงสลับรูปแบบไปมา โดย checkpoint ที่ผ่านการ fine-tune แล้วสามารถโหลดเข้าสู่ DiffusionPipeline เพื่อทำ inference หรืออัปโหลดกลับไปยัง Hub ได้โดยตรง ทำให้ยังใช้งานเครื่องมืออื่นๆ เช่น quantization, LoRA adapters หรือ custom samplers ได้เหมือนเดิม
ทางลัดรองรับโมเดลใหม่: เมื่อมีโมเดล diffusion ใหม่บน Diffusers การเพิ่มการรองรับใน NeMo Automodel จะทำได้เร็วมาก เพียงเพิ่มโค้ดเล็กน้อยในส่วนการประมวลผลข้อมูลและ model adapter โดยไม่ต้องเริ่มเขียนสคริปต์การเทรนใหม่ทั้งหมด
ยืดหยุ่นทั้ง Full Fine-tuning และ LoRA: รองรับทั้งการทำ Full fine-tuning เพื่อคุณภาพสูงสุดบนคลัสเตอร์ขนาดใหญ่ หรือจะเลือกทำ LoRA (PEFT) เพื่อความประหยัดและรวดเร็วบนโหนดเดียว โดยใช้โครงสร้างสูตรเดียวกันจัดการ
ขยายสเกลได้เหนือกว่าสคริปต์พื้นฐาน: NeMo Automodel เพิ่มการทำ sharding ขั้นสูง เช่น FSDP2, tensor, context และ pipeline parallelisms รวมถึงการจัดการหลายโหนด (รองรับ SLURM และกำลังพัฒนาสำหรับ Kubernetes) ทำให้การเทรนโมเดลขนาดใหญ่ระดับ FLUX.1 (12B) หรือ HunyuanVideo (13B) เป็นเรื่องที่เป็นไปได้
ภาพรวมของขั้นตอนการ Fine-tuning
วิธีที่แนะนำในการใช้งานคือผ่าน NeMo Automodel Docker container (nvcr.io/nvidia/nemo-automodel:26.06) ที่ติดตั้ง PyTorch และ TransformerEngine มาให้แล้ว หรือติดตั้งผ่าน pip3 install nemo-automodel ดูรายละเอียดได้ที่ คู่มือการติดตั้ง
ในตัวอย่างนี้ เราจะสาธิตการทำ full fine-tune ของ FLUX.1-dev โดยใช้ Rider–Waite tarot dataset จำนวน 78 ใบ โดยใช้ YAML config เดิมและปรับเปลี่ยนค่าผ่าน command-line
1. การ Pre-encode ชุดข้อมูล
เราจะใช้ VAE latents และ text embeddings ที่แคชไว้เพื่อความสะดวก โดยดึงภาพจาก Hugging Face และประมวลผลผ่าน GPU ทั้งหมด:
uv run --locked --no-default-groups \
  --extra diffusion \
  --extra diffusion-media \
python -m tools.diffusion.preprocessing_multiprocess image \
  --dataset_name multimodalart/1920-raider-waite-tarot-public-domain \
  --dataset_media_column image \
  --dataset_caption_column caption \
  --dataset_streaming \
  --max_images 78 \
  --output_dir /cache/flux_tarot \
  --processor flux \
  --model_name black-forest-labs/FLUX.1-dev \
  --max_pixels 245760
ผลลัพธ์จะได้ไฟล์แคช .pt และ metadata ที่จัดระเบียบพร้อมสำหรับการเทรน:
/cache/flux_tarot/
├── 384x640/
│   ├── <hash1>.pt
│   └── ...
├── metadata_shard_0000.json
├── metadata.json
└── _hf_dataset/
    └── images/
2. เริ่มการเทรนด้วย FLUX YAML ที่มีอยู่
ใช้สคริปต์ finetune.py ร่วมกับไฟล์ YAML มาตรฐานของ FLUX พร้อมระบุพาธและพารามิเตอร์ที่ต้องการ:
uv run --locked --no-default-groups --extra diffusion \
  torchrun --nproc-per-node=8 \
  examples/diffusion/finetune/finetune.py \
  -c examples/diffusion/finetune/flux_t2i_flow.yaml \
  --model.transformer_engine_fp8 false \
  --data.dataloader.cache_dir /cache/flux_tarot \
  --data.dataloader.base_resolution '[384,640]' \
  --lr_scheduler.lr_decay_style constant \
  --lr_scheduler.lr_warmup_steps 20 \
  --step_scheduler.max_steps 200 \
  --step_scheduler.ckpt_every_steps 50 \
  --checkpoint.checkpoint_dir /tmp/flux_tarot/checkpoints/full \
  --checkpoint.save_consolidated true \
  --seed 2026
3. สร้างภาพจาก checkpoint ที่ fine-tune แล้ว
ทดสอบการสร้างภาพโดยใช้ checkpoint ที่สเต็ป 200:
uv run --locked --no-default-groups --extra diffusion \
  python examples/diffusion/generate/generate.py \
  -c examples/diffusion/generate/configs/generate_flux.yaml \
  --model.checkpoint /tmp/flux_tarot/checkpoints/full/epoch_66_step_199 \
  --inference.height 640 \
  --inference.width 384 \
  --inference.prompts '["a trtcrd of an astronaut tending a rose garden on Mars, \"the gardener\""]' \
  --output.output_dir /tmp/flux_tarot/generations/full/step_200 \
  --seed 2026
ผลลัพธ์
ที่สเต็ป 200 เมื่อใช้ trigger token trtcrd ภาพที่ได้จะเปลี่ยนจากภาพถ่ายปกติเป็นสไตล์ไพ่ทาโรต์ที่มีสีวินเทจและเส้นหมึกชัดเจน ในขณะที่หากไม่ใส่ keyword นี้ ภาพจะมีสไตล์แบบเดิม แสดงให้เห็นว่าโมเดลเรียนรู้สไตล์ใหม่ได้อย่างแม่นยำโดยไม่ทำลายความรู้เดิม
| พรอมต์ (seed) | พื้นฐาน | Fine-tuned (สเต็ป 200) |
|---|---|---|
| นักบินอวกาศดูแลสวนกุหลาบบนดาวอังคาร (seed 2026) | 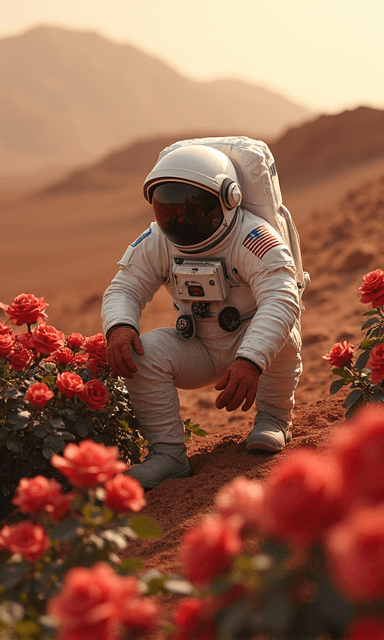 | 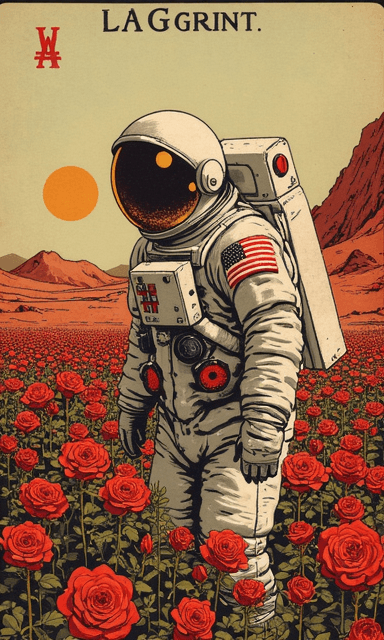 |
| นักบินอวกาศในสวนใต้แสงจันทร์บนดาวอังคาร (seed 2028) | 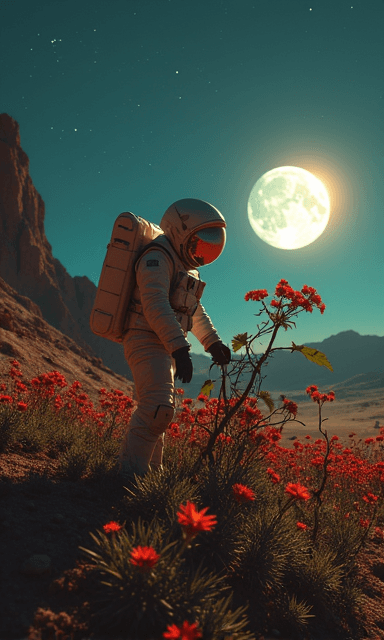 | 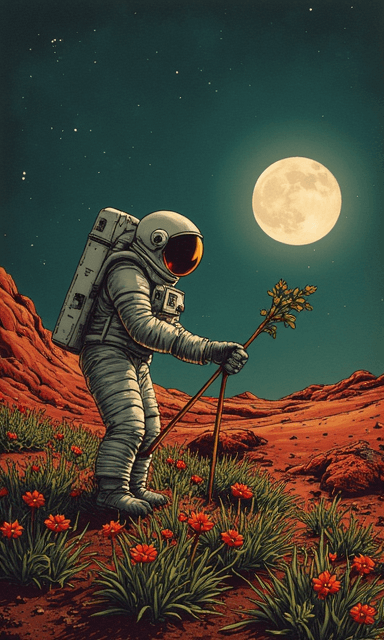 |
| นักบินอวกาศปลูกต้นกล้าใต้ดวงจันทร์สองดวง (seed 2029) | 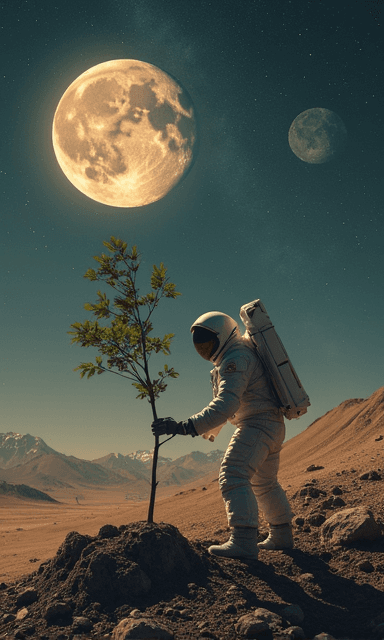 | 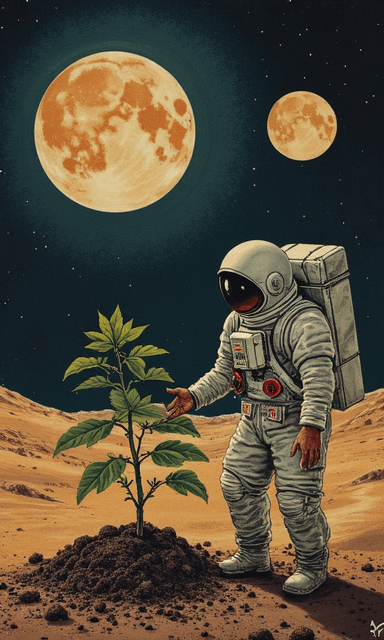 |
4. ประสิทธิภาพ
การวัดประสิทธิภาพบนโหนด NVIDIA H100 80GB (8 ตัว) พบข้อมูลที่น่าสนใจดังนี้:
Text-to-image — 512×512
| โมเดล | การเทรน | Parallelism | GBS / LBS | เวลาต่อสเต็ป | ภาพ/วินาที | หน่วยความจำสูงสุด/GPU |
|---|---|---|---|---|---|---|
| FLUX.1-dev | Full | FSDP2 | 32 / 4 | 0.902 วินาที | 35.51 | 63.88 GiB |
| Qwen-Image | Full | FSDP2 | 40 / 5 | 0.974 วินาที | 41.21 | 53.55 GiB |
Text-to-video — 512×512×49 เฟรม
| โมเดล | การเทรน | GBS / LBS | Activation checkpointing | เวลาต่อสเต็ป | คลิป/วินาที | หน่วยความจำสูงสุด/GPU |
|---|---|---|---|---|---|---|
| Wan 2.1 14B | Full | 8 / 1 | เปิด | 3.798 วินาที | 2.107 | 33.35 GiB |
| HunyuanVideo 1.5 | Full | 8 / 1 | เปิด | 5.926 วินาที | 1.350 | 15.90 GiB |
ตัวอย่างการ Fine-tune/LoRA อื่นๆ
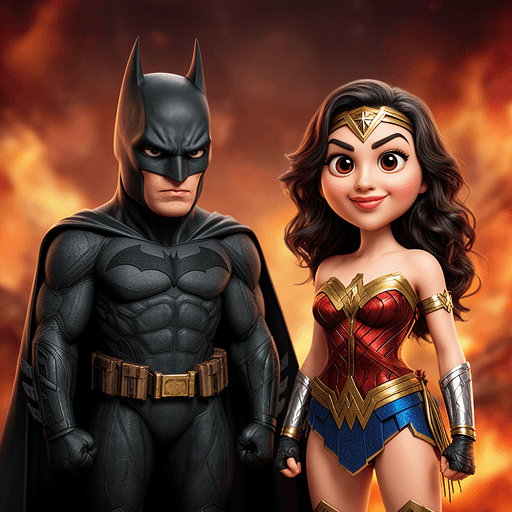
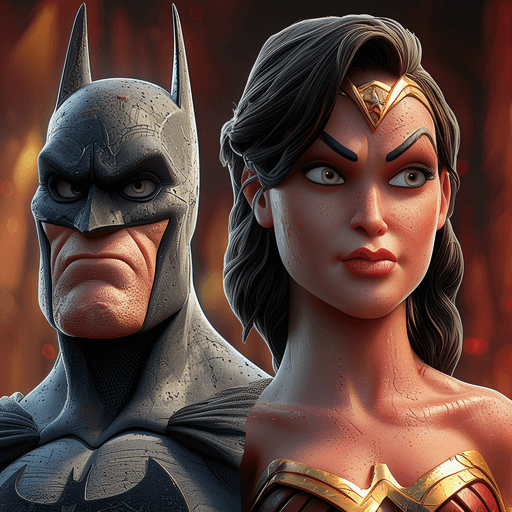
ผลการทดสอบกับโมเดล Wan 2.1 ในสไตล์สตูดิโอ Ghibli พบว่าการ fine-tuning แบบเต็มรูปแบบให้คุณภาพการเคลื่อนไหวและลายเส้นที่ลึกซึ้ง ขณะที่การใช้ LoRA สามารถใส่เอกลักษณ์ของตัวละคร (เช่น ตา) ได้อย่างมีประสิทธิภาพ
ผลลัพธ์เปรียบเทียบ: (ดูรูปภาพประกอบด้านล่าง)
 |  |
 |  |
ทดลองใช้งานวันนี้
สามารถศึกษารายละเอียดและตัวอย่างเพิ่มเติมได้ที่ เอกสาร NeMo Automodel
สิ่งที่จะตามมา: Pythonic recipe APIs
แม้ YAML จะเหมาะสำหรับการทำซ้ำ แต่ในอนาคต NeMo Automodel จะนำเสนอ Pythonic API แบบ typed สมบูรณ์ เพื่อให้ผู้ใช้ประกอบโมเดล, ตัวเพิ่มประสิทธิภาพ (optimizer) และตั้งค่า parallelism ผ่าน Python ได้โดยตรง ซึ่งจะช่วยให้การทำงานร่วมกับ notebooks หรือ pipeline เดิมทำได้สะดวกยิ่งขึ้น
ทรัพยากร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร