
เจาะลึกการ Fine-Tuning ฉบับมือใหม่: เปลี่ยน AI ให้เก่งเฉพาะทางอย่างมืออาชีพ
บทนำ
บทความนี้เป็นส่วนหนึ่งของซีรีส์สำหรับมือใหม่ โดยผมตั้งใจจะอธิบายหัวข้อที่ผู้คนค้นหาใน Google มากที่สุด แต่ยังมีความเข้าใจที่คลาดเคลื่อนเนื่องจากความซับซ้อนทางด้านคณิตศาสตร์ ดังนั้น หากคุณเคยได้ยินคำว่า "fine-tuning" มาก่อน โดยเฉพาะในยุคของ Large Language Models (LLMs) นี่คือสิ่งที่คุณต้องรู้ แม้แนวคิดนี้จะมีอยู่ในวงการ Machine Learning มานานแล้ว แต่ได้รับความนิยมพุ่งสูงขึ้นหลังจากที่ทุกคนสามารถเข้าถึงโมเดลพื้นฐานขนาดใหญ่ที่ฝึกฝนมาล่วงหน้าได้ ซึ่งคุณสามารถนำมาปรับเปลี่ยนตามเป้าหมาย ความต้องการ และโทนเสียงที่คุณต้องการ
กระบวนการปรับแต่งนี้เรียกว่า fine-tuning ซึ่งเป็นการกระทำที่นิยมมากที่สุดในปัจจุบัน แต่คุณจะไม่เข้าใจความหมายของมันเลยหากไม่รู้จักขั้นตอนก่อนหน้าอย่าง "pretraining" เพราะการ fine-tuning คือการ "ปรับจูน" สิ่งที่มีอยู่แล้ว ซึ่งก็คือ pretrained model นั่นเอง เรามาย่อยแนวคิดเหล่านี้เพื่อให้คุณอธิบายต่อได้อย่างมั่นใจกันครับ
Pretraining คืออะไร?
หากคุณเริ่มสร้างโมเดลใหม่แกะกล่องที่มีพารามิเตอร์นับล้านหรือพันล้านตัวซึ่งถูกสุ่มค่าไว้ แล้วพยายามสอนงานที่เจาะจงทันที เช่น การแยกประเภทภาพยนตร์ โมเดลจะต้องเรียนรู้ตั้งแต่วิทยาศาสตร์ภาษาอังกฤษพื้นฐานไปพร้อมๆ กัน ซึ่งแทบเป็นไปไม่ได้เลยในชุดข้อมูลที่จำกัด มันเหมือนกับการสอนวิชาชีววิทยาให้กับเด็กหัดเดินที่ยังไม่เข้าใจภาษาด้วยซ้ำ
Pretraining เข้ามาแก้ปัญหานี้ด้วยการสอนสิ่งที่ยากและเป็นเรื่องทั่วไปครั้งเดียวจากข้อมูลมหาศาล แม้ขั้นตอนนี้จะต้องใช้พลังการประมวลผล (Compute) และข้อมูลสูงมาก แต่เมื่อเสร็จสิ้น คุณจะได้โมเดลที่เข้าใจภาษาอย่างถ่องแท้ โดยหัวใจหลักคือการสอนให้มัน "ทำนายคำถัดไป" หากทายถูกค่าความสูญเสีย (loss) จะต่ำ แต่หากทายผิดค่าจะสูง ทำให้โมเดลต้องปรับตัว
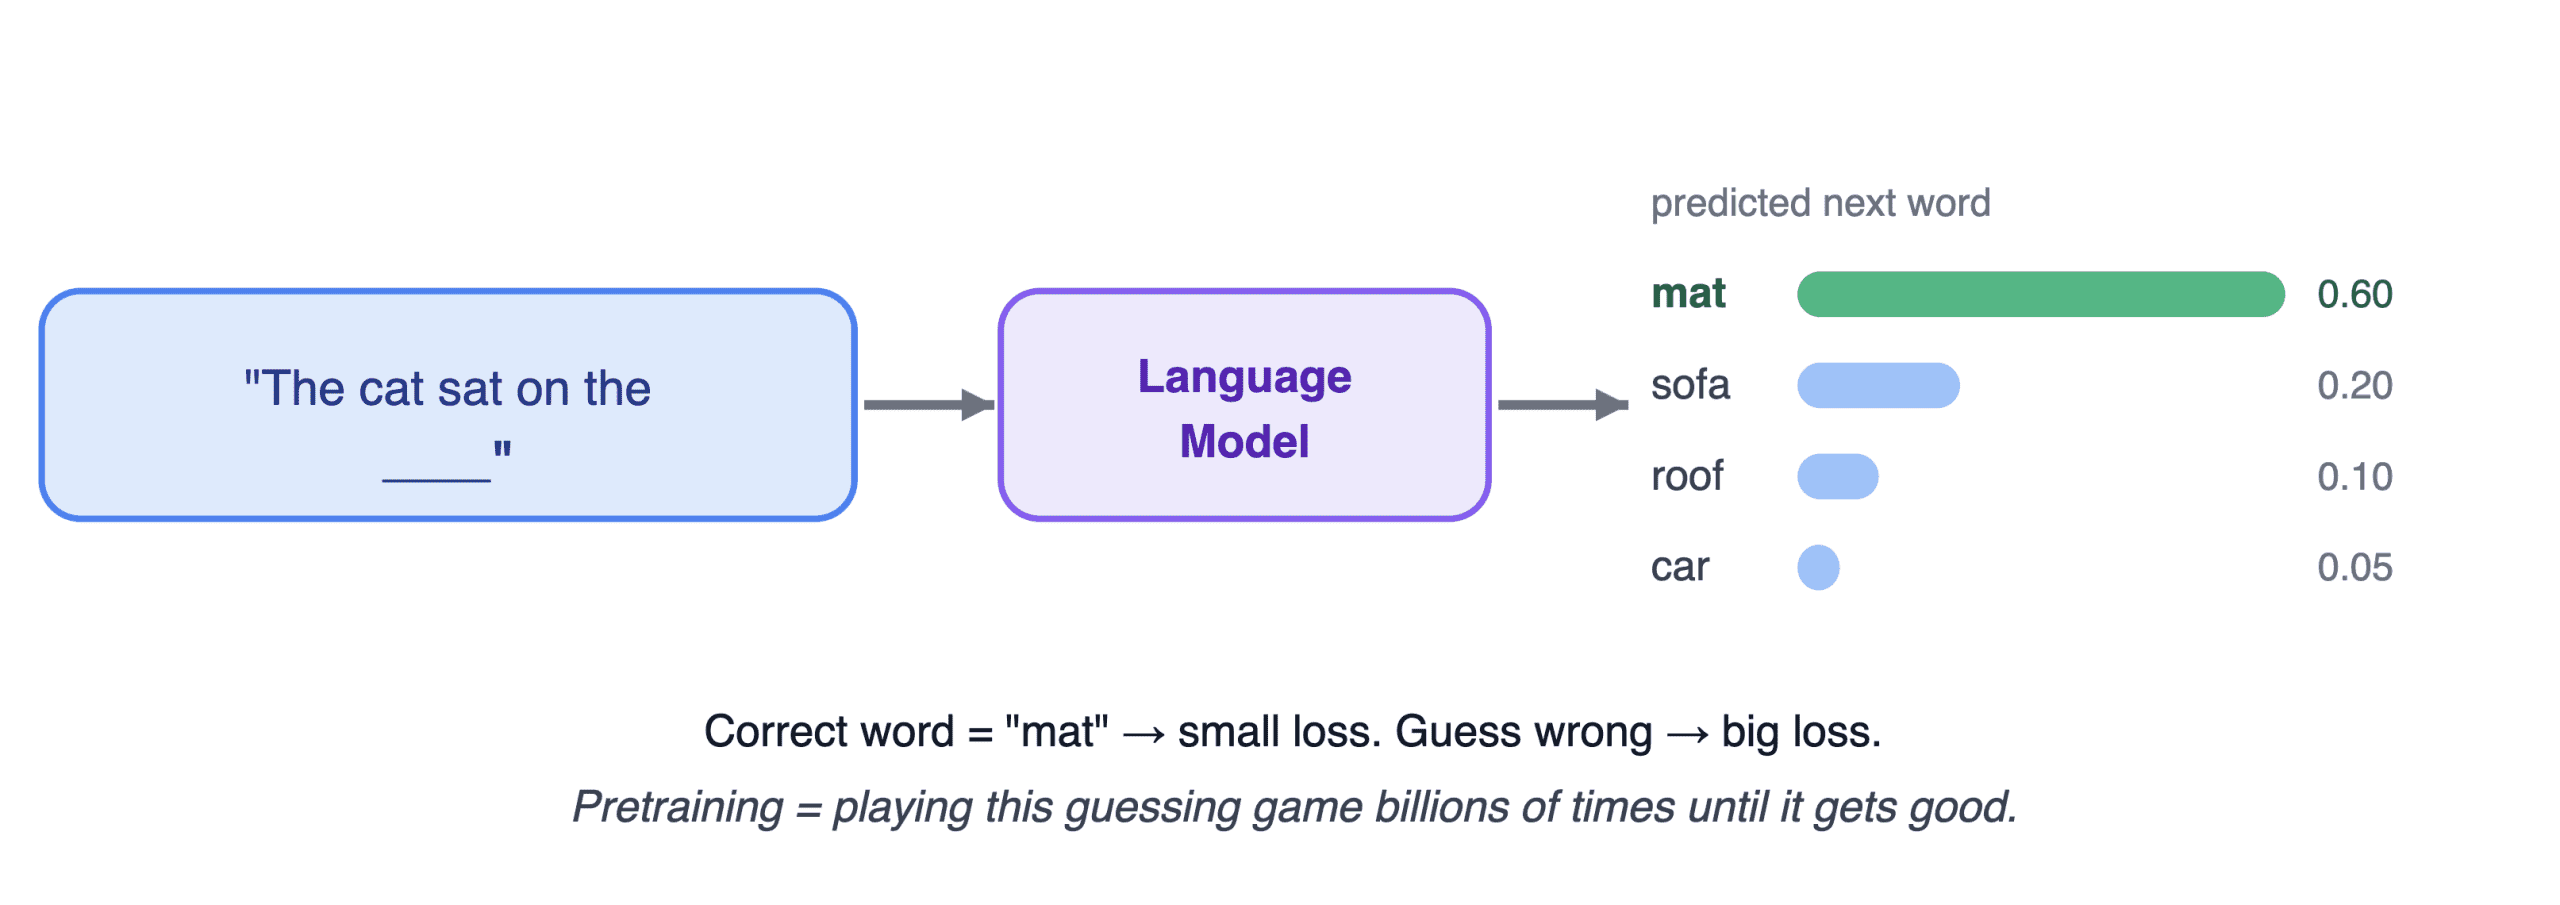
ตัวอย่างเช่นในแผนภาพ หากเราป้อนประโยคว่า "The cat sat on the ____" โมเดลจะเรียนรู้ว่า "mat" มีความเป็นไปได้สูงกว่า "car" การฝึกฝนซ้ำๆ กับหนังสือและบทความนับพันล้านรายการทำให้โมเดลกลายเป็นผู้เชี่ยวชาญด้านภาษา ซึมซับไวยากรณ์ ข้อเท็จจริง และตรรกะ จนกลายเป็นสิ่งที่เรียกว่า foundation models (โมเดลรากฐาน)
ในชีวิตจริง คุณแทบไม่ต้องทำ pretraining เองเลย แต่จะดาวน์โหลดโมเดลสำเร็จรูปอย่าง Llama, Mistral, หรือ Qwen มาเริ่มต้นใช้งาน ซึ่งนำเราไปสู่หัวใจสำคัญนั่นคือการ fine-tuning
Fine-Tuning คืออะไร?
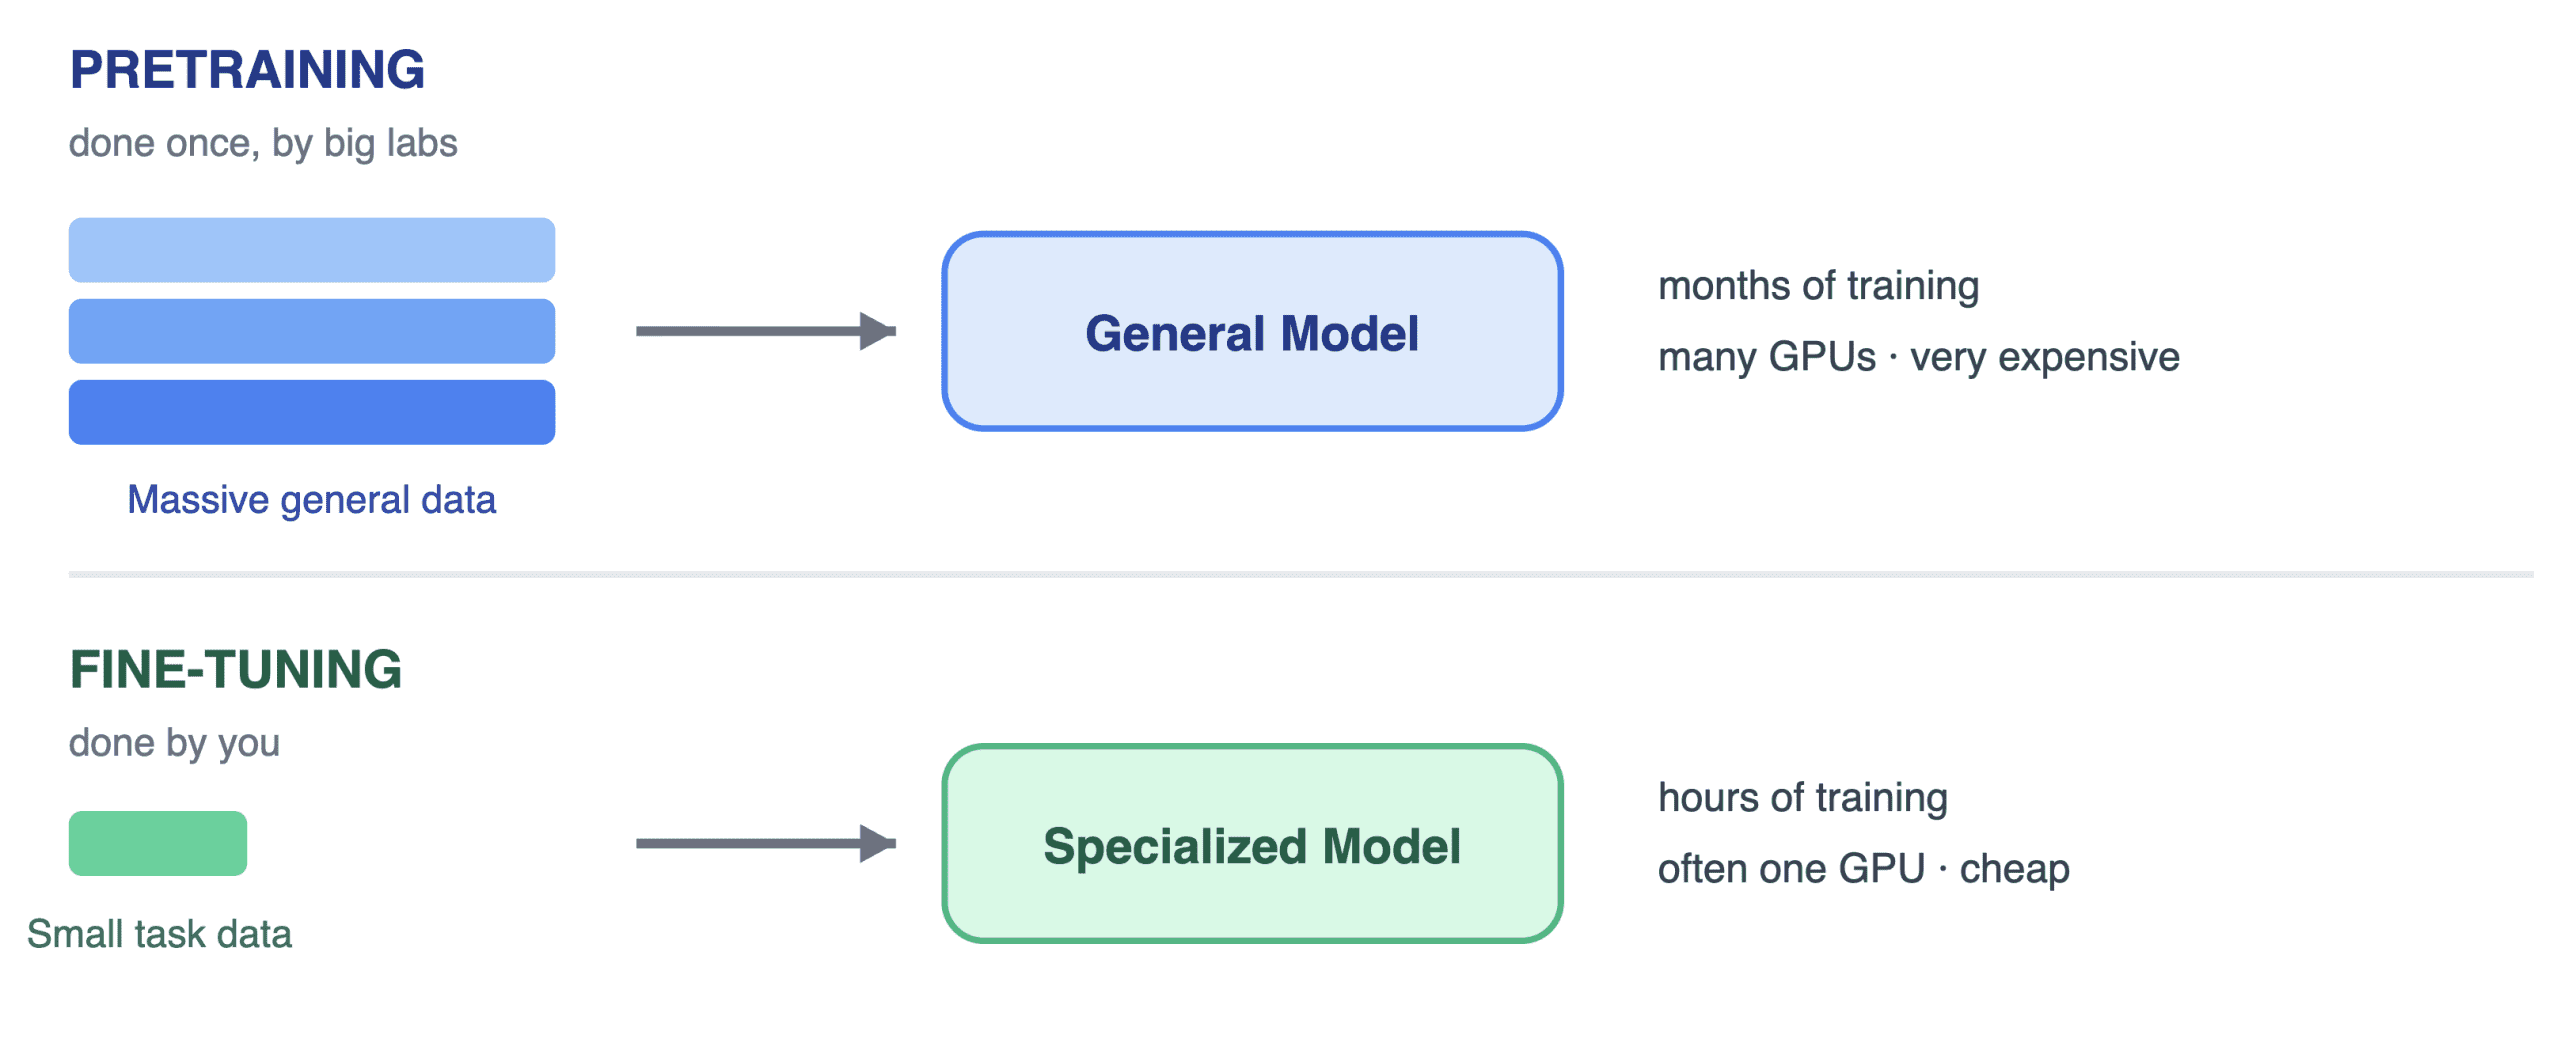
มือใหม่หลายคนมักเข้าใจผิดว่าค่าน้ำหนัก (weights) ของโมเดลจะถูกแช่แข็งหลังฝึกเสร็จ แต่ความจริงแล้ว pretrained model คือการตั้งค่าค่าน้ำหนักไว้ใน "ระดับที่ดี" แล้ว คุณสามารถปรับความฉลาดนั้นให้ตรงกับงานเฉพาะด้านของคุณได้ด้วยข้อมูลเฉพาะทาง ซึ่งกระบวนการนี้เรียกว่า "fine-tuning" โดยใช้ปริมาณข้อมูลน้อยกว่า pretraining มหาศาล
เปรียบได้กับเชฟที่เรียนจบจากโรงเรียนทำอาหารพื้นฐานมาเหมือนกัน แต่เมื่อเข้าทำงานในร้านอาหารเฉพาะแห่ง พวกเขาแค่ต้องเรียนรู้เมนูและเทคนิคเฉพาะของร้านนั้นๆ การฝึกต่อยอดจึงใช้เวลาน้อยกว่าการสอนคนที่ไม่เคยทำอาหารเลย แผนภาพด้านล่างจะช่วยให้เห็นความแตกต่างที่ชัดเจนขึ้น
Fine-Tuning ทำอย่างไร?
เมื่อเข้าใจพื้นฐานแล้ว มาดูวงจรการทำงานของการ fine-tuning กันครับ
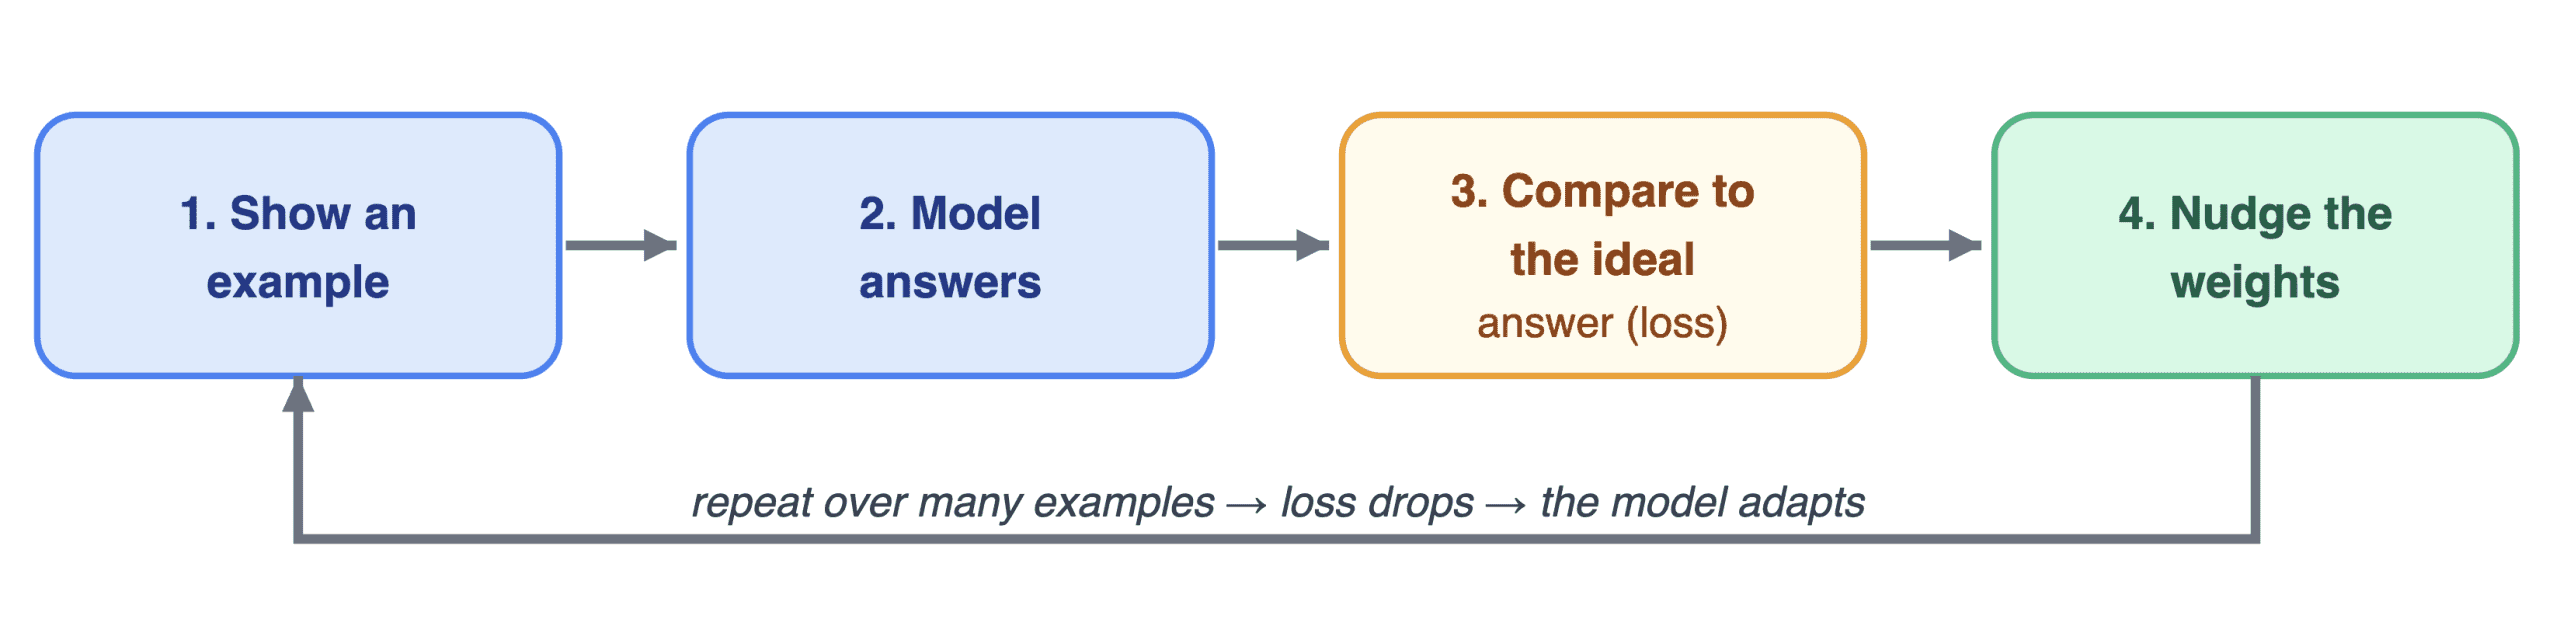
คุณต้องป้อนข้อมูลเฉพาะงานให้โมเดล เช่น ข้อมูลภาพยนตร์ เพื่อให้มันลองทำนายและแยกประเภท จากนั้นเปรียบเทียบกับคำตอบที่ถูกต้อง แล้วปรับค่าน้ำหนักเล็กน้อยวนไปจนกว่าโมเดลจะแม่นยำในงานนั้น (downstream task) โดยมีความแตกต่างสำคัญ 2 อย่างคือ:
- Data: ใช้ข้อมูลเฉพาะทางขนาดเล็กแต่คุณภาพสูง แทนที่จะใช้ข้อมูลทั้งอินเทอร์เน็ต
- Learning Rate: ใช้อัตราการเรียนรู้ที่ต่ำและรอบการเทรนน้อย เพื่อให้โมเดลปรับตัวได้โดยไม่สูญเสียความรู้ทั่วไปที่มีอยู่เดิม
Fine-Tuning 2 ประเภทที่พบบ่อย
หากแบ่งตามจำนวนพารามิเตอร์ที่ต้องปรับจูน เราจะแบ่งได้เป็น 2 ประเภทหลัก:
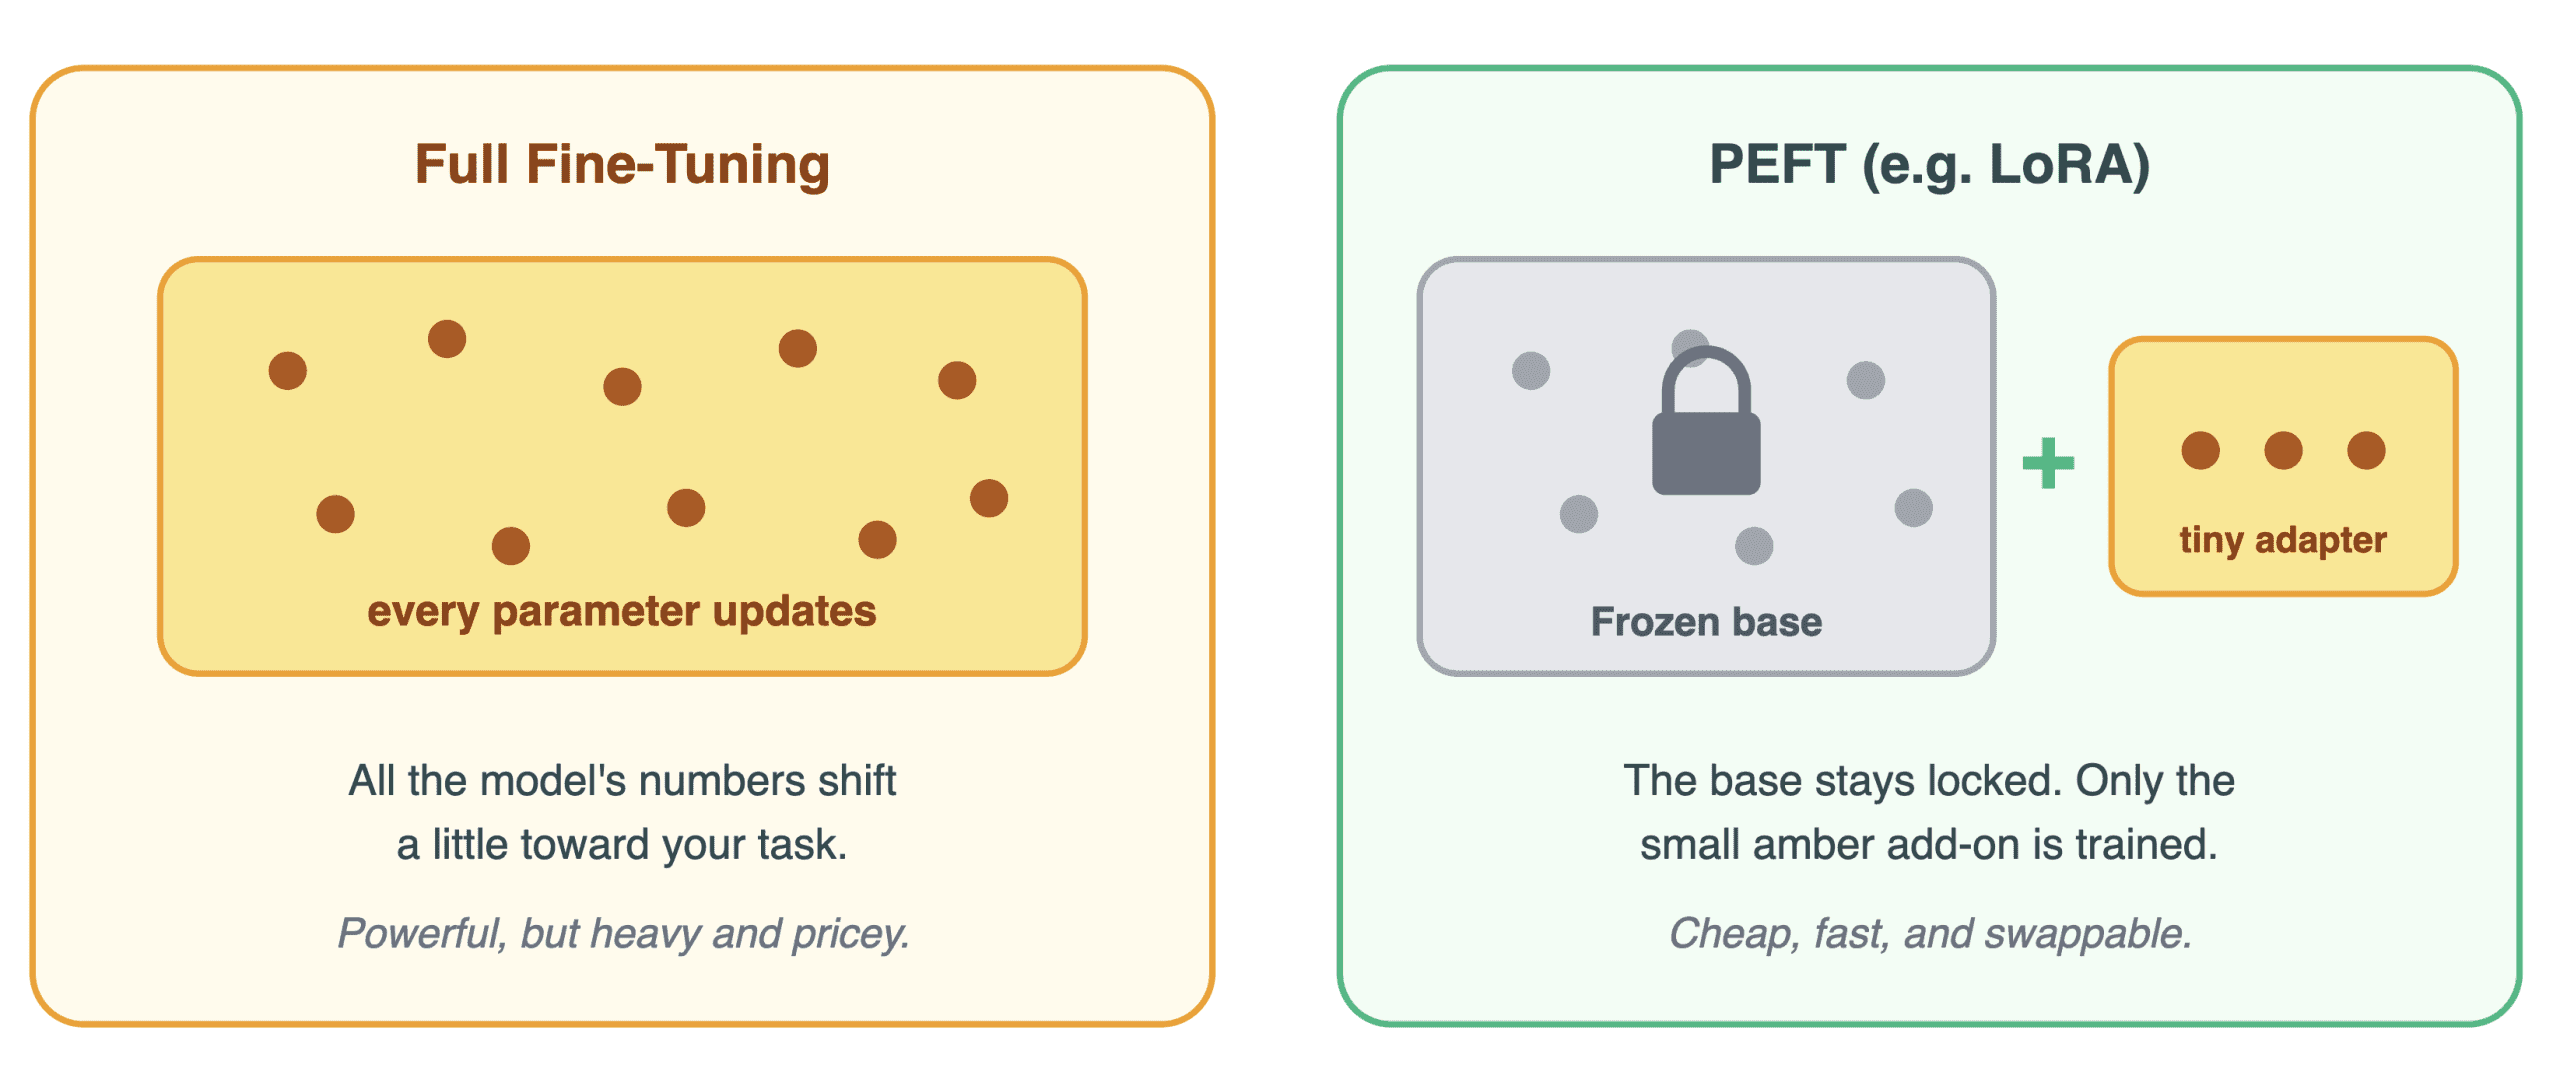
- Full Fine-Tuning: การปรับจูนพารามิเตอร์ทุกตัวในโมเดล ข้อเสียคือต้องใช้หน่วยความจำมหาศาลสำหรับฮาร์ดแวร์ระดับสูง และมีความเสี่ยงต่อการเกิด catastrophic forgetting หรือการที่โมเดลเก่งเฉพาะงานใหม่แต่ลืมความรู้พื้นฐานอื่นๆ ไปหมด
- Parameter-Efficient Fine-Tuning (PEFT): เทคนิคนี้จะแช่แข็งโมเดลฐานไว้ และเพิ่มชุดตัวเลขขนาดเล็กเข้าไปเพื่อฝึกฝนเฉพาะส่วนนั้น เทคนิคที่นิยมคือ LoRA, QLoRA และ prompt tuning ซึ่งช่วยประหยัดทั้งเวลาและทรัพยากร ทั้งยังลดความเสี่ยงในการลืมความรู้เดิม จึงเป็นตัวเลือกยอดนิยมสำหรับการ fine-tuning LLM ในปัจจุบัน
Fine-Tuning คือคำตอบเสมอไปหรือไม่?
แม้การ fine-tuning จะยอดเยี่ยมในการสอนทักษะหรือสไตล์ใหม่ๆ แต่ไม่ใช่เครื่องมือเดียวที่มี บางครั้งการเขียน Prompt ที่ดีกว่าก็ช่วยได้ หรือหากข้อมูลมีการเปลี่ยนแปลงบ่อย การใช้ Retrieval-Augmented Generation (RAG) อาจเหมาะสมกว่า ในทางปฏิบัติ ระบบที่มีประสิทธิภาพมักใช้หลายเทคนิคควบคู่กัน
แหล่งความรู้เพิ่มเติม
หากคุณสนใจเริ่มต้นฝึก fine-tuning ด้วยเทคนิค LoRA นี่คือทรัพยากรแนะนำ:
- Hugging Face PEFT: ไลบรารีมาตรฐานสำหรับ LoRA และ QLoRA
- Hugging Face TRL: มี
SFTTrainerสำเร็จรูปสำหรับงาน supervised fine-tuning - Unsloth: เครื่องมือที่เป็นมิตรที่สุดสำหรับมือใหม่ ฝึกฝนได้เร็วขึ้น 2 เท่าและใช้ทรัพยากรน้อยลง
- Axolotl: เครื่องมือยอดนิยมสำหรับรันไปป์ไลน์ผ่านการตั้งค่า YAML โดยไม่ต้องเขียนโค้ดเยอะ
- The original LoRA paper: งานวิจัยต้นฉบับเรื่อง LoRA
- The QLoRA paper: งานวิจัยเรื่อง QLoRA ที่มีประสิทธิภาพมากขึ้น
คำแนะนำสุดท้าย: เริ่มต้นด้วยโมเดลขนาดเล็กอย่าง Llama 8B หรือ Gemma และทดลองใช้ Unsloth บน Colab ฟรี พร้อมข้อมูลสะอาดๆ สัก 2-3 ร้อยตัวอย่าง เมื่อคุณเห็นค่า training loss ลดลง ทุกอย่างจะชัดเจนขึ้นทันทีครับ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร