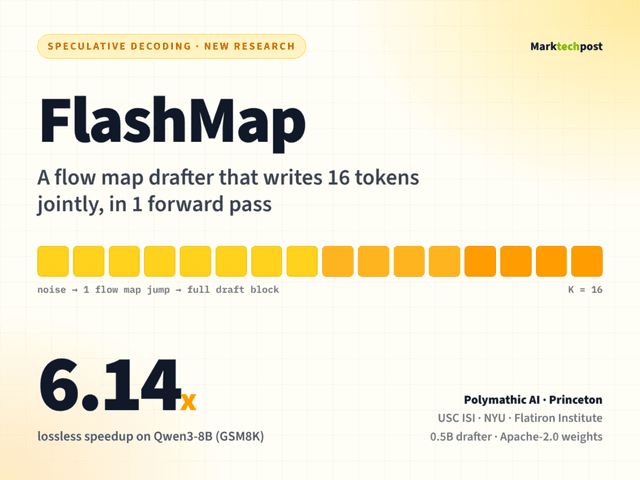
เปิดตัว FlashMap ระบบร่าง Token ใหม่ เร่งความเร็ว LLM สูงสุด 6.14 เท่าtag: FlashMap, LLM, Polymathic AI, Princeton University, Qwen3, Speculative DecodingOct 28, 2026 · By: AttapolKสรุปข่าว 1:20คณะวิจัยจาก Polymathic AI และ Princeton เปิดตัว FlashMap ตัวร่างสำหรับ speculative decoding ที่ใช้เทคนิค continuous flow map ช่วยให้ร่าง 16 token ได้พร้อมกันในครั้งเดียวและเร่งความเร็วแบบ lossless ได้มหาศาล
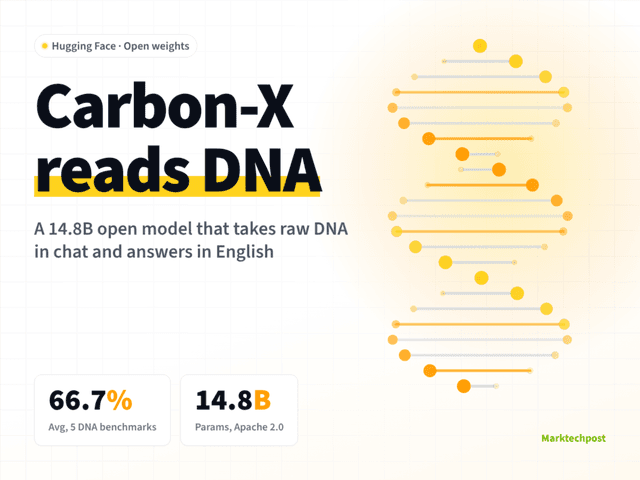
Hugging Face เปิดตัว Carbon-X โมเดลภาษาด้าน DNA ขนาด 14.8Btag: Bioinformatics, Carbon-X, DNA Model, Hugging Face, Qwen3Oct 26, 2026 · By: SirilukPสรุปข่าว 1:21Hugging Face เปิดตัว Carbon-X โมเดลภาษาด้าน DNA แบบโอเพนซอร์สที่สร้างบน Qwen3-14B สามารถวิเคราะห์รหัสพันธุกรรมและตอบโต้เป็นภาษาธรรมชาติได้แม่นยำสูงภายใต้สัญญาอนุญาต Apache 2.0
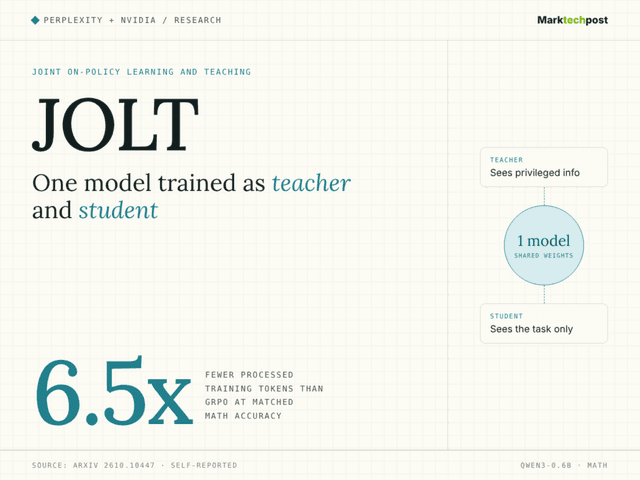
Perplexity และ NVIDIA เปิดตัว JOLT ฝึกโมเดลเป็นทั้งครูและนักเรียนtag: JOLT, Nvidia, Perplexity, Post-Training, Qwen3, Reinforcement LearningOct 22, 2026 · By: TanasakPสรุปข่าว 1:13JOLT เป็นวิธีการฝึกโมเดล AI รูปแบบใหม่ที่ใช้โมเดลเดียวเป็นทั้งผู้สอนและผู้เรียน ให้ผลลัพธ์แม่นยำเทียบเท่า GRPO แต่ประหยัดทรัพยากรการคำนวณน้อยกว่าถึง 6.5 เท่า
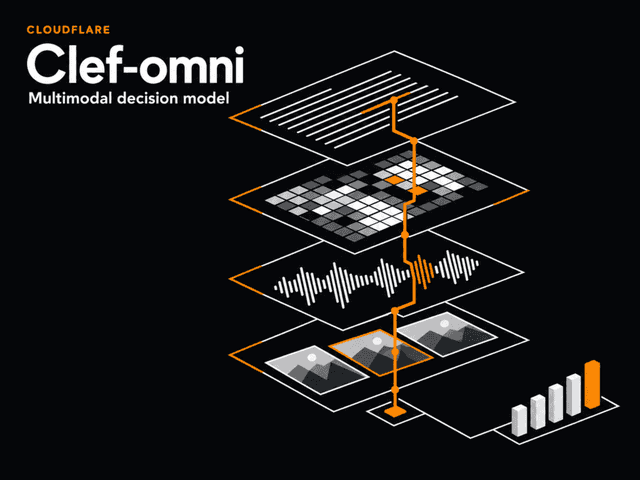
Cloudflare เปิดตัว Clef-omni โมเดลตัดสินใจ Multimodal ตัวแรกtag: Clef-omni, Cloudflare, Multimodal, Qwen3, Workers AIOct 12, 2026 · By: NatapolKสรุปข่าว 1:31Cloudflare เปิดตัว Clef-omni โมเดลแบบ open-weight ที่ประมวลผลข้อความ ภาพ เสียง และวิดีโอได้พร้อมกันในราคาประหยัด พร้อมอัปเกรด Clef รุ่นเดิมให้ทำงานเร็วขึ้น 2 เท่า
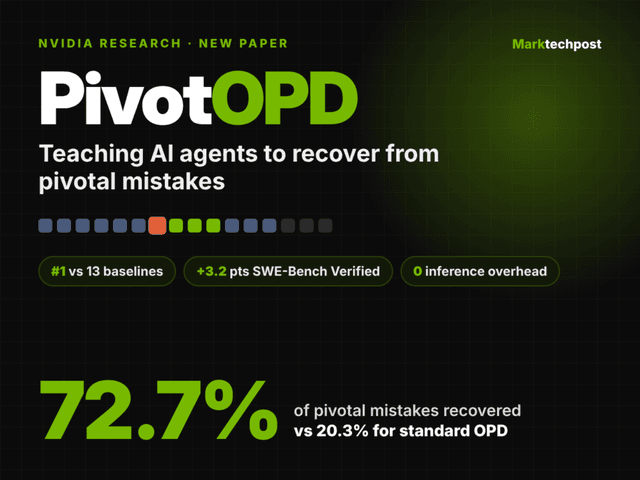
NVIDIA เปิดตัว PivotOPD สอน AI Agent แก้ไขข้อผิดพลาดและกู้คืนสถานการณ์tag: AI Research, LLM Agent, Nvidia, On-policy Distillation, PivotOPD, Qwen3Oct 8, 2026 · By: AttapolKสรุปข่าว 1:38นักวิจัย NVIDIA พัฒนา PivotOPD วิธีการฝึกสอน LLM agent ให้รู้จักหลีกเลี่ยงข้อผิดพลาดสำคัญและกู้คืนสถานการณ์ได้สำเร็จ โดยทำคะแนนสูงสุดเมื่อเทียบกับ 13 baselines ในชุดทดสอบมาตรฐาน
Retrieve-for-Train: เร่งความเร็วการค้นหาด้วย AI ซับซ้อนได้ 20 เท่าtag: Diffusion Models, Gemma3, Information Retrieval, Qwen3, Reinforcement Learning, Retrieve-for-TrainSep 16, 2026 · By: NatapolKทีมนักวิจัยเสนอเฟรมเวิร์กใหม่ที่ใช้การเรียนรู้แบบเสริมกำลัง (RL) ฝึกฝน AI ให้แตกหัวข้อการค้นหาที่หลากหลายและแม่นยำขึ้น โดยลดภาระการประมวลผลให้ทำงานได้เร็วขึ้นอย่างมหาศาล
คู่มือ Fine-Tuning LLM สำหรับ Tool-Calling ด้วย XYZ-Aquila-SFT และ Qwen3tag: Fine-tuning, LLM, LoRA, Qwen3, Tool-Calling, XYZ-Aquila-SFTAug 16, 2026 · By: AttapolKนำเสนอขั้นตอนการ Fine-tuning โมเดลภาษาแบบ end-to-end เพื่อรองรับการเรียกใช้เครื่องมือ (tool-calling) ครอบคลุมตั้งแต่การจัดการชุดข้อมูล XYZ-Aquila-SFT ไปจนถึงการปรับแต่ง LoRA บนโมเดล Qwen3