ThinkingBox: ปรับปรุงเอเจนท์ AI ด้วยการทำ Post-Training ผ่านรางวัล RLtag: AI Agent, GRPO, Microsoft, Qwen, Reinforcement Learning, ThinkingBoxOct 23, 2026 · By: NatapolKสรุปข่าว 1:28ทีมนักวิจัยใช้ ThinkingBox เปลี่ยนการตรวจสอบสถานะฐานข้อมูลให้เป็นฟังก์ชันรางวัลเพื่อฝึกฝนเอเจนท์ AI ด้วยวิธี GRPO ช่วยเพิ่มความน่าเชื่อถือและอัตราความสำเร็จของ Qwen3.8-27B ได้เกือบ 3 เท่า
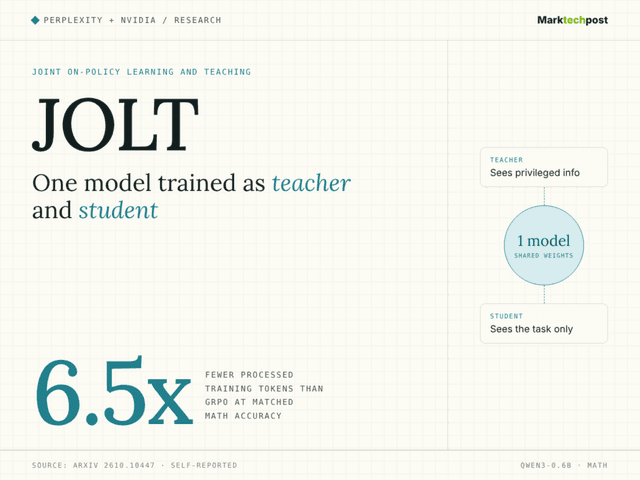
Perplexity และ NVIDIA เปิดตัว JOLT ฝึกโมเดลเป็นทั้งครูและนักเรียนtag: JOLT, Nvidia, Perplexity, Post-Training, Qwen3, Reinforcement LearningOct 22, 2026 · By: TanasakPสรุปข่าว 1:13JOLT เป็นวิธีการฝึกโมเดล AI รูปแบบใหม่ที่ใช้โมเดลเดียวเป็นทั้งผู้สอนและผู้เรียน ให้ผลลัพธ์แม่นยำเทียบเท่า GRPO แต่ประหยัดทรัพยากรการคำนวณน้อยกว่าถึง 6.5 เท่า
5 แหล่งเรียนรู้ World Models ปี 2026 เจาะลึกจุดเปลี่ยนสำคัญของ AItag: Embodied AI, Reinforcement Learning, Stanford, Tsinghua University, UC Berkeley, World ModelsOct 16, 2026 · By: SirilukPสรุปข่าว 1:22World models คือเทคโนโลยีที่จะพลิกโฉมวงการ AI จากการแค่ประมวลผลข้อมูล สู่การเรียนรู้และจำลองพฤติกรรมของสภาพแวดล้อมเพื่อวางแผนการทำงานได้อย่างชาญฉลาด
Alibaba เปิดตัว QwenGyre เฟรมเวิร์ก Elastic RL สำหรับ AI Agenttag: AI Agent, Alibaba, Qwen, QwenGyre, Reinforcement LearningOct 13, 2026 · By: NatapolKสรุปข่าว 1:14ทีม Qwen ของ Alibaba เปิดตัว QwenGyre เฟรมเวิร์กการฝึกฝนแบบ elastic reinforcement learning ที่ช่วยให้ AI Agent ทำงานต่อเนื่องได้นานเป็นพิเศษและรองรับโทเคนได้เกือบ 1 ล้านโทเคน
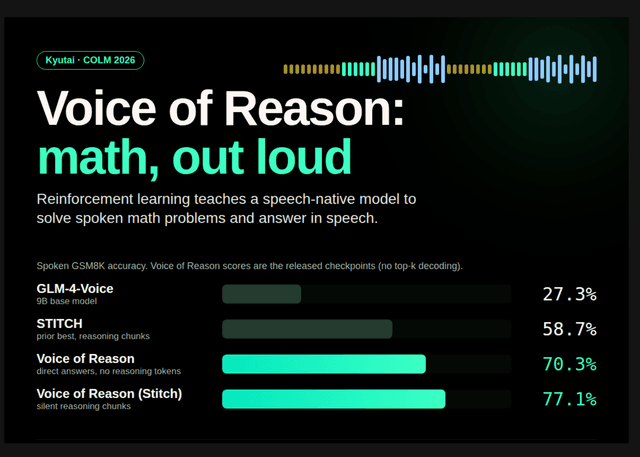
Kyutai เปิดตัว Voice of Reason โมเดลเสียงแก้โจทย์เลขด้วย RLtag: GLM-4-Voice, Kyutai, Reinforcement Learning, Speech-to-Speech, Voice of ReasonSep 23, 2026 · By: AttapolKสรุปข่าว 1:24Kyutai เปิดตัว Voice of Reason โมเดล Speech-to-Speech แบบ Open-weight จำนวน 2 โมเดลที่พัฒนาต่อยอดจาก GLM-4-Voice-9B โดยใช้เทคนิค SFT และ Reinforcement Learning ช่วยเพิ่มความแม่นยำในการแก้โจทย์คณิตศาสตร์ผ่านเสียงจาก 27.3% พุ่งสูงถึง 77.1% โดยไม่ต้องแปลงเป็นข้อความ
Xiaomi ปล่อย MiMo-V2.6-Pro โมเดล AI โอเพนซอร์สที่แรงและถูกที่สุดในโลกtag: Anthropic, MiMo-V2.6-Pro, Open Model, Reinforcement Learning, XiaomiSep 23, 2026 · By: AttapolKสรุปข่าว 1:41Xiaomi ก้าวขึ้นเป็นผู้นำตลาด AI แบบเปิดด้วยโมเดล MiMo-V2.6-Pro ที่เน้นประสิทธิภาพความฉลาดสูงแต่ต้นทุนต่ำ ท่ามกลางข้อครหาจาก Anthropic ว่ามีการลักลอบนำข้อมูลจาก Claude ไปใช้ฝึกฝน
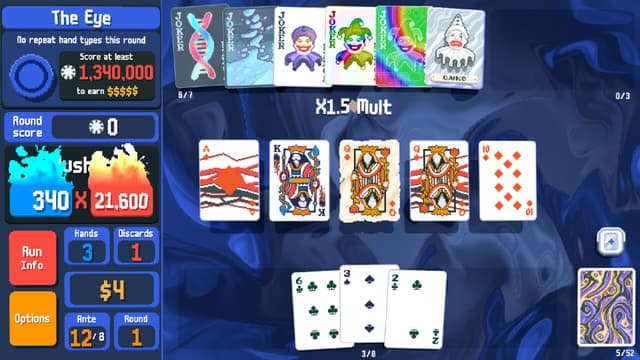
แฟนเกม Balatro ฝึกสมองแมลงวันจำลองของ Google ให้เล่นเกมชนะtag: Artificial Intelligence, Balatro, Fruit Fly Brain, Google, Reinforcement LearningSep 18, 2026 · By: SirilukPสรุปข่าว 1:32ผู้เล่น Balatro ใช้แผนที่สมองแมลงวันทองของ Google มาฝึกฝนด้วยอัลกอริทึมจนสามารถเล่นเกมชนะได้ที่อัตราความสำเร็จ 20%
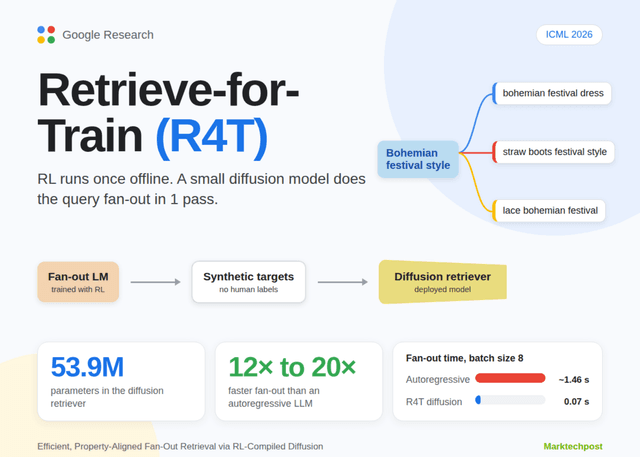
Google เปิดตัว R4T: Diffusion Retriever เร่งการค้นหาเร็วขึ้น 20 เท่าtag: Diffusion Model, Google Research, Information Retrieval, Reinforcement Learning, Retrieve-for-TrainSep 17, 2026 · By: AttapolKGoogle Research พัฒนาเฟรมเวิร์ก Retrieve-for-Train (R4T) ที่ใช้ RL ฝึกโมเดล Diffusion ขนาด 53.9 ล้านพารามิเตอร์ ให้สามารถสร้างผลลัพธ์การค้นหาที่หลากหลายและแม่นยำได้ในการประมวลผลครั้งเดียว เร็วกว่าเดิมสูงสุด 20 เท่า
Retrieve-for-Train: เร่งความเร็วการค้นหาด้วย AI ซับซ้อนได้ 20 เท่าtag: Diffusion Models, Gemma3, Information Retrieval, Qwen3, Reinforcement Learning, Retrieve-for-TrainSep 16, 2026 · By: NatapolKทีมนักวิจัยเสนอเฟรมเวิร์กใหม่ที่ใช้การเรียนรู้แบบเสริมกำลัง (RL) ฝึกฝน AI ให้แตกหัวข้อการค้นหาที่หลากหลายและแม่นยำขึ้น โดยลดภาระการประมวลผลให้ทำงานได้เร็วขึ้นอย่างมหาศาล
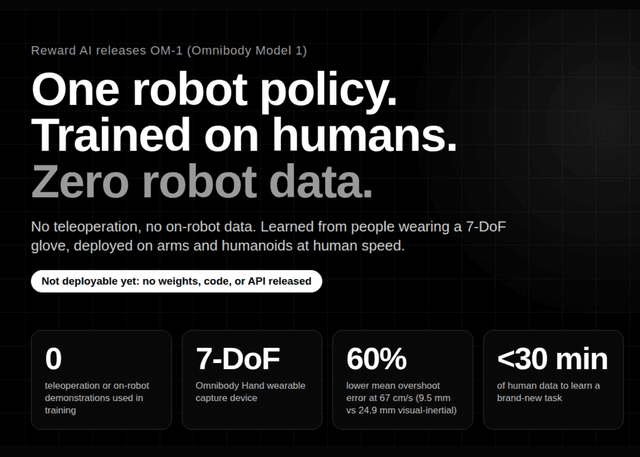
Reward AI เปิดตัว OM-1 นโยบายควบคุมหุ่นยนต์อัจฉริยะ ฝึกฝนจากข้อมูลมนุษย์โดยตรง 100%tag: Humanoid, OM-1, Omnibody Model, Reinforcement Learning, Reward AI, RoboticsSep 15, 2026 · By: NatapolKReward AI เปิดตัว OM-1 นโยบายควบคุมหุ่นยนต์อเนกประสงค์ที่ฝึกฝนผ่านการสาธิตโดยมนุษย์ด้วยถุงมือเซนเซอร์ 7-DoF โดยไม่ต้องใช้การควบคุมระยะไกลหรือข้อมูลเดิมจากตัวหุ่นยนต์ สามารถเรียนรู้งานใหม่ได้ภายในเวลาไม่ถึง 30 นาที
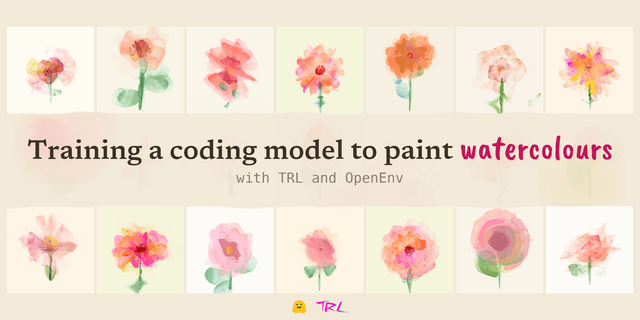
เทคนิคการฝึก AI เขียนโค้ดวาดภาพสีน้ำด้วย TRL และ OpenEnv ผ่านกระบวนการ RLtag: Generative Art, Hugging Face, OpenEnv, p5.js, Qwen, Reinforcement LearningSep 3, 2026 · By: TanasakPสรุปกระบวนการสร้างและฝึกโมเดลภาษาขนาดเล็กให้สามารถวาดภาพสีน้ำที่สวยงามผ่านโค้ด JavaScript โดยใช้เทคนิค Reinforcement Learning (RL) ร่วมกับไลบรารี p5.brush และเครื่องมือจาก Hugging Face เพื่อเลียนแบบรสนิยมทางศิลปะของมนุษย์
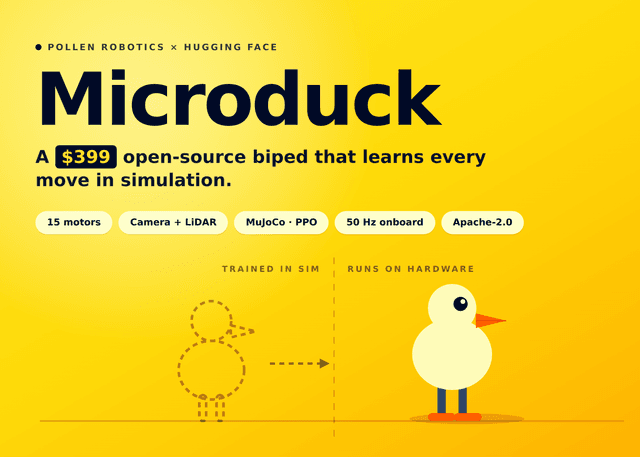
Hugging Face เปิดตัว Microduck หุ่นยนต์สองขา Open-Source ราคา 1.4 หมื่นบาท ฝึกฝนด้วย AI ได้บนโต๊ะทำงานtag: Hugging Face, Microduck, MuJoCo, Open Source Robotics, Pollen Robotics, Reinforcement LearningAug 30, 2026 · By: TanasakPPollen Robotics ทีมผู้พัฒนาจาก Hugging Face เปิดตัว Microduck หุ่นยนต์สองขาสูง 25 ซม. ที่รองรับการฝึกฝนผ่าน Reinforcement Learning ในราคา 399 ดอลลาร์ พร้อมเปิดเผยกระบวนการฝึกแบบ sim-to-real สู่สาธารณะ
Harvey เปิดตัว Tenet: โมเดลฐาน Kimi K3 ที่ผ่านการฝึกฝนพิเศษเพื่อยกระดับงานกฎหมายระยะยาวtag: Harvey, Harvey Tenet, Kimi K3, Legal AI, Reinforcement LearningAug 24, 2026 · By: SirilukPHarvey เปิดตัว Harvey Tenet โมเดลวิจัยที่พัฒนาจาก Kimi K3 ผ่านกระบวนการ Reinforcement Learning เพื่อเพิ่มประสิทธิภาพในภารกิจทางกฎหมายที่ซับซ้อน โดยทำคะแนนบน Legal Agent Benchmark ได้ดีขึ้นเกือบเท่าตัว
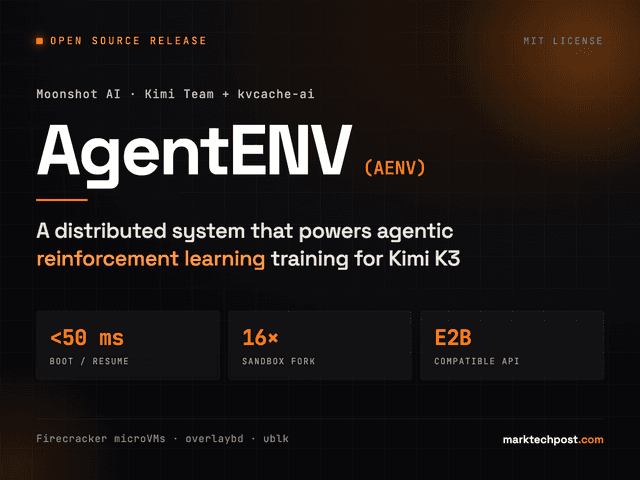
Moonshot AI เปิดตัว 'AgentENV' โอเพนซอร์สระบบ MicroVM ความเร็วสูง ขับเคลื่อนการฝึก Agentic RL ให้ Kimi K3tag: AgentENV, Firecracker, Kimi K3, Moonshot AI, Open-Source, Reinforcement LearningJul 29, 2026 · By: NatapolKทีม Kimi ของ Moonshot AI และ kvcache-ai เปิดตัว AgentENV ระบบ Sandbox สำหรับ AI Agent ที่ใช้เทคโนโลยี Firecracker microVM สามารถ Snapshot และ Resume ได้ในระดับมิลลิวินาที พร้อมรองรับการฝึกโมเดล Kimi K3 ขนาด 2.8 ล้านล้านพารามิเตอร์
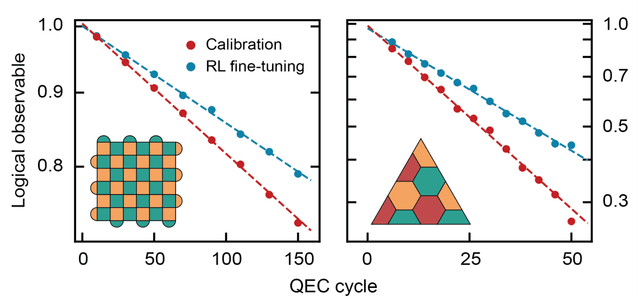
คอมพิวเตอร์ควอนตัมยุคใหม่ เรียนรู้และแก้ไขความผิดพลาดได้เองโดยไม่ต้องหยุดการประมวลผลtag: Google DeepMind, Google Quantum AI, Quantum Error Correction, Reinforcement Learning, WillowJul 23, 2026 · By: NatapolKGoogle Research พัฒนาเฟรมเวิร์ก Reinforcement Learning (RL) ที่ช่วยให้คอมพิวเตอร์ควอนตัมสามารถปรับจูนพารามิเตอร์และแก้ไขข้อผิดพลาดได้แบบเรียลไทม์ระหว่างรันอัลกอริทึม
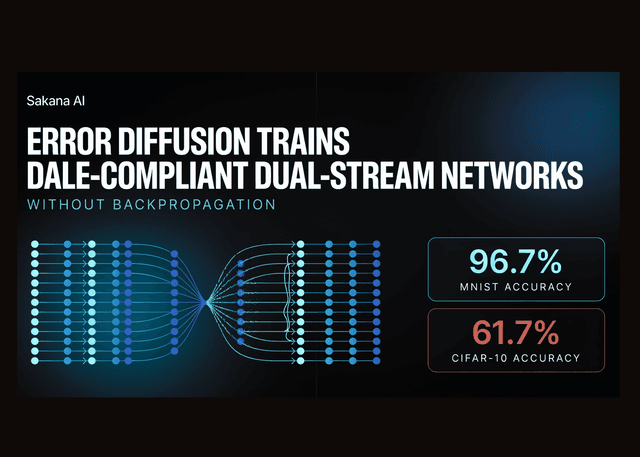
Sakana AI เปิดตัว Error Diffusion: ฝึก AI ด้วยหลักการชีวภาพโดยไม่ใช้ Backpropagationtag: Backpropagation, Dale's Principle, Error Diffusion, Reinforcement Learning, Sakana AIJul 19, 2026 · By: AttapolKSakana AI เปิดตัว Error Diffusion (ED) แนวทางการฝึก AI รูปแบบใหม่ที่ใช้หลักการชีวภาพโดยไม่พึ่งพา Backpropagation เพื่อแก้ปัญหาการขนส่งน้ำหนักและรองรับฮาร์ดแวร์ยุคใหม่ ผลการทดสอบพบว่าสามารถใช้กับโครงข่าย Convolutional ได้เป็นครั้งแรกและทำประสิทธิภาพได้ดีในงานเสริมแรงเรียนรู้
Rich Sutton เจ้าของรางวัล Turing Award เปิดตัว Oak Lab มุ่งสร้าง AI Agent ที่เรียนรู้ได้เองตลอดเวลาtag: AI Agent, Deep Learning, Oak Lab, Reinforcement Learning, Rich Sutton, Turing AwardJul 14, 2026 · By: SirilukPRich Sutton ผู้บุกเบิกด้าน Reinforcement Learning ระดับโลก เปิดตัวสตาร์ทอัพ Oak Lab ในโตรอนโต เพื่อท้าทายขีดจำกัดของ Deep Learning ในปัจจุบัน และสร้าง AI ที่สามารถเรียนรู้จากสิ่งแวดล้อมได้อย่างต่อเนื่อง