
คอมพิวเตอร์ควอนตัมยุคใหม่ เรียนรู้และแก้ไขความผิดพลาดได้เองโดยไม่ต้องหยุดการประมวลผล
ลองนึกภาพวงดุริยางค์ซิมโฟนีที่กำลังบรรเลงบทเพลงอันซับซ้อน หากไวโอลินเกิดเสียงเพี้ยนทุกๆ สองสามจังหวะ วงทั้งวงคงต้องหยุดชะงักเพื่อปรับจูนเครื่องดนตรีกันอยู่ตลอดเวลา โชคดีที่เรื่องนี้ไม่เกิดขึ้นกับวงออร์เคสตราจริงเพราะเครื่องดนตรีมีความเที่ยงตรงสูง แต่สำหรับโลกของคอมพิวเตอร์ควอนตัมในปัจจุบัน นี่คืออุปสรรคสำคัญที่ต้องเผชิญอยู่ทุกวัน เนื่องจากคอมพิวเตอร์ควอนตัมเป็นระบบอนาล็อกที่ไวต่อความคลาดเคลื่อน (drift) การรักษาเสถียรภาพจึงต้องอาศัยการปรับเทียบ (recalibrate) พารามิเตอร์ควบคุม เช่น ความถี่ แอมพลิจูด และเฟสของสัญญาณอย่างต่อเนื่อง ซึ่งปัจจุบันจำเป็นต้องหยุดการคำนวณทั้งหมดเพื่อดำเนินการ การแยกส่วนระหว่างการคำนวณและการปรับเทียบเช่นนี้ถือเป็นคอขวดสำคัญ เพราะอัลกอริทึมควอนตัมที่มีประสิทธิภาพจำเป็นต้องรันต่อเนื่องนานหลายวันหรือหลายเดือน เพื่อแก้ปัญหานี้ งานวิจัยเรื่อง “Reinforcement learning control of quantum error correction” ที่ตีพิมพ์ในวารสาร Nature ได้นำเสนอเฟรมเวิร์ก reinforcement learning (RL) ที่ใช้ตัวแทนอิสระ (autonomous agent) เรียนรู้จากการตรวจจับข้อผิดพลาดเพื่อควบคุมพารามิเตอร์หลายพันตัวอย่างต่อเนื่อง ช่วยให้ระบบเสถียรได้ในขณะคำนวณ เปรียบเสมือนการรู้วิธีปรับจูนเครื่องดนตรีในขณะที่การบรรเลงยังดำเนินต่อไป
การรับมือกับความผิดพลาดทางควอนตัม
ในโลกควอนตัม การตรวจหาความผิดพลาดเป็นเรื่องยากเพราะการเข้าไปสังเกตการณ์จะทำให้สถานะการทับซ้อน (quantum superposition) ล่มสลายทันที เราจึงต้องใช้เทคนิค Quantum Error Correction (QEC) สร้าง “logical qubits” จาก physical qubits จำนวนมาก และใช้การตรวจสอบพาริตี้ (parity checks) เพื่อเปลี่ยนสัญญาณรบกวนอนาล็อกให้เป็นข้อมูลข้อผิดพลาดแบบไบนารี
อย่างไรก็ตาม ข้อมูลเหล่านี้บอกเพียงว่ามีจุดผิดพลาดเกิดขึ้น แต่ไม่ได้ระบุตำแหน่งที่แน่นอน เพื่อแก้ไขปัญหานี้เราจึงต้องพึ่งพาตัวถอดรหัส QEC เช่น AlphaQubit และ Tesseract ซึ่งแม้จะกู้คืนข้อมูลได้สำเร็จ แต่ตัวถอดรหัสเหล่านี้ยังไม่สามารถตอบได้ว่าข้อผิดพลาดนั้นเกิดขึ้นจากสาเหตุใดตั้งแต่แรก
ข้อผิดพลาดบางส่วนเกิดจาก decoherence หรือการปฏิสัมพันธ์กับสิ่งแวดล้อมที่หลีกเลี่ยงไม่ได้ แต่ความผิดพลาดส่วนใหญ่นั้นมาจากความคลาดเคลื่อนของฮาร์ดแวร์และการปรับเทียบที่ไม่แม่นยำ ซึ่งเป็นส่วนที่เรายังสามารถพัฒนาและแก้ไขได้
ก้าวข้ามโมเดลฟิสิกส์แบบดั้งเดิม
เดิมทีการปรับเทียบควอนตัมจะพึ่งพาโมเดลฟิสิกส์ แต่อุตสาหกรรมเทคโนโลยีมักพบว่าโมเดลที่มนุษย์สร้างขึ้นมีขีดจำกัดด้านประสิทธิภาพ เช่นเดียวกับในวงการคอมพิวเตอร์วิทัศน์ หุ่นยนต์ หรือการทำนายการพับตัวของโปรตีนอย่าง AlphaFold ที่ความก้าวหน้าครั้งใหญ่เกิดขึ้นเมื่อเปลี่ยนมาใช้การเรียนรู้จากข้อมูลโดยตรง
เมื่อตัวประมวลผลควอนตัมได้รับการพัฒนาให้ซับซ้อนขึ้น ข้อผิดพลาดที่เกิดขึ้นจะเริ่มเกินขีดความสามารถของโมเดลและการปรับเทียบแบบดั้งเดิม นี่จึงเป็นจังหวะสำคัญที่ Machine Learning จะเข้ามามีบทบาทในการนำพาก้าวต่อไปของเทคโนโลยีนี้
อย่าเพียงแค่แก้ไขข้อผิดพลาด แต่จงเรียนรู้จากมัน!
Google Research ได้นำเทคนิค RL มาประยุกต์ใช้เพื่อสร้างกระบวนการเรียนรู้จากประสบการณ์จริง โดยใช้กระแสข้อมูลจากการตรวจจับของ QEC เป็นสัญญาณการเรียนรู้เชิงรุก (active learning signal) ในขณะที่เครื่องกำลังคำนวณ ตัวแทน RL จะเฝ้าติดตามและเรียนรู้ที่จะควบคุมพารามิเตอร์ต่างๆ แบบไดนามิกเพื่อป้องกันไม่ให้เกิดข้อผิดพลาดใหม่
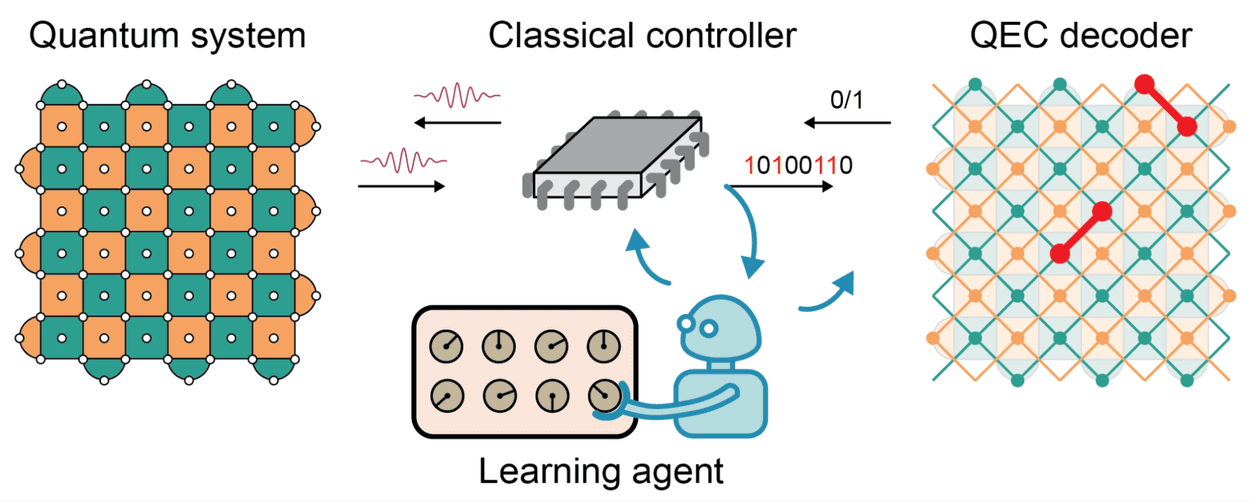
การคำนวณควอนตัมเกิดขึ้นทางกายภาพผ่านสัญญาณควบคุมอนาล็อก เหตุการณ์การตรวจจับข้อผิดพลาดทางควอนตัมถูกใช้โดยตัวถอดรหัสเพื่ออนุมานการแก้ไขเชิงตรรกะ ในเฟรมเวิร์กการควบคุมของเรา ข้อมูลเหล่านี้ยังถูกนำมาใช้ใหม่เป็นสัญญาณการเรียนรู้ ซึ่งสอนตัวแทน RL ให้ควบคุมพารามิเตอร์ควบคุมหลายพันตัวอย่างต่อเนื่อง และทำให้ระบบควอนตัมมีเสถียรภาพในระหว่างการคำนวณ
การทดลองควบคุมควอนตัมของเรา
เราได้ทดสอบระบบบนตัวประมวลผลซูเปอร์คอนดักติ้ง Willow โดยการฉีดความคลาดเคลื่อนจำลองเข้าไป ผลปรากฏว่า RL ช่วยเพิ่มเสถียรภาพเชิงตรรกะได้ถึง 3.5 เท่า และแม้หลังจากการปรับเทียบโดยผู้เชี่ยวชาญอย่างละเอียดแล้ว การใช้ RL ปรับละเอียด (fine-tuning) เพิ่มเติมยังสามารถลดอัตราข้อผิดพลาดลงได้อีก 20% อย่างเป็นระบบ
การบูรณาการเทคโนโลยีเหล่านี้ช่วยลดข้อผิดพลาดเชิงตรรกะในหน่วยความจำควอนตัมลงสู่ระดับต่ำสุดเป็นประวัติการณ์ โดยมีข้อผิดพลาดน้อยกว่าหนึ่งครั้งต่อรอบการแก้ไขหนึ่งพันรอบใน surface code และหนึ่งครั้งต่อร้อยรอบใน color code
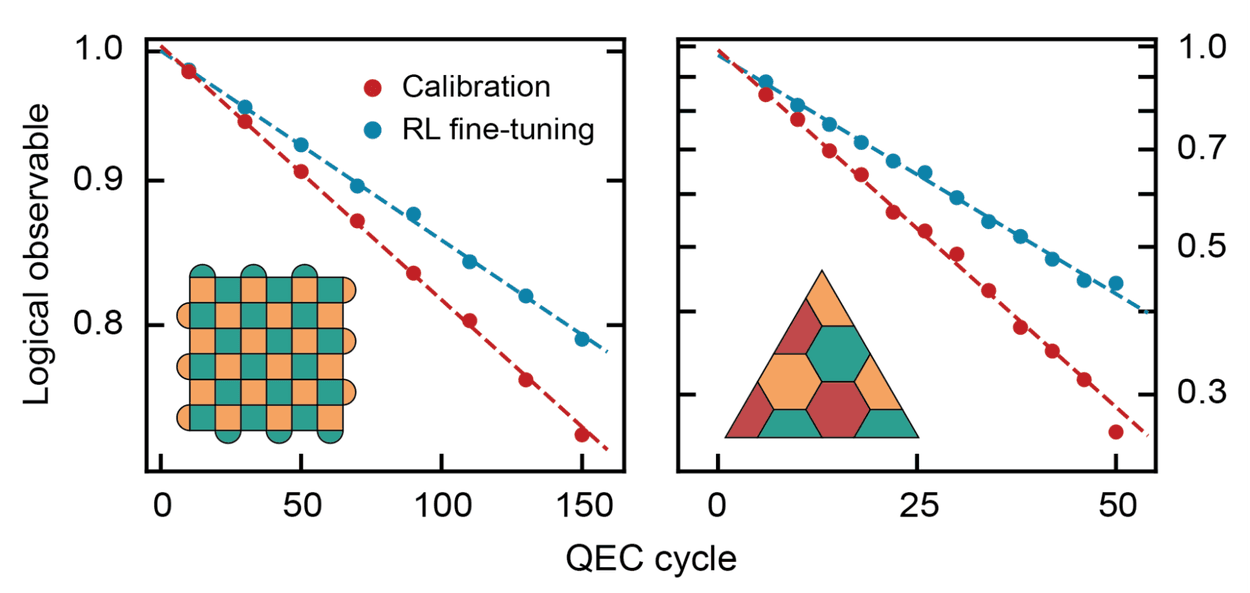
QEC ช่วยยืดอายุขัยของข้อมูลเชิงตรรกะในหน่วยความจำควอนตัมที่ใช้ surface code (ซ้าย) และ color code (ขวา) การปรับละเอียดด้วย RL ของตัวควบคุมของเราช่วยปรับปรุงคุณภาพของ QEC โดยการก้าวข้ามข้อจำกัดของโมเดลฟิสิกส์ที่ซับซ้อนและสัญชาตญาณของมนุษย์
ปูทางสู่การขยายขนาดในอนาคต เพื่อให้มั่นใจว่าแนวทางนี้สามารถใช้งานได้จริงกับคอมพิวเตอร์ควอนตัมขนาดใหญ่ เราได้ทำการจำลองด้วยคิวบิตหลายร้อยตัวและพารามิเตอร์ควบคุมหลายหมื่นตัว ซึ่งผลการจำลองยืนยันว่าจำนวนรอบการฝึกฝน RL (epochs) ที่ต้องการไม่ได้เพิ่มขึ้นตามขนาดของระบบ
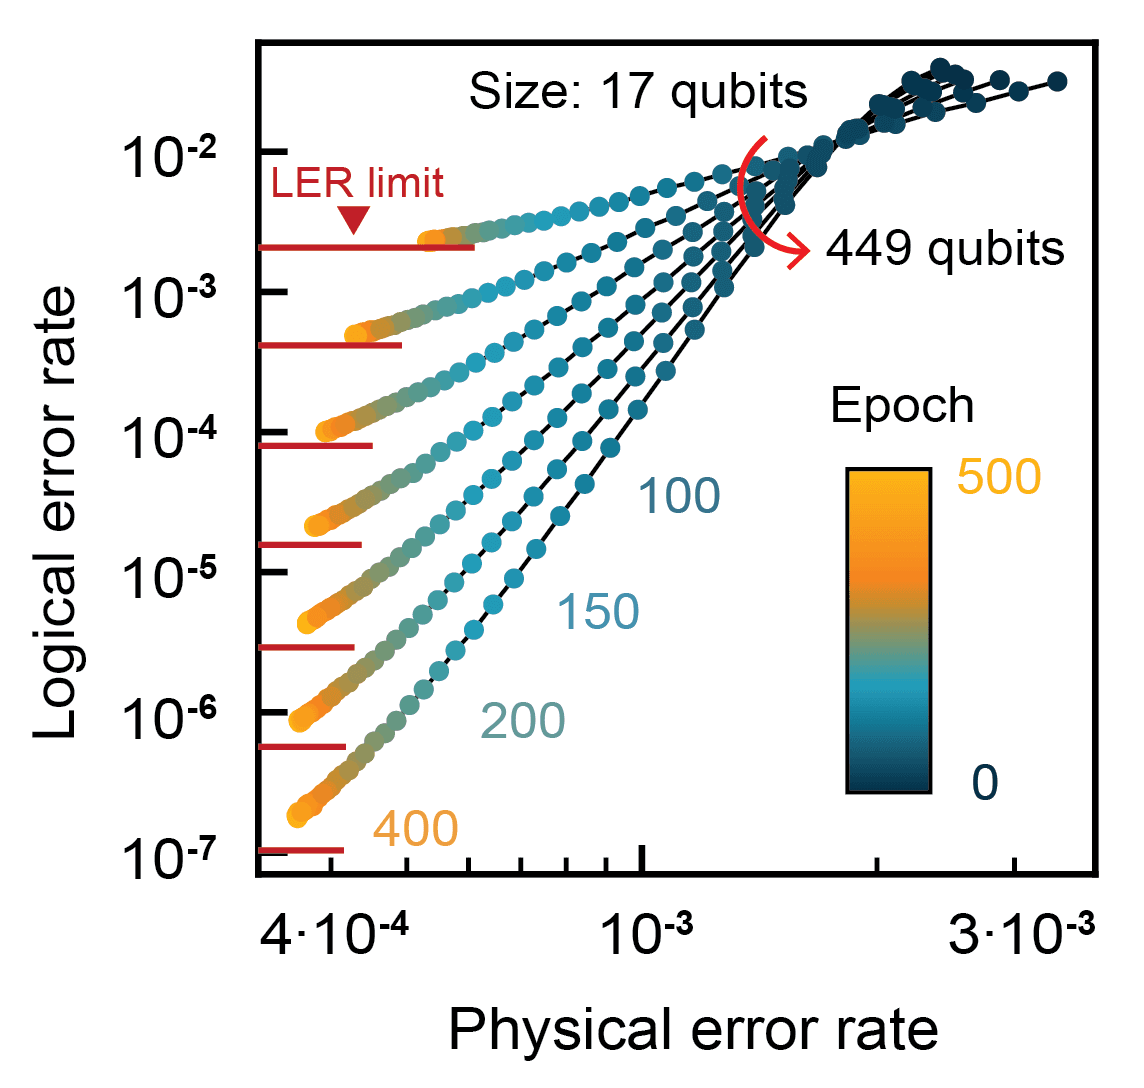
ในการจำลองของเรา ระบบที่ขาดการปรับเทียบเริ่มต้นด้วยอัตราข้อผิดพลาดทางกายภาพที่สูง ตัวแทนจะค่อยๆ ลดอัตรานั้นลงตามเวลาโดยการเรียนรู้พารามิเตอร์ควบคุมที่ได้รับการปรับปรุง และด้วย QEC อัตราข้อผิดพลาดเชิงตรรกะ (LER) จะถูกยับยั้งแบบเอกซ์โพเนนเชียลตามขนาดของระบบ (เช่น จำนวนของ physical qubits) ที่สำคัญคือ ความเร็วที่ RL ลดอัตราข้อผิดพลาดทางกายภาพนั้นไม่ขึ้นกับขนาดนี้ ซึ่งช่วยให้เราสามารถขยายแนวทางนี้ไปสู่ระบบที่ใหญ่ขึ้นมากได้
การค้นพบครั้งนี้เปิดประตูสู่การสร้างคอมพิวเตอร์ควอนตัมที่สามารถเรียนรู้จากความผิดพลาดของตนเองและทำงานได้อย่างต่อเนื่อง โดยก้าวต่อไปคือการเร่งสปีดการสื่อสารระหว่างตัวแทน RL และตัวประมวลผลให้รวดเร็วยิ่งขึ้น
กิตติกรรมประกาศ
เราขอขอบคุณผู้เขียนร่วมสำหรับความช่วยเหลือ ซึ่งรวมถึงการสร้างและบำรุงรักษาโครงสร้างพื้นฐานด้านฮาร์ดแวร์ ซอฟต์แวร์ ระบบไครโอเจนิก และอิเล็กทรอนิกส์ งานนี้เกิดขึ้นได้โดยทีม Google Quantum AI ที่ Google Research โดยความร่วมมือกับทีมจาก Google DeepMind
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร