
Google เปิดตัว R4T: Diffusion Retriever เร่งการค้นหาเร็วขึ้น 20 เท่า
ระบบการค้นหาและการแนะนำ (Search and Recommendation Systems) ในปัจจุบันมีความจำเป็นอย่างยิ่งในการส่งคืนชุดผลลัพธ์ที่ครอบคลุม ไม่ใช่เพียงแค่ผลลัพธ์ที่ตรงที่สุดเพียงอย่างเดียว ตัวอย่างเช่น การค้นหาด้วยคำว่า 'camping gear' ควรแสดงผลทั้งเต็นท์ ถุงนอน เตา และไฟฉาย แทนที่จะเป็นเต็นท์ที่หน้าตาคล้ายกัน 10 หลัง
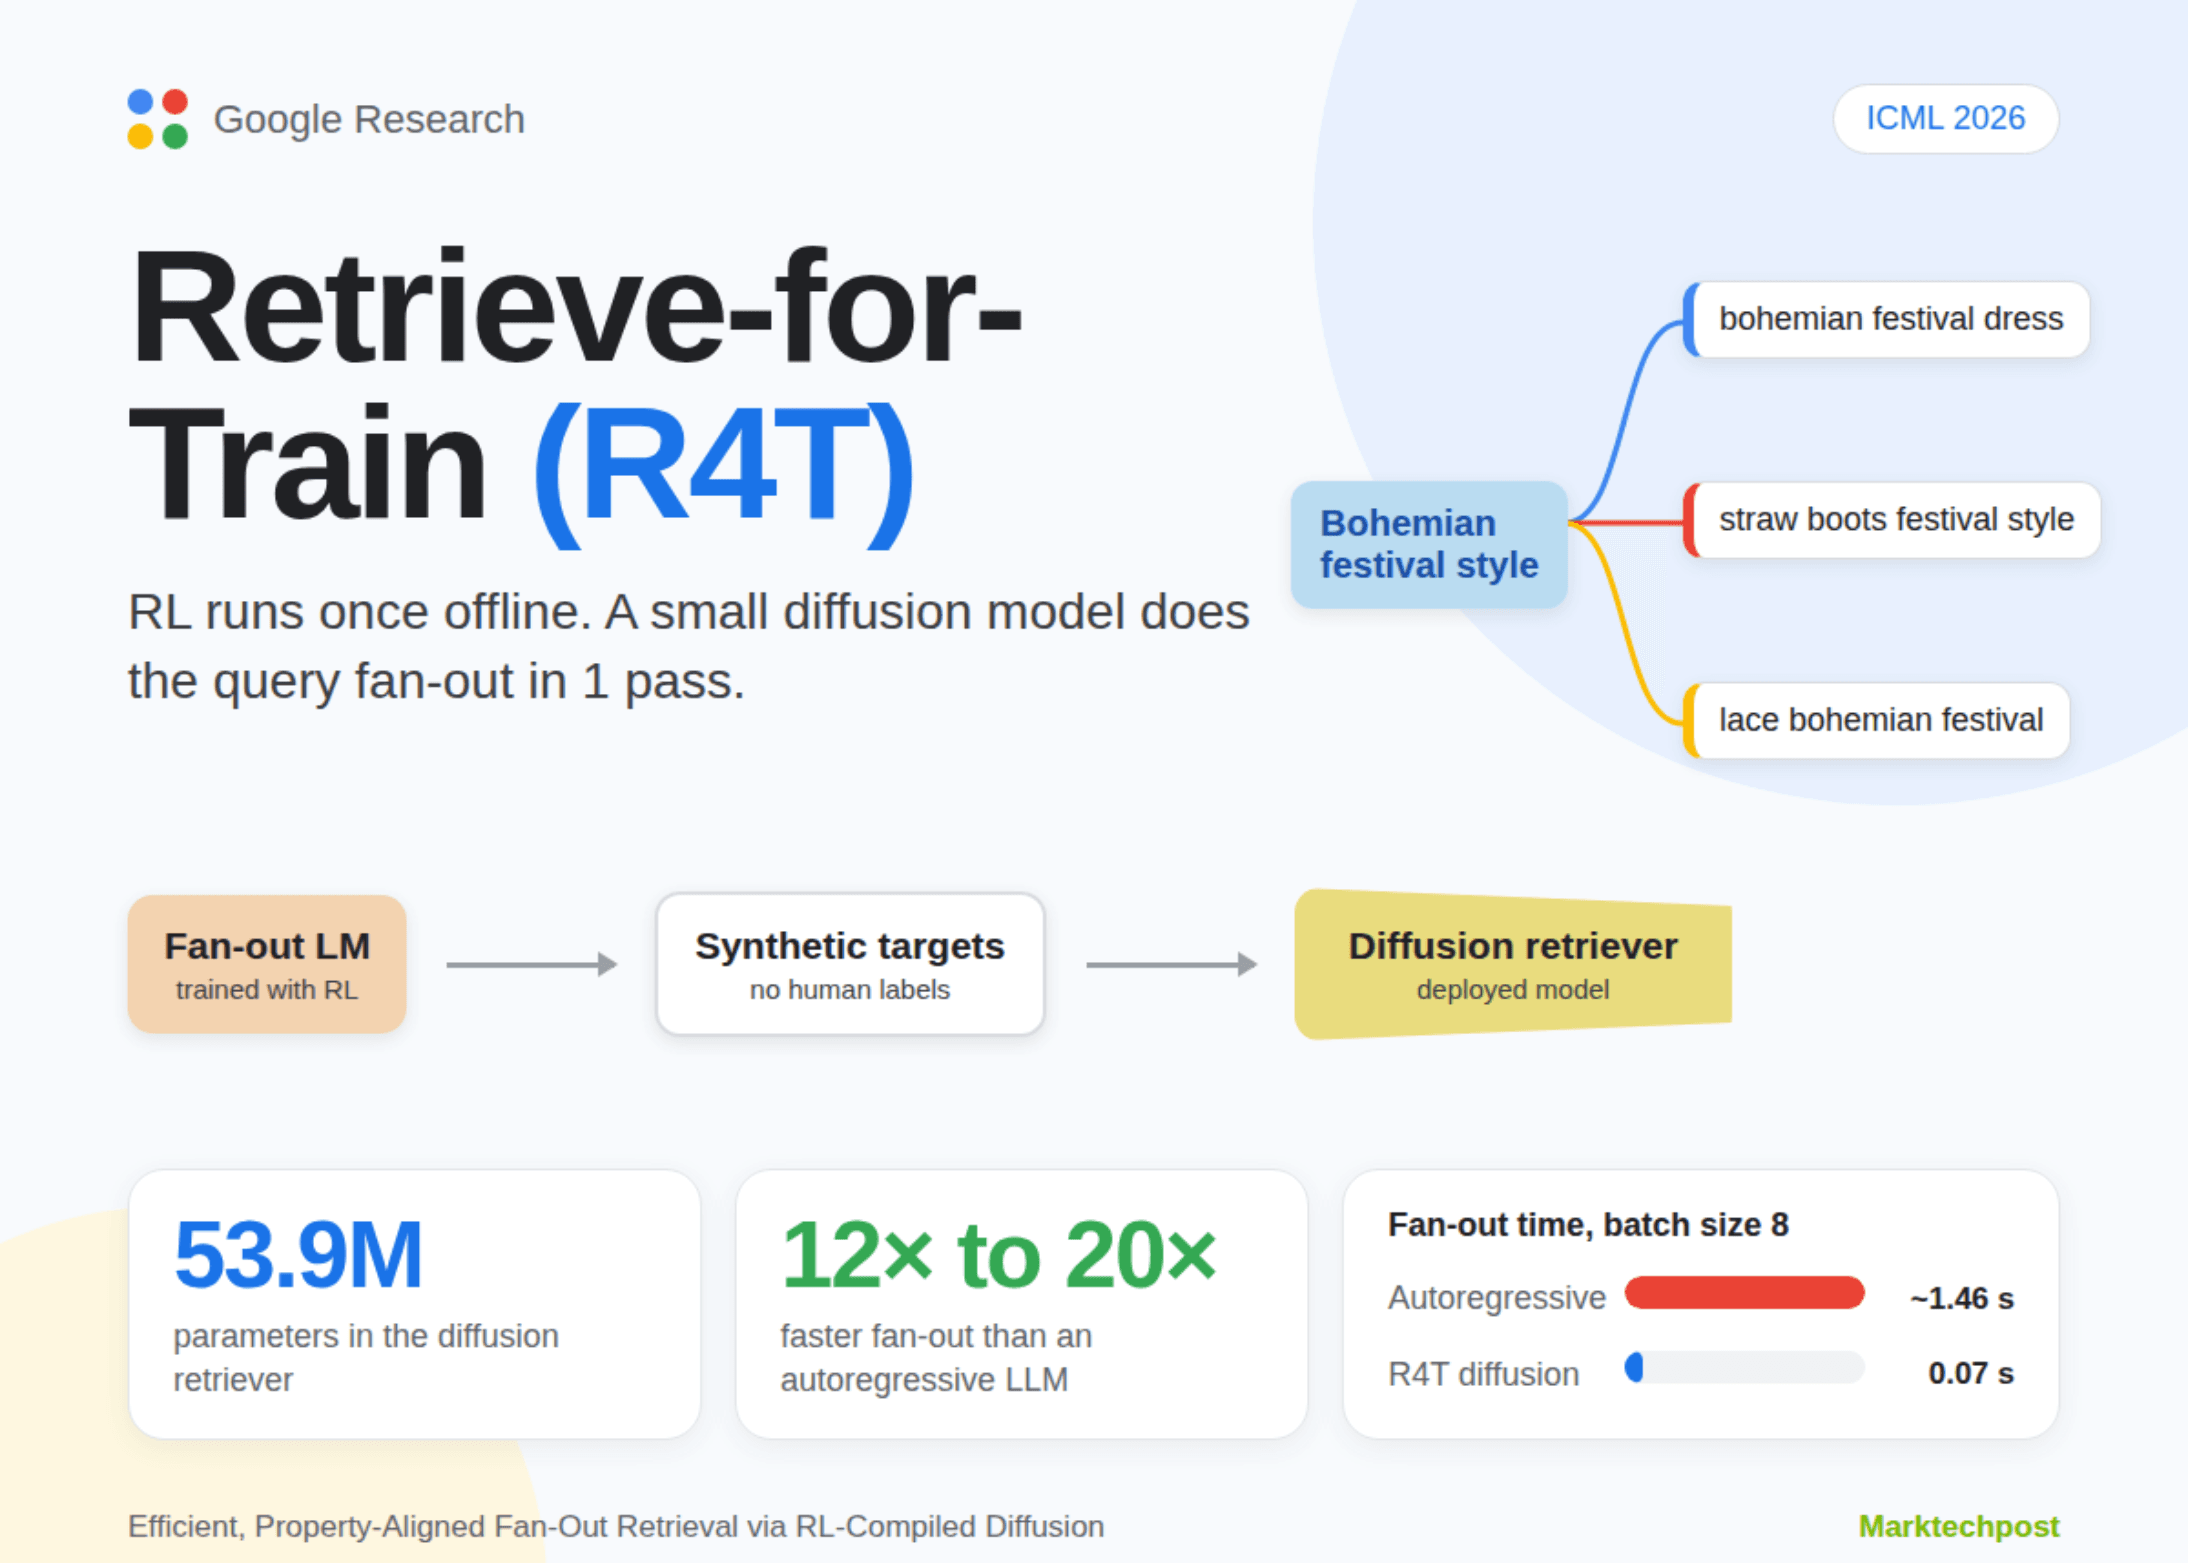
Google Research จึงได้เปิดตัว Retrieve-for-Train (R4T) เพื่อแก้ปัญหานี้ โดยเฟรมเวิร์กดังกล่าวใช้ Reinforcement Learning (RL) ฝึกสอนแบบออฟไลน์เพียงครั้งเดียว เพื่อเรียนรู้แนวทางการแตกคำค้นหา (Query Fan-out) ที่มีประสิทธิภาพ จากนั้นจึงกลั่นกรองพฤติกรรมนั้นลงสู่โมเดล Diffusion ขนาดเล็กที่สามารถสร้างทิศทางการค้นหาทั้งหมดได้ในขั้นตอนเดียว (Single Pass)
ทำไม Standard Fan-Out ถึงยังไม่ดีพอ
Query fan-out คือกระบวนการแบ่งพรอพต์กว้างๆ หนึ่งอันออกเป็นหลายคำค้นหาย่อย (Sub-queries) ซึ่งทีมวิจัยพบปัญหาหลัก 2 ประการเมื่อใช้ LLM ทั่วไปทำงานนี้ในช่วงการประมวลผล (Inference)
ประการแรกคือ Paraphrastic Collapse เช่น คำค้นหา 'Bohemian festival style' โมเดล Qwen3-4B แบบ Zero-shot มักสร้างคำที่ใกล้เคียงกันเกินไปอย่าง 'bohemian festival fashion' ซึ่งส่งผลให้ได้ผลลัพธ์ที่ซ้ำซาก ประการที่สองคือ Latency หรือความล่าช้า เนื่องจากการสร้างข้อความแบบ Autoregressive ร่วมกับการค้นหาซ้ำๆ นั้นกินเวลานานและมีต้นทุนการประมวลผลสูง
กระบวนการ 3 ขั้นตอนของ R4T
-
การฝึก Fan-out LM: โมเดลภาษาแบบ Fan-out (FOLM) จะสร้าง Sub-queries จำนวน k ชุด โดยมี Dense Retriever ทำหน้าที่ค้นหาผลลัพธ์ ซึ่งจะมีการให้รางวัลในระดับชุดผลลัพธ์ (Set-level Reward) เพื่อประเมินคุณภาพของทั้งชุดข้อมูลที่ค้นหาได้
-
การสังเคราะห์การกำกับดูแล (Supervision Synthesis): FOLM ที่ผ่านการฝึกจะสุ่มตัวอย่าง Fan-outs 128 ชุดต่อหนึ่งคำค้นหา เพื่อสร้างเป็นคู่ข้อมูลสำหรับฝึก (Query, Target Set) โดยไม่ต้องใช้มนุษย์มาเขียนเลเบลให้
-
การฝึก Diffusive Retriever: ใช้ Diffusion Transformer ขนาด 53.9 ล้านพารามิเตอร์ เรียนรู้การจับคู่ Query Embedding ไปยังกลุ่ม Target Embeddings ทั้งหมดผ่านสูตร Variance-exploding ใน EDM framework ทำให้ในช่วงใช้งานจริง โมเดลสามารถสร้าง Embedding ทั้งหมดได้พร้อมกันแบบ Non-autoregressive
การออกแบบรางวัลและการโกงรางวัล (Reward Hacking)
สำหรับการค้นหาแบบนามธรรมปลายเปิด (OAR) รางวัลจะประกอบด้วย 3 ส่วนสำคัญ ได้แก่ Groundedness เพื่อลดระยะห่างระหว่าง Sub-query กับข้อมูลจริง, Diversity โดยใช้ Vendi Score เพื่อความหลากหลาย และ Alignment เพื่อคงความใกล้เคียงกับคำค้นหาต้นฉบับ
การศึกษาพบว่าหากขาดส่วนประกอบใดไป โมเดลอาจเกิดการลู่เข้าหาคำซ้ำๆ หรือที่เรียกว่า Reward Hacking เช่น โมเดล Gemma3-4B อาจสร้างข้อความเดิมซ้ำไปมาหากไม่มีการวัดค่า Diversity ร่วมด้วย ทั้งนี้การฝึกจะใช้เทคนิค GRPO ร่วมกับ Soft PPO Regularization เพื่อควบคุมประสิทธิภาพให้เสถียรที่สุด
ผลลัพธ์และประสิทธิภาพ
จากการทดสอบด้วยชุดข้อมูลแฟชั่น Polyvore และเพลงผ่าน MuLan พบว่าโมเดล Gemma3-4B R4T-FOLM ทำคะแนนเฉลี่ยได้สูงกว่าการใช้วิธี Best-of-N และ Zero-shot อย่างมีนัยสำคัญ โดยเฉพาะค่าความหลากหลายที่เพิ่มขึ้นอย่างชัดเจน
ในด้านความเร็ว R4T-Diffusion แสดงศักยภาพที่เหนือกว่าอย่างมาก โดยที่ Batch Size ขนาด 1024 ระบบ Autoregressive แบบเดิมต้องใช้เวลาเกือบ 50 วินาที แต่โมเดล Diffusion ใช้เวลาเพียง 4.21 วินาทีเท่านั้น ซึ่งคิดเป็นการทำงานที่เร็วขึ้นถึง 12 ถึง 20 เท่าอย่างสม่ำเสมอในทุกการทดสอบ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร