
Perplexity และ NVIDIA เปิดตัว JOLT ฝึกโมเดลเป็นทั้งครูและนักเรียน
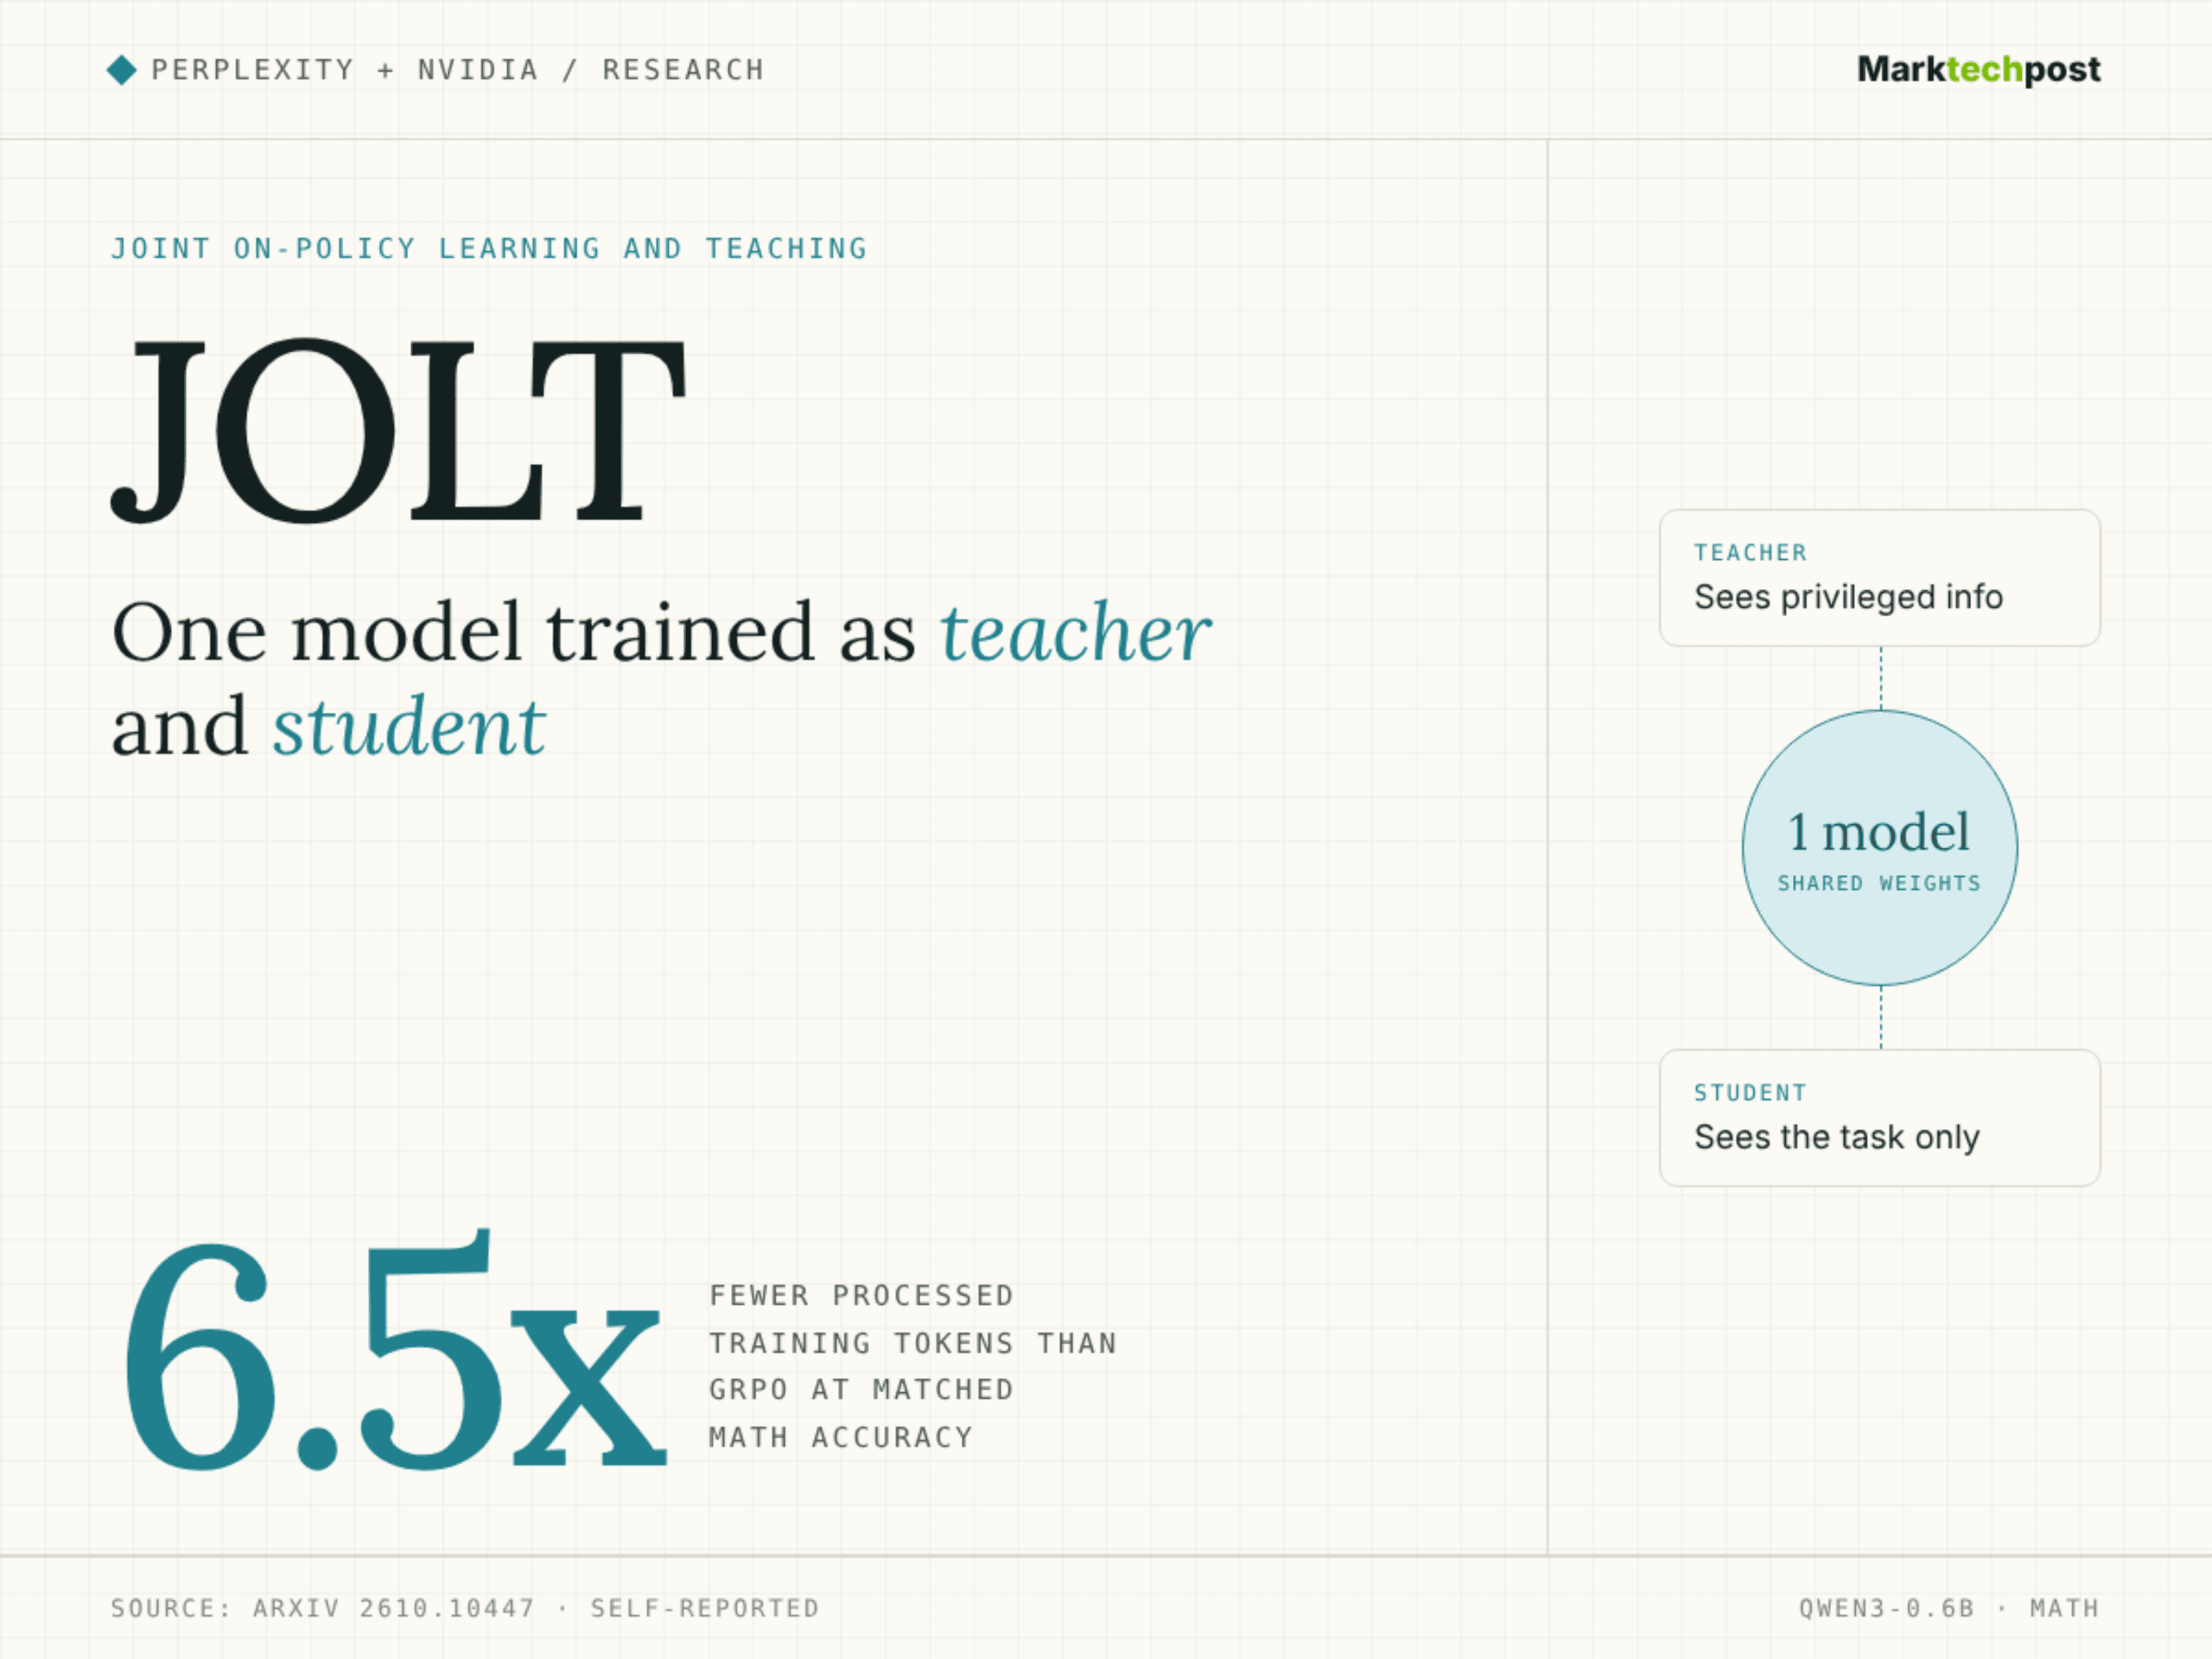
Perplexity ร่วมกับทีม NVIDIA เปิดตัว JOLT วิธีการหลังการฝึกฝน (post-training) รูปแบบใหม่สำหรับโมเดลภาษา JOLT ย่อมาจาก Joint On-policy Learning and Teaching ซึ่งมีจุดเด่นคือการฝึกโมเดลเดียวให้ทำหน้าที่ 2 บทบาทไปพร้อมกัน
ในการทำงานนี้ ผู้สอน (teacher) จะสามารถมองเห็นข้อมูลพิเศษ (privileged information) ที่ผู้เรียน (student) มองไม่เห็น โดยหัวใจสำคัญคือการฝึกฝนผู้สอนควบคู่ไปด้วยเพื่อให้การตอบกลับ (feedback) ยังคงประสิทธิภาพและใช้งานได้จริง จากการทดสอบบน MATH พบว่า JOLT ให้ความแม่นยำเทียบเท่ากับ GRPO แต่ใช้ training token ในการประมวลผลน้อยกว่าถึง 6.5 เท่า ซึ่งถือเป็นความก้าวหน้าสำคัญในเรื่องการบริหารจัดการทรัพยากรการคำนวณ (compute)
TL;DR
- คืออะไร: วิธีการแบบ post-training สำหรับโมเดลภาษา
- ขนาด: ทดสอบกับ Qwen3-0.6B, Qwen3-4B-Instruct, Qwen3-8B, Qwen3-30B-A3B-Instruct และ DeepSeek-V2-Lite
- ทำงานบน: ใช้โมเดลร่วมกันเพียง 1 โมเดลทำหน้าที่ทั้งสองบทบาทโดยไม่มีโมเดลผู้สอนแยกต่างหาก
- ประสิทธิภาพ: JOLT+ ทำคะแนนเฉลี่ยสูงสุดในทุกการตั้งค่าเมื่อเทียบกับ GRPO, OPSD และ π-Distill
- ดีที่สุด: ทำอัตราการผ่าน AppWorld state-test ได้ที่ 72.09% ด้วย JOLT+ สูงกว่า GRPO ที่ทำได้ 62.20% (+9.9 จุด)
- แย่ที่สุด: JOLT รุ่นปกติที่ไม่มีรางวัลสำหรับผู้เรียนทำคะแนนบน AppWorld ได้ 51.92% ซึ่งต่ำกว่า GRPO
Perplexity JOLT คืออะไร?
JOLT เป็นเทคนิคการฝึกแบบ self-distillation ที่พัฒนาโดย Perplexity และ NVIDIA โดยให้โมเดลเดียวสวมบทบาทเป็นทั้งผู้สอนและผู้เรียนพร้อมกัน วิธีการนี้ต่อยอดมาจาก On-Policy Self-Distillation (OPSD) เพื่อเพิ่มประสิทธิภาพในการเรียนรู้
ทำไม RL post-training ถึงต้องการผู้สอนที่ดีกว่าเดิม?
ปกติแล้ว RL แบบให้รางวัลตามผลลัพธ์ (Outcome-reward RL) เช่น GRPO จะให้หนึ่งรางวัลต่อความพยายามหนึ่งครั้ง ซึ่งเป็นสัญญาณที่ค่อนข้างเบาบาง (sparse) เนื่องจากไม่ระบุชัดเจนว่า token ใดคือตัวแปรสำคัญ ส่งผลให้การเรียนรู้ในงานประเภท agentic ที่ซับซ้อนเป็นไปอย่างล่าช้า
แม้ On-Policy Distillation จะพยายามแก้ปัญหานี้ด้วยการใช้ผู้สอนให้คะแนนในแต่ละ token และ OPSD จะช่วยตัดโมเดลผู้สอนที่แยกต่างหากออกไป แต่ทีมวิจัยพบว่ายังไม่เพียงพอ เพราะผู้สอนที่มีคำตอบในมือมักใช้ "วิธีลัด" ที่ผู้เรียนไม่สามารถทำตามได้ ทำให้ความไม่สอดคล้องกันระหว่างผู้สอนและผู้เรียนเพิ่มขึ้นในระหว่างการฝึกฝน
JOLT ทำงานอย่างไร?
JOLT ใช้วิธีฝึกทั้งสองบทบาทในโมเดลเดียวไปพร้อมๆ กัน ดังนี้:
- ผู้สอน (Teacher): ได้รับข้อมูลพิเศษและเรียนรู้จากรางวัลของผลลัพธ์ (outcome rewards) พร้อมใช้ KL penalty เพื่อรักษาความใกล้ชิดกับระดับของผู้เรียนไว้
- ผู้เรียน (Student): มองเห็นเฉพาะโจทย์และเรียนรู้จากสัญญาณ distillation ระดับ token ที่ได้รับจากผู้สอน
- On-policy: ทั้งสองบทบาทจะเรียนรู้จากเส้นทาง (trajectories) ที่สร้างขึ้นภายใต้บริบทของตนเอง
- JOLT+: มีการเพิ่มรางวัลผลลัพธ์ของผู้เรียนเองเข้าไปในการอัปเดตข้อมูลของผู้เรียนด้วย
เป้าหมายของงานวิจัยนี้คือการทำให้ผู้สอน 'สอดคล้องกับรางวัล' (reward-consistent) เพื่อให้คำแนะนำชี้ไปในทิศทางเดียวกับรางวัลที่ผู้เรียนจะได้รับ ผู้สอนที่เหมาะสมจึงต้องช่วยส่งเสริมการกระทำที่ได้เปรียบสูง (high-advantage actions) โดยไม่ทิ้งห่างจากนโยบาย (policy) เดิมของผู้เรียนจนเกินไป
ประสิทธิภาพของ JOLT บน benchmark
ทีมวิจัยทดสอบ 5 รูปแบบ โดยใช้โมเดลฐานและข้อมูลพิเศษที่แตกต่างกัน:
- GSM8K: ใช้ DeepSeek-V2-Lite โดยผู้สอนจะเห็นคำตอบที่ยืนยันแล้ว
- MATH: ใช้ Qwen3-0.6B โดยผู้สอนเห็นแนวทางการแก้ปัญหาอ้างอิง
- LiveCodeBench v6: ใช้ Qwen3-8B ใน 131 ปัญหา โดยผู้สอนเห็นผลลัพธ์จากการรันโค้ด
- AppWorld: ใช้ Qwen3-4B-Instruct โดยผู้สอนเห็นสรุปความพยายามในอดีต
- Terminal-Bench 2.1: ใช้ Qwen3-30B-A3B-Instruct ฝึกบน TMax โดยผู้สอนเห็นไฟล์ตรวจสอบส่วนตัว
ผลลัพธ์แสดงให้เห็นว่า JOLT+ มีคะแนนเฉลี่ยสูงสุดในทุกการตั้งค่า โดยเฉพาะบน AppWorld ที่ทำคะแนนเพิ่มขึ้นถึง 9.9 จุดเมื่อเทียบกับ GRPO ส่วนใน Terminal-Bench 2.1 JOLT+ ทำคะแนน pass@1 ได้ 10.96% สูงกว่า GRPO ที่ทำได้ 8.25%
JOLT ประหยัดทรัพยากรการคำนวณได้แค่ไหน?
ในการทดสอบกับ MATH พบว่าที่ระดับความแม่นยำ 63.44% วิธีการแบบ GRPO ต้องใช้ training token ถึง 8.40M ในขณะที่ JOLT ใช้เพียง 1.30M ซึ่งประหยัดกว่า 6.5 เท่า และหากวัดเฉพาะ completion tokens ช่องว่างจะกว้างขึ้นถึง 13 เท่า นอกจากนี้ JOLT ยังสามารถดันเพดานความแม่นยำไปได้สูงสุดเกือบ 72% ซึ่งสูงกว่าทั้ง GRPO และ OPSD
สรุปการเปรียบเทียบ
| คุณสมบัติ | JOLT | JOLT+ | GRPO | OPSD | π-Distill |
|---|---|---|---|---|---|
| โมเดลผู้สอนแยกต่างหาก | ไม่ | ไม่ | ไม่มีผู้สอน | ไม่ | ไม่ |
| ผู้สอนได้รับการฝึกฝน | ใช่ | ใช่ | ไม่ระบุ | ไม่ | ใช่ |
| สัญญาณผู้เรียน | Dense distillation | Distillation + รางวัล | Outcome reward | Dense distillation | Off-policy |
| MATH, Qwen3-0.6B (%) | 72.14 ± 0.90 | 72.59 ± 1.17 | 68.36 ± 3.73 | 61.20 ± 2.10 | 42.25 ± 1.10 |
| AppWorld, Qwen3-4B (%) | 51.92 ± 5.30 | 72.09 ± 6.01 | 62.20 ± 2.83 | 29.49 ± 2.48 | 59.85 ± 2.97 |
แม้ JOLT รุ่นปกติจะยังตามหลัง GRPO ในบางการทดสอบเช่น AppWorld แต่เวอร์ชัน JOLT+ ได้พิสูจน์ให้เห็นถึงศักยภาพที่เหนือกว่าในทุกด้าน พร้อมการใช้ทรัพยากรที่คุ้มค่ากว่าอย่างชัดเจน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร