
Sakana AI เปิดตัว Error Diffusion: ฝึก AI ด้วยหลักการชีวภาพโดยไม่ใช้ Backpropagation
การฝึกฝน Deep Learning ในปัจจุบันถูกครอบงำด้วย Backpropagation แต่กลไกนี้มีข้อจำกัดที่สมองมนุษย์อาจไม่ได้ทำตาม โดยเฉพาะขั้นตอน Backward Pass ที่ต้องใช้ค่า Transpose ของเมทริกซ์น้ำหนักอย่างแม่นยำ ซึ่งเรียกว่า ปัญหาการขนส่งน้ำหนัก (Weight Transport Problem) งานวิจัยใหม่จาก Sakana AI ในชื่อ paper, Diffusing Blame ได้นำเสนอแนวทางใหม่ที่สอดคล้องกับ
หลักการของ Dale (Dale’s principle) โดยหลีกเลี่ยงการขนส่งน้ำหนักอย่างสิ้นเชิง
Error Diffusion คืออะไร?
Error Diffusion (ED) เป็นกฎการเรียนรู้เฉพาะที่ (Local Learning Rule) ที่เสนอโดย Kaneko (2000) การอัปเดตน้ำหนักจะขึ้นอยู่กับสัญญาณเพียง 3 อย่าง ได้แก่ Presynaptic activity, Postsynaptic activation derivative และสัญญาณ Global error เพียงตัวเดียว ทำให้ ED ไม่ต้องใช้การ Transpose น้ำหนัก หรือใช้เมทริกซ์ Feedback แบบสุ่ม ซึ่งส่งผลให้ ED เข้ากันได้กับหลักการของ Dale โดยธรรมชาติ แม้ว่าก่อนหน้านี้ ED จะถูกจำกัดอยู่แค่ในงาน Binary Classification หรือ MNIST เท่านั้น
สถาปัตยกรรม Dual-Stream เพื่อก้าวข้ามข้อจำกัดเดิม ทีมวิจัยได้แบ่งแต่ละชั้น (Layer) ออกเป็นสองสตรีม ได้แก่ สตรีมแบบกระตุ้น (Excitatory - p) และสตรีมแบบยับยั้ง (Inhibitory - n) โดยที่ขั้นตอน Forward Pass จะมีการคำนวณดังนี้:
p_i = φ_i( +p_{i-1} Wpp − n_{i-1} Wnp + bp )
n_i = φ_i( +n_{i-1} Wnn − p_{i-1} Wpn + bn )
เมทริกซ์น้ำหนักทั้ง 4 ตัวจะถูกคุมให้มีค่าไม่เป็นลบ (Non-negative) ยกเว้นค่า Bias (b) ขณะที่เครื่องหมายลบหน้า Wnp และ Wpn ถูกกำหนดตายตัวเพื่อสร้างโครงสร้างการยับยั้ง การออกแบบนี้ใช้พารามิเตอร์มากกว่าโครงข่ายปกติประมาณ 4 เท่า (เช่น ~32M เทียบกับ ~8M ใน DFA.pn)
Modulo Error Routing
หัวใจสำคัญที่ช่วยให้ ED พัฒนาไปไกลกว่าการทำ Binary Classification คือการใช้ Modulo Error Routing สำหรับหน่วยซ่อน (Hidden unit) i ทีมวิจัยจะกำหนดเส้นทาง r(i) = i mod C (เมื่อ C คือมิติของเอาต์พุต) เพื่อให้หน่วยนั้นเรียนรู้จาก Error เฉพาะช่องสัญญาณที่ได้รับมอบหมายคงที่ ต่างจาก DFA ที่ใช้ Feedback แบบสุ่ม
นวัตกรรม 3 ประการเพื่อประสิทธิภาพที่สูงขึ้น
ทีมวิจัยได้เสริมเทคนิคพิเศษ 3 อย่างสำหรับการเรียนรู้แบบ Multi-class Classification:
- ความกว้างของ Sigmoid เฉพาะเลเยอร์: ใช้
φเนื่องจากอนุพันธ์ของ Sigmoid มีผลต่อสัญญาณ Error การใช้ Sigmoid ที่กว้างขึ้น (ตั้งค่า α = 3.0 สำหรับ Conv layers และ α = 6.0 สำหรับ FC layers) ช่วยป้องกันการอิ่มตัว (Saturation) ของสัญญาณ - Batch-centered class error: ลบค่าเฉลี่ยของ Mini-batch รายคลาส เพื่อช่วยลดอาการยับยั้งต่อเนื่องที่เกิดจากความไม่สมดุลของเป้าหมาย (ระดับ 9:1)
- การตั้งค่าเริ่มต้นแบบอสมมาตร (Asymmetric initialization): ปรับสัดส่วนน้ำหนัก Excitatory ให้สูงกว่า Inhibitory เพื่อให้ได้อัตราส่วน E/I ที่ 3:1
ประสิทธิภาพที่ได้รับ
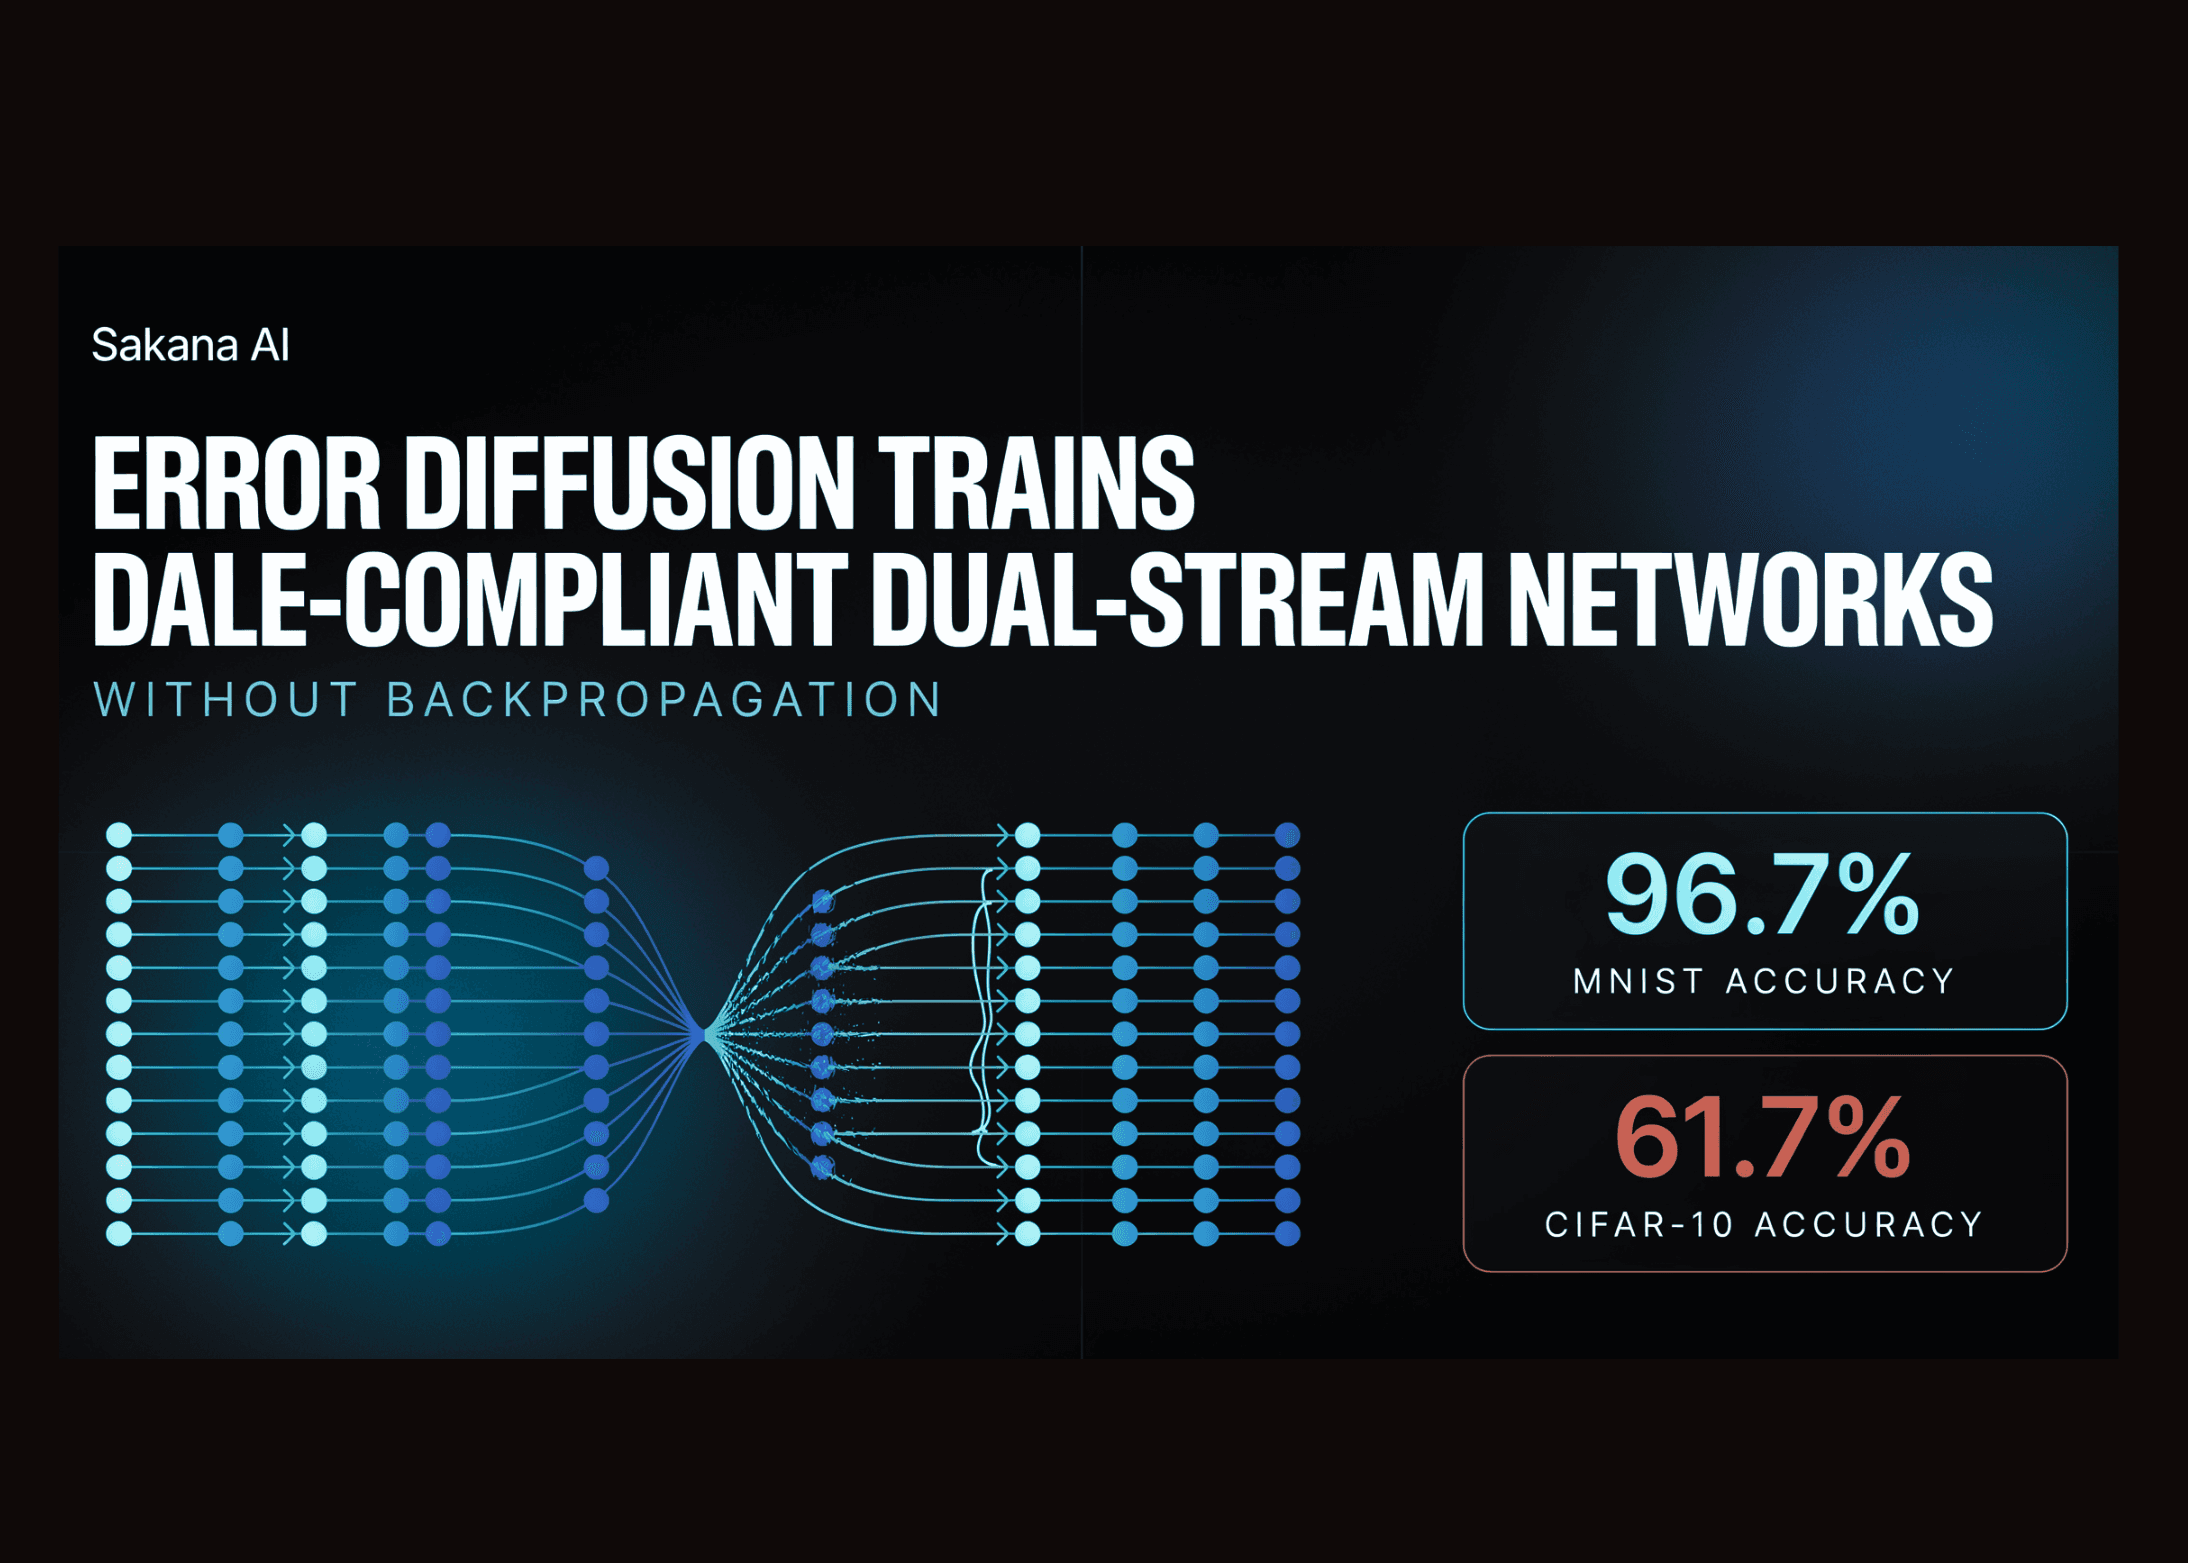
ด้วยนวัตกรรมเหล่านี้ ED สามารถทำคะแนน MNIST ได้ถึง 96.7% และ CIFAR-10 ที่ 61.7% ซึ่งถือเป็นครั้งแรกที่มีการใช้ ED ฝึกฝนโครงข่ายแบบ Convolutional แม้จะยังตามหลังวิธีการ Gradient มาตรฐาน แต่ก็แสดงให้เห็นถึงศักยภาพที่น่าสนใจ
| Method | MNIST | CIFAR-10 | Dale-compliant | Notes |
|---|---|---|---|---|
| Proposed ED | 96.7% | 61.7% | Yes | All weights non-negative; first ED on CNNs |
| Seed ED | 50.4% | 11.6% | Yes | No innovations; α = 1.0, raw error, symmetric init |
| DFA | 97.6% | 69.1% | No | Random feedback; ∼2.84M negative weights |
การวิเคราะห์ความสำคัญของตัวแปร (Ablation Analysis)
สิ่งที่น่าสนใจคือ ความสำคัญของเทคนิคต่างๆ จะเปลี่ยนไปตามประเภทงาน สำหรับ MNIST การปรับความกว้าง Sigmoid มีความสำคัญสูงสุด ขณะที่ใน CIFAR-10 การทำ Batch-centering กลับเป็นปัจจัยชี้ขาด ความแตกต่างนี้เผยให้เห็นคอขวดของการกำหนดเครดิต (Credit Assignment) ที่แตกต่างกันในแต่ละโจทย์
Error Diffusion ในโลกของ Reinforcement Learning
ทีมวิจัยยังได้พัฒนา ED-PPO โดยนำ ED ไปผสานกับวิธีการ Proximal Policy Optimization เพื่อทดสอบในงานอย่าง Brax และ Craftax ผลการทดลองพบว่า ED-PPO สามารถเอาชนะ BP-PPO ในการทดสอบ HalfCheetah (5494 เทียบกับ 3520) และทำได้ดีกว่า DFA-PPO ในงานแนว Open-ended อย่าง Craftax
กรณีการใช้งานที่สำคัญ
- ฮาร์ดแวร์ยุคใหม่: เหมาะสำหรับชิปประมวลผลแสง (Photonic) หรือฮาร์ดแวร์ Neuromorphic ที่มักถูกจำกัดให้ใช้น้ำหนักแบบไม่เป็นลบได้ดีกว่า
- ความเบาบางของโมเดล: การใช้น้ำหนักไม่เป็นลบทำให้เกิดความเบาบาง (Sparsity) โดยธรรมชาติ โดยเฉพาะการเชื่อมต่อแบบ Inhibitory ที่ถูกตัดออก (Pruned) ได้สูงถึง 68.8% ช่วยในเรื่องการบีบอัดโมเดล
- การเรียนรู้ต่อเนื่อง: โครงสร้างการยับยั้งช่วยลดปัญหา Gradient ระเบิด (Gradient Exploding) ในการเรียนรู้แบบปลายเปิด
ตารางเปรียบเทียบ Error Diffusion และเทคนิคอื่นๆ
| Method | Backprop-free (no weight transport) | How error reaches hidden layers | Dale-compliant (E/I, non-negative) | Shown on RL | Demonstrated reach / notes |
|---|---|---|---|---|---|
| Backpropagation | No (uses transpose) | All-to-all gradients | No | Yes | Standard baseline |
| Feedback Alignment (FA) | Yes | Random feedback matrix | No | Yes | CIFAR-10 convolution |
| Direct Feedback Alignment (DFA) | Yes | Direct random feedback | No | Yes | CIFAR-10 / ImageNet |
| Dale’s ANNs (DANNs) | No (uses BP) | All-to-all gradients | Yes | No | Biological plausibility focus |
| Predictive coding | Yes | Local prediction errors | No | No | Hebbian-like inference |
| Dendritic cortical microcircuits | Yes | Integrated drendrites | No | No | Cortical column model |
| Evolution Strategies (ES) | Yes | Perturbation estimation | No | Yes | Black-box optimization |
| Original Error Diffusion | Yes | r(i) = i mod C | Yes | No | Binary / MNIST MLP only |
ตัวอย่างโค้ดเบื้องต้น
import torch
def dual_stream_forward(p, n, Wpp, Wnp, Wnn, Wpn, bp, bn, phi):
    # All W >= 0; cross-stream signs are hardcoded inhibitory (Dale's principle)
    p_next = phi(p @ Wpp - n @ Wnp + bp) # excitatory stream
    n_next = phi(n @ Wnn - p @ Wpn + bn) # inhibitory stream
    return p_next, n_next

def routed_error(S, H, C): # S: output error, shape (B, C)
    M = torch.zeros(H, C)
    for i in range(H):
        M[i, i % C] = 1.0 # r(i) = i mod C
    return S @ M.T # R = S M^T, shape (B, H)

def ed_update(A_p, Z_p, R, phi_deriv):
    U_p = phi_deriv(Z_p) * R # local postsynaptic drive
    return A_p.T @ U_p # dWpp ∝ A_p^T U_p, shape (K, H)
บทสรุป
งานวิจัยครั้งนี้เป็นก้าวสำคัญที่พิสูจน์ว่า เราสามารถฝึกโครงข่ายประสาทเทียมที่สอดคล้องกับหัวใจสำคัญของชีววิทยา (Dale's Principle) และก้าวข้ามขีดจำกัดทางวิศวกรรม (Backprop-free) ได้พร้อมกัน แม้จะมีราคาที่ต้องจ่ายเป็นคะแนนความแม่นยำที่ลดลงเล็กน้อยเมื่อเทียบกับ DFA แต่ก็เปิดทางสู่สถาปัตยกรรม AI ที่มีประสิทธิภาพในเชิงฮาร์ดแวร์และการเรียนรู้ที่ยืดหยุ่นกว่าในอนาคต
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร