
Xiaomi ปล่อย MiMo-V2.6-Pro โมเดล AI โอเพนซอร์สที่แรงและถูกที่สุดในโลก
ประเด็นสำคัญ
- โมเดล MiMo-V2.6-Pro รุ่นใหม่ของ Xiaomi ครองอันดับหนึ่งในการจัดอันดับโมเดล Open AI ในปัจจุบัน โดยมีต้นทุนการใช้งานต่ำกว่าคู่แข่งอย่างมหาศาล
- Xiaomi ประสบความสำเร็จด้วยการขยายกระบวนการเรียนรู้แบบเสริมกำลัง (Reinforcement Learning - RL) พร้อมเปิดเผยเครื่องมือและชุดข้อมูลการฝึกฝนสู่สาธารณะ
- อย่างไรก็ตาม Anthropic ได้กล่าวหาว่า Xiaomi ลักลอบดึงข้อมูลจากโมเดล Claude เพื่อนำไปพัฒนาและฝึกฝนโมเดลของตนเองอย่างไม่ถูกต้อง
Xiaomi เปิดตัวไลน์อัป MiMo-V2.6 โดยมีโมเดลเรือธงที่สามารถทำคะแนนขึ้นแท่นอันดับหนึ่งในกลุ่มโมเดลเปิด (Open Model) โดยมีค่าใช้จ่ายต่อภารกิจเพียงเศษเสี้ยวของคู่แข่ง ความก้าวหน้านี้เป็นผลมาจากการขยายรอบการเรียนรู้แบบเสริมกำลังอย่างมหาศาล แม้จะมีประเด็นอื้อฉาวเรื่องการดึงข้อมูลจาก Claude ของ Anthropic มาใช้งานก็ตาม
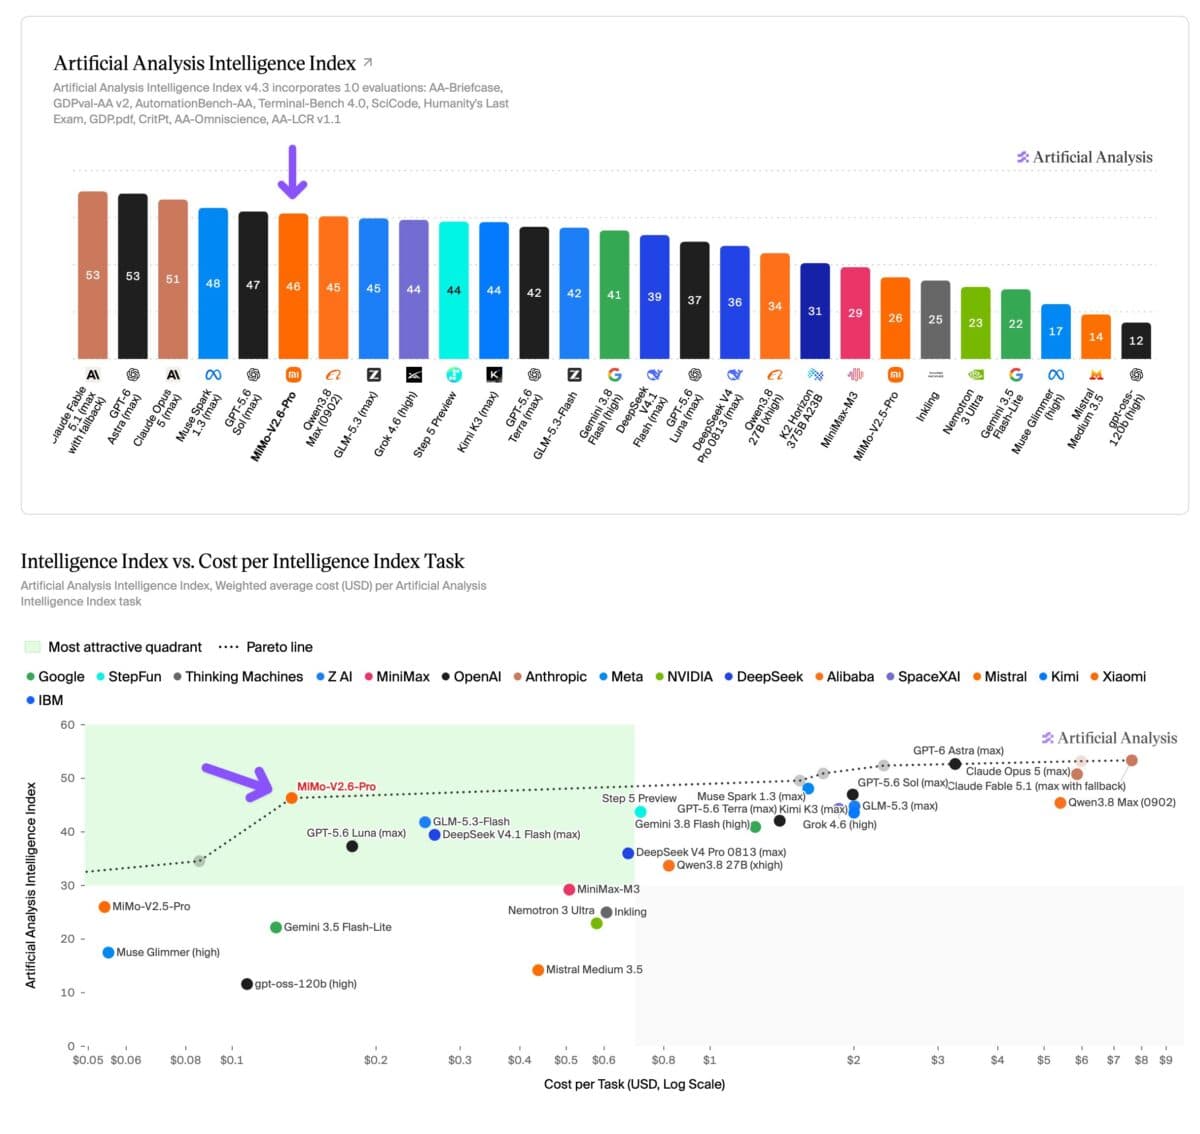
ข้อมูลจาก Xiaomi ระบุว่าโมเดลรุ่นใหญ่ใน โมเดลใหม่ ทั้งสองรุ่นอย่าง MiMo-V2.6-Pro ทำคะแนนได้ 46 คะแนนในดัชนีปัญญาประดิษฐ์ (Intelligence Index) ของ Artificial Analysis ส่งผลให้มันเป็นโมเดล AI แบบเปิดที่แข็งแกร่งที่สุดในขณะนี้ แซงหน้าคู่แข่งอย่าง Kimi K3 และ Qwen โดยมีราคาเพียง $0.435 ต่อหนึ่งล้าน input token และ $0.87 ต่อหนึ่งล้าน output token
จากการวิเคราะห์ของ Artificial Analysis พบว่าภารกิจทดสอบเดี่ยวมีค่าใช้จ่ายเพียงประมาณ $0.13 ซึ่งถูกกว่าโมเดลที่มีความสามารถใกล้เคียงกันอย่างมาก ทำให้ MiMo-V2.6-Pro ก้าวขึ้นสู่จุดที่เรียกว่าแนวหน้าปาเรโต (Pareto frontier) หรือจุดสมดุลสูงสุดระหว่างความฉลาดและต้นทุนที่คุ้มค่า
ในเชิงเทคนิค MiMo-V2.6-Pro เป็นโมเดลแบบ Mixture-of-Experts (MoE) ที่มีพารามิเตอร์รวม 1.02 ล้านล้านพารามิเตอร์ แต่จะเปิดทำงานเพียง 42 พันล้านพารามิเตอร์ต่อการเรียกใช้งานหนึ่งครั้ง นอกจากนี้ยังมีรุ่น MiMo-V2.6-Flash ที่มีขนาดเล็กกว่าและเน้นประสิทธิภาพความเร็วควบคู่กันด้วย
ความก้าวหน้ามาจากการเรียนรู้แบบเสริมกำลัง
Xiaomi เผยว่าประสิทธิภาพที่ก้าวกระโดดนี้เกิดจากการขยายกระบวนการเรียนรู้แบบเสริมกำลัง (RL) อย่างหนัก ซึ่งเป็นการฝึกผ่านการทดลองและให้รางวัล โดยบริษัทให้ความสำคัญใน 3 ด้านคือ การเพิ่มปริมาณข้อมูลต่อขั้นตอนการฝึก, การเพิ่มความหลากหลายของสภาพแวดล้อมภารกิจ และการเพิ่มพลังประมวลผลสำหรับประเมินวิธีแก้ปัญหา
ระบบนี้ใช้เวลาประมวลผลไม่ถึง 6 วัน โดยมีค่าใช้จ่ายประมาณ 2.62 ล้านดอลลาร์สำหรับรุ่น Pro และ 0.85 ล้านดอลลาร์สำหรับรุ่น Flash ซึ่งผลลัพธ์ที่ได้นั้นคุ้มค่ามาก เช่น ในการทดสอบเขียนโค้ด DeepSWE รุ่น Pro สามารถทำคะแนนเพิ่มขึ้นจาก 58.4 เป็น 72.6 ขณะที่รุ่น Flash เพิ่มจาก 48.8 เป็น 65.7 เพื่อให้การฝึกฝนมีความเสถียร Xiaomi ได้ทำการตรึงกลไกการกระจายภายในของโมเดล และเพิ่มเลเยอร์ป้องกันพฤติกรรม "reward hacking" ซึ่งเป็นอาการที่ AI พยายามหาทางลัดเพื่อเอาชนะระบบให้รางวัลโดยที่ไม่ได้แก้ปัญหาจริง
แจกฟรีภารกิจ 7,000 รายการพร้อมระบบตรวจให้คะแนนอัตโนมัติ
นอกจากการปล่อยโมเดลแล้ว Xiaomi ยังส่งมอบรุ่น Pro-UltraSpeed ที่มีความเร็วการประมวลผลผลลัพธ์สูงถึง 20 เท่า ที่สำคัญคือบริษัทได้เปิดชุดเครื่องมือ RL สู่สาธารณะ ซึ่งรวมถึงรายงานทางเทคนิค, เฟรมเวิร์กการฝึกอบรม, โมเดลขนาดเล็กสำหรับการฝึกเพิ่มเติม และภารกิจฝึกฝนสำเร็จรูปกว่า 7,000 รายการ
ภารกิจเหล่านี้ครอบคลุมตั้งแต่การพัฒนาซอฟต์แวร์ ความปลอดภัยไซเบอร์ งานสำนักงาน ไปจนถึงการแต่งเพลง โดยรวบรวมข้อมูลมาจากหลายแหล่ง เช่น pull request บน GitHub ของพนักงานจริง และการจำลองช่องโหว่ซอฟต์แวร์จาก OSS-Fuzz เพื่อสร้างสภาพแวดล้อมการเรียนรู้ที่สมจริงที่สุด
ความใจกว้างที่มาพร้อมข้อสงสัยจาก Anthropic
ท่าทีที่ดูเปิดกว้างของ Xiaomi กลับสวนทางกับข้อกล่าวหาจาก Anthropic เมื่อสองสัปดาห์ก่อน ที่ระบุว่าห้องปฏิบัติการในจีนหลายแห่ง รวมถึง Xiaomi, Alibaba และ DeepSeek ได้ลักลอบดึงข้อมูลจาก Claude ไปใช้ฝึกฝนโมเดลของตนเอง ซึ่งเป็นเทคนิคที่เรียกว่าการกลั่นกรองที่ผิดกฎหมาย (Illegal Distillation)
ในรายงานระบุชัดเจนถึงกรณี GTG-16008 ว่ามีการแลกเปลี่ยนข้อมูลกว่า 400,000 ครั้งในช่วงเดือนมีนาคมและเมษายน 2026 โดย Xiaomi ถูกกล่าวหาว่านำบทสนทนาระหว่างผู้ใช้กับโมเดล MiMo ของตนเองไปป้อนให้ Claude ผ่านช่องทาง OpenClaw และ OpenCode เพื่อดึงข้อมูลคุณภาพสูงกลับมาพัฒนาโมเดลรุ่นใหม่
ข้อกล่าวหานี้ชี้ให้เห็นว่า ข้อมูลที่ทำให้โมเดลของ Xiaomi พุ่งทะยานสู่จุดสูงสุดของการจัดอันดับโมเดลแบบเปิดในตอนนี้ อาจมีที่มาจากบทสนทนาของผู้ใช้ที่ถูกนำไปรีไซเคิลผ่านสมองกลของคู่แข่งอย่าง Claude นั่นเอง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร