
Kyutai เปิดตัว Voice of Reason โมเดลเสียงแก้โจทย์เลขด้วย RL
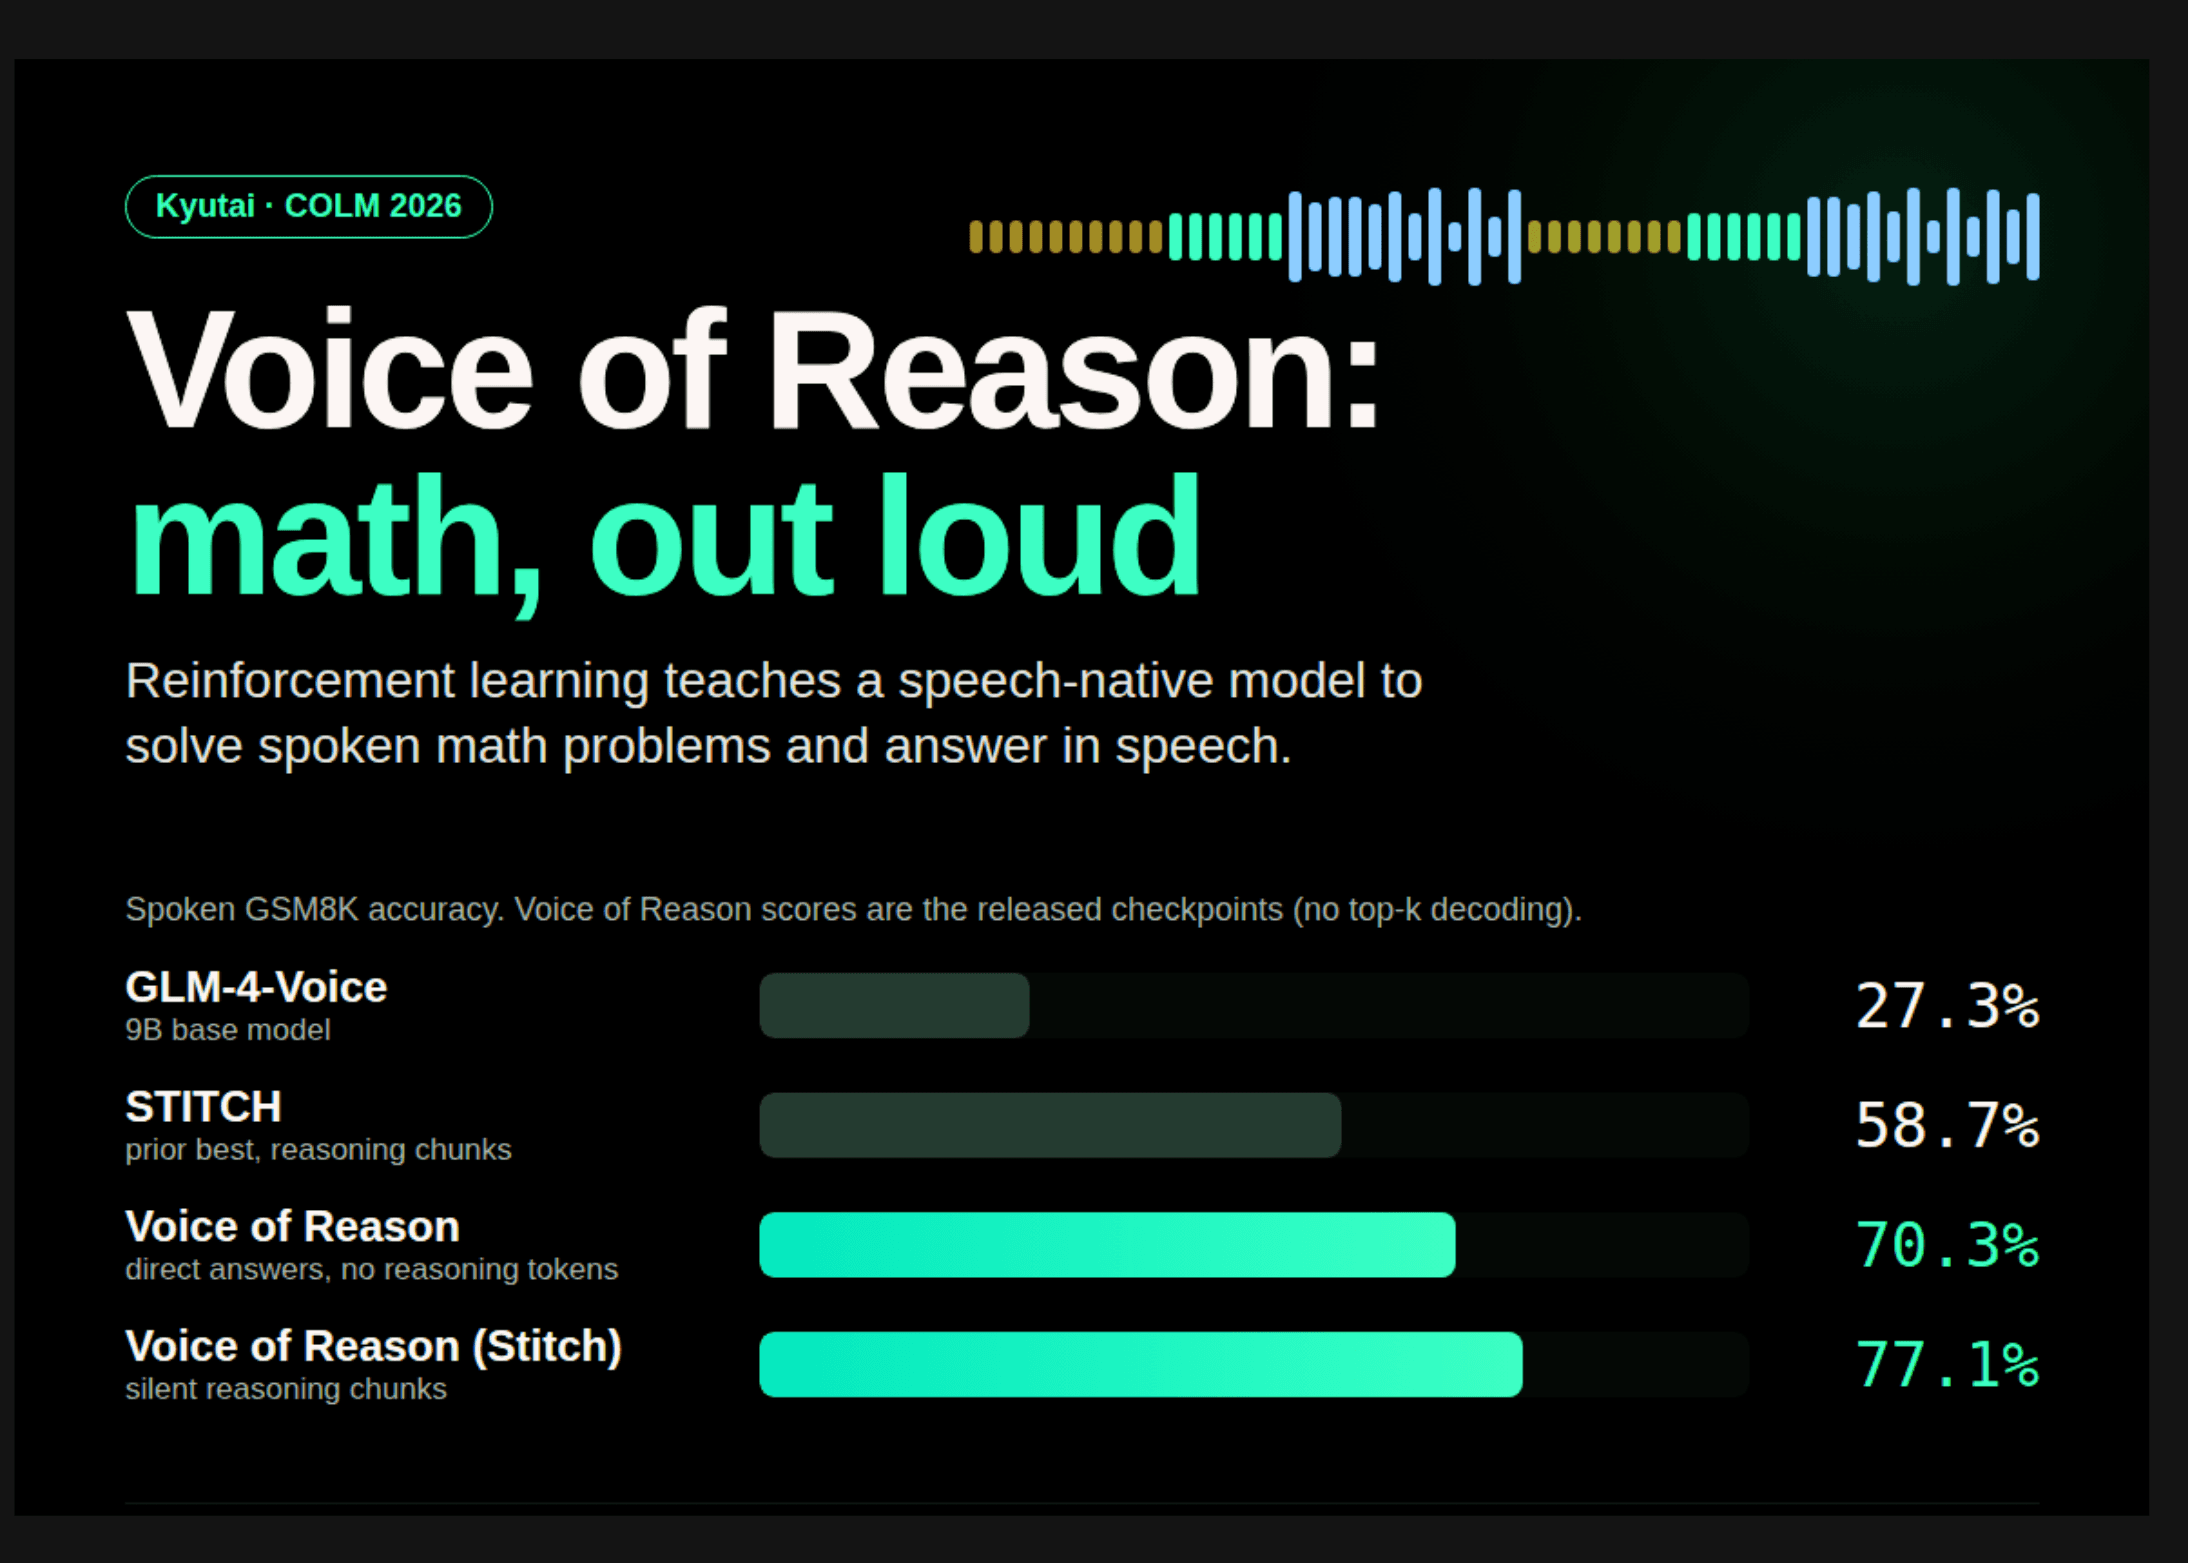
Kyutai ได้เปิดตัว Voice of Reason ซึ่งเป็นโมเดล speech-to-speech แบบ open-weight จำนวน 2 โมเดลที่สามารถแก้โจทย์คณิตศาสตร์ด้วยการพูดออกมา ทั้งคู่เริ่มต้นจาก GLM-4-Voice-9B และเพิ่ม supervised fine-tuning (SFT) และ reinforcement learning (RL) เข้าไป โดยไม่มีขั้นตอนการแปลงเป็นข้อความและไม่มี text LLM แยกต่างหากอยู่ในกระบวนการ สำหรับเกณฑ์วัด spoken GSM8K ความแม่นยำพุ่งสูงขึ้นจาก 27.3% ในโมเดลฐาน เป็น 77.1%
ผู้ใช้งานสามารถนำโมเดลนี้ไปใช้งานจริงในรูปแบบ self-hosting ได้ โดย Kyutai รันทั้งสอง BF16 checkpoint บน H100 เพียงตัวเดียว นอกจากนี้คุณยังต้องการ GLM-4-Voice repo สำหรับ speech tokenizer และ decoder ของมันด้วย โดยค่าน้ำหนัก (weights) จะสืบทอดสัญญาอนุญาตของ GLM-4-Voice และยังไม่มีผู้ให้บริการ inference บน Hugging Face รายใดโฮสต์โมเดลเหล่านี้ในขณะนี้
ทำไมโมเดลเสียงถึงตามหลังในด้านคณิตศาสตร์
ระบบแบบ Cascaded pipelines (speech-to-text, text LLM, text-to-speech) ยังคงเป็นผู้นำในด้านการใช้เหตุผล อย่างไรก็ตาม แต่ละขั้นตอนจะเพิ่มความล่าช้า (latency) และ pipeline จะสูญเสียสัญญาณทางภาษาอื่นๆ เช่น น้ำเสียง โมเดลแบบ speech-native จำเป็นต้องส่งสัญญาณเสียงออกมาเป็นระยะๆ เพื่อคงความเป็นปฏิสัมพันธ์ ซึ่งจำกัดจำนวน hidden reasoning tokens ที่พวกมันจะสามารถใช้ได้
Base GLM-4-Voice ทำคะแนนได้ 27.3% บน GSM8K ส่วนวิธีการ STITCH ก่อนหน้านี้ได้เพิ่มคะแนนเป็น 58.7% โดยการเพิ่ม reasoning chunks ทีมวิจัยเรียกผลงานของพวกเขาว่าเป็นการนำ RL มาใช้กับการใช้เหตุผลทางคณิตศาสตร์ในโมเดล speech-native เป็นครั้งแรก
การฝึกฝนทำงานอย่างไร
GLM-4-Voice จะสลับ output ของมัน: text tokens 13 ตัว ตามด้วย audio tokens 26 ตัว วนซ้ำไป
Stage-1 SFT: การฝึกฝนใช้โจทย์ 150,616 ข้อจาก Orca-Math โดย Qwen3-235B ได้เขียนโจทย์แต่ละข้อใหม่สำหรับภาษาพูด จากนั้น DSM TTS ของ Kyutai ได้พากย์เสียงเหล่านั้นด้วยเสียงที่หลากหลาย ลำพังแค่ SFT ก็ช่วยยกระดับ GLM-4-Voice จาก 27.3% เป็น 61.7%
Stage-2 RL: สำหรับคำถามเสียงแต่ละข้อ โมเดลจะสุ่มตัวอย่างคำตอบ 4 แบบที่ค่า temperature 0.9 โดยมีผู้ตัดสินคือ Qwen3-235B-A22B-2507 ทำหน้าที่ให้คะแนนข้อความที่ถอดรหัสออกมาด้วยรางวัลแบบ binary ซึ่งผู้ตัดสินจะไม่เห็นคำตอบอ้างอิงเลย จากกรณีที่ตรวจสอบด้วยมือ 100 กรณี พบว่าผู้ตัดสินมีความเห็นตรงกับมนุษย์ถึง 88%
รางวัลจะถูกจัดให้อยู่ตรงกลางภายในแต่ละกลุ่ม เพื่อสร้างวัตถุประสงค์แบบ group-relative REINFORCE ซึ่งมีความเกี่ยวข้องกับ GRPO แต่ตัดการทำ PPO clipping และ KL regularization ออก การฝึกฝนทำงานบน GPU H100 จำนวน 16 ตัว พร้อมการอัปเดต RL 1,500 ครั้ง
ทางเลือกในการออกแบบ 2 อย่างที่สำคัญที่สุด:
Temperature correction: ค่า Logits จะถูกหารด้วย sampling temperature ก่อนที่จะเข้าสู่ log-softmax ในส่วนของ loss หากไม่มีส่วนนี้ GSM8K จะพังทลายจาก 65.5% เหลือเพียง 12.3%
Audio-token merging: ที่ตำแหน่งเสียงแต่ละตำแหน่ง ความน่าจะเป็นของ audio-vocabulary ทั้งหมดจะถูกรวมเข้าเป็น 1 abstract token โดย loss จะถามเพียงว่ามีเสียงตามมาหรือไม่ ไม่ใช่ถามว่าเป็น audio token ตัวไหน งานวิจัยพิสูจน์ว่าตัวประมาณค่านี้ไม่มีความลำเอียงและมีความแปรปรวนต่ำกว่าภายใต้สมมติฐาน value-invariance
Interactive Explainer
2 Checkpoints ที่ปล่อยออกมา
glm-4-voice-of-reason-9b ตอบโดยตรงโดยไม่มี reasoning tokens พิเศษ ขั้นตอนการทำงานทีละขั้นจะถูกพูดออกมาดังๆ
ส่วน glm-4-voice-of-reason-stitch-9b จะเขียน reasoning chunks แบบเงียบขนาด 100 token ระหว่างบล็อกเสียง Kyutai กล่าวว่า chunks หลังๆ จะถูกสร้างขึ้นในขณะที่เสียงก่อนหน้ากำลังเล่น ดังนั้นการคิดจึงไม่เพิ่ม latency พิเศษ ในรูปแบบ STITCH-R ที่ใช้ที่นี่ reasoning chunk แรกจะเกิดขึ้นก่อนบล็อกเสียงแรก
ผลลัพธ์
| โมเดล | จำนวนพารามิเตอร์ | GSM8K (%) |
|---|---|---|
| PersonaPlex (full-duplex) | 8B | 3.2 |
| GLM-4-Voice | 9B | 27.3 |
| STITCH (Chiang et al.) | 9B | 58.7 |
| Voice of Reason | 9B | 65.5 ± 1.1 (ปล่อยออกมาที่ 70.3) |
| Voice of Reason (Stitch) | 9B | 74.8 ± 1.1 (ปล่อยออกมาที่ 77.1) |
| Qwen2.5-Omni (output ข้อความ) | 7B | 84.7 |
| Qwen3-Omni (output ข้อความ) | 30B | 94.6 |
| Cascaded ASR-LLM-TTS-ASR | 31B LLM | 95.7 |
คะแนนในรายงานวิจัยใช้การถอดรหัสแบบ top-k 50 เฉลี่ยจาก 3 seeds ส่วนการเอา top-k ออกจะได้คะแนน 70.3% และ 77.1% ซึ่ง checkpoint ที่ปล่อยออกมาตรงกับการรันเหล่านี้ ทั้งนี้ระบบ omni และ cascaded เป็นตัวเปรียบเทียบขนาดใหญ่ ไม่ใช่การเปรียบเทียบในระดับเดียวกัน
สิ่งที่ค้นพบอื่นๆ:
ประสิทธิภาพยังคงดีในเสียงจริง: เมื่อถอดความเป็นข้อความด้วย Qwen3-ASR-1.7B โมเดล Stitch ทำคะแนนได้ 72.0 ± 1.9%
ความเป็นธรรมชาติยังคงอยู่: UTMOSv2 เปลี่ยนจาก 4.067 เป็น 4.069 (แบบ direct) และ 4.174 เป็น 4.164 (แบบ Stitch) หลังจากทำ RL
คะแนนที่เพิ่มขึ้นไม่ได้มาจากคำตอบที่ยาวขึ้น: RL ช่วยลดเวลาตอบเฉลี่ยของโมเดล direct จาก 41.9 เหลือ 36.4 วินาที ส่วน Stitch reasoning tokens เพิ่มขึ้นเพียงเล็กน้อยจาก 167 เป็น 176
RL ช่วยได้มากที่สุดเมื่อมีข้อมูลน้อย: ด้วยข้อมูล SFT เพียง 10% การรัน RL ที่นานขึ้นสามารถทำคะแนนได้ถึง 58.5% ขณะที่ SFT เพียงอย่างเดียวทำได้ 43.9%
ความรู้ทั่วไปลดลงเล็กน้อย: Spoken TriviaQA ลดลงจาก 40.6% เป็น 34.0% สำหรับโมเดล direct ผู้เขียนระบุว่าเป็นผลมาจาก full-data SFT เป็นหลัก ไม่ใช่ RL
การตรวจสอบการปนเปื้อนข้อมูล (Contamination check): ทีมงานได้ถอด AddSub, MultiArith, SingleEQ และ SVAMP ออกจากการประเมิน จากคำถามที่ตรวจสอบ 678 ข้อ พบว่า 54.0% มีความซ้ำซ้อนกับ Orca-Math ในระดับการถอดความ (paraphrase)
เสียงที่ใช้ประเมินมาจาก GPT-4o-mini-TTS ซึ่งเป็นระบบ TTS ที่ต่างจากเสียงที่ใช้ฝึก และใช้ GPT-4o เป็นผู้ตัดสินในการประเมิน
บทสรุปสำคัญ
- สูตร RL ของ Kyutai ช่วยยกระดับ GLM-4-Voice จาก 27.3% เป็น 77.1% บน spoken GSM8K
- โมเดลแบบ Direct ทำคะแนนได้ 70.3% โดยไม่มี reasoning tokens ซึ่งชนะคะแนน 58.7% ของ STITCH
- Temperature correction เป็นสิ่งสำคัญมาก: การตัดออกทำให้ความแม่นยำดิ่งลงเหลือ 12.3%
- ความเป็นธรรมชาติของเสียงยังคงเดิมหลังทำ RL; คะแนน TriviaQA ลดลง ซึ่งส่วนใหญ่เกิดจาก SFT
- ทั้งสอง checkpoint ขนาด 9B เปิดให้ใช้งานบน Hugging Face และทำงานได้บน H100 1 ตัว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร