
Retrieve-for-Train: เร่งความเร็วการค้นหาด้วย AI ซับซ้อนได้ 20 เท่า
แอปพลิเคชันการค้นหาหรือการแนะนำในปัจจุบันถูกคาดหวังมากขึ้นว่าจะต้องส่งคืนชุดผลลัพธ์ที่สอดคล้องกันแทนที่จะเป็นผลลัพธ์ที่ตรงกันที่สุดเพียงรายการเดียว ตัวอย่างเช่น เมื่อผู้ใช้ค้นหา "camping gear" (อุปกรณ์ตั้งแคมป์) พวกเขาไม่ต้องการเพียงแค่เต็นท์สิบรายการที่คล้ายกัน แต่ต้องการชุดผลลัพธ์ที่เสริมกันซึ่งรวมถึงอุปกรณ์จำเป็นอย่างถุงนอน เตาพกพา และไฟฉายคาดศีรษะ เพื่อให้บรรลุสิ่งนี้ ระบบต่างๆ จึงใช้เทคนิค query fan-out ที่ย่อยพรอพต์กว้างๆ ออกเป็นข้อคำถามย่อย (sub-queries) ที่เกี่ยวข้องหลายรายการ อย่างไรก็ตาม การสอนให้ LLM ทำการ query decomposition ที่คำนึงถึงฐานข้อมูลแบบไดนามิกนั้นสิ้นเปลืองงบประมาณการคิด (thinking budget) มหาศาล โดยพื้นฐานแล้ว zero-shot LLMs คือเครื่องมือทำนายข้อความแบบ autoregressive ทั่วไป ไม่ได้ถูกปรับแต่งมาเพื่อนำทางใน geometric manifold หรือโครงสร้างเฉพาะของคลังข้อมูลเป้าหมาย ส่งผลให้ต้องใช้การคำนวณสูงมากในช่วงเวลาประมวลผล (test-time computation) เพื่อให้ได้ผลลัพธ์ที่หลากหลายและสอดคล้องกับข้อเท็จจริงในฐานข้อมูล
ในงานวิจัย ICML 2026 หัวข้อ “Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion” คณะผู้วิจัยได้แก้ปัญหาคอขวดนี้ผ่านกรอบการทำงาน Retrieve-for-Train ซึ่งใช้การเรียนรู้แบบเสริมกำลังแบบออฟไลน์ (offline RL) เพื่อค้นหาชุดคำค้นหาที่สอดคล้องกับเป้าหมาย แล้วรวบรวมข้อมูลเหล่านั้นเป็นชุดสอน (supervision) ให้กับโมเดล diffusion ขนาดเล็ก ทำให้สามารถค้นหาผลลัพธ์ที่ซับซ้อนได้ในครั้งเดียวโดยไม่ต้องพึ่งพา thinking tokens จำนวนมาก
ทำไม AI ทั่วไปจึงไม่ใช่ผู้เชี่ยวชาญด้านการค้นหา
การพึ่งพาโมเดลทั่วไปสำหรับการย่อยคำถามที่คำนึงถึงฐานข้อมูลมีข้อจำกัดสำคัญ 2 ประการ ประการแรกคือปัญหา Paraphrastic collapse: ซึ่ง zero-shot LLMs มักสร้างคำถามย่อยที่ซ้ำซ้อนกันเอง เช่น คำว่า "bohemian festival fashion" และ "bohemian festival clothes" แทนที่จะสำรวจแง่มุมที่ต่างกันแต่เสริมกันอย่าง แจ็กเก็ตพู่ หรือชุดเดรสโครเชต์ ตามที่ paraphrastic collapse ได้ระบุไว้
ประการที่สองคือ Autoregressive latency bottlenecks: LLM ถูกจำกัดด้วยการสร้างข้อมูลทีละลำดับ ทำให้การวางแผนคำถามย่อยที่ซับซ้อนต้องใช้ chain-of-thought (CoT) หลายร้อย tokens ซึ่งสร้างความหน่วง (latency) จนไม่สามารถตอบสนองในระดับเสี้ยววินาทีตามที่ระบบค้นหาใช้งานจริงต้องการได้
กรอบการทำงาน Retrieve-for-Train
Retrieve-for-Train เปลี่ยนวิธีการฝึกฝน AI ให้เหมือนการฝึกซ้อมแบบออฟไลน์ แทนที่จะให้ AI มานั่งคิดหาสูตรการค้นหาใหม่ทุกครั้งที่ผู้ใช้พิมพ์คำถาม ระบบจะรันโปรแกรมฝึกด้วย RL เพียงครั้งเดียวเพื่อสร้าง "คู่มือ" การค้นหาที่แม่นยำไว้ล่วงหน้า ทำให้เมื่อใช้งานจริง AI สามารถประมวลผลได้ทันที
กระบวนการทำงานหลักประกอบด้วย 3 ขั้นตอน ดังนี้:
- Fan-out language model training: ฝึกโมเดลภาษาให้ปล่อยคำถามย่อยที่สอดคล้องกับคุณสมบัติ โดยให้คะแนนรางวัลจากภาพรวมของกลุ่มผลลัพธ์ (set-level reward)
- Supervision synthesis: ใช้โมเดลที่ฝึกแล้วสังเคราะห์ข้อมูลสอนแบบ (query → target-set) โดยอัตโนมัติ ไม่ต้องพึ่งพาแรงงานคน
- Diffusive retriever training: ฝึกโมเดล diffusion ขนาดเพียง 53.9 ล้านพารามิเตอร์ ให้เรียนรู้การจับคู่คำถามเข้ากับชุดผลลัพธ์โดยตรงแบบ non-autoregressive ซึ่งช่วยข้ามขั้นตอนการคิดแบบ CoT ที่ยาวเหยียดไปได้
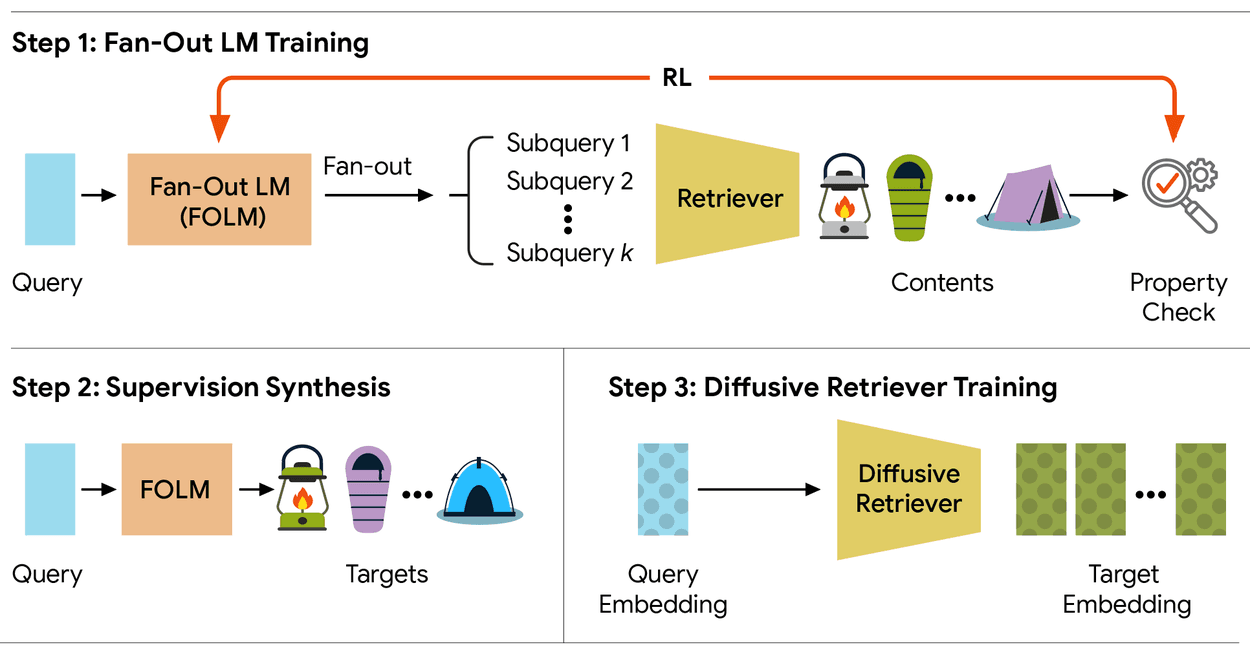
ภาพรวมของกรอบการทำงาน Retrieve-for-Train ขั้นตอนที่ 1: ฝึกโมเดลภาษาแบบ fan-out (FOLM) โดยใช้ RL เพื่อสร้างข้อคำถามย่อยที่สอดคล้องกับคุณสมบัติ ขั้นตอนที่ 2: ใช้ FOLM ที่ฝึกแล้วในการสังเคราะห์ข้อมูลสอน ขั้นตอนที่ 3: ฝึก fan-out retriever แบบ diffusion ที่สุ่มตัวอย่าง content embeddings โดยตรงจาก query embeddings
การออกแบบสำหรับชุดข้อมูล: พลังของรางวัลแบบผสม (Composite Rewards)
ความสำเร็จของระบบนี้อยู่ที่การกำหนดนิยามการค้นหาที่ "ดี" แทนที่จะวัดความเกี่ยวข้องทีละรายการแบบ pointwise relevance via learning to rank แต่ Retrieve-for-Train จะประเมินทั้งคอลเลกชัน โดยการปรับแต่งโมเดลโอเพนซอร์สอย่าง Gemma3-4B และ Qwen3-4B ผ่านรางวัลแบบผสม 3 ด้าน คือ ความสมจริงตามฐานข้อมูล (Groundedness), ความหลากหลายทางความหมาย (Diversity โดยใช้ Vendi Score), และความตรงประเด็นกับคำถามตั้งต้น (Alignment)
Mutual counter-anchors และการฝึกแบบ soft-GRPO
ในการฝึกเราใช้เทคนิค group relative policy optimization (GRPO) ร่วมกับ soft proximal policy optimization (PPO) เพื่อสร้างจุดสมดุล หากเน้นแค่ความสมจริง โมเดลอาจโกงรางวัลด้วยการสร้างข้อความไร้สาระที่ตรงกับพิกัดในฐานข้อมูล การมี Vendi Score เป็นตัวถ่วงดุลจึงบังคับให้โมเดลต้องหาความแปรผันที่ถูกต้องและมีสาระเท่านั้น
การทดลองและผลลัพธ์
ผู้วิจัยได้ทดสอบในสองโดเมนหลัก คือ ชุดข้อมูลแฟชั่นขนาดใหญ่ (ประเมินด้วย CLIP) และชุดข้อมูลเพลงระดับอุตสาหกรรม (ประเมินด้วย MuLan) โดยใช้โมเดล Gemma3-4B และ Qwen3-4B เป็นแกนหลักในการแตกคำถามย่อยผ่านวิธี Soft-GRPO
ผลการทดสอบพบว่า Retrieve-for-Train ให้ประสิทธิภาพเหนือกว่าทั้งการค้นหาแบบเดิมและการขยายความแบบ zero-shot ที่สำคัญคือการใช้โมเดล Diffusion ขนาด 53.9 ล้านพารามิเตอร์ ช่วยทำลายกำแพงความหน่วง โดยสามารถประมวลผลได้เร็วขึ้นถึง 12 ถึง 20 เท่า เมื่อเทียบกับวิธีดั้งเดิมที่ต้องรอ AI คิดทีละขั้นตอน
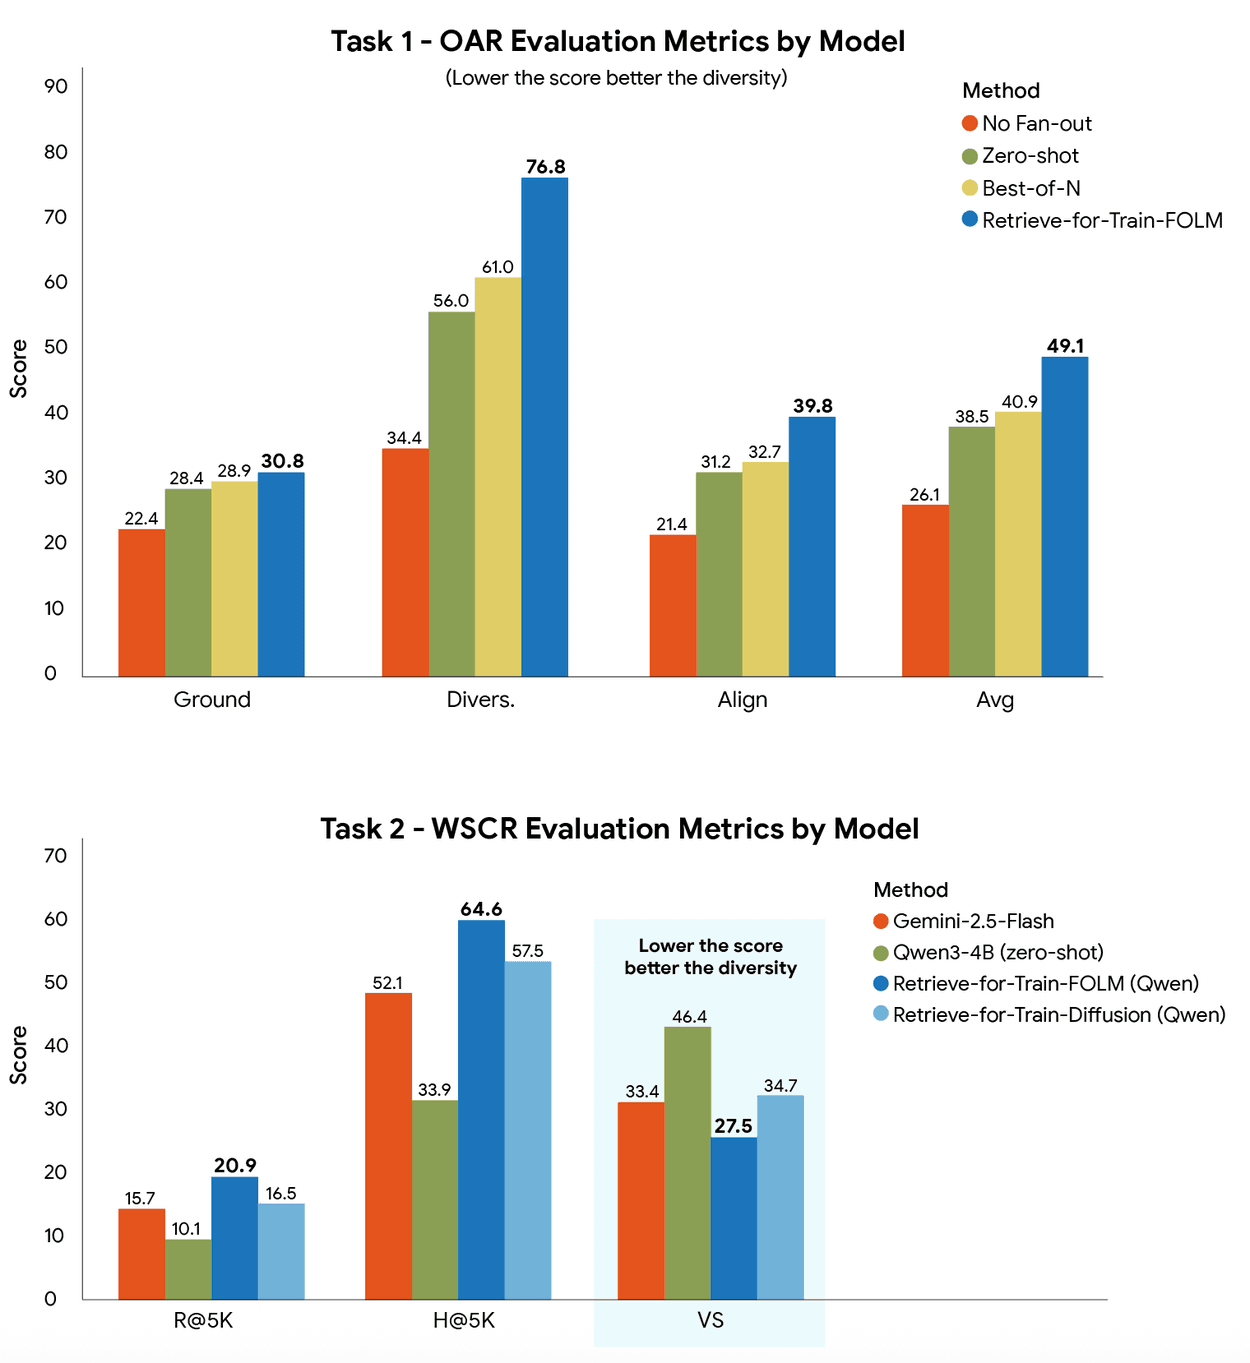
กรอบการทำงาน Retrieve-for-Train (FOLM และ Diffusion) มีประสิทธิภาพเหนือกว่าการค้นหามาตรฐานและ zero-shot baselines อย่างสม่ำเสมอในทั้งงาน Open-Ended Abstract Retrieval (OAR) และ Weakly Supervised Compositional Retrieval (WSCR) โดยมอบการเพิ่มขึ้นอย่างมีนัยสำคัญในด้านความหลากหลาย ความสอดคล้อง และการระลึกได้ (recall)
สรุป
งานวิจัยนี้พิสูจน์ว่า RL สามารถทำหน้าที่เป็น "ตัวแปลงเป้าหมาย" แบบออฟไลน์ที่มีประสิทธิภาพสูง ช่วยให้ระบบดึงข้อมูลสามารถรักษาคุณสมบัติระดับสูงอย่างความหลากหลายและความสอดคล้องไว้ได้ โดยไม่ต้องแบกรับต้นทุนการคำนวณมหาศาลในช่วงใช้งานจริง ซึ่งเป็นประโยชน์อย่างมากในโดเมนเฉพาะทางที่ข้อมูลสอนจากมนุษย์มีราคาแพง ผู้ที่สนใจสามารถศึกษาเพิ่มเติมได้ใน paper
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร