
Google เปิดตัว Gemini 3.8 Live ชูจุดเด่น Voice Agent สนทนาสดพร้อมใช้เหตุผล
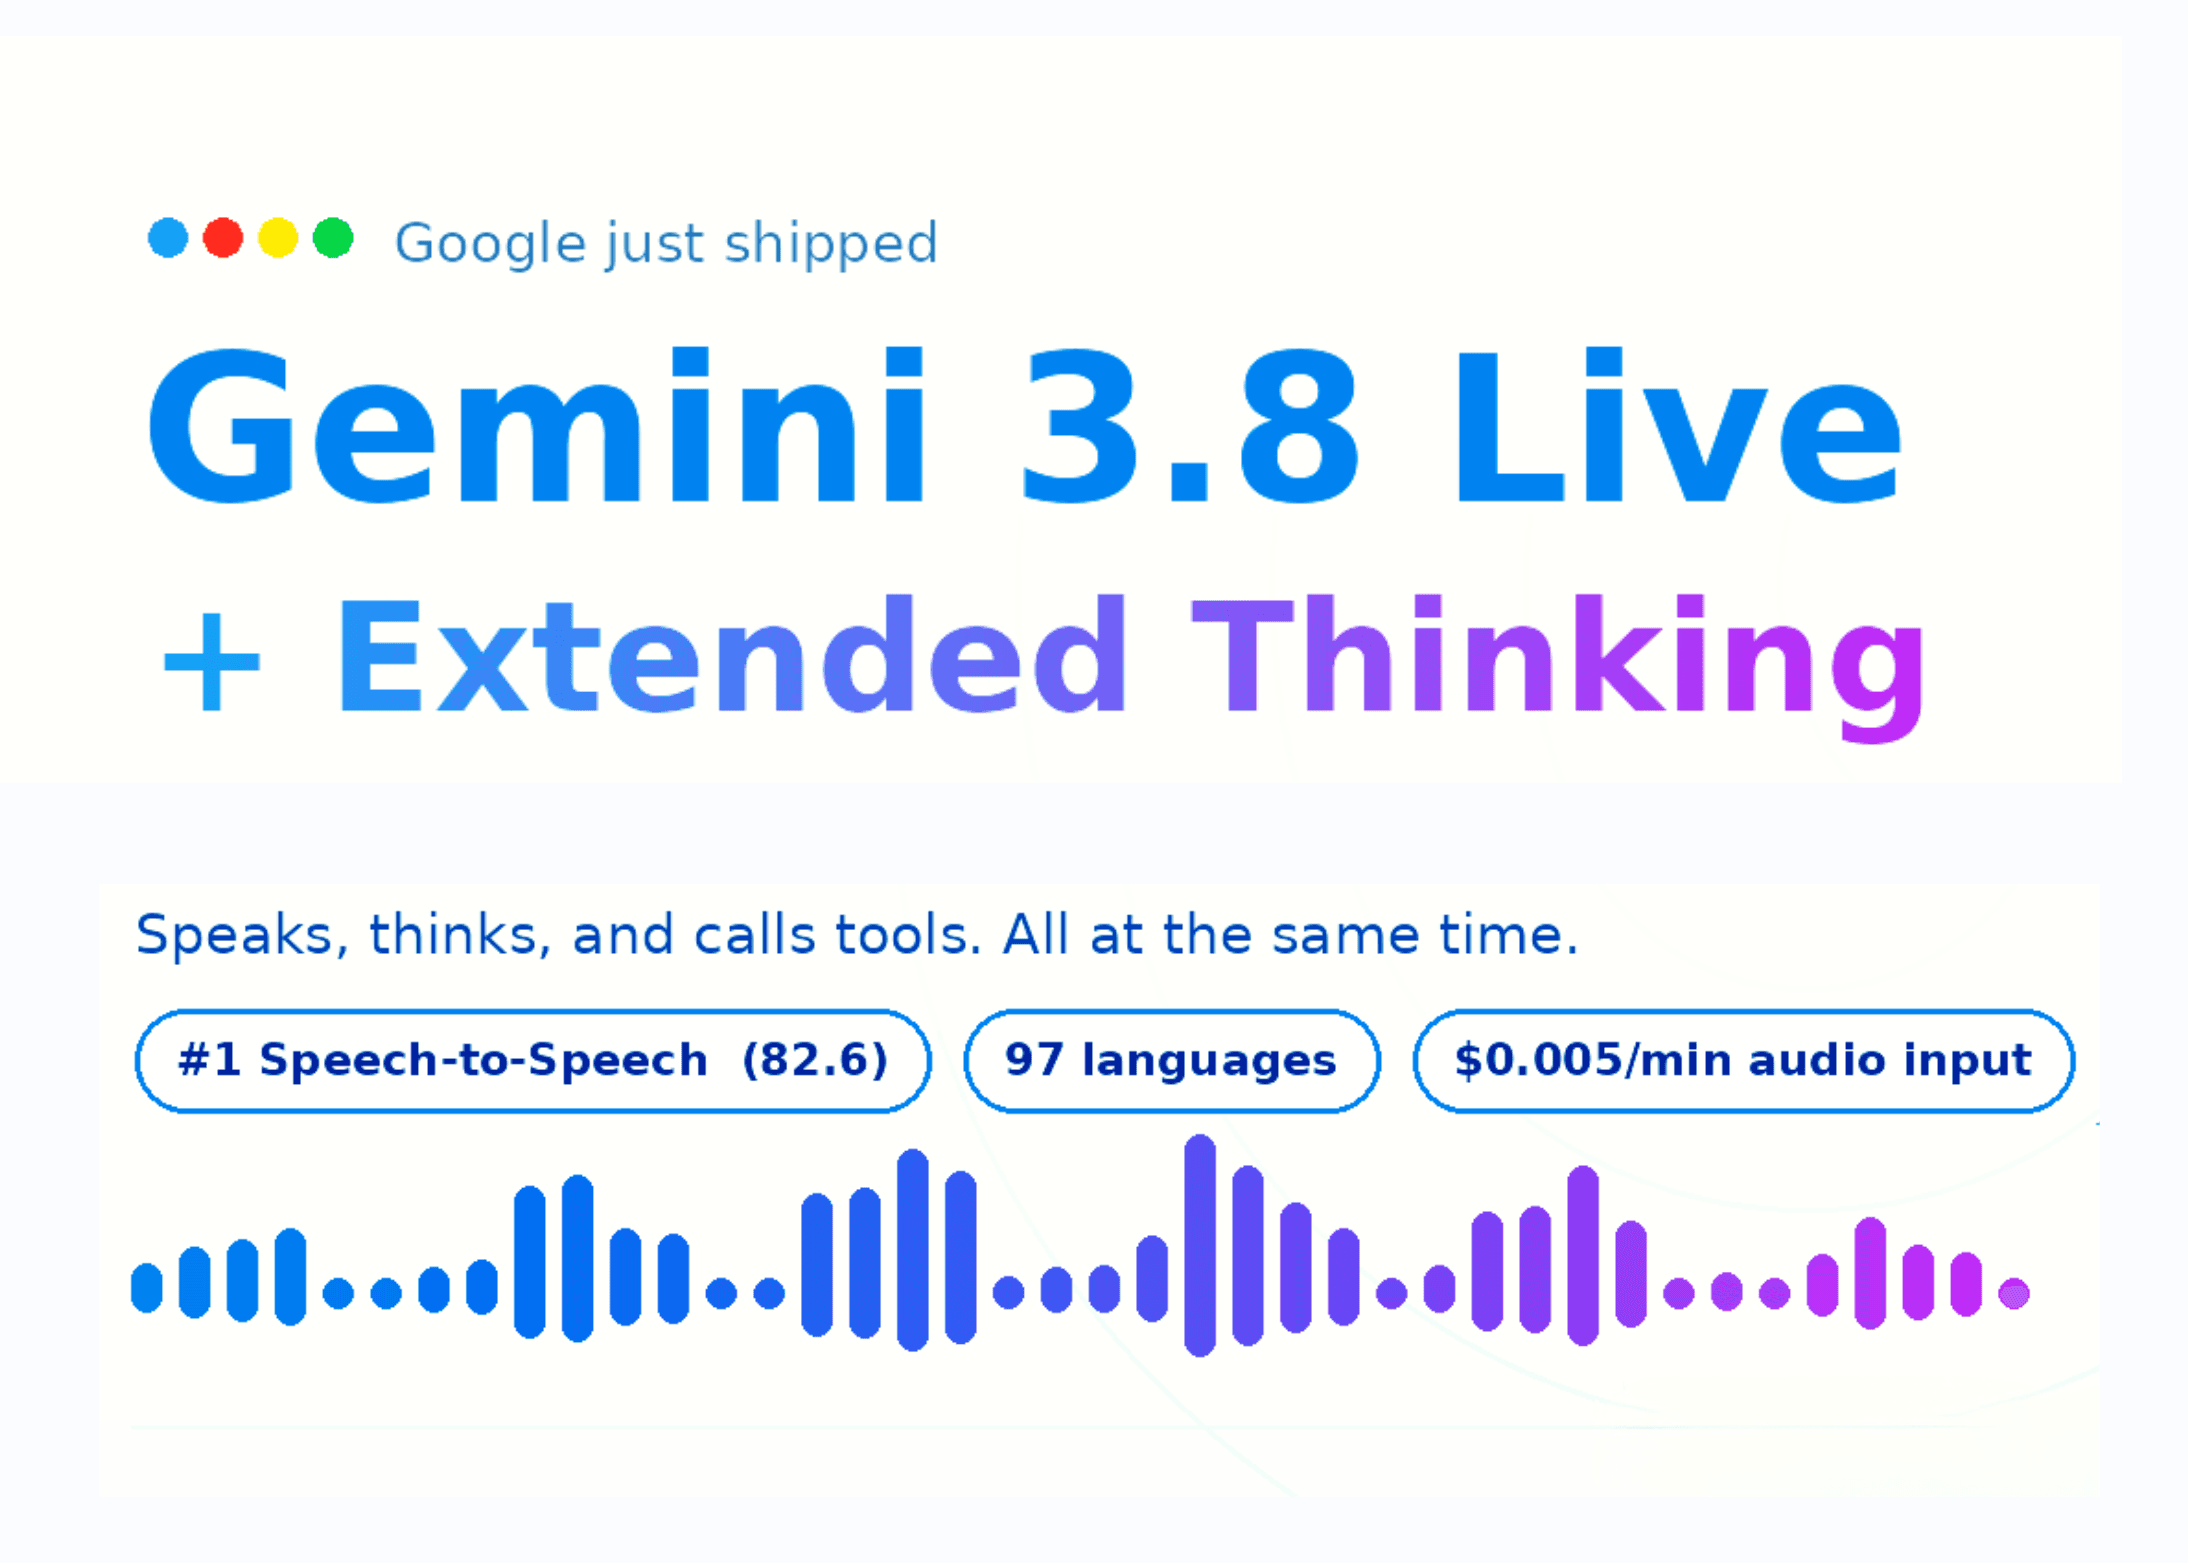
Google ได้ แนะนำ Gemini 3.8 Live และ Gemini 3.8 Live Extended Thinking ซึ่งเป็นโมเดลบทสนทนาแบบสดที่ล้ำสมัยที่สุดเท่าที่เคยมีมา ทั้งคู่เป็นโมเดลแบบ native speech to speech ที่สร้างขึ้นเพื่อเป็น Voice Agents แบบเรียลไทม์ โดยเป็นการต่อยอดตระกูล Gemini Audio ที่ Google ได้ ขยาย ศักยภาพเมื่อเดือนก่อนด้วย Gemini 3.5 Transcribe การเปิดตัวครั้งนี้มุ่งเน้นการสร้างเอเจนต์เสียงที่สามารถใช้เหตุผลและรันเครื่องมือต่างๆ ได้โดยไม่ขัดจังหวะการสนทนา
สำหรับการใช้งานระดับโปรดักชัน โมเดลทั้งสองพร้อมใช้งานแล้วตั้งแต่วันนี้ผ่าน Gemini Live API และ Google AI Studio โดยมาในรูปแบบโมเดล hosted ซึ่งนักพัฒนาสามารถเรียกใช้งานผ่านระบบของ Google ได้ทันที แต่จะไม่มีตัวเลือกสำหรับการติดตั้งบนเซิร์ฟเวอร์ส่วนตัว (self-hosted)
สิ่งที่ Google เปิดตัว
การเปิดตัวครั้งนี้ประกอบด้วย 2 โมเดลที่ตอบโจทย์การใช้งานต่างกัน Gemini 3.8 Live เน้นความคุ้มค่าและรองรับการขยายตัว โดยผสานความฉลาดในการสนทนาเข้ากับการรับรู้ทางภาพ (Visual grounding) ส่วน Gemini 3.8 Live Extended Thinking ออกแบบมาเพื่องานซับซ้อนโดยเฉพาะ โดยเพิ่มความสามารถในการใช้เหตุผลหลายขั้นตอน (Multi-step reasoning) ในขณะที่กำลังพูด Google วางตำแหน่งทั้งสองรุ่นเป็นทางเลือกที่คล่องตัวกว่าระบบเสียงแบบเดิมที่ต้องนำ ASR, LLM และ TTS มาต่อกันเป็นทอดๆ
ผลการทดสอบ Benchmark
ในด้านประสิทธิภาพ Gemini 3.8 Live Extended Thinking ครองอันดับ 1 ใน Speech to Speech Quality Index ของ Artificial Analysis’ ด้วยคะแนน 82.6 นอกจากนี้ยังทำผลงานได้โดดเด่นในภารกิจแบบ agentic ด้วยคะแนน 68.6% ใน τ-Voice และ 35.1% ใน τ-Voice-banking ของ Sierra รวมถึงคว้าคะแนนสูงถึง 97.7% ใน Big Bench Audio ซึ่งเป็นมาตรฐานการวัดผลด้านการใช้เหตุผลผ่านเสียง
ทางด้าน Gemini 3.8 Live รุ่นมาตรฐานได้รับอันดับสองใน Speech Agent Arena ซึ่งเป็นการประเมินความพึงพอใจโดยมนุษย์ ส่วนในผลการทดสอบ EVA-Bench ของ ServiceNow พบว่าโมเดลเหล่านี้สามารถสร้างสมดุลระหว่างความแม่นยำในการทำงานและคุณภาพการสนทนาได้เป็นอย่างดี ช่วยยกระดับมาตรฐานสำหรับเวิร์กโฟลว์ที่ซับซ้อนผ่าน Live API บนแพลตฟอร์ม Gemini Enterprise Agent
ความสามารถสำหรับนักพัฒนา
Live API ได้เผยความสามารถหลัก 5 ประการในโมเดลซีรีส์ใหม่นี้ ได้แก่:
- Asynchronous function calling: รันการเรียก API และเครื่องมือต่างๆ ในเบื้องหลังได้โดยที่การสตรีมเสียงตอบกลับยังดำเนินต่อไปอย่างต่อเนื่อง
- Visual context: ประมวลผลภาพสดได้เกือบเรียลไทม์ ช่วยให้เอเจนต์เข้าใจสิ่งที่ผู้ใช้กำลังพูดและมองเห็นพร้อมกัน
- Alphanumeric precision: แยกแยะข้อมูลทางเทคนิค เช่น รหัสยืนยัน หรือหมายเลขการเคลมได้อย่างแม่นยำ ลดจุดอ่อนที่มักพบในระบบเสียงทั่วไป
- Multilingual support: ตรวจจับและสลับระหว่าง 97 ภาษาที่รองรับได้อัตโนมัติกลางบทสนทนาโดยไม่เสียความต่อเนื่อง
- Incremental content updates: ผสานรวมข้อมูลเสียงเรียลไทม์เข้ากับข้อมูลโครงสร้างเพื่อการตอบสนองที่ตรงบริบทที่สุด
สำหรับรุ่น Extended Thinking ยังเพิ่มฟีเจอร์ configurable thinking เพื่อใช้เหตุผลหลายขั้นตอนในเบื้องหลัง โดยโมเดลสามารถคิดและพูดไปพร้อมกันได้ พร้อมแสดงความคืบหน้าของงานให้ผู้ใช้ทราบเป็นระยะ ตัวอย่างเช่น การแปลงภาพร่างร่วมกับคำสั่งเสียงให้เป็น React components ที่ใช้งานได้จริง หรือการประสานงานจองบริการหลายขั้นตอนอย่างเป็นระบบ
ราคาและระบบนิเวศ
โมเดลทั้งสองรุ่นมี ราคา เริ่มต้นที่ $0.005 ต่อนาทีสำหรับ input เสียง และ $0.018 ต่อนาทีสำหรับ output เสียง โดยนักพัฒนาสามารถเลือกใช้งานผ่านพาร์ทเนอร์รายใหญ่ เช่น Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel และ Vision Agents
นอกจากนี้ Google ยังร่วมมือกับองค์กรชั้นนำอย่าง Salesforce, Genspark และ Lumeris เพื่อยืนยันถึงความหน่วงต่ำและความลื่นไหลของระบบ โดยเสียงที่สร้างขึ้นทั้งหมดจะมีการฝังลายน้ำ SynthID จาก Google DeepMind ที่มองไม่เห็นเพื่อความปลอดภัย สำหรับผู้ที่สนใจสามารถดูตัวอย่างแอปพลิเคชันได้บน GitHub
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร