
เทคนิคการฝึก AI เขียนโค้ดวาดภาพสีน้ำด้วย TRL และ OpenEnv ผ่านกระบวนการ RL
เมื่อวันที่ 23 สิงหาคม Surya Narreddi ได้เผยแพร่วิดีโอภาพวาดสีน้ำสุดตระการตาที่สร้างสรรค์โดยโมเดลภาษาผ่านการเขียน JavaScript ด้วย p5.brush ซึ่งเป็นไลบรารีที่ช่วยเพิ่มเครื่องมือวาดภาพแบบธรรมชาติให้กับ p5.js วิดีโอนี้กลายเป็นไวรัลอย่างรวดเร็วโดยมียอดชมทะลุ 1.5 ล้านครั้ง
โปรเจกต์นี้มี บล็อกโพสต์ อธิบายเบื้องหลังการฝึกฝนโมเดลในระยะแรกที่เน้นภาพดอกไม้แบบใกล้ชิด แม้ว่าปัจจุบันจะยังไม่มีผลงานแบบเปิดเผย (open artifacts) ออกมาให้ใช้งาน แต่ผู้เขียนบทความนี้ได้พยายามจำลองไอเดียดังกล่าวด้วยการสร้างระบบวิศวกรรมในรูปแบบเปิดที่เผยแพร่ทุกชิ้นส่วน
หมายเหตุ: สำหรับบริบทเบื้องหลังโปรเจกต์ที่เล่าโดย Surya เอง สามารถรับชมได้จาก วิดีโอวิทยานิพนธ์ของเขา
ในบทความนี้ ผมได้จำลองไอเดียของเขาโดยใช้ TRL และ OpenEnv ซึ่งชิ้นส่วนทั้งหมดไม่ว่าจะเป็นชุดข้อมูลอ้างอิง (reference pool dataset), สภาพแวดล้อม RL (RL environment), สคริปต์การฝึก และโมเดลที่ฝึกสำเร็จแล้ว ล้วนถูกเผยแพร่เป็นแบบเปิดทั้งหมด
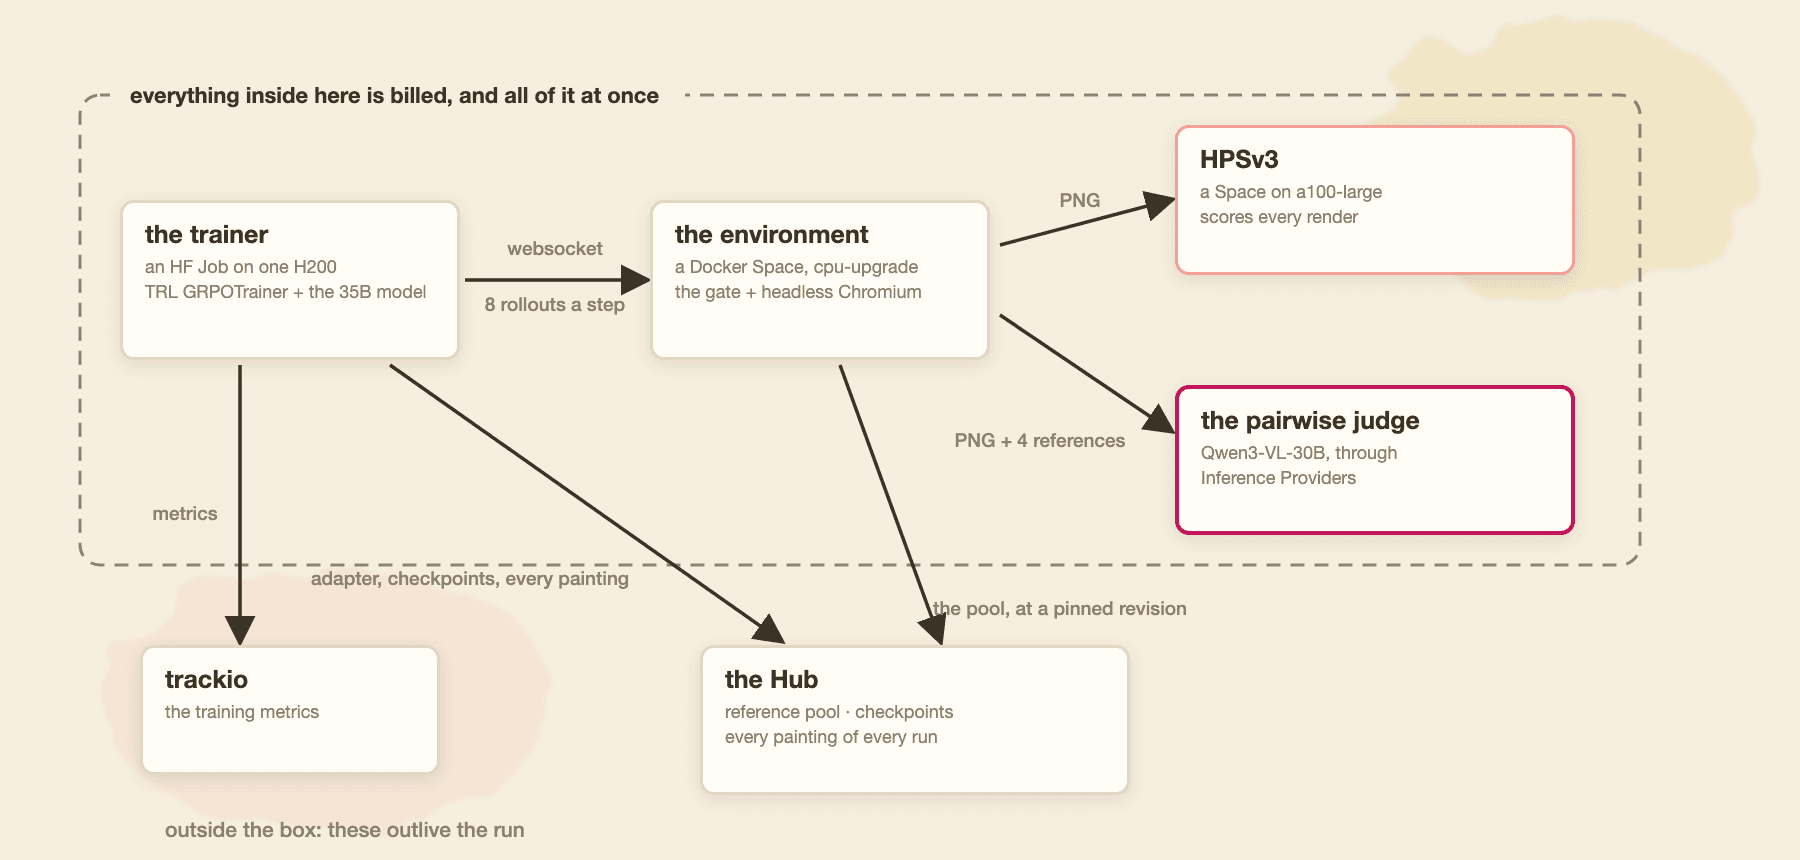
กระบวนการทำงาน (pipeline) ทั้งหมดรันบนระบบของ Hugging Face แบบครบวงจร ได้แก่:
- การฝึกบน Jobs
- สภาพแวดล้อม RL และโมเดลให้คะแนน (scorer model) ในรูปแบบ Spaces
- ผู้ตัดสินแบบจับคู่ (pairwise judge) ผ่าน Inference Providers
- ชิ้นส่วนทั้งหมดบน Hub ถูกรวบรวมไว้ใน คอลเลกชันเดียว
เมื่อ Spaces เปิดใช้งานแล้ว การเริ่มต้นฝึกโมเดลสามารถทำได้เพียงใช้คำสั่งเดียว โดยการคัดลอก (Duplicate) สภาพแวดล้อม และ โมเดลให้คะแนน พร้อมตั้งค่าตัวแปรสภาพแวดล้อมเพื่อเริ่มรัน:
hf jobs uv run train/watercolour_grpo.py --flavor h200 --timeout 48h --secrets HF_TOKEN -- \
  --env-url https://<you>-watercolour-env.hf.space \
  --model Qwen/Qwen3.5-35B-A3B --lora --all-linear --bf16 --gradient-checkpointing \
  --subject 'a peach hibiscus' --references 4 \
  --top-p 0.95 --top-k 20 \
  --lr 5e-5 --lr-scheduler constant_with_warmup --warmup-steps 5 \
  --scale-rewards none \
  --steps 110 --n-episodes 240 --num-generations 8 \
  --per-device-batch-size 1 --gradient-accumulation-steps 8 \
  --max-completion-length 8192 \
  --run-tag my-run --out <you>/watercolour-grpo --push-to-hub
รายละเอียดการดำเนินงานและชิ้นส่วนโค้ดทั้งหมดสามารถดูได้ที่ คลังเก็บโค้ด (repo) โดยผมได้ดำเนินงานตามบล็อกต้นฉบับและปรับปรุงบางจุดที่จำเป็น เช่น การนำเสนอชุดข้อมูลที่ให้คะแนนโดยคน และการเปรียบเทียบการฝึกแบบผสมรางวัลสามรูปแบบ
ทำไมผู้คนถึงชอบมัน
ภาพวาดเหล่านี้มีเสน่ห์ที่ความไม่สมบูรณ์แบบและให้ความรู้สึกเหมือนงานทำมือ ซึ่งแตกต่างจากโมเดลสร้างภาพทั่วไปที่มักเน้นความสมบูรณ์แบบตามค่าเฉลี่ยทางสถิติ สิ่งนี้ชวนให้นึกถึงยุคแรกของ Generative AI เช่น DeepDream ในปี 2015 หรือผลงาน Edmond de Belamy ที่เป็นการทดสอบขีดจำกัดของสื่อกลางทางศิลปะ
โมเดลจะเขียนโปรแกรม JavaScript ประมาณ 150 บรรทัดเพื่อสร้างภาพ ทำให้เราสามารถอ่าน แก้ไข และทำซ้ำโค้ดเพื่อดูการตัดสินใจเบื้องหลังแต่ละฝีแปรงได้ โดยสไตล์สีน้ำอันเป็นเอกลักษณ์เกิดจากการจำกัดให้โมเดลใช้เมธอดของไลบรารีเพียง 10 ตัวเท่านั้น
งานนี้มีความคล้ายคลึงกับโปรเจกต์ Myriad Tulips ของ Anna Ridler ที่มีการคัดเลือกและให้ป้ายกำกับชุดข้อมูลด้วยมืออย่างละเอียดเพื่อฝึกโมเดล ซึ่งเป็นการนำรสนิยมของมนุษย์เข้ามาเป็นส่วนหนึ่งของกระบวนการสร้างสรรค์
RL เหนือรสนิยม
โปรเจกต์นี้เป็นการพิสูจน์ว่า Reinforcement Learning (RL) สามารถนำมาใช้กับ "รสนิยม" หรือความพึงพอใจทางสุนทรียะได้หรือไม่ โดยรางวัล (rewards) ในระบบประกอบด้วย 4 ส่วนหลักดังนี้:
| หัวข้อ | น้ำหนัก | สิ่งที่วัด |
|---|---|---|
gate | 0.05 | โค้ดคอมไพล์ได้, มีภาพปรากฏ และไม่มีการโกง |
length | 0.05 | กระตุ้นให้โค้ดมีความยาวที่เหมาะสม |
| pairwise judge | 0.60 | การเปรียบเทียบสไตล์กับภาพอ้างอิงในชุดข้อมูล |
| HPSv3 | 0.30 | ความสวยงามของภาพตามค่าเฉลี่ยความชอบของมนุษย์ |
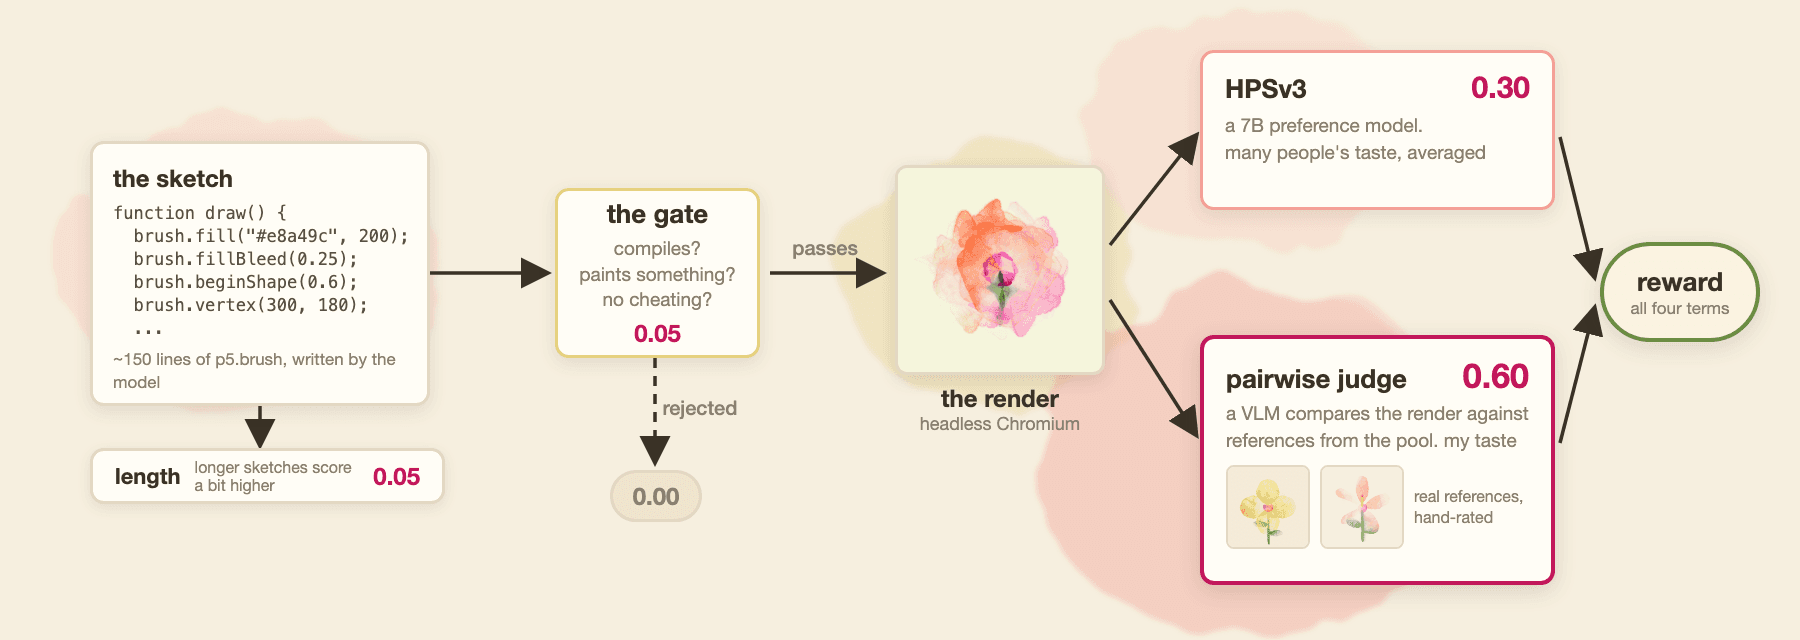
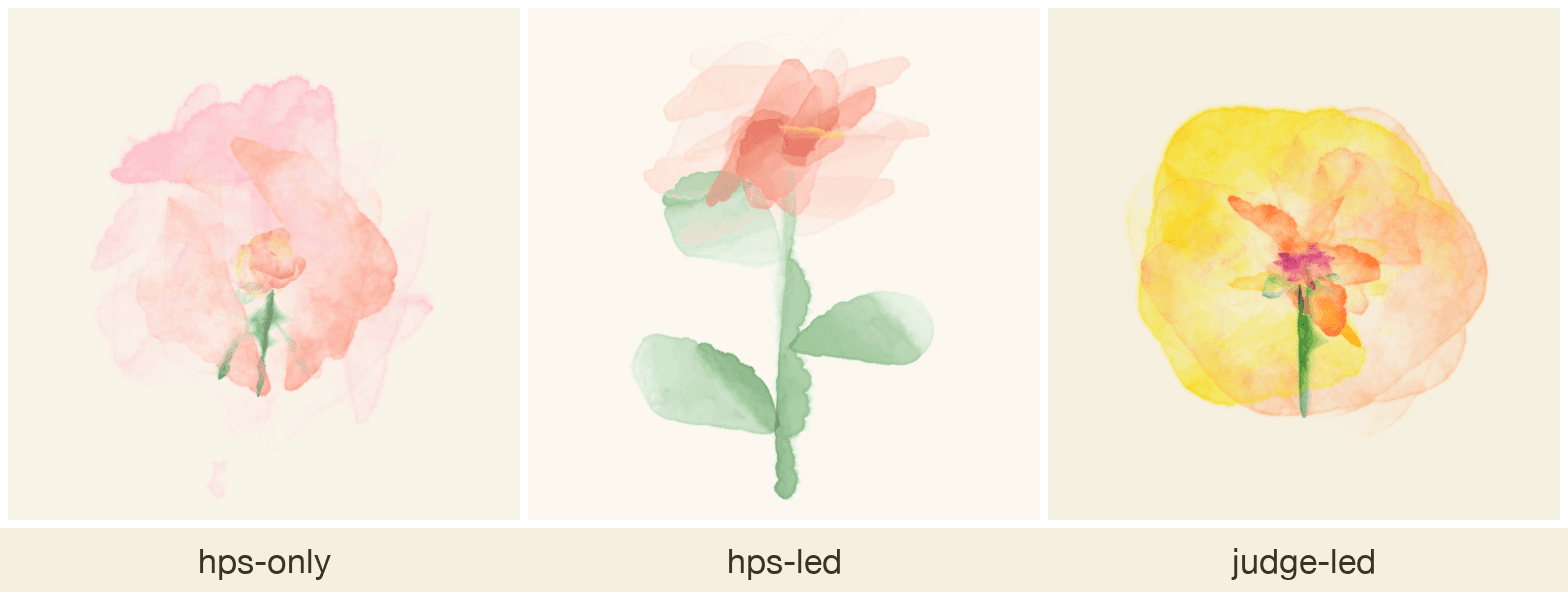
เราได้ทำการทดลองรัน 3 รอบ โดยปรับเปลี่ยนน้ำหนักระหว่างโมเดลตัดสินแบบจับคู่ (Pairwise Judge) และ HPSv3 เพื่อดูผลลัพธ์ที่แตกต่างกัน ตั้งแต่รอบที่เน้นรสนิยมส่วนตัว (Judge-led) ไปจนถึงรอบที่เน้นความชอบทั่วไปตามมาตรฐานโมเดล (HPS-only) ซึ่งผลการทดสอบพบว่าทุกรูปแบบสามารถเรียนรู้และพัฒนาคุณภาพงานวาดให้ดีขึ้นได้ตามเกณฑ์ที่กำหนดไว้
สภาพแวดล้อม RL ที่คุณต้องสร้าง
สภาพแวดล้อม RL ทำหน้าที่เป็นตัวกลางระหว่างโมเดลและรางวัล โดยครอบคลุมตั้งแต่ไลบรารี JavaScript, System Prompt ไปจนถึงระบบ headless Chromium ที่ใช้เรนเดอร์ภาพ ซึ่งหัวใจสำคัญคือไลบรารี p5.brush ที่จำลองการซึมของเม็ดสีและพื้นผิวกระดาษได้อย่างสมจริง
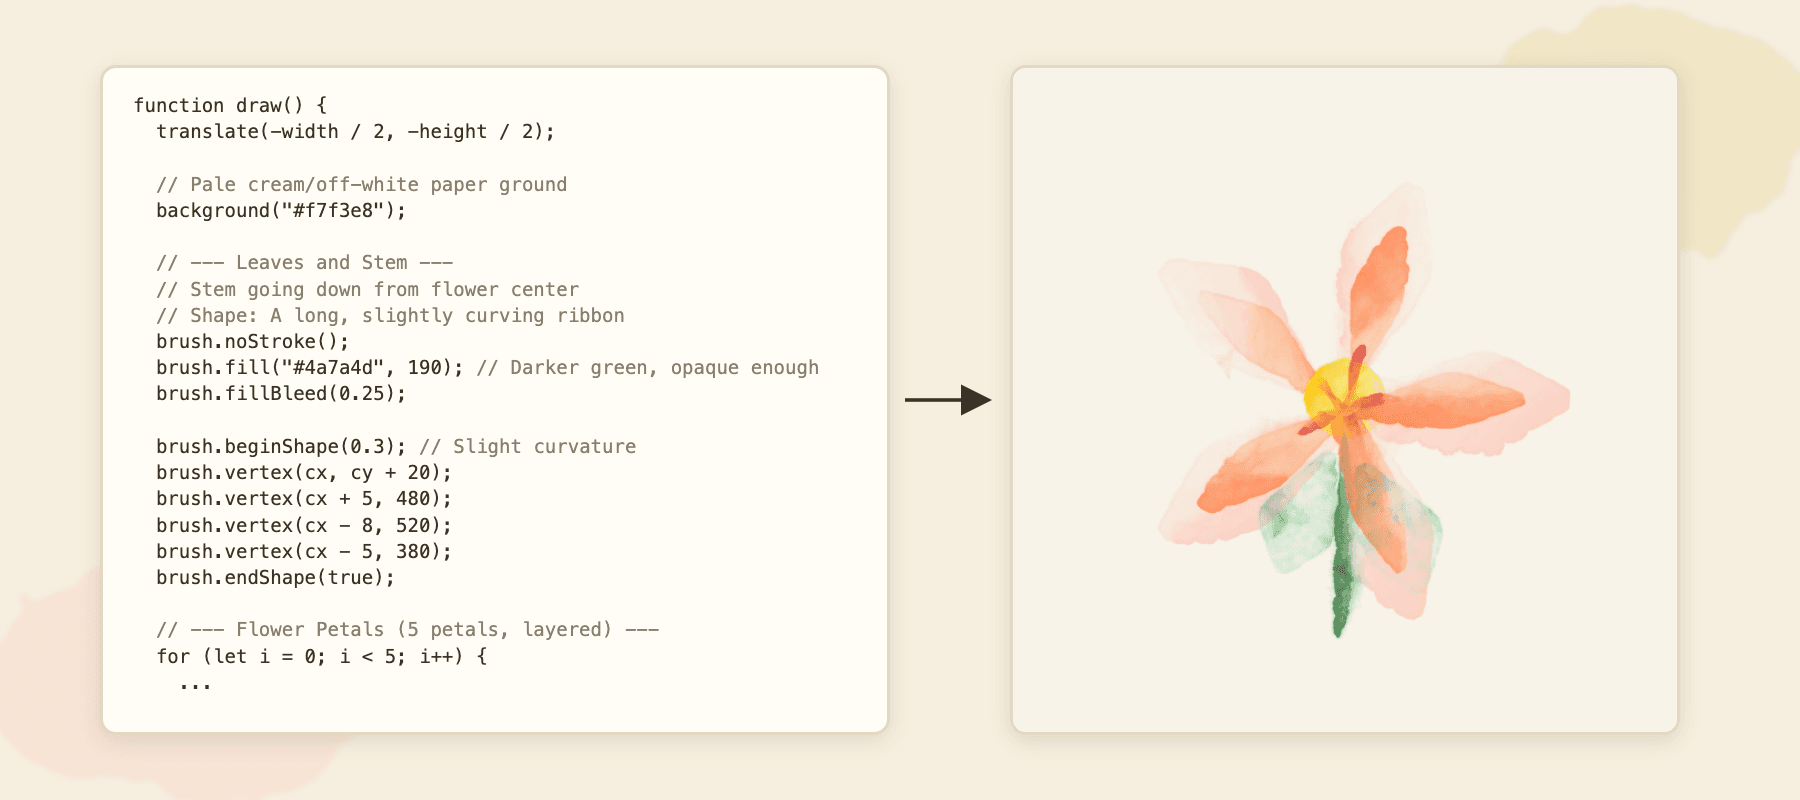
เราจำกัดให้โมเดลใช้เพียง 10 เมธอดหลัก เช่น fillBleed และ scaleBrushes เพื่อคงความเป็นเอกลักษณ์ของภาพสีน้ำ และใช้ด่านกั้น (gate) เพื่อตรวจสอบว่าภาพร่างต้องคอมไพล์ได้จริงและมีการใช้เม็ดสีลงบนผ้าใบโดยไม่พยายามหลอกล่อตัวให้คะแนน
ชุดข้อมูลอ้างอิงคือฟังก์ชันรางวัล
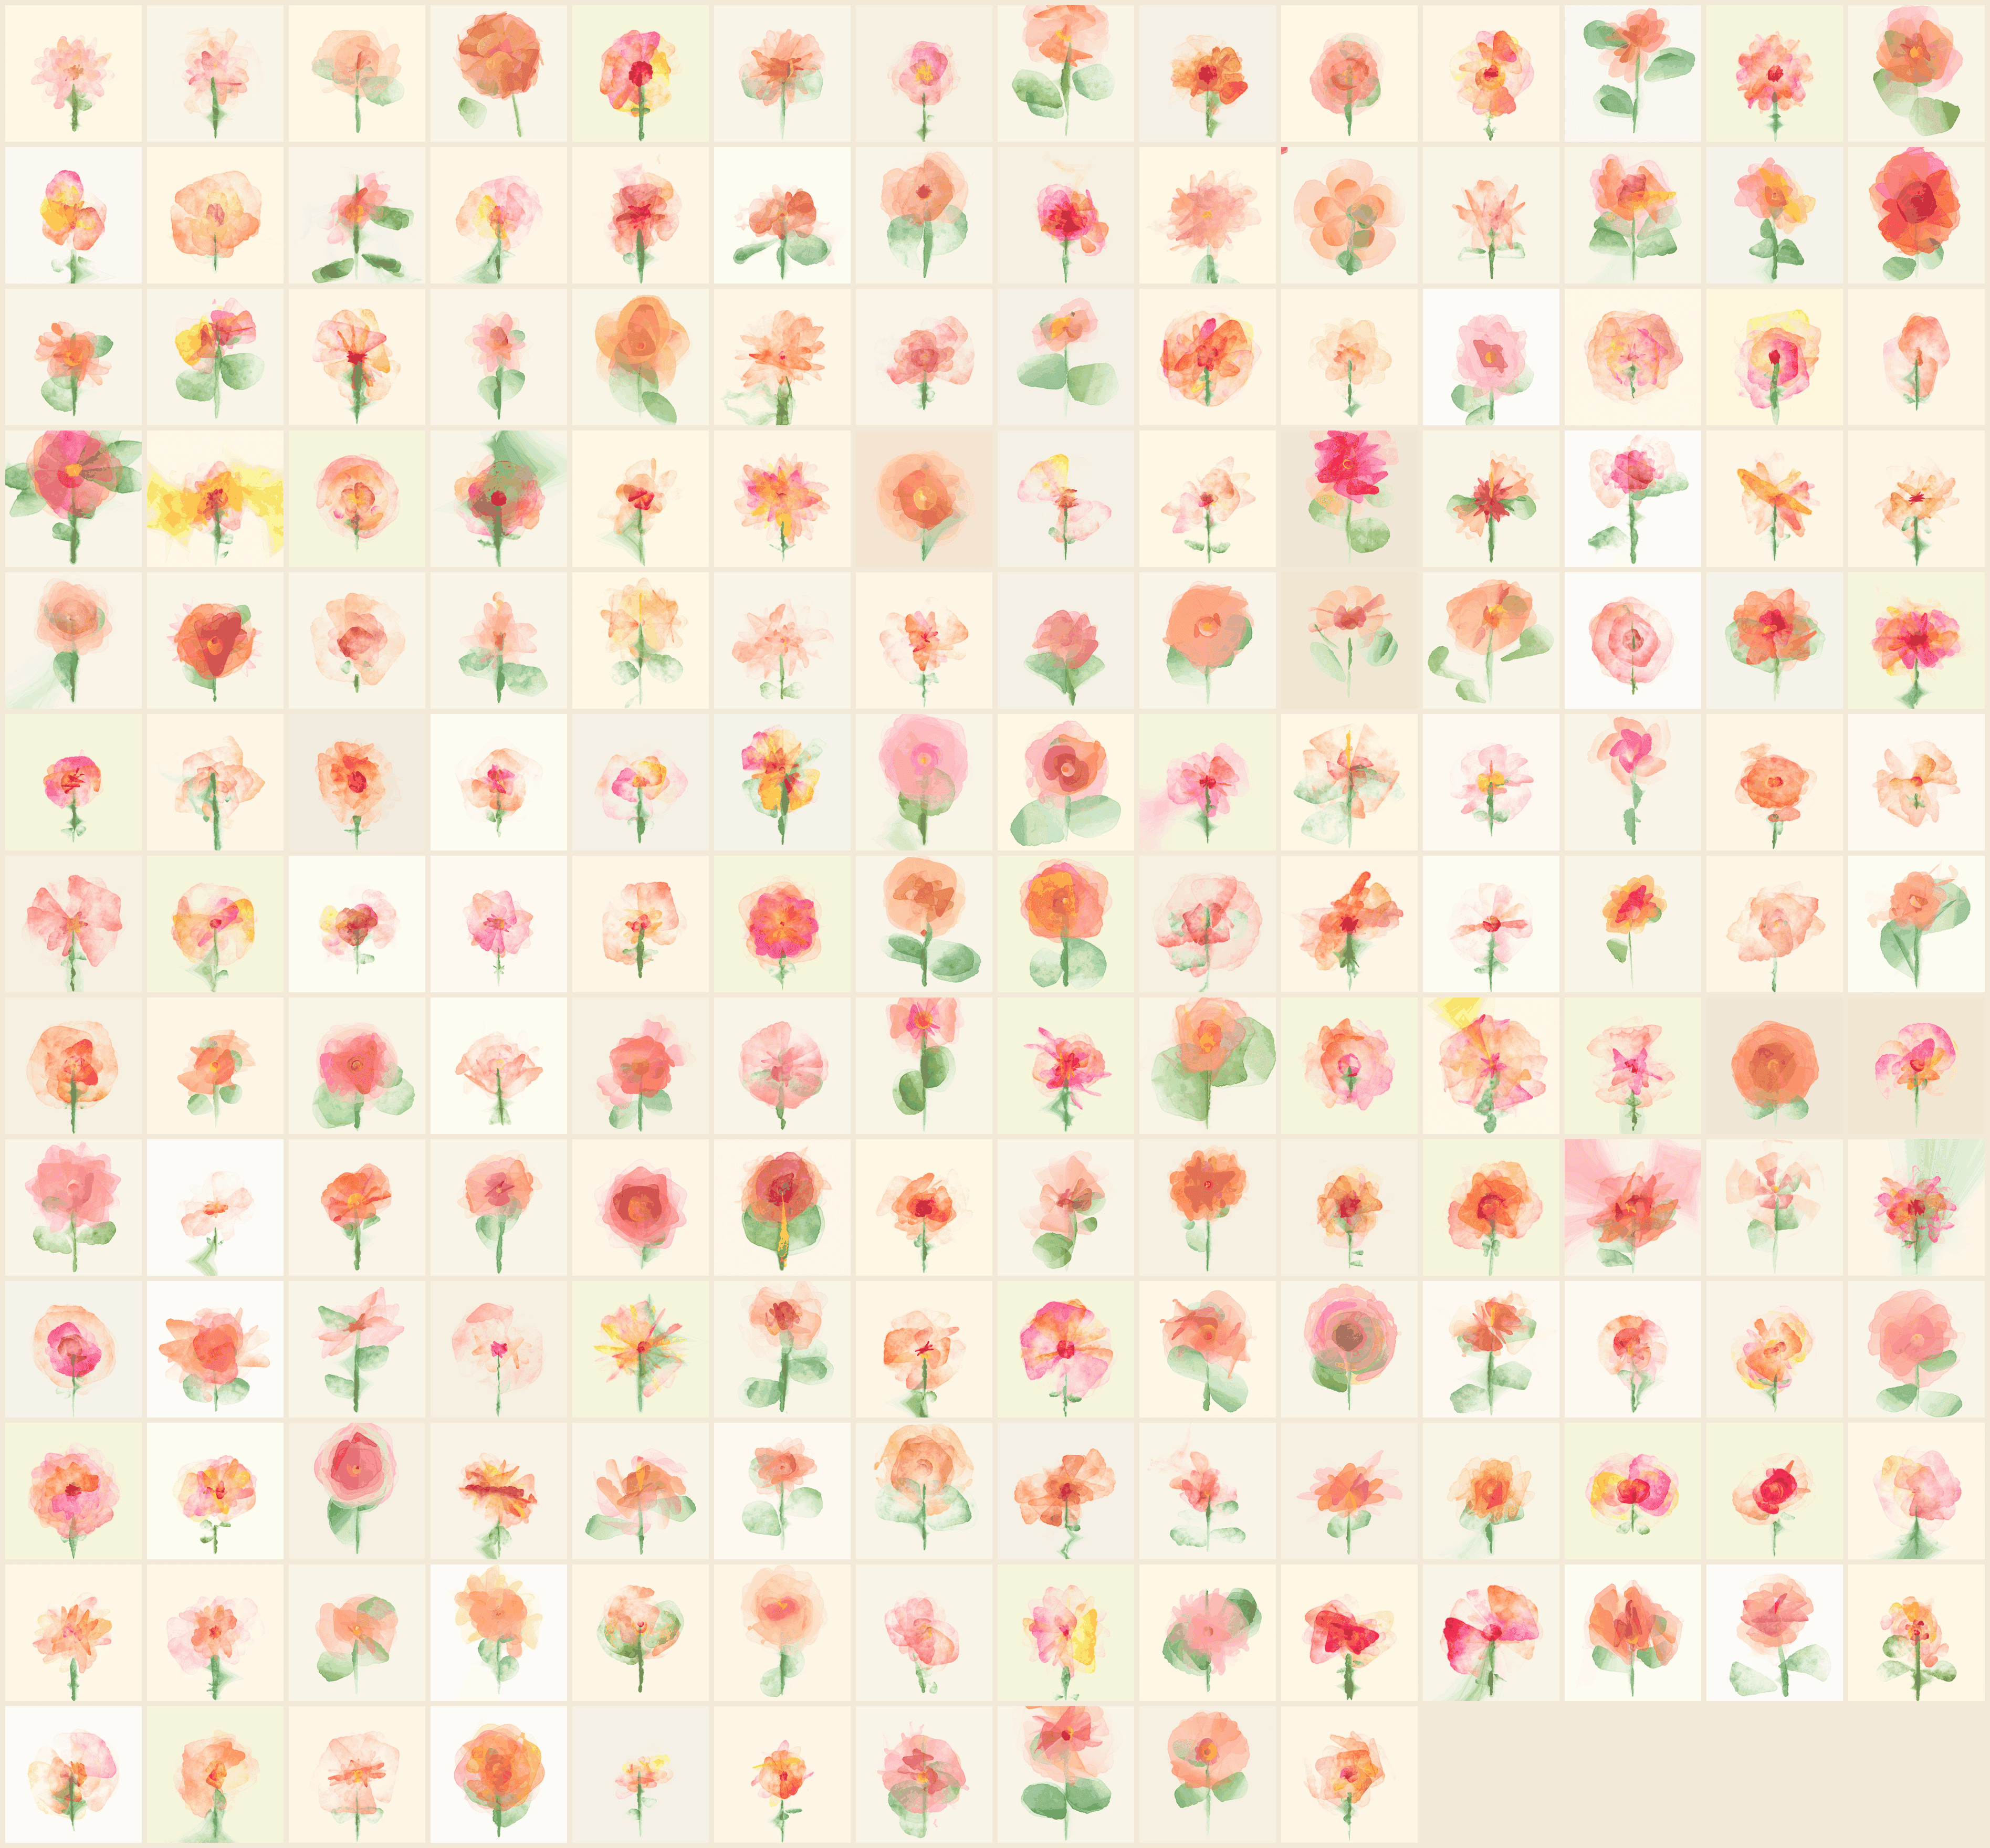
ชุดข้อมูลอ้างอิงประกอบด้วย ภาพวาด 178 ภาพ ที่ผมคัดเลือกและให้คะแนนด้วยตัวเอง แบ่งเป็นระดับ love และ okay โดยภาพเหล่านี้สร้างขึ้นจากโมเดลภาษา 4 ตระกูล ได้แก่ GLM-5.2, Kimi-K3, Qwen3-Coder-Next และ Qwen3.5-122B เพื่อให้ได้สไตล์ที่หลากหลาย
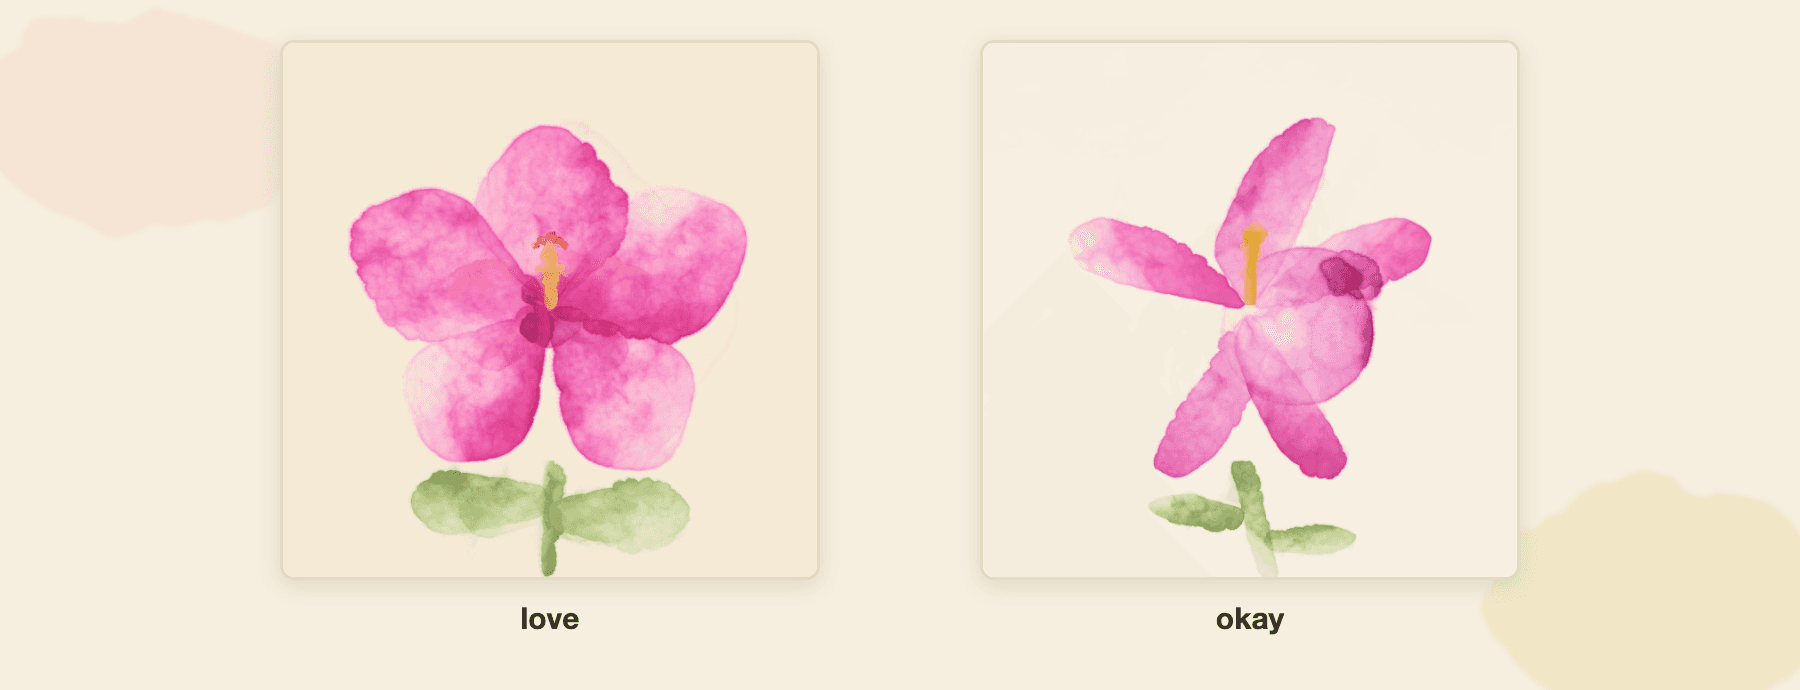
การใช้ข้อมูลอ้างอิงที่มนุษย์คัดสรรมาเป็นตัวกำหนดรางวัล ทำให้นโยบายของ AI พัฒนาไปตามรสนิยมที่ต้องการ โดย HPSv3 จะดูว่าภาพนั้นเป็นดอกไม้ที่สวยงามหรือไม่ ในขณะที่ Pairwise Judge จะดูว่ามันถูกวาดออกมาได้ตรงตามสไตล์ที่เลือกไว้หรือไม่
บทสรุปและสิ่งที่จะทำต่อไป
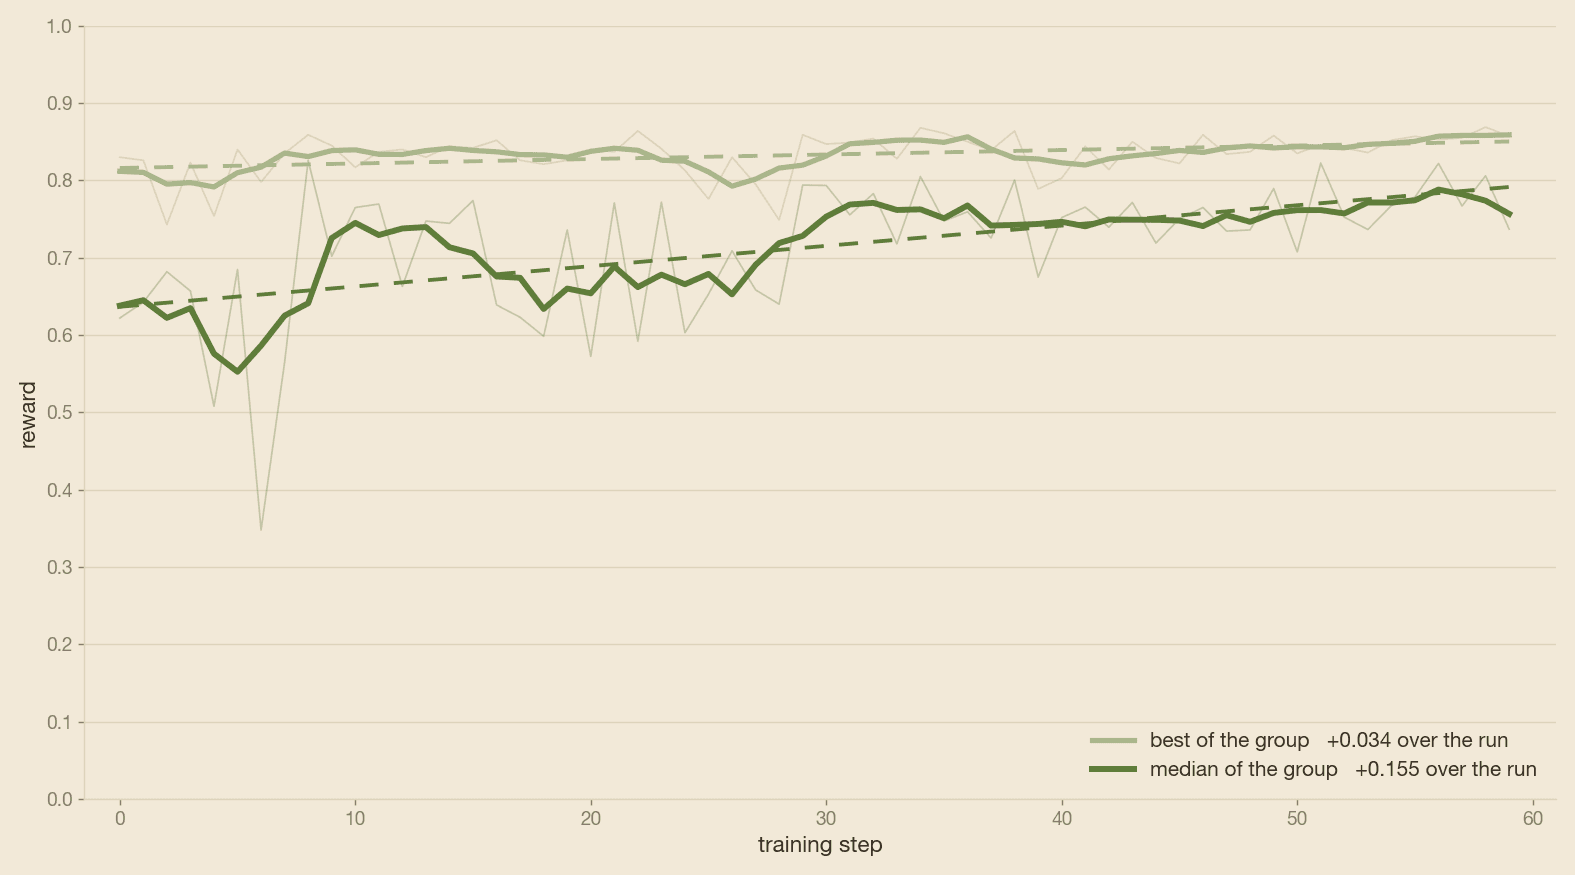
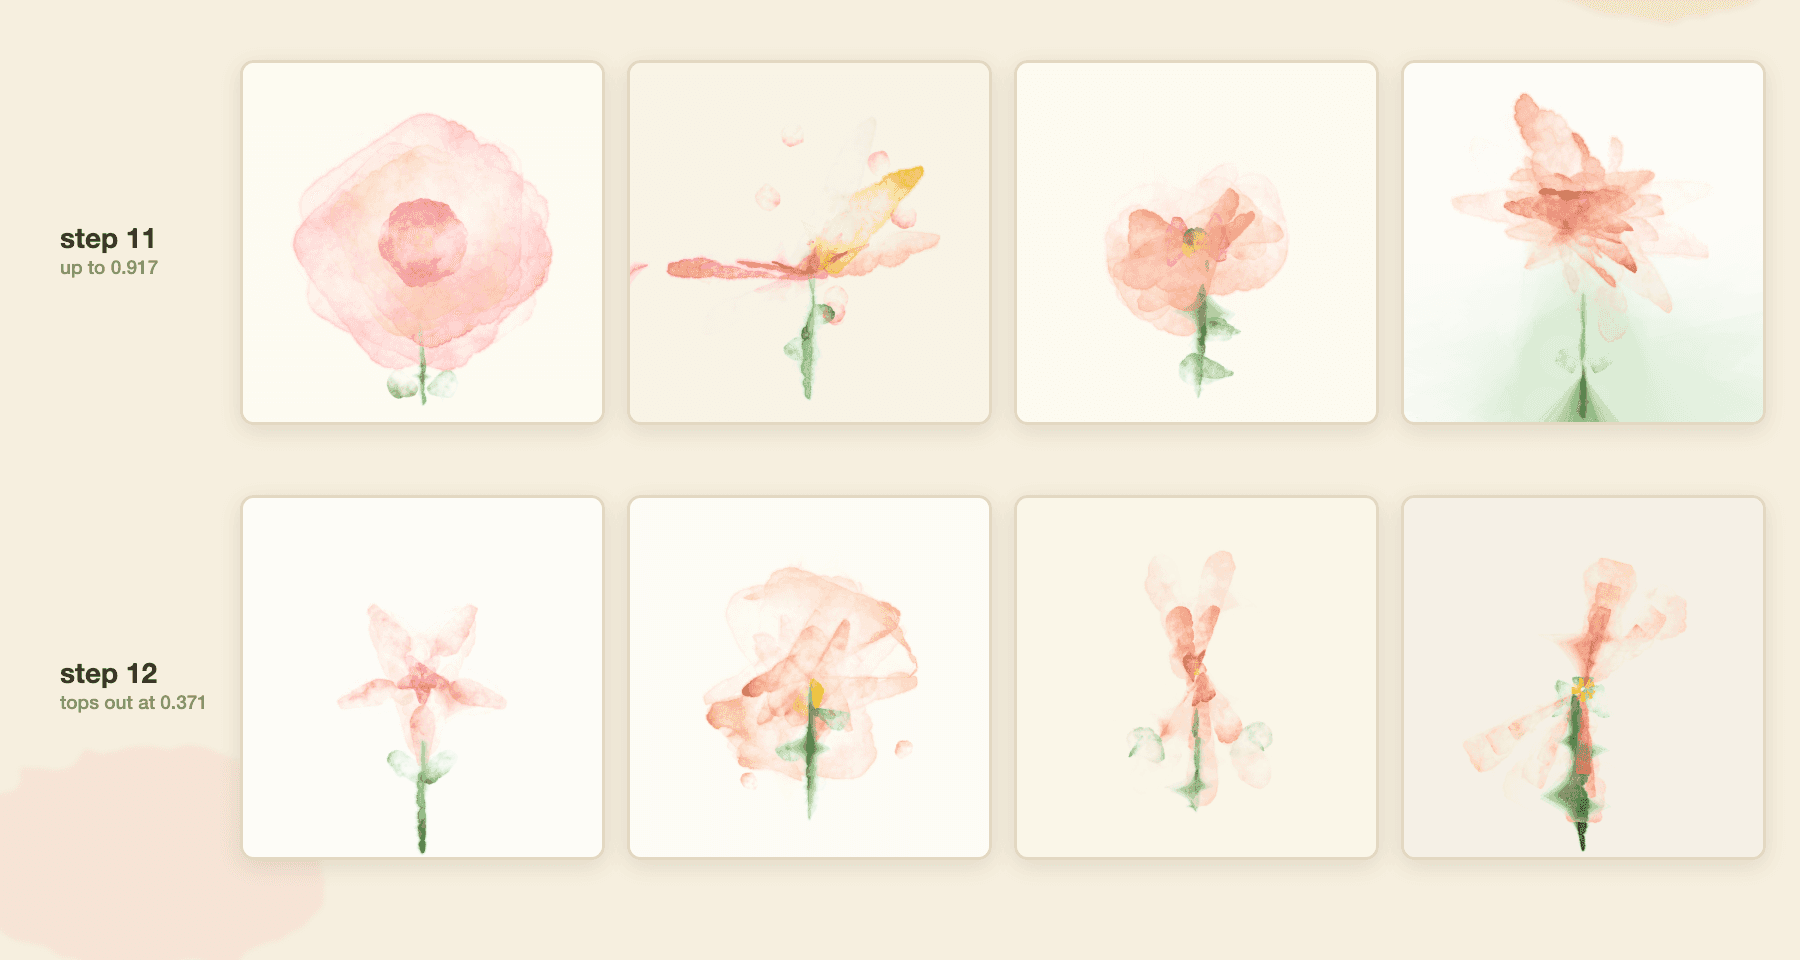
จากการทดลองพบว่าในระยะแรกโมเดลจะเรียนรู้ที่จะเลิกสร้างภาพที่แย่ก่อน จากนั้นจึงค่อยๆ พัฒนาจุดสูงสุดของภาพให้สวยงามขึ้นตามข้อมูลอ้างอิง สิ่งที่น่าสนใจคือ AI เปลี่ยนคอขวดของการทำงานจากการสร้างผลงานมาเป็นการสังเกตและคัดเลือก (curation) แทน
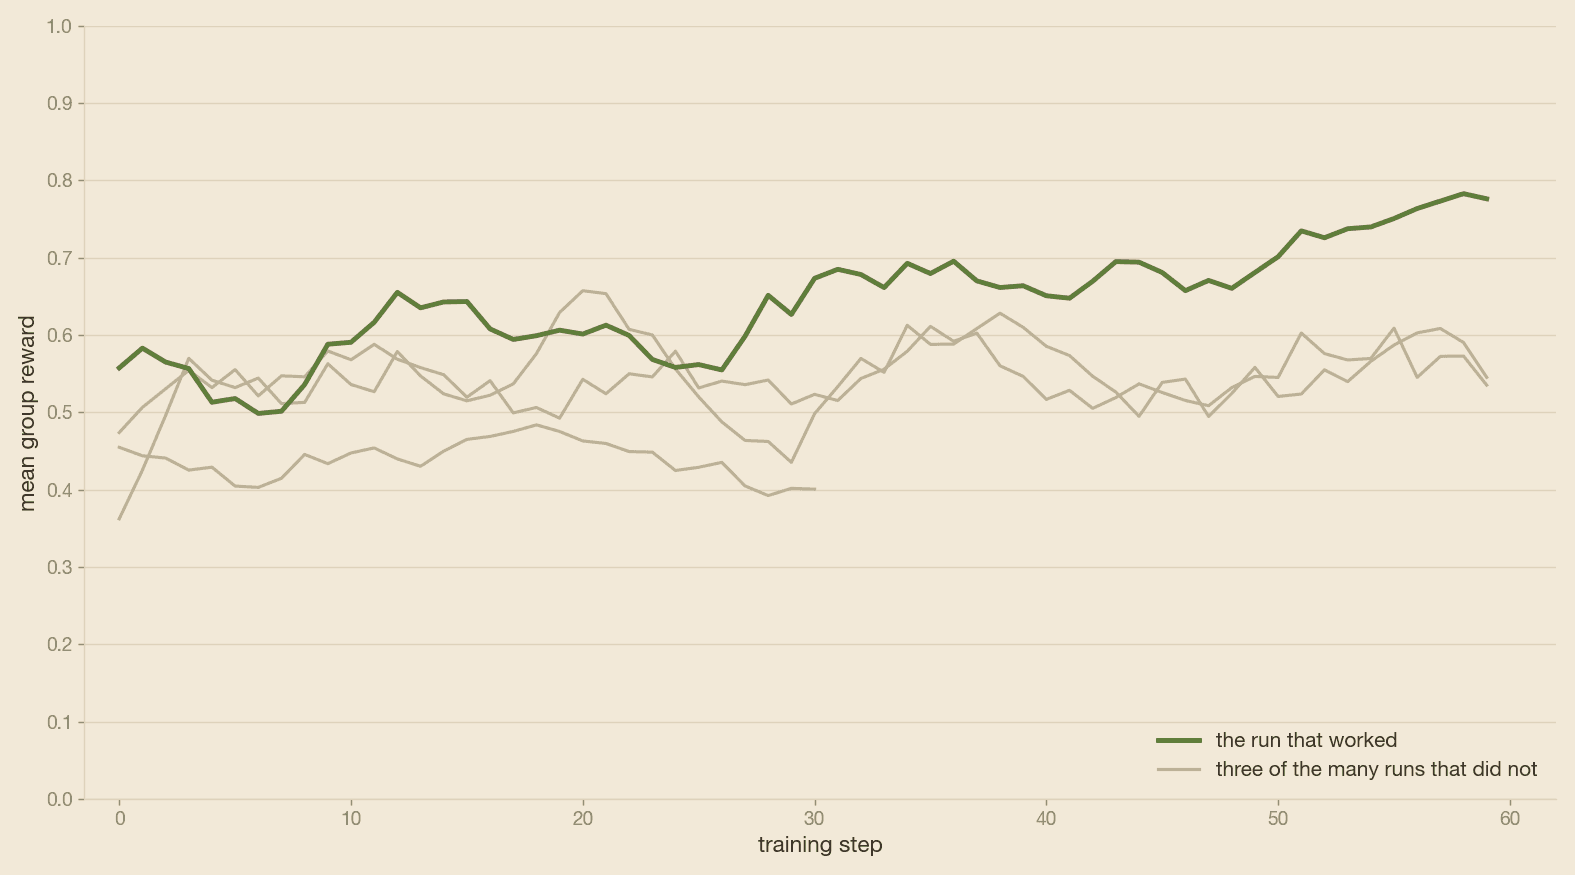
ในอนาคต ผมมีแผนที่จะลองฝึกแบบหลายขั้นตอน (Multi-step) เพื่อให้โมเดลมองเห็นสิ่งที่ตัวเองวาดและปรับปรุงได้ทันที รวมถึงการทดสอบกับโมเดลที่มีขนาดเล็กลงเพื่อลดต้นทุนในการคำนวณ โดยผู้ที่สนใจสามารถเข้าไปดูผลงานทั้งหมดได้ที่ แกลเลอรี
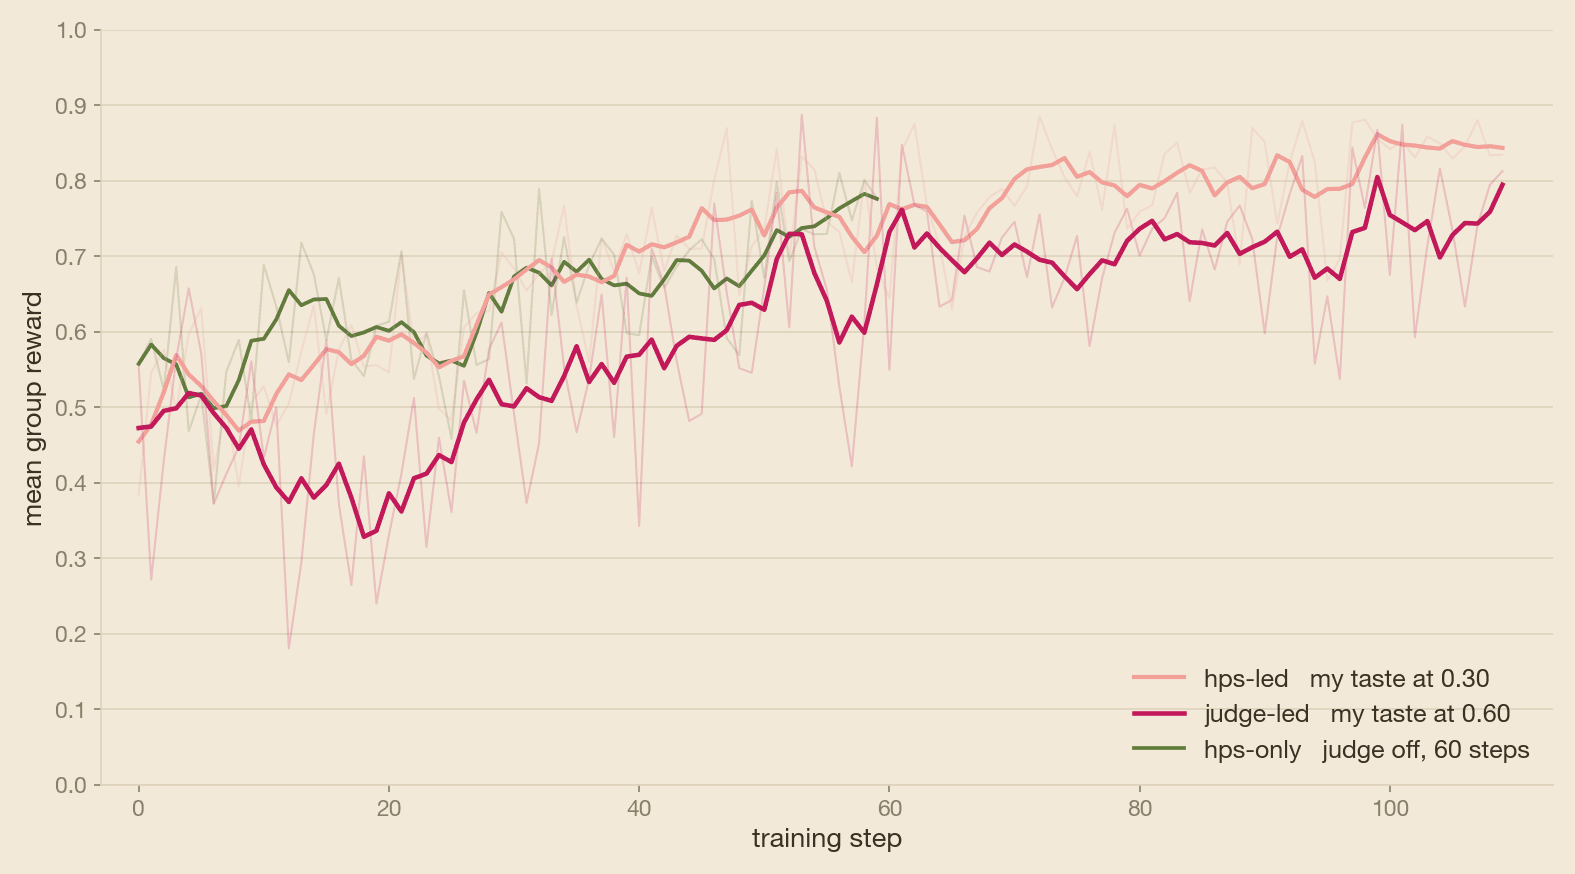
ทุกอย่างในโปรเจกต์นี้ได้รับการเผยแพร่เป็นแบบเปิด เพื่อให้ชุมชนนักพัฒนาสามารถนำไปต่อยอดและศึกษาการใช้ RL กับงานสร้างสรรค์ทางศิลปะได้อย่างอิสระ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร