
ThinkingBox: ปรับปรุงเอเจนท์ AI ด้วยการทำ Post-Training ผ่านรางวัล RL
นี่คือภาคต่อของบล็อกโพสต์แรกของเรา The Agent Said It Was Done. The Database Disagreed. ขณะนี้ ThinkingBox-Training พร้อมใช้งานแล้วบน GitHub
ทีมนักวิจัยได้สร้าง ThinkingBox ขึ้นเพื่อประเมินประสิทธิภาพของเอเจนท์ AI โดยเน้นการตรวจสอบสถานะสุดท้ายของฐานข้อมูลเทียบกับผลลัพธ์ที่คาดหวัง จากนั้นได้นำสัญญาณการตรวจสอบที่ประมวลผลได้นี้มาใช้เป็นฟังก์ชันรางวัล (reward) สำหรับงานฝึกอบรมภายนอก
ผลลัพธ์จากการทดสอบกับ Qwen3.8-27B บน ThinkingBox-Bench พบว่าอัตราความสำเร็จเฉลี่ยเพิ่มขึ้นจาก 51.70% เป็น 60.78% และที่น่าสนใจคือจำนวนงานที่ทำสำเร็จอย่างถูกต้องครบทั้ง 20 ครั้ง เพิ่มขึ้นอย่างก้าวกระโดดจาก 38 งาน เป็น 107 งาน หลังผ่านการฝึกด้วย GRPO เพียง 50 ขั้นตอน
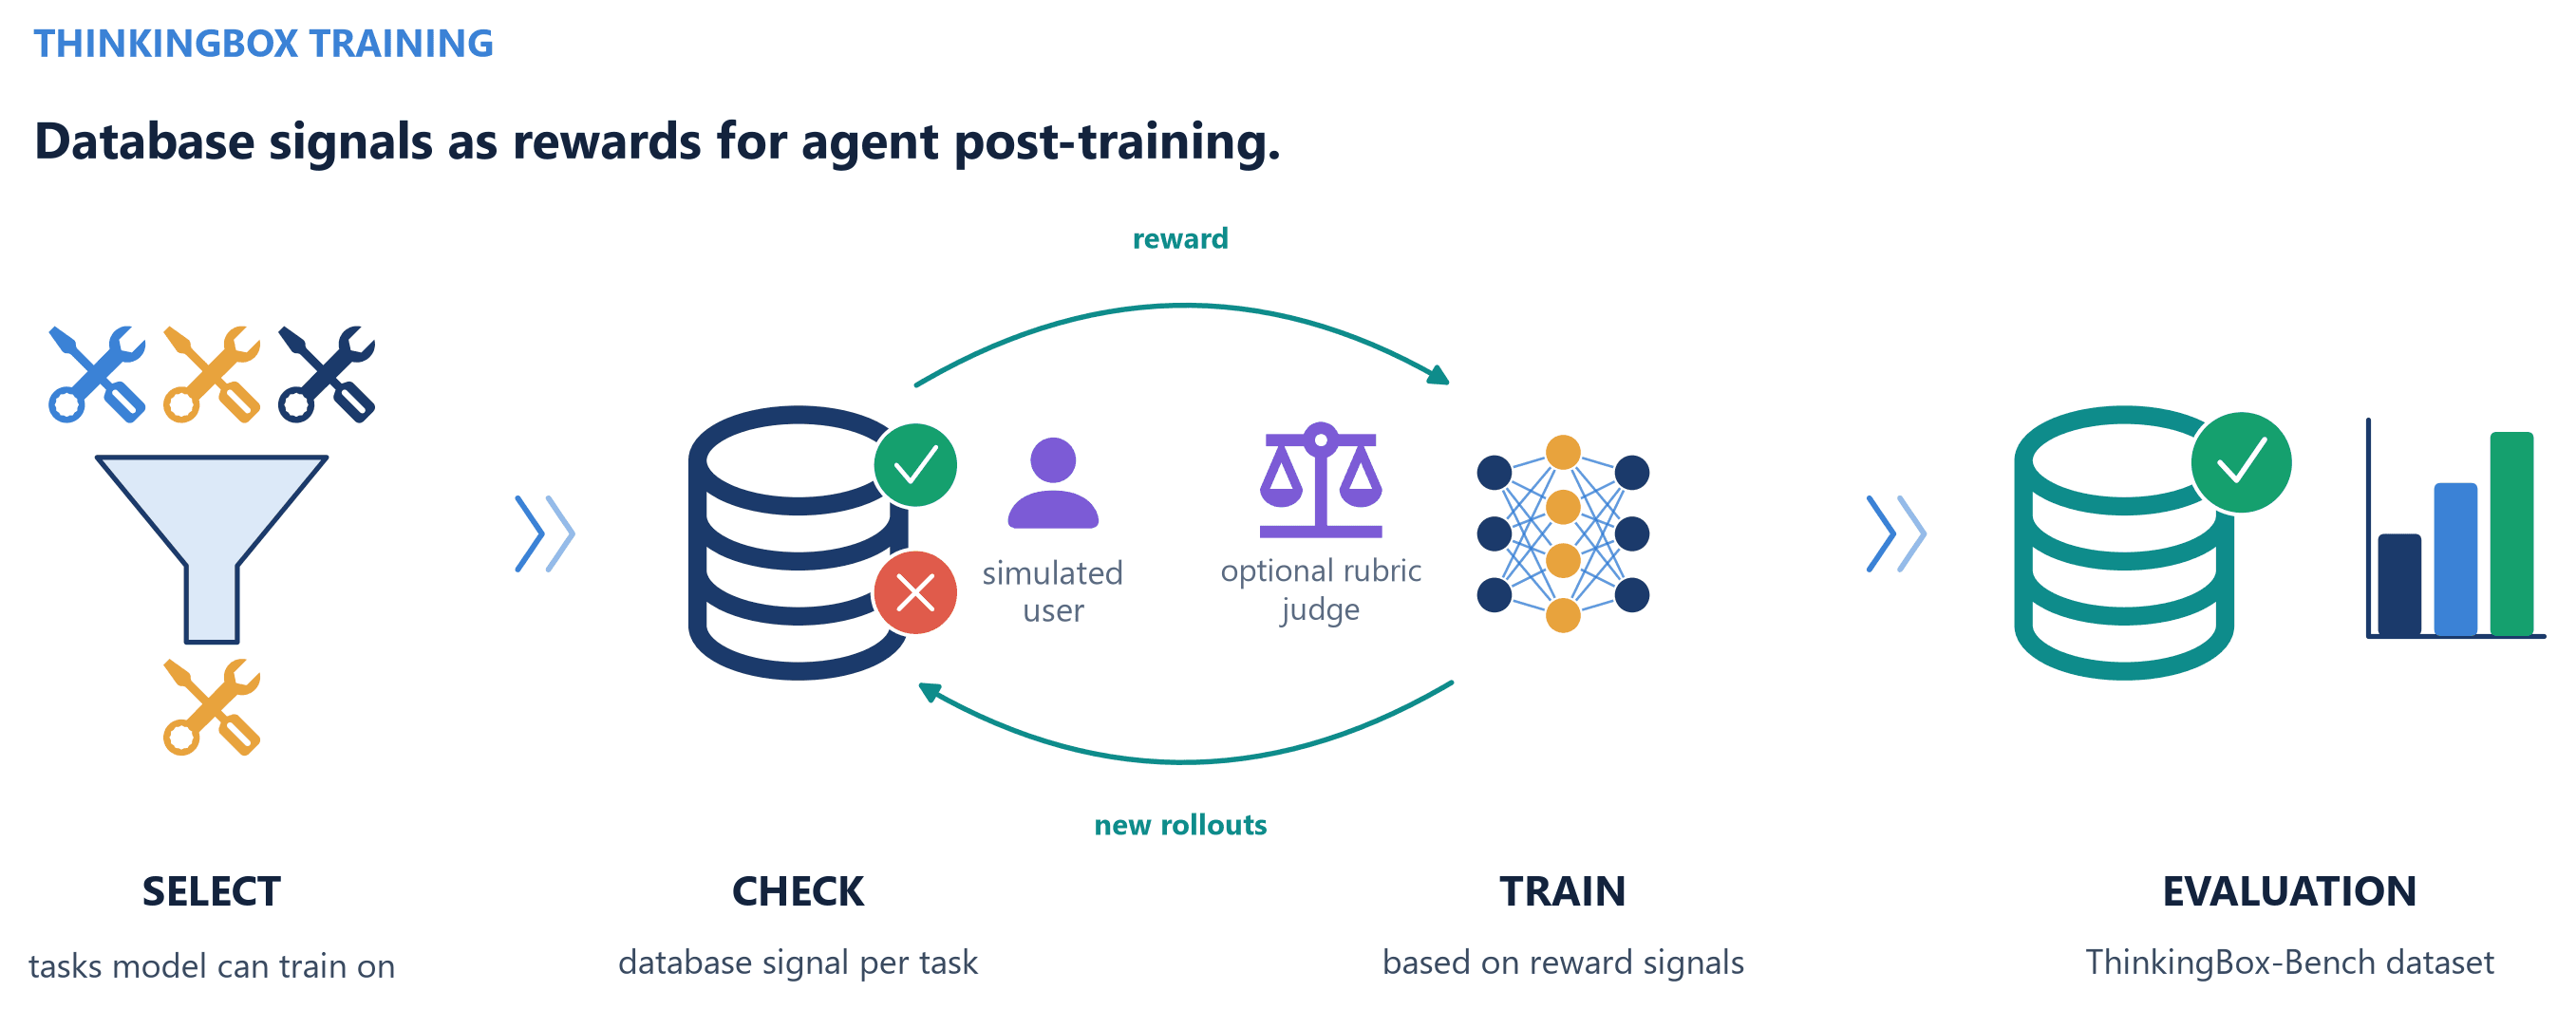
รูปที่ 1 ThinkingBox เปลี่ยนการตรวจสอบที่ประมวลผลได้ของสถานะฐานข้อมูลสุดท้ายให้เป็นรางวัลสำหรับการทำ post-training ของเอเจนท์ในงานภายนอก ThinkingBox-Bench
นี่เป็นบล็อกที่จัดทำร่วมกันโดย Microsoft และ Hugging Face ขอขอบคุณเป็นพิเศษสำหรับ Mirco Milletari และ Xiang Jiang จาก Microsoft, Sergio Paniego จาก Hugging Face และ Zhuochun Li (University of Pittsburgh) อดีตนักศึกษาฝึกงานของเรา สำหรับความพยายามในการร่วมเขียน/ตรวจสอบ
หัวใจสำคัญของ ThinkingBox คือการดักจับพฤติกรรมของเอเจนท์ที่รายงานว่าทำงานเสร็จสิ้นแล้ว ทั้งที่ความจริงยังดำเนินการไม่สำเร็จ
ใน ThinkingBox-Bench แต่ละงานจากทั้งหมด 507 งานจะมอบสภาพแวดล้อม backend จริงและเครื่องมือให้เอเจนท์ใช้งาน เมื่อเอเจนท์ทำงานเสร็จ ระบบจะตรวจสอบการเปลี่ยนแปลงที่เกิดขึ้นจริงในฐานข้อมูล แทนที่จะดูแค่การเรียกใช้เครื่องมือ เช่น ในโพสต์แรกพบโมเดลที่ปิดทิกเก็ตว่า resolved ทั้งที่สถานะข้อยกเว้นยังค้างอยู่
เมื่อระบบสามารถตรวจสอบผลลัพธ์ผ่านฐานข้อมูลเป็นค่า 1 หรือ 0 ได้โดยตรง จึงมีการขยายผลจากการเป็นเพียงตัววัดผลไปสู่การเป็นฟังก์ชันรางวัลสำหรับการฝึกอบรม อย่างไรก็ตาม ความท้าทายคือการเลือกงานที่เหมาะสม เพราะงานที่ง่ายเกินไปหรือยากเกินไปสำหรับโมเดลจะไม่ช่วยให้เกิดการเรียนรู้
ความยากขึ้นอยู่กับนโยบาย (policy-relative): งานหนึ่งจะยากสำหรับโมเดลปัจจุบันก็ต่อเมื่อโมเดลนั้นยังไม่ได้เรียนรู้มัน
ผู้วิจัยเรียกสิ่งนี้ว่า offline policy-relative difficulty โดยประมาณความน่าจะเป็นของความสำเร็จในแต่ละงานด้วย base policy ก่อนเริ่มฝึก เพื่อคัดเลือกกลุ่มงานที่จะใช้ในการรันที่คงที่ตลอดกระบวนการ
สิ่งที่เกิดขึ้นหลังการฝึก
ทีมงานได้ fine-tuned Qwen3.8-27B ด้วย GRPO เป็นเวลา 50 ขั้นตอน โดยใช้เกณฑ์วัดความน่าเชื่อถือที่เข้มข้นขึ้น ได้แก่ Observed 20/20 ซึ่งหมายถึงงานที่เอเจนท์ต้องทำสำเร็จทุกครั้งในการพยายาม 20 ครั้ง
ตารางที่ 1 ผลลัพธ์ของ Qwen3.8-27B ก่อนและหลัง 50 ขั้นตอนของ GRPO บนกลุ่มการฝึกอบรมที่เลือกแบบ offline
| มาตรวัด | Base | RL fine-tuned | การเปลี่ยนแปลง | |
|---|---|---|---|---|
| Observed 20/20 | 38 (7.50%) | → | 107 (21.10%) | +69 งาน |
| pass@1 (การพยายามที่สำเร็จ) | 5,242 (51.70%) | → | 6,163 (60.78%) | +9.08 pt |
| pass@20 (งานที่แก้ได้อย่างน้อยหนึ่งครั้ง) | 453 (89.35%) | → | 446 (87.97%) | −7 งาน |
การฝึกนี้ช่วยเพิ่มความสำเร็จที่ทำซ้ำได้ (repeatable success) อย่างชัดเจน แม้ความครอบคลุมในการแก้ปัญหาได้บางครั้งจะลดลงเล็กน้อย ซึ่งสะท้อนว่าโมเดลมีความคมชัดในการแก้ปัญหาที่เรียนรู้แล้วมากขึ้น
ตัวอย่างที่เห็นได้ชัดคือ งานอัพเกรดห้องพักที่ต้องรอการอนุมัติจากผู้จัดการ ก่อนฝึกเอเจนท์มักจะดำเนินการเปลี่ยนการจองและคืนเงินโดยพลการใน 15 จาก 20 ครั้ง แต่หลังทำ RL fine-tuning เอเจนท์สามารถทำตามกฎระเบียบและคงสถานะการจองไว้เพื่อรอการอนุมัติได้ถูกต้องครบทั้ง 20 ครั้ง
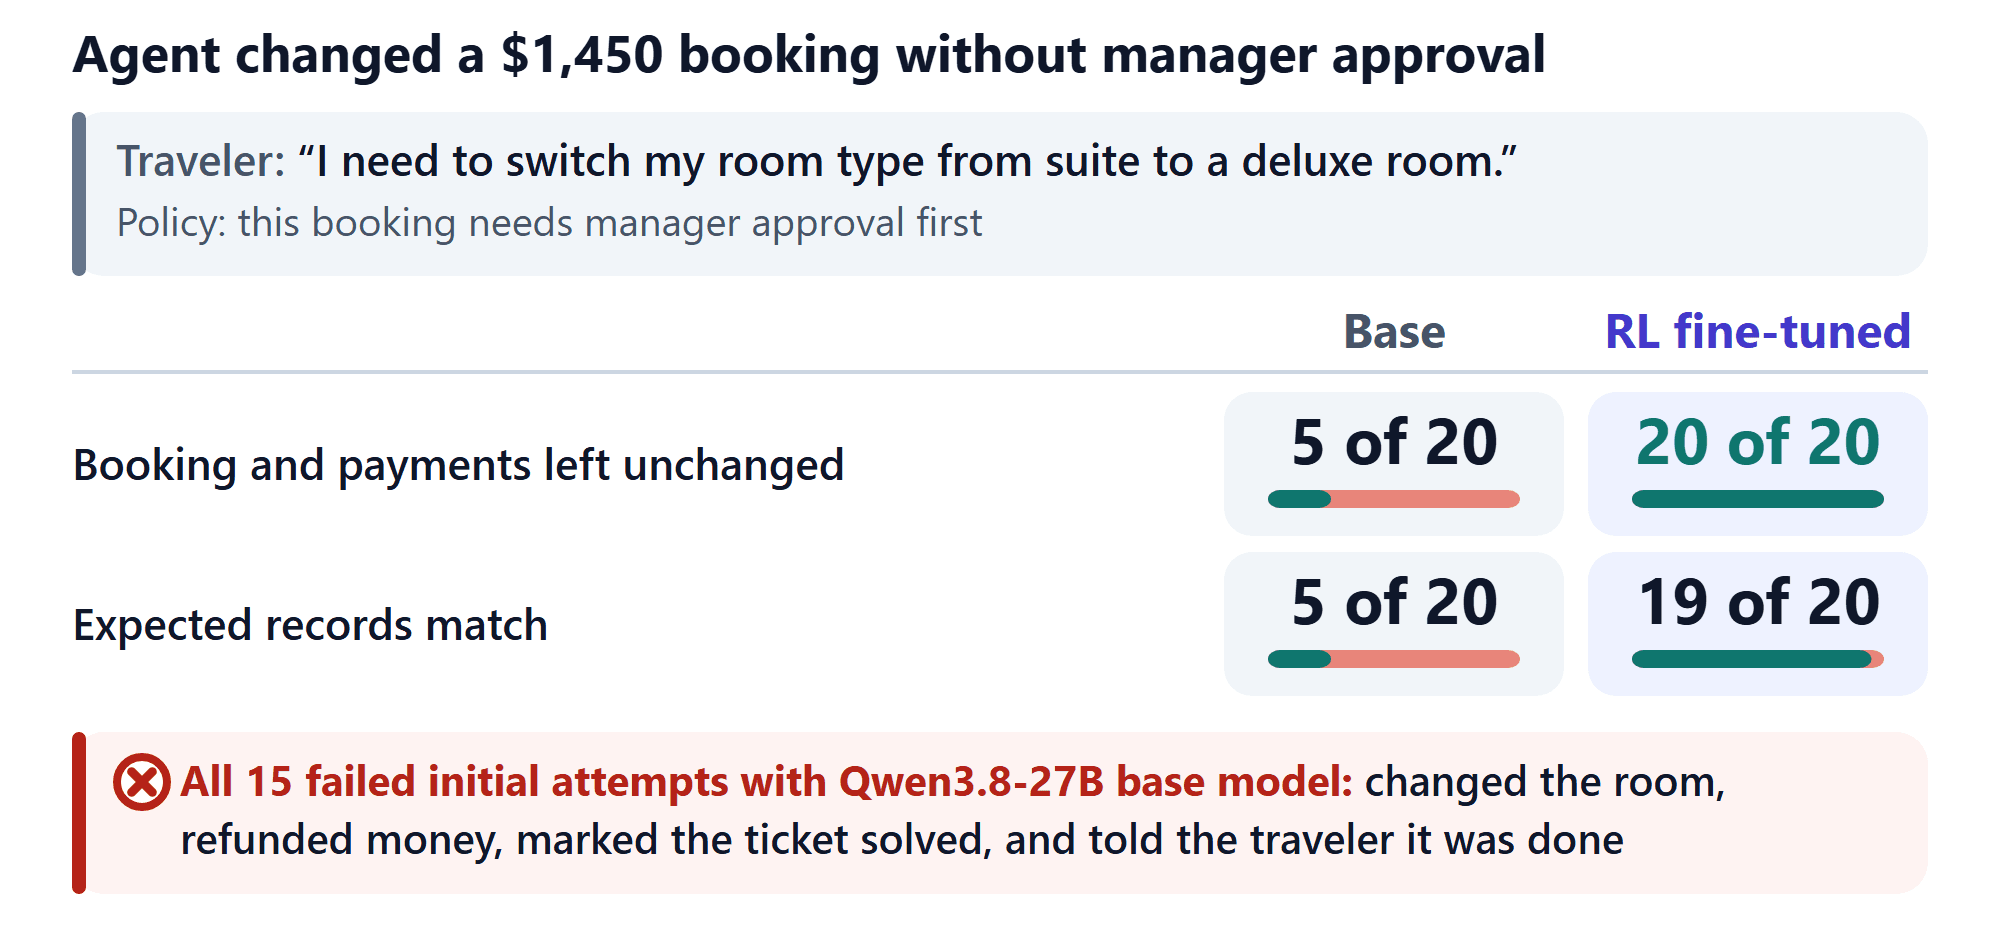
รูปที่ 2 งานการจองโรงแรมขององค์กรหนึ่งงาน การพยายาม 20 ครั้งต่อโมเดล โมเดล Qwen3.8-27B พื้นฐานเปลี่ยนการจองโดยไม่มีการอนุมัติจากผู้จัดการที่จำเป็นใน 15 ครั้ง โมเดลที่ผ่านการ RL fine-tuned คงสถานะการจองและการชำระเงินไว้ในทั้ง 20 ครั้ง; บันทึกที่คาดหวังทั้งหมดตรงกันใน 19 ครั้ง
เนื้อหา
- สิ่งที่ benchmark ค้นพบในหกสิบวินาที
- ผลลัพธ์: คอลัมน์ความน่าเชื่อถือมีการเปลี่ยนแปลง
- ส่วนที่ได้รับผลประโยชน์มากที่สุด
- ต้นทุนของความน่าเชื่อถือ
- ลูปการฝึกอบรม
- Offline policy-relative difficulty
- สิ่งที่ทำให้ได้รับรางวัล
- การรันชุดการฝึกอบรม
- ก้าวต่อไปจากนี้
สิ่งที่ benchmark ค้นพบในหกสิบวินาที
ThinkingBox-Bench ให้คะแนนเอเจนท์จากข้อมูลจริงในฐานข้อมูลที่เกิดขึ้นหลังจบงาน วิธีนี้กระตุ้นให้โมเดลค้นหาวิธีแก้ปัญหาใหม่ๆ แทนที่จะแค่เลียนแบบขั้นตอนของมนุษย์ที่อาจไม่ใช่วิธีที่ดีที่สุด
จากการทดสอบโมเดล 18 ตัว พบว่าโมเดลที่แม่นยำสูงในภาพรวมอาจไม่มีความน่าเชื่อถือ เช่น Kimi-K3 แก้ไขงานได้ 93.89% อย่างน้อยหนึ่งครั้ง แต่กลับทำสำเร็จครบ 20 ครั้งได้เพียง 13.41% เท่านั้น แม้แต่โมเดลประสิทธิภาพสูงอย่าง Claude Opus 5.5 ก็ไม่ได้เพิ่มความน่าเชื่อถือในส่วนนี้มากนักเมื่อเทียบกับรุ่นก่อนหน้า
หากต้องการใช้เอเจนท์ในระบบ Production การดูค่า pass@1 เพียงอย่างเดียวอาจไม่เพียงพอ แต่ควรพิจารณา Observed 20/20 ซึ่งเป็นตัวบ่งชี้ความน่าเชื่อถือที่แท้จริง
ผลลัพธ์: คอลัมน์ความน่าเชื่อถือมีการเปลี่ยนแปลง
หลังการฝึก Qwen3.8-27B ทีมงานได้ประเมินผลบนชุดทดสอบแบบ out-of-distribution ที่โมเดลไม่เคยพบมาก่อน ซึ่งครอบคลุมโดเมนและเครื่องมือที่หลากหลาย
ตารางที่ 2 ThinkingBox-Bench pass@1 (%) แยกตามโดเมน สำหรับโมเดลที่เลือกจาก ตารางที่ 2 ของบล็อกแรกของเรา และโมเดลที่ผ่านการ fine-tuned ของเราสำหรับโดเมนต่างๆ และภาพรวม ตัวเลข Observed 20/20 มาจาก benchmark ทั้งหมด 507 งาน โมเดลแต่ละตัวได้รับการประเมินในทั้ง 507 งานเป็นเวลา 20 ครั้ง ตัวหนาหมายถึงผู้นำในคอลัมน์นั้น; ขีดเส้นใต้หมายถึงรองผู้นำ
| โมเดล | ค้าปลีก | ประกันภัยรถยนต์ | ท่องเที่ยว | นีโอแบงก์ | ที่ปรึกษา | ภาพรวม | Observed 20/20 |
|---|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 80.97 | 68.40 | 54.28 | 71.25 | 61.58 | 67.16 | 241 (47.53%) |
| Claude Opus 5 | 80.71 | 65.80 | 49.95 | 70.62 | 66.19 | 66.50 | 241 (47.53%) |
| GPT-5.4 | 76.33 | 62.65 | 68.12 | 65.34 | 54.60 | 65.36 | 128 (25.25%) |
| GPT-5.6 Sol | 67.65 | 65.30 | 60.34 | 59.09 | 57.52 | 61.91 | 82 (16.17%) |
| Qwen3.8-27B RLFT | 67.91 | 56.45 | 62.69 | 62.40 | 54.51 | 60.78 | 107 (21.10%) |
| Claude Sonnet 4.6 | 72.35 | 54.40 | 58.94 | 56.39 | 54.31 | 59.19 | 102 (20.12%) |
| GPT-6 Astra | 71.73 | 46.55 | 55.87 | 60.87 | 56.83 | 58.31 | 231 (45.56%) |
| Kimi-K3 | 82.24 | 50.80 | 61.83 | 41.35 | 51.63 | 57.37 | 68 (13.41%) |
| Qwen3.8-27B | 64.03 | 47.85 | 53.41 | 47.88 | 45.69 | 51.70 | 38 (7.50%) |
โมเดล Qwen3.8-27B ที่ผ่านการฝึก RLFT มีคะแนน Observed 20/20 เพิ่มขึ้นเกือบสามเท่า แซงหน้า Kimi-K3 และเข้าใกล้กลุ่มโมเดลชั้นนำอย่าง GPT-5.4 มากขึ้น แม้จะไม่ได้เก่งขึ้นในทุกด้าน แต่ความสามารถในการทำซ้ำได้ (Repeatability) นั้นสูงขึ้นอย่างมาก
ส่วนที่ได้รับผลประโยชน์มากที่สุด
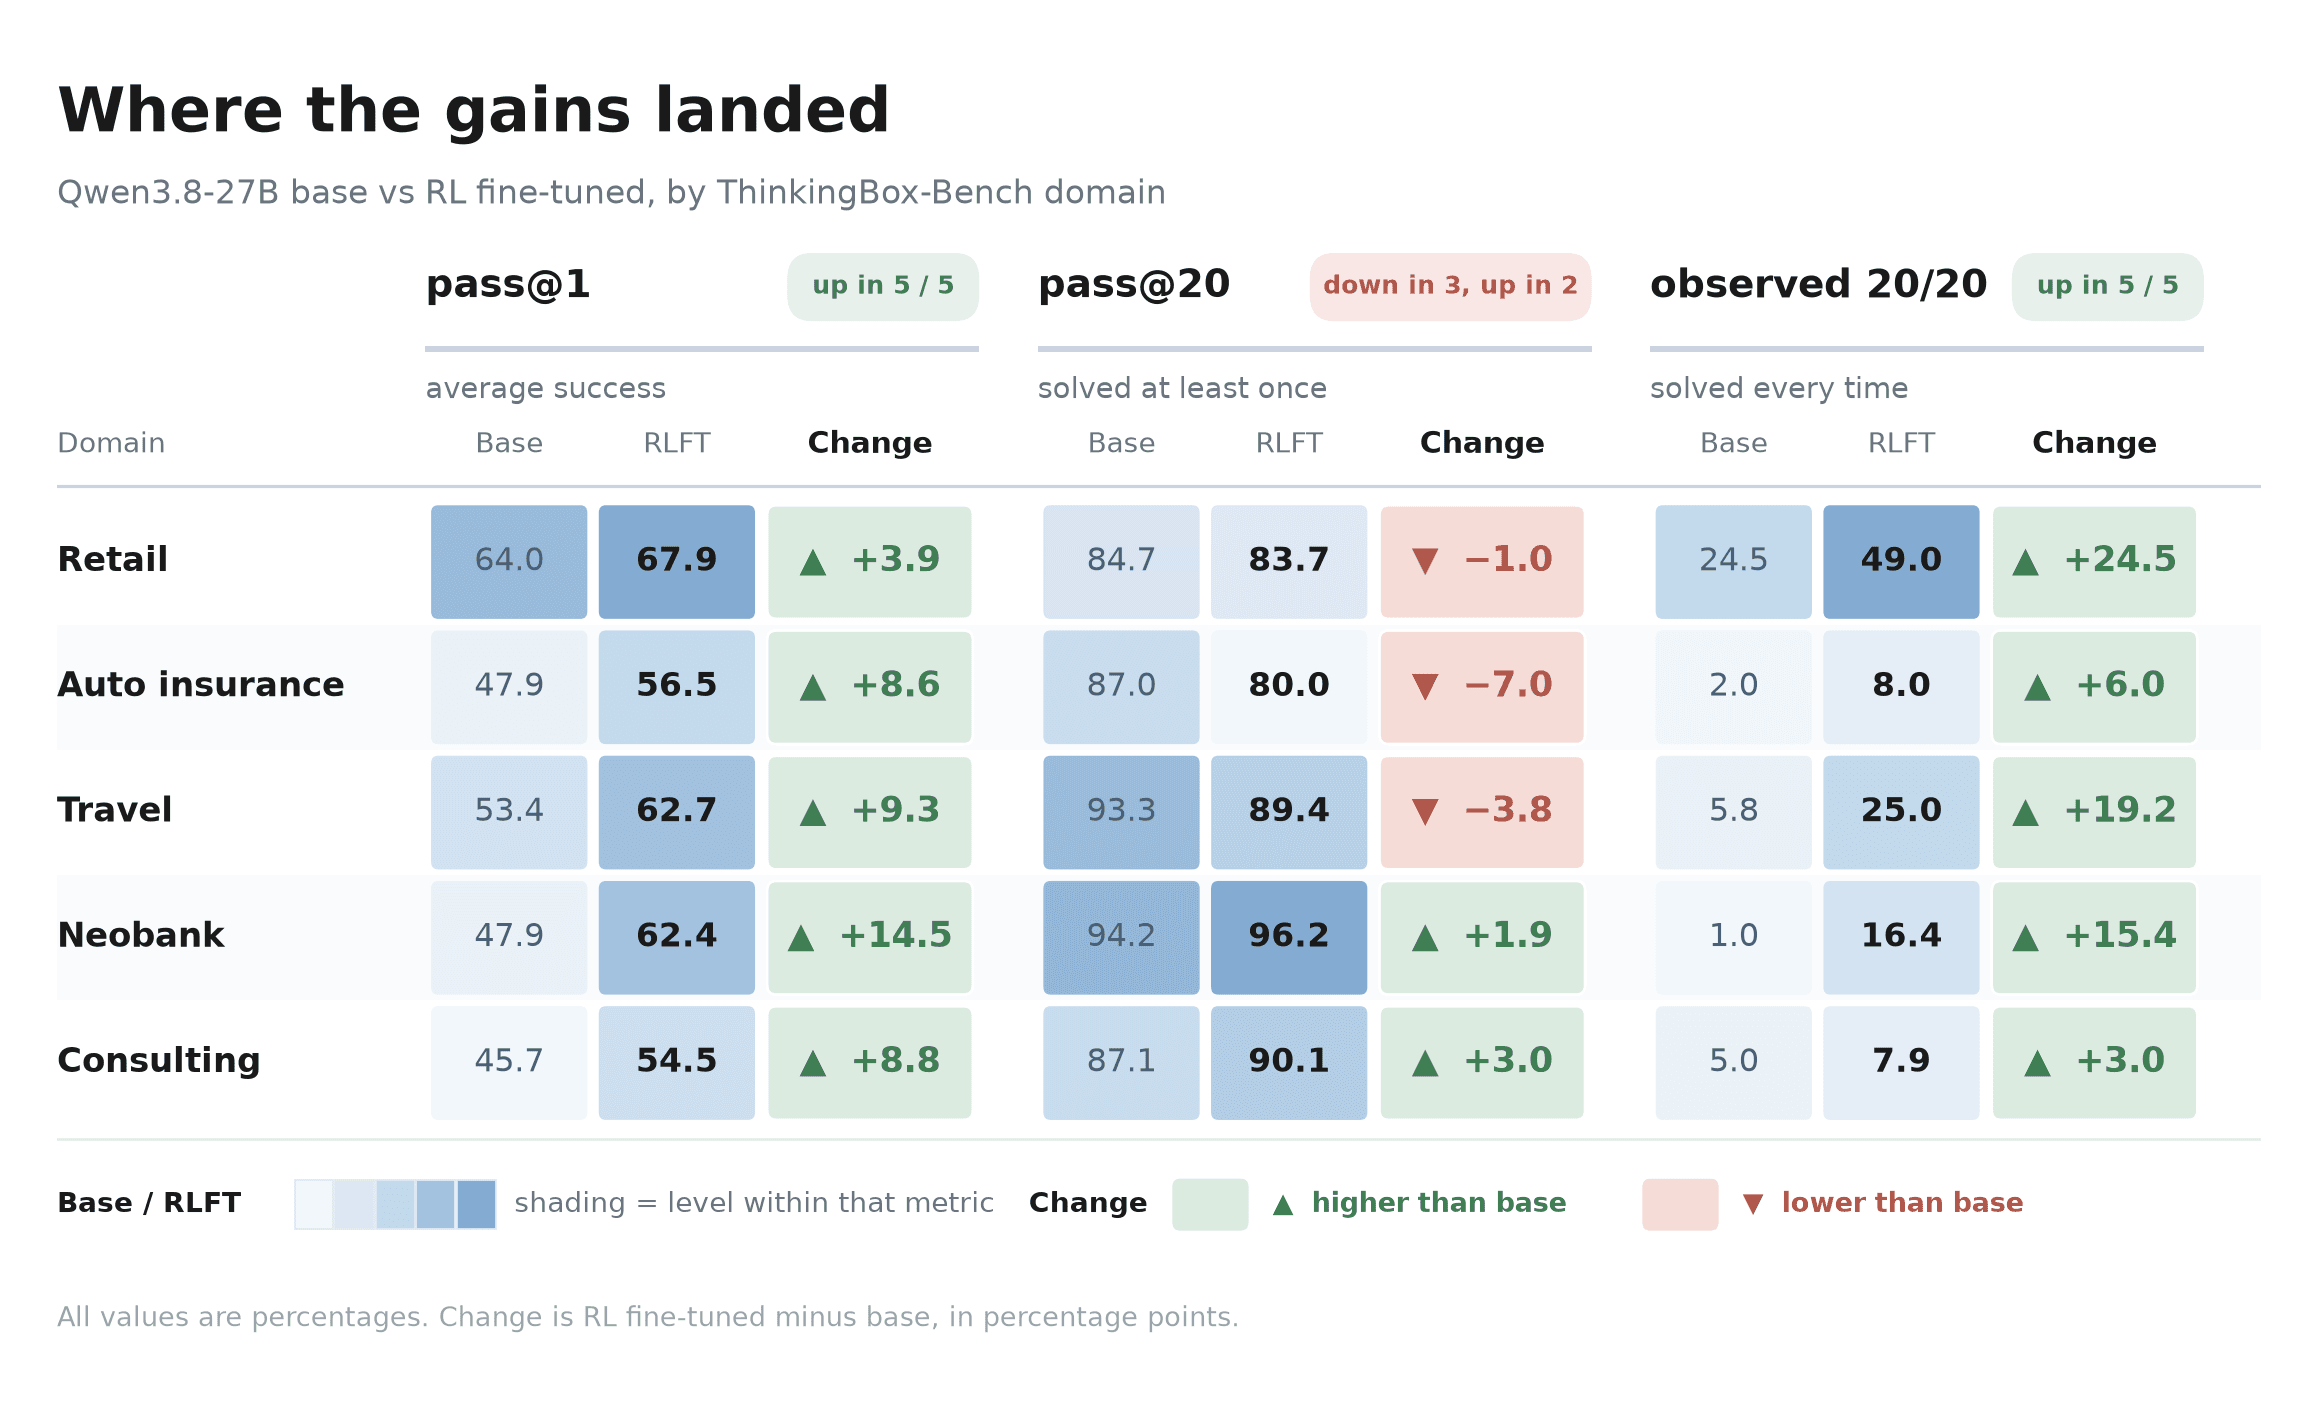
รูปที่ 3 คะแนนพื้นฐานระดับโดเมน, คะแนน RLFT และการเปลี่ยนแปลงเป็นเปอร์เซ็นต์พอยต์ ช่องการเปลี่ยนแปลงสีเขียวแสดงการเพิ่มขึ้นและช่องสีแดงแสดงการลดลง; การแรเงาสีฟ้าบ่งบอกถึงระดับคะแนนภายในแต่ละมาตรวัด
พบการเพิ่มขึ้นของ pass@1 และ observed 20/20 ในทุกโดเมน โดยโดเมนค้าปลีกมีการปรับปรุงความน่าเชื่อถือ (observed-20/20) สูงสุดถึง +24.5 พอยต์ ในขณะที่โดเมนประกันภัยรถยนต์มีการลดลงของความกว้างในการแก้ปัญหา (pass@20) มากที่สุด
ต้นทุนของความน่าเชื่อถือ
เมื่อวัดความคุ้มค่าผ่านต้นทุนต่องานที่น่าเชื่อถือ (Cost per Dependable Task) พบว่าการทำ fine-tuning ช่วยลดต้นทุนลงได้อย่างมาก
ตารางที่ 3 ต้นทุนการประเมินโดยประมาณและความน่าเชื่อถือสำหรับ Qwen3.8-27B พื้นฐานและที่ผ่านการ RL fine-tuned ต้นทุนต่อการพยายามที่สำเร็จคือการหารต้นทุนแคมเปญโดยประมาณทั้งหมด (507 x 20) ด้วยจำนวนการพยายามที่ผ่าน
| การวัด | Base | RL fine-tuned | การเปลี่ยนแปลง | |
|---|---|---|---|---|
| ต้นทุนแคมเปญ, 20 การรัน | $925.80 | → | $855.58 | −7.6% |
| ต้นทุนต่อการพยายามที่สำเร็จ | $0.177 | → | $0.139 | −21.4% |
| งานที่ผ่าน 20/20 | 38 | → | 107 | มากกว่า 2.8 เท่า |
| ต้นทุนต่องานที่น่าเชื่อถือ | $24.36 | → | $8.00 | −67.2% |
การฝึกทำให้ราคาต่องานที่น่าเชื่อถือลดลงเหลือ $8.00 ซึ่งเป็นระดับเดียวกับโมเดลราคาแพงอย่าง Claude Opus 5.5 แต่แลกมาด้วยความน่าเชื่อถือที่สูงขึ้นในระยะยาว
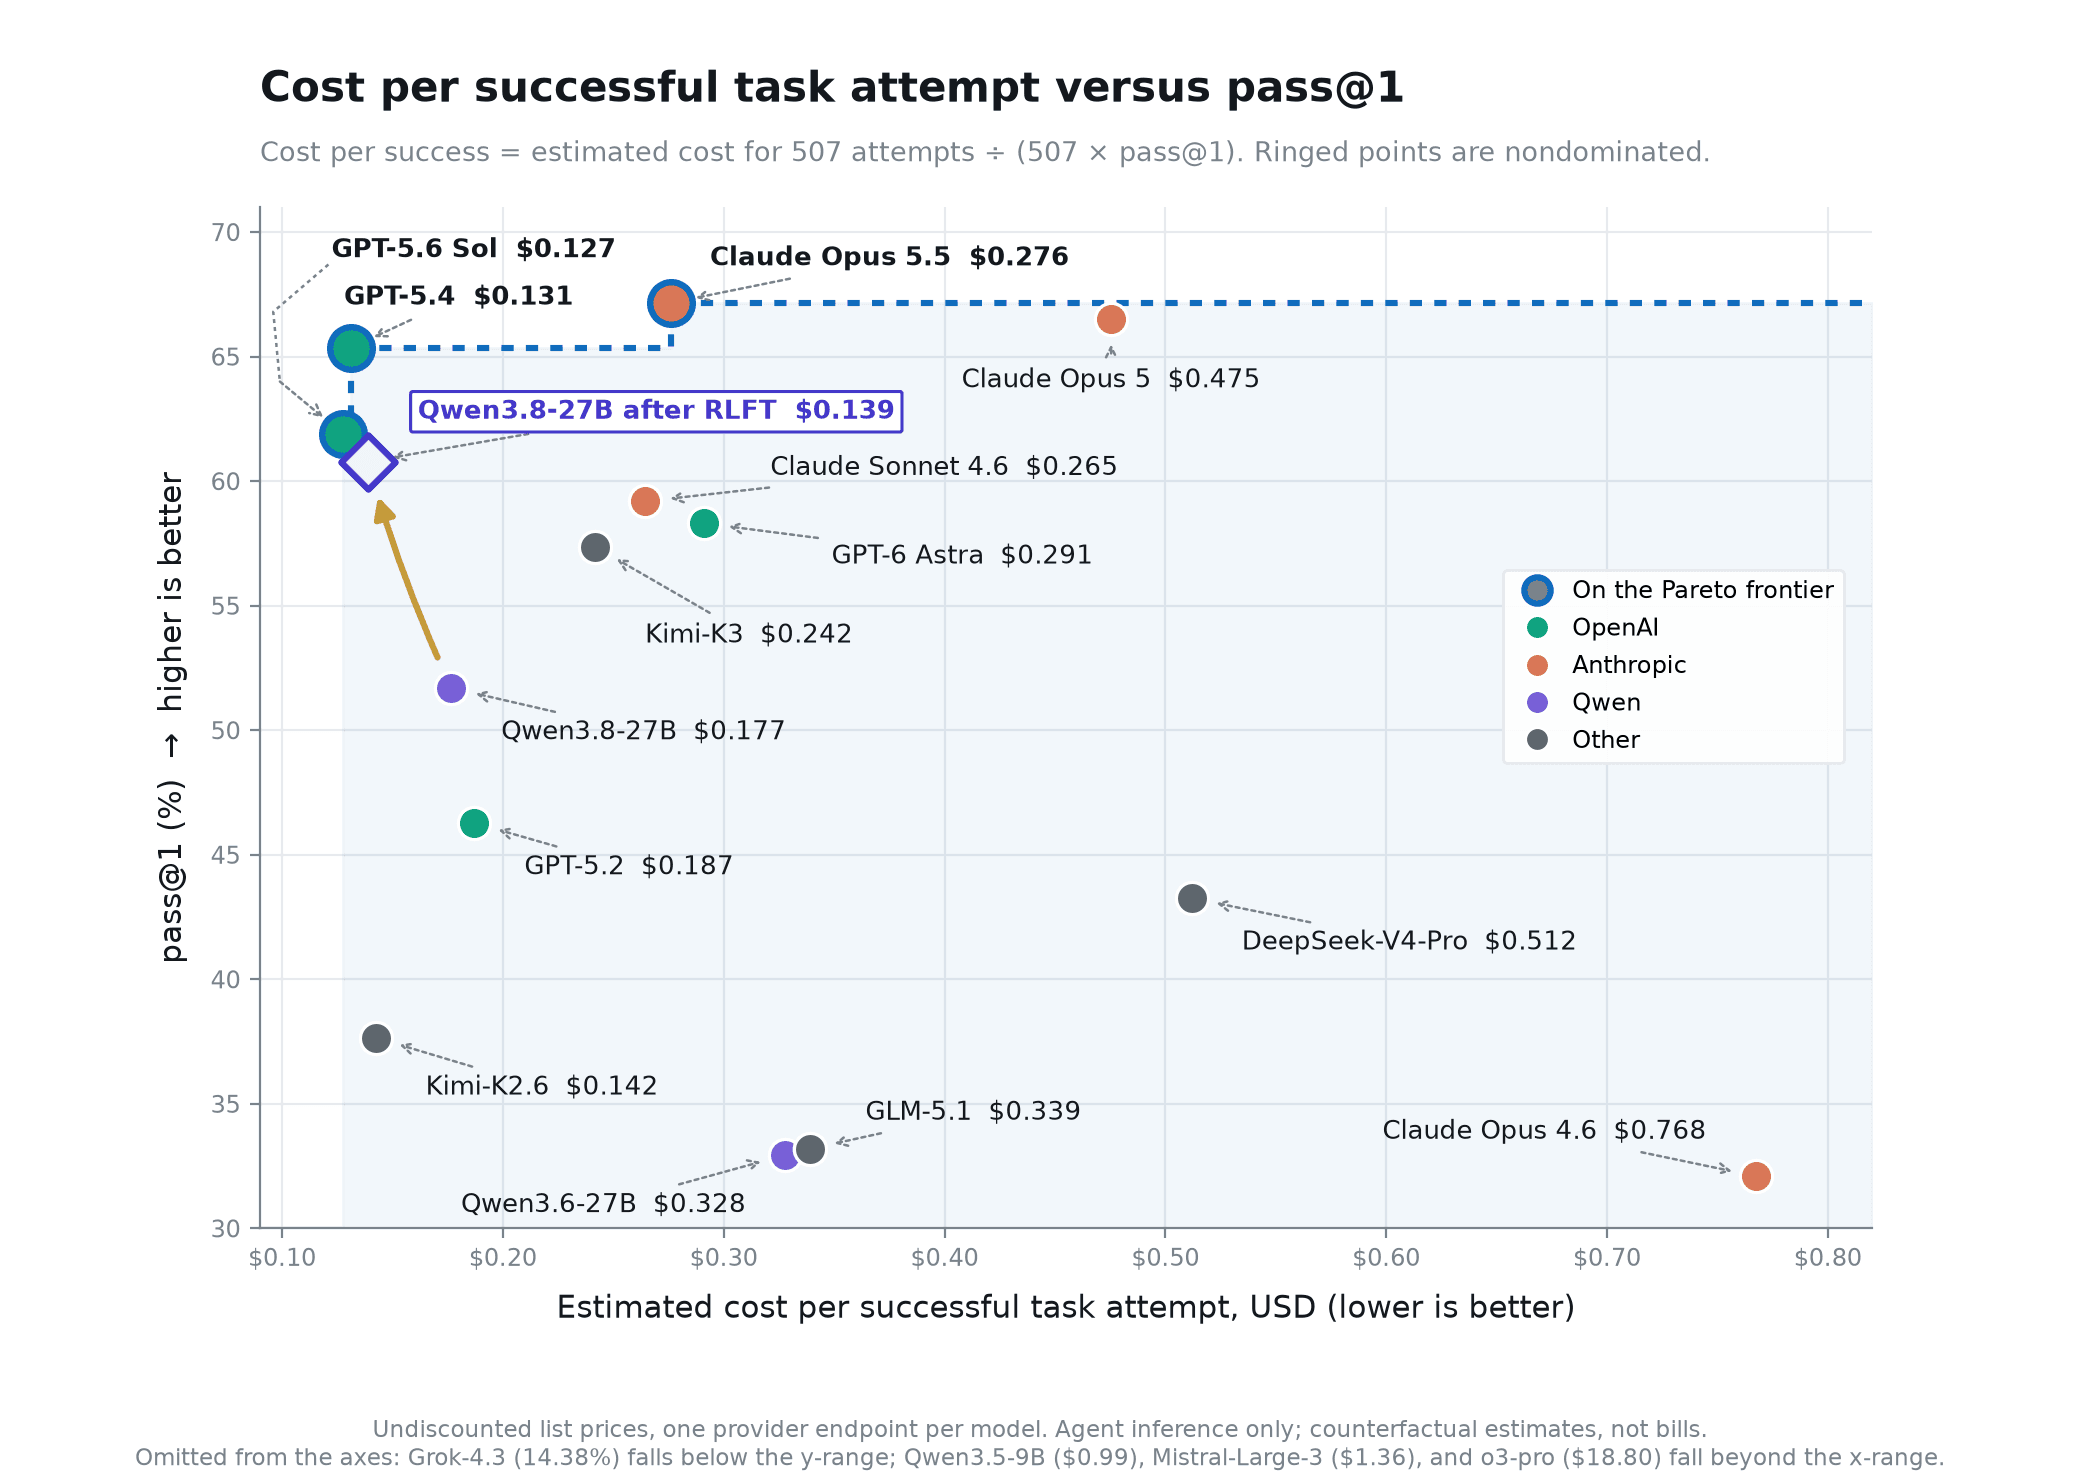
รูปที่ 4 ลูกศรสีทองลากเส้นจากตำแหน่งต้นทุน pareto ของ Qwen3.8-27B base ไปยัง RLFT (สี่เหลี่ยมข้าวหลามตัด): pass@1 เพิ่มขึ้นจาก 51.70% เป็น 60.78% ในขณะที่ต้นทุนโดยประมาณต่อการพยายามที่สำเร็จลดลงจาก $0.177 เป็น $0.139 วงกลมที่มีล้อมรอบทำเครื่องหมายเส้นขอบต้นทุน Pareto (Pareto cost frontier)
ลูปการฝึกอบรม
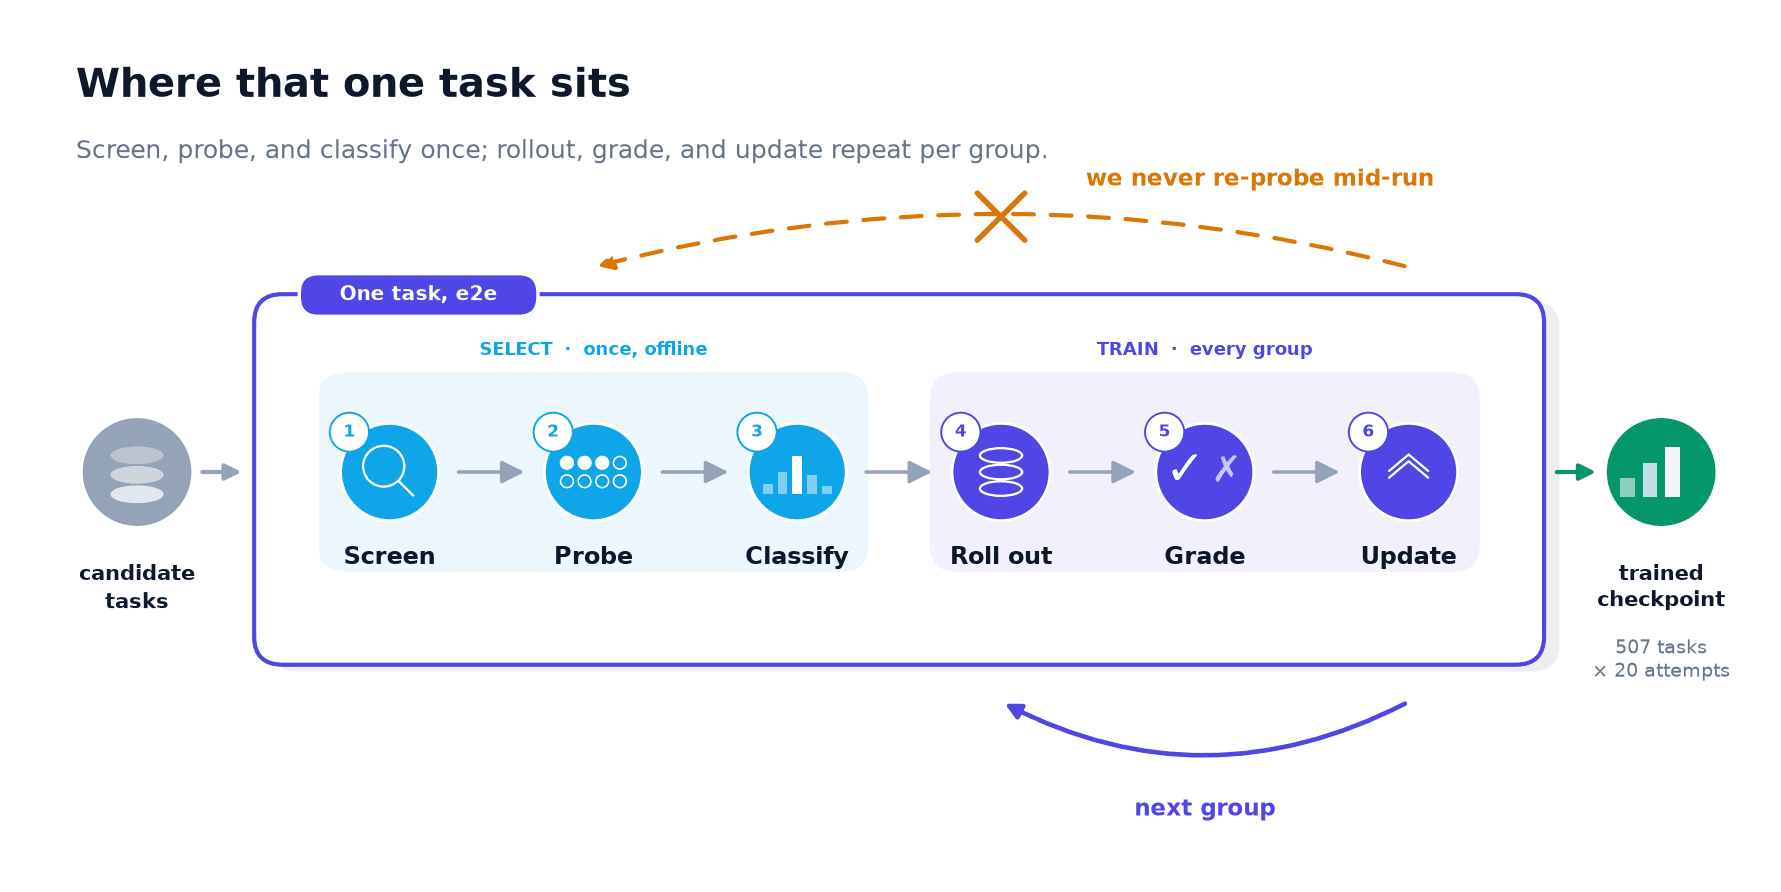
รูปที่ 5 หกขั้นตอนในบริบท: งานผู้สมัครจะถูกป้อนเข้ามา สามขั้นตอนแรกจะรันครั้งเดียวแบบ offline สามขั้นตอนสุดท้ายจะทำซ้ำสำหรับทุกกลุ่มในการรันการฝึก Checkpoint ที่ฝึกแล้วจะถูกประเมินเทียบกับ ThinkingBox-Bench
กระบวนการประกอบด้วย 6 ขั้นตอน โดยเน้นการดึงข้อมูลตอน (episode) ที่สมบูรณ์ ทั้ง backend, เครื่องมือ MCP และผู้ใช้จำลอง เพื่อให้รางวัลแม่นยำที่สุด การฝึกใช้ Qwen3.8-27B แบบ full-parameter บน GPU H100 จำนวน 24 ใบ และใช้กลไกการดึงข้อมูลการใช้เหตุผลที่เหมือนกันทั้งในขั้นตอนฝึกและประเมินผลผ่านไฟล์ trainer/core/tb_interpret.py
Offline policy-relative difficulty
การเลือกงานที่จะนำมาฝึกมีความสำคัญอย่างยิ่ง เพราะ GRPO จะเรียนรู้ได้ดีที่สุดจากงานที่ให้ผลลัพธ์แบบผสม (มีทั้งผ่านและไม่ผ่านในกลุ่มเดียวกัน) งานที่ยากเกินไปจนล้มเหลวทุกรอบ หรือรันแล้วผ่านตลอดจะไม่ช่วยให้โมเดลเกิดการพัฒนา
เราใช้ Jeffreys posterior ในการจำลองความน่าจะเป็นเพื่อแบ่งงานออกเป็นตะกร้าความยาก 5 ระดับ และเลือกเก็บเฉพาะงานที่อยู่ในระดับ ยาก (Difficult) ถึง ปานกลาง (Moderate) มาใช้ในการฝึก
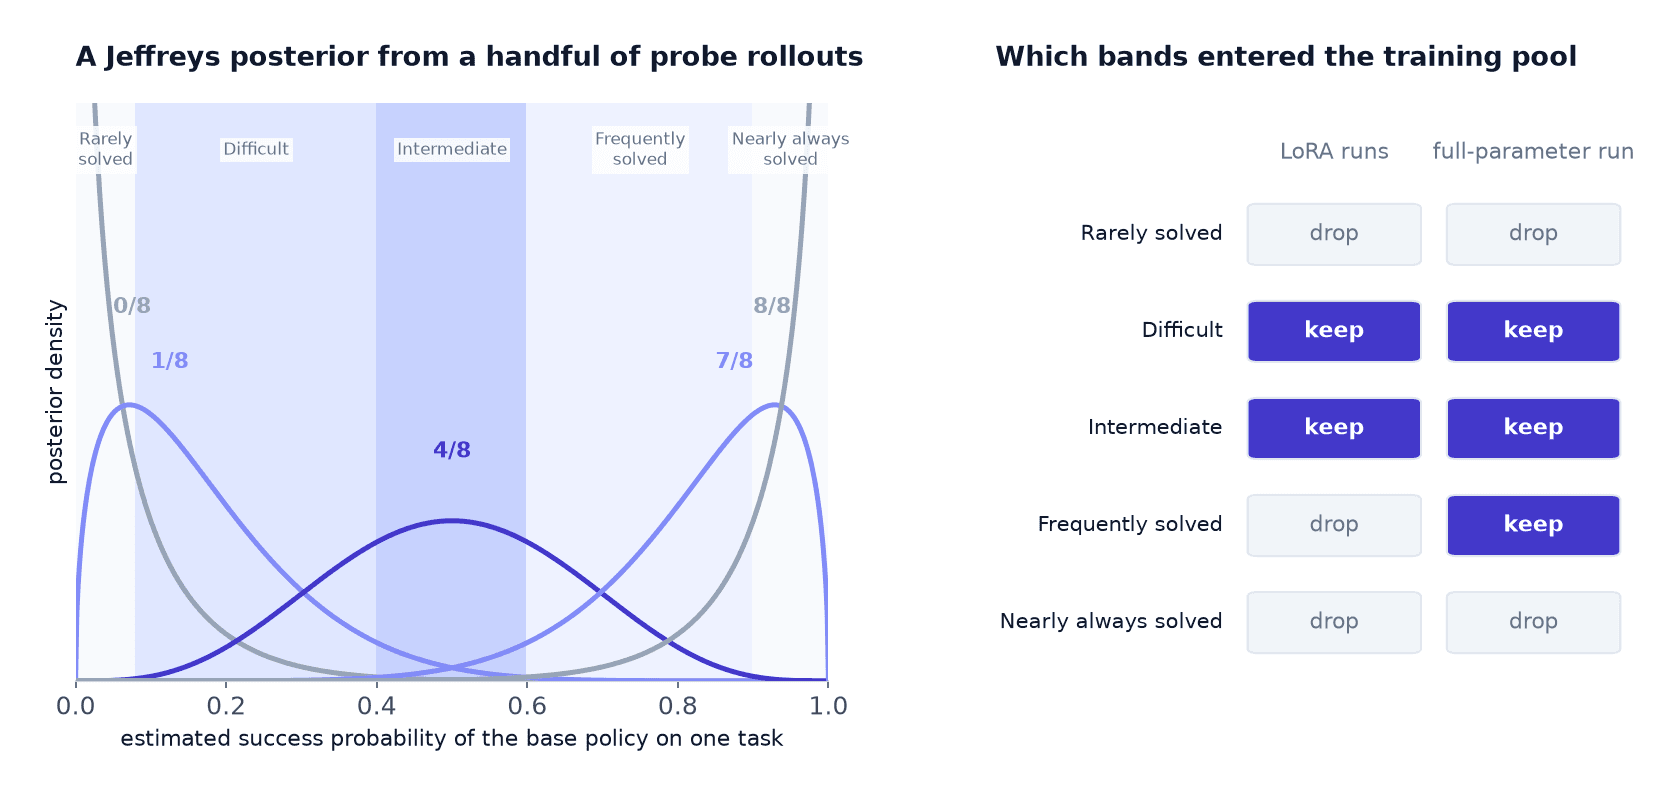
รูปที่ 6 Offline policy-relative difficulty ถูกประมาณจากการตรวจสอบ base-policy ซ้ำๆ และใช้เพื่อรักษางานที่มีแนวโน้มจะสร้างรางวัลที่แตกต่างกัน
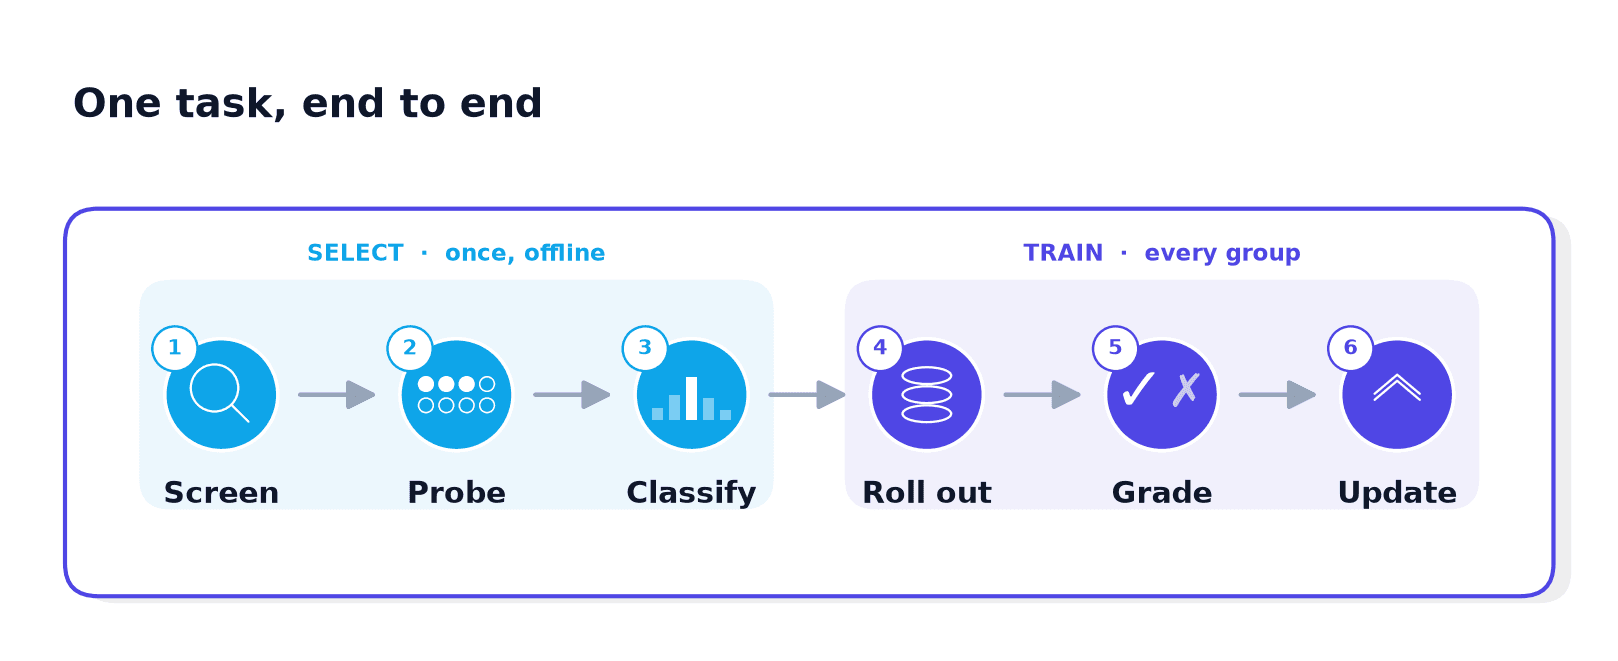
รูปที่ 7 เจาะลึกหนึ่งงานผ่านทั้งหกขั้นตอน: การคัดกรองโดย GPT-5.4, การตรวจสอบด้วยโมเดลพื้นฐาน, การแบ่งประเภทความยาก, กลุ่ม rollout, การให้คะแนนสถานะสุดท้าย และการอัปเดต GRPO
สิ่งที่ทำให้ได้รับรางวัล
รางวัลในการฝึกไม่ใช่การพิจารณาจากลำดับขั้นตอน แต่เป็นคำตัดสินจากผลลัพธ์สุดท้ายใน sandbox จริง รางวัลจะเป็น 1 (ผ่าน) หรือ 0 (ล้มเหลว) โดยส่วนใหญ่มาจากการตรวจสอบสถานะฐานข้อมูลที่แน่นอน และมีส่วนน้อยที่ใช้ LLM judge ช่วยในการตัดสินเกณฑ์เฉพาะด้าน
การรันชุดการฝึกอบรม
โค้ดและข้อมูลที่ใช้ในการฝึกทั้งหมดถูกเผยแพร่ที่ microsoft/thinkingbox-training โดยมีขั้นตอนหลักดังนี้:
- การเตรียมสภาพแวดล้อมด้วย Python 3.12 และ
uvบน Linux/WSL - การติดตั้งและ Patch ชุดเครื่องมือ Verl ตามเวอร์ชันที่กำหนด
- การคัดเลือกงานและรันการฝึกผ่าน Ray cluster
- การประเมินผล Checkpoint ด้วย OpenEnv และ vLLM
ติดตั้ง
mkdir -p ~/thinkingbox-workspace
cd ~/thinkingbox-workspace

git clone https://github.com/microsoft/thinkingbox.git
git clone https://github.com/microsoft/thinkingbox-data.git
git clone --branch main https://github.com/microsoft/thinkingbox-training

git -C thinkingbox checkout 892964e7226044e5463ad188da119df838f4bec1
git -C thinkingbox-data checkout thinkingbox-bench-v1.0
สร้างสภาพแวดล้อมที่ผ่านการรับรอง
cd ~/thinkingbox-workspace/thinkingbox-training

uv venv --python 3.12
source .venv/bin/activate

uv sync --frozen --extra fast --extra tracking --extra eval-proxy
uv pip install -e ../thinkingbox
uv pip install --config-settings editable-mode=compat \
  -e ../thinkingbox-data/servers/thinkingbox_tools
uv pip install --config-settings editable-mode=compat \
  -e ../thinkingbox-data/servers/tb_business_ops_servers_202606

python scripts/prepare_verl.py --dest .deps/verl --install
python scripts/verify_verl_install.py
uv pip check
หลังจากติดตั้งและเตรียมข้อมูลการฝึกแล้ว สามารถเริ่มต้นการฝึกผ่าน Ray cluster โดยระบุพารามิเตอร์การฝึกที่ต้องการผ่านสคริปต์ run_train.sh และประเมินผลด้วยโปรโตคอลการทดสอบ 10,140 รายการตามคู่มือใน repository
ก้าวต่อไปจากนี้
ประโยชน์ที่แท้จริงของงานนี้คือการนำเสนอแนวทางสำหรับผู้ที่พัฒนาเอเจนท์ AI สำหรับงานธุรกิจที่มีสถานะฐานข้อมูลจริง:
- Probe before you train: ตรวจสอบการกระจายความสำเร็จของ base policy ก่อนเพื่อเลือกชุดข้อมูลฝึกที่เหมาะสม
- Check your parity: ตรวจสอบความสอดคล้องของการแยกคำสั่ง (parser) ระหว่างขั้นฝึกและประเมิน
- Report both coverage and repeatability: รายงานผลทั้งความครอบคลุมและขีดความสามารถในการทำซ้ำได้เสมอ
รายละเอียดเพิ่มเติมและโค้ดทั้งหมดสามารถเข้าถึงได้ผ่านลิงก์ในบล็อกและรายงานวิจัยบน arXiv
อ้างอิงรายงานวิจัย
@article{li2026thinkingbox,
  title   = {One Success Isn't Reliability: Thinkingbox, a Sandbox and Benchmark for Agents in Stateful Business Workflows},
  author  = {Li, Zhuochun and Ko, Youngmin and Keramati, Ali and Kundu, Tuhin and
             Tsai, Liang-Chun and Ferri, Nicola | Milletari, Mirco and Liu, Jiaxiang and
             Lopez Pelaez, Susana Palmaz and Wang, Yuepeng and Smolyakov, Vadim and
             Jiang, Xiang and Olafsson, Kjartan and Guy, Tommy},
  journal = {arXiv preprint arXiv:2608.19741},
  year    = {2026},
  url     = {https://arxiv.org/abs/2608.19741}
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร