tag: AI Research

เปิดตัว Project ProtoStar หนุนงานวิจัยภาครัฐให้พร้อมสำหรับ AI

เปิดตัว Project ProtoStar หนุนงานวิจัยภาครัฐให้พร้อมสำหรับ AI

· By: TanasakP
ความร่วมมือครั้งใหญ่ระหว่างมหาวิทยาลัยและองค์กรวิจัย เพื่อขับเคลื่อนงานวิจัยที่ได้ทุนภาครัฐให้ค้นหาง่ายและต่อยอดด้วยเทคโนโลยี AI ได้อย่างมีประสิทธิภาพ
Meta พัฒนา Muse โมเดล AI ช่วยเร่งงานวิจัยสุขภาพให้เร็วขึ้น 10 เท่า

Meta พัฒนา Muse โมเดล AI ช่วยเร่งงานวิจัยสุขภาพให้เร็วขึ้น 10 เท่า

· By: TanasakP
Meta เปิดตัวระบบ AI ที่ควบคุมโดยมนุษย์โดยใช้โมเดล Muse เพื่อเร่งกระบวนการวิจัยด้านสุขภาพในทุกขั้นตอน ช่วยให้นักวิจัยผลิตผลงานคุณภาพสูงได้ภายในเวลาเพียงไม่กี่สัปดาห์
Sakana AI พัฒนาระบบ MLR ตรวจพบข้อผิดพลาดงานวิจัยได้แม่นยำ 73%

Sakana AI พัฒนาระบบ MLR ตรวจพบข้อผิดพลาดงานวิจัยได้แม่นยำ 73%

· By: NatapolK
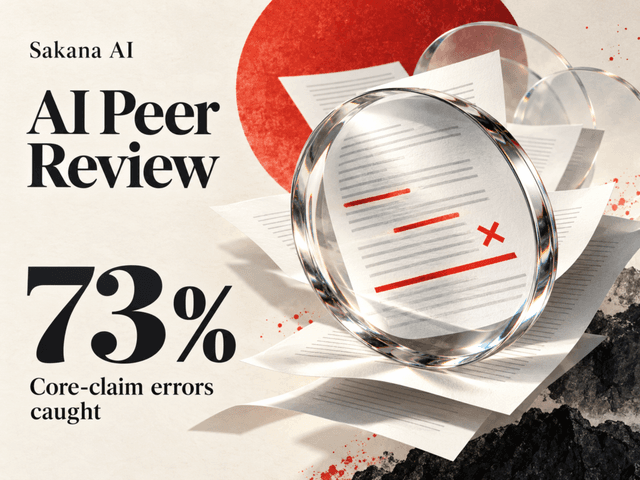
Sakana AI เผยงานวิจัยระบบ Multi-Layered Review (MLR) ที่ใช้เอเจนต์ AI 3 ตัวบนโมเดล Claude สามารถตรวจพบข้อผิดพลาดในข้อกล่าวอ้างหลักของบทความวิจัยได้สูงถึง 73.43% ทิ้งห่างระบบเดิมหลายเท่าตัว
NVIDIA เปิดตัว PivotOPD สอน AI Agent แก้ไขข้อผิดพลาดและกู้คืนสถานการณ์

NVIDIA เปิดตัว PivotOPD สอน AI Agent แก้ไขข้อผิดพลาดและกู้คืนสถานการณ์

· By: AttapolK
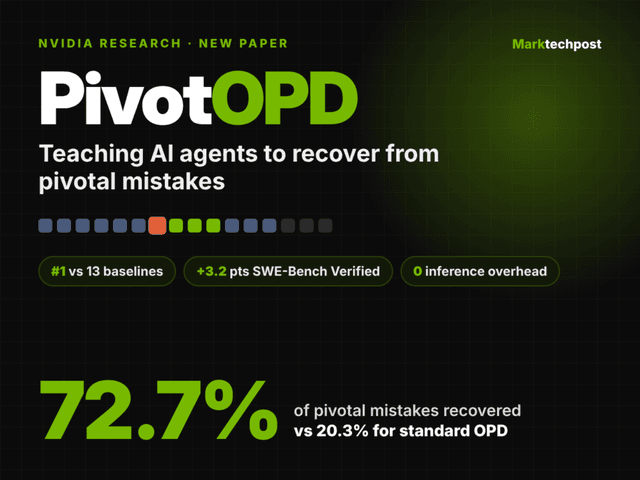
นักวิจัย NVIDIA พัฒนา PivotOPD วิธีการฝึกสอน LLM agent ให้รู้จักหลีกเลี่ยงข้อผิดพลาดสำคัญและกู้คืนสถานการณ์ได้สำเร็จ โดยทำคะแนนสูงสุดเมื่อเทียบกับ 13 baselines ในชุดทดสอบมาตรฐาน
NVIDIA ปั้น Nemotron คว้าเหรียญทองโอลิมปิกวิชาการทั้ง IOI และ IMO

NVIDIA ปั้น Nemotron คว้าเหรียญทองโอลิมปิกวิชาการทั้ง IOI และ IMO

· By: SirilukP
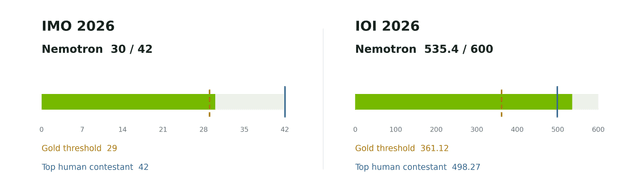
ทีมวิจัยประสบความสำเร็จในการพัฒนาโมเดล Nemotron 3 ผ่านกระบวนการ SFT และ RL จนสามารถทำคะแนนระดับเหรียญทองในการแข่งขันคอมพิวเตอร์และคณิตศาสตร์โอลิมปิกระหว่างประเทศปี 2026
Meta ผนึกกำลังนักคณิตศาสตร์ ใช้ Muse Spark แก้โจทย์วิจัยระดับโลก

Meta ผนึกกำลังนักคณิตศาสตร์ ใช้ Muse Spark แก้โจทย์วิจัยระดับโลก

· By: TanasakP
นักคณิตศาสตร์ร่วมกับ AI โมเดล Muse Spark ประสบความสำเร็จในการสร้างสรรค์บทความวิจัย 6 ฉบับ ซึ่งส่วนใหญ่เป็นการไขคำตอบสำหรับโจทย์คณิตศาสตร์ที่เคยเป็นปัญหาเปิดมาอย่างยาวนาน
ผลวิจัยชี้การเข้าถึง AI ทำให้คนแทบไม่กล้าตอบว่า "ไม่รู้"

ผลวิจัยชี้การเข้าถึง AI ทำให้คนแทบไม่กล้าตอบว่า "ไม่รู้"

· By: SirilukP
การศึกษาพบว่าการเข้าถึง AI เกือบจะทำลายความเต็มใจของคนในการกล่าวคำว่าไม่รู้ โดยผู้เข้าร่วมยอมเชื่อ AI แม้ข้อมูลจะผิดเกือบทั้งหมด ส่งผลให้ความมั่นใจพุ่งสูงขึ้นแต่ความถูกต้องกลับลดฮวบลง
DeepMind ปรับทิศทางใหม่ มุ่งส่ง Gemini 4 ลุยตลาดแทนพันธกิจ AGI

DeepMind ปรับทิศทางใหม่ มุ่งส่ง Gemini 4 ลุยตลาดแทนพันธกิจ AGI

· By: SirilukP
Koray Kavukcuoglu หัวหน้าคนใหม่ของ Google DeepMind เร่งเครื่องเตรียมปล่อย Gemini 4 ภายในสิ้นปีนี้ พร้อมเปลี่ยนจุดยืนจากการไล่ตาม AGI สู่การพัฒนาเอเจนท์อัจฉริยะเชิงพาณิชย์เพื่อสู้ศึก OpenAI และ Anthropic
OpenAI เผยโมเดลลับแก้โจทย์คณิตศาสตร์ค้างคาได้กว่า 100 ข้อในเดือนเดียว

OpenAI เผยโมเดลลับแก้โจทย์คณิตศาสตร์ค้างคาได้กว่า 100 ข้อในเดือนเดียว

· By: AttapolK
OpenAI เปิดตัวโมเดลภายในที่สามารถแก้โจทย์คณิตศาสตร์ปลายเปิดได้มหาศาล พร้อมจัดตั้งกลุ่มที่ปรึกษาอิสระเพื่อลดแรงเสียดทานจากนักวิชาการที่กังวลว่า AI จะทำลายหัวใจสำคัญของคณิตศาสตร์
Anthropic เผย Claude 'เป็นผู้นำ' งานวิจัย 26% ท่ามกลางนิยามที่ยังคลุมเครือ

Anthropic เผย Claude 'เป็นผู้นำ' งานวิจัย 26% ท่ามกลางนิยามที่ยังคลุมเครือ

· By: SirilukP
Anthropic เปิดตัวชี้วัดความเร็วในการพัฒนา AI พบว่า Claude รับบทผู้นำในงานวิจัยเพิ่มขึ้นอย่างก้าวกระโดด แต่ถูกตั้งคำถามเรื่องความแม่นยำและการให้คะแนนตัวเองของโมเดล
HarnessDev เผยศักยภาพ LLM ในการออกแบบ Agent Harness: พัฒนาเองได้ดีเทียบเท่ามนุษย์ในบางด้าน แต่ผลลัพธ์ยังไม่เสถียร

HarnessDev เผยศักยภาพ LLM ในการออกแบบ Agent Harness: พัฒนาเองได้ดีเทียบเท่ามนุษย์ในบางด้าน แต่ผลลัพธ์ยังไม่เสถียร

· By: NatapolK
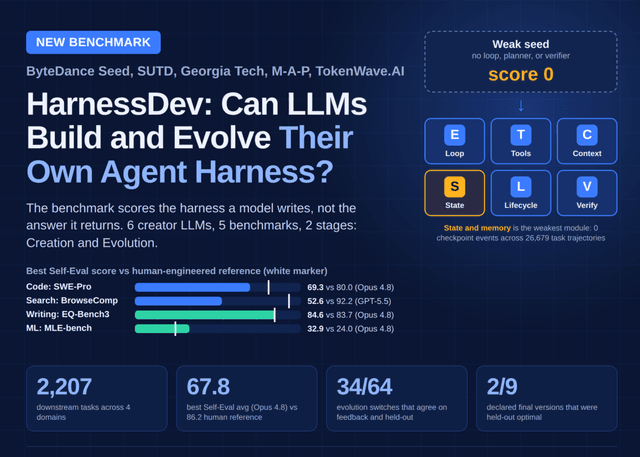
ทีมนักวิจัยจาก ByteDance Seed และพันธมิตรเปิดตัว HarnessDev เกณฑ์วัดผลแนวใหม่ที่เน้นประเมินโค้ด Harness ที่ LLM สร้างขึ้นเอง พบว่าโมเดลเริ่มทำผลงานได้ใกล้เคียงมนุษย์ในงานเขียนและงานทดลอง ML แต่ยังคงมีปัญหาด้านความแม่นยำและการนำไปใช้จริงในระยะยาว
เจาะลึก OpenAI: Coding Agents กำลังเปลี่ยนโฉมงานวิจัยสู่ยุค AI อัตโนมัติ

เจาะลึก OpenAI: Coding Agents กำลังเปลี่ยนโฉมงานวิจัยสู่ยุค AI อัตโนมัติ

OpenAI เผยข้อมูลการใช้เอเจนต์ช่วยเขียนโค้ดเพื่อเร่งความเร็วในการวิจัย AI โดยมุ่งเป้าพัฒนา 'นักวิจัย AI อัตโนมัติ' ภายในปี 2028 ภายใต้มาตรการความปลอดภัยที่เข้มงวด
ถอดบทเรียนการใช้ AI ทำซ้ำงานวิจัย 2,200 ฉบับจาก ICML: เมื่อ Agent กลายเป็นผู้ตรวจสอบความถูกต้อง

ถอดบทเรียนการใช้ AI ทำซ้ำงานวิจัย 2,200 ฉบับจาก ICML: เมื่อ Agent กลายเป็นผู้ตรวจสอบความถูกต้อง

· By: TanasakP
สรุปผลงาน Hackathon ที่ใช้ Coding Agents ตรวจสอบงานวิจัยใน ICML 2026 พบว่า 51% ยืนยันผลได้จริง แต่ 23% พบข้อผิดพลาดหรือถูกโต้แย้ง พร้อมชี้ให้เห็นถึงบทบาทใหม่ของมนุษย์ในการควบคุม AI เพื่อยกระดับความน่าเชื่อถือทางวิทยาศาสตร์