
NVIDIA ปั้น Nemotron คว้าเหรียญทองโอลิมปิกวิชาการทั้ง IOI และ IMO
การแข่งขันคอมพิวเตอร์โอลิมปิกระหว่างประเทศ (IOI) และคณิตศาสตร์โอลิมปิกระหว่างประเทศ (IMO) ล้วนทดสอบทักษะที่แตกต่างกันอย่างสุดขั้ว โดย IOI เน้นการสร้างอัลกอริทึมและโค้ดภายใต้ข้อจำกัดที่เข้มงวด ส่วน IMO เน้นการพิสูจน์ทางคณิตศาสตร์ด้วยภาษาธรรมชาติที่รัดกุม ความสำเร็จในรายการใดรายการหนึ่งก็นับว่ายากแล้ว แต่การพิชิตทั้งสองรายการได้พร้อมกันคือข้อพิสูจน์ถึงศักยภาพที่เหนือชั้น
ผลลัพธ์ล่าสุดแสดงให้เห็นว่า Nemotron เป็นโมเดลพื้นฐานที่แข็งแกร่งและปรับตัวได้ดีเยี่ยม ทีมวิจัยเริ่มต้นจาก Nemotron 3 โดยใช้การปรับจูนแบบมีผู้สอน (SFT), การเรียนรู้แบบเสริมกำลัง (RL) และระบบการอนุมานที่ขับเคลื่อนด้วยผลป้อนกลับ จนสามารถพัฒนาระบบที่คว้าเหรียญทองได้ทั้งใน IMO 2026 และ IOI 2026
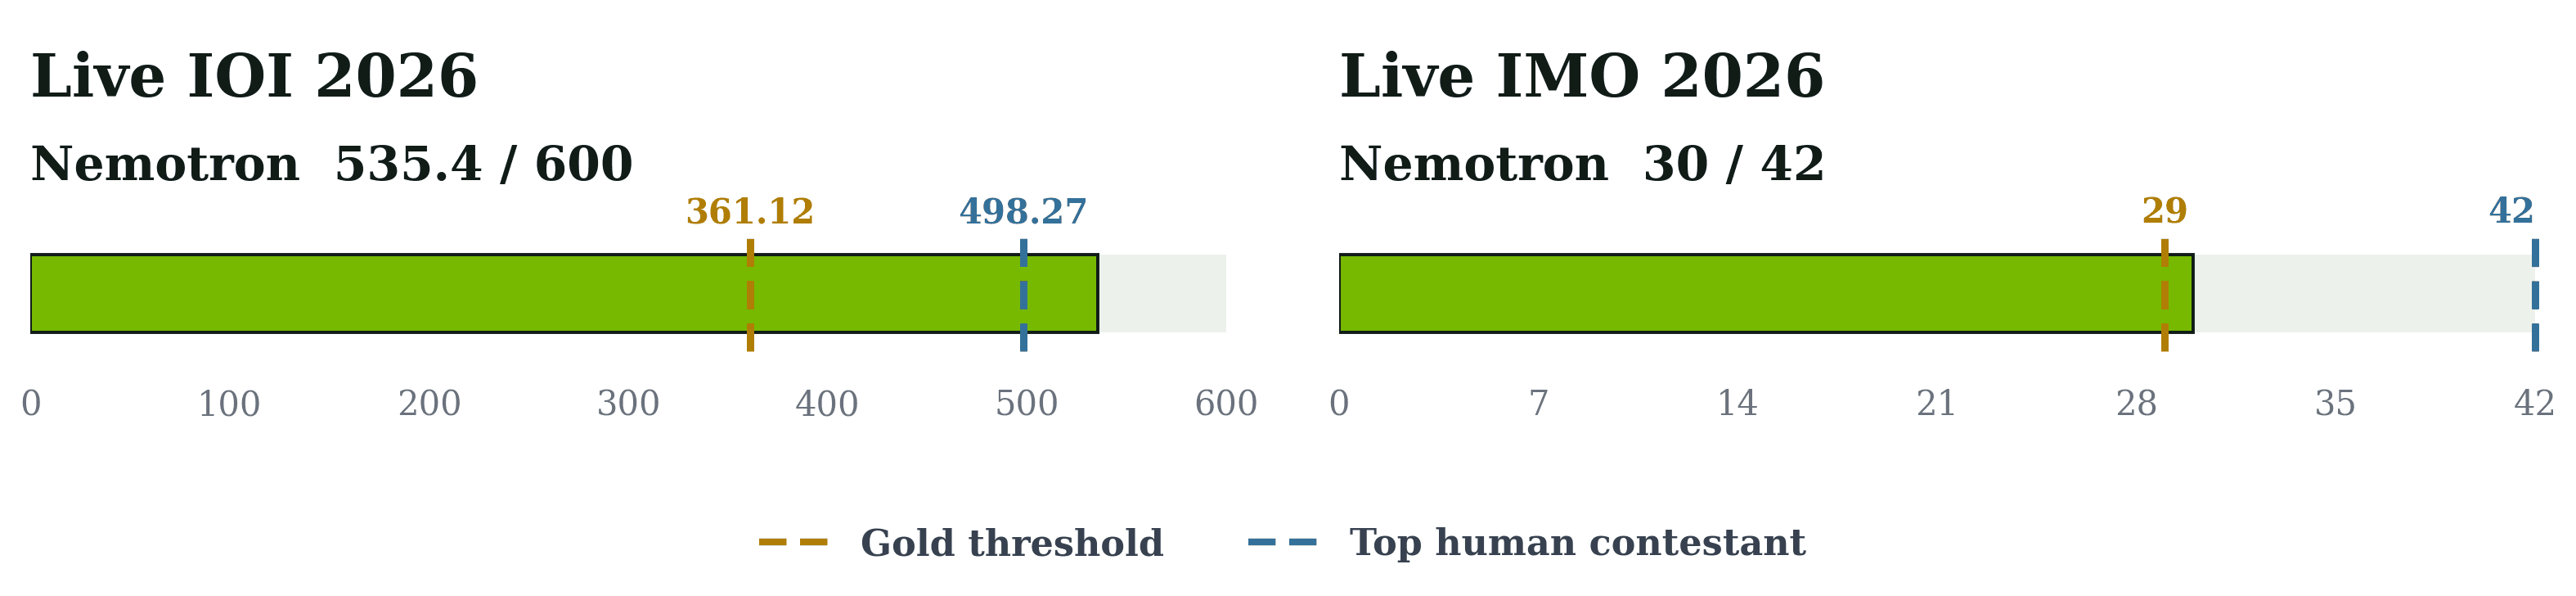
| การแข่งขัน | การปรับเฉพาะทางของ Nemotron | ผลลัพธ์ |
|---|---|---|
| IOI 2026 | Nemotron-3-Ultra-CC พร้อม SFT และ GenCorrect | 535.4/600, สูงกว่าเกณฑ์เหรียญทองที่ 361.12 และสูงกว่าคะแนนสูงสุดของมนุษย์ที่ 498.27 |
| IMO 2026 | Nemotron 3 Ultra รุ่นทั่วไป, SFT และ RL checkpoints ในระบบ generate-verify-refine | 30/42, สูงกว่าเกณฑ์เหรียญทองอย่างเป็นทางการที่ 29 |
ผลลัพธ์ของ IOI มาจากการรันระบบแบบสดๆ ภายใต้ข้อจำกัดเดียวกับมนุษย์ ทั้งเรื่องเวลาและการเข้าถึงอินเทอร์เน็ต แม้จะเป็นเกณฑ์มาตรฐานที่ไม่เป็นทางการ แต่สำหรับ IMO บทพิสูจน์ที่ระบบส่งเข้าไปนั้นได้รับการตรวจให้คะแนนโดยคณะกรรมการผู้ให้คะแนนของ IMO อย่างเป็นทางการ
สูตรการปรับเฉพาะทางที่นำกลับมาใช้ใหม่ได้
หัวใจสำคัญของโปรเจกต์นี้คือการพิสูจน์ว่าโมเดลพื้นฐานที่ดีควรถูกปรับให้เข้ากับโดเมนที่ยากเป็นพิเศษได้ด้วยสูตรที่ชัดเจน โดยสูตรดังกล่าวประกอบด้วย 4 ส่วนสำคัญ ได้แก่ การเริ่มจากโมเดลฐาน Nemotron ที่แข็งแกร่ง, คัดสรรชุดข้อมูลเฉพาะทางที่มีคุณภาพ, ใช้วิธีการหลังการฝึกฝนมาตรฐาน (SFT/RL) และจับคู่โมเดลเข้ากับวงจรการอนุมาน (Inference Loop) เพื่อประเมินและปรับปรุงคำตอบ
แนวทางนี้เน้นย้ำว่าเราไม่จำเป็นต้องสร้างโมเดลพื้นฐานใหม่สำหรับทุกความท้าทาย แต่เราสามารถปรับ Nemotron ให้เฉพาะทางสำหรับงานนั้นๆ ได้ผ่านกระบวนการที่ทำซ้ำได้และเป็นระบบ
จากการเขียนโค้ดทั่วไปสู่เหรียญทอง IOI
สำหรับการแข่งขันเขียนโปรแกรม ทีมวิจัยคัดสรรโจทย์กว่า 22,000 ข้อเพื่อฝึกฝนผู้เชี่ยวชาญสองรุ่น คือ Nemotron-3-Nano-CC และ Nemotron-3-Ultra-CC โดยรุ่น Ultra-CC ที่มีพารามิเตอร์สูงถึง 5.5 แสนล้านตัว สามารถทำคะแนนได้ถึง 535.4 จาก 600 คะแนน เมื่อใช้ร่วมกับกลยุทธ์ GenCorrect ซึ่งเป็นการทำงานแบบสร้าง-ประเมิน-ปรับปรุง
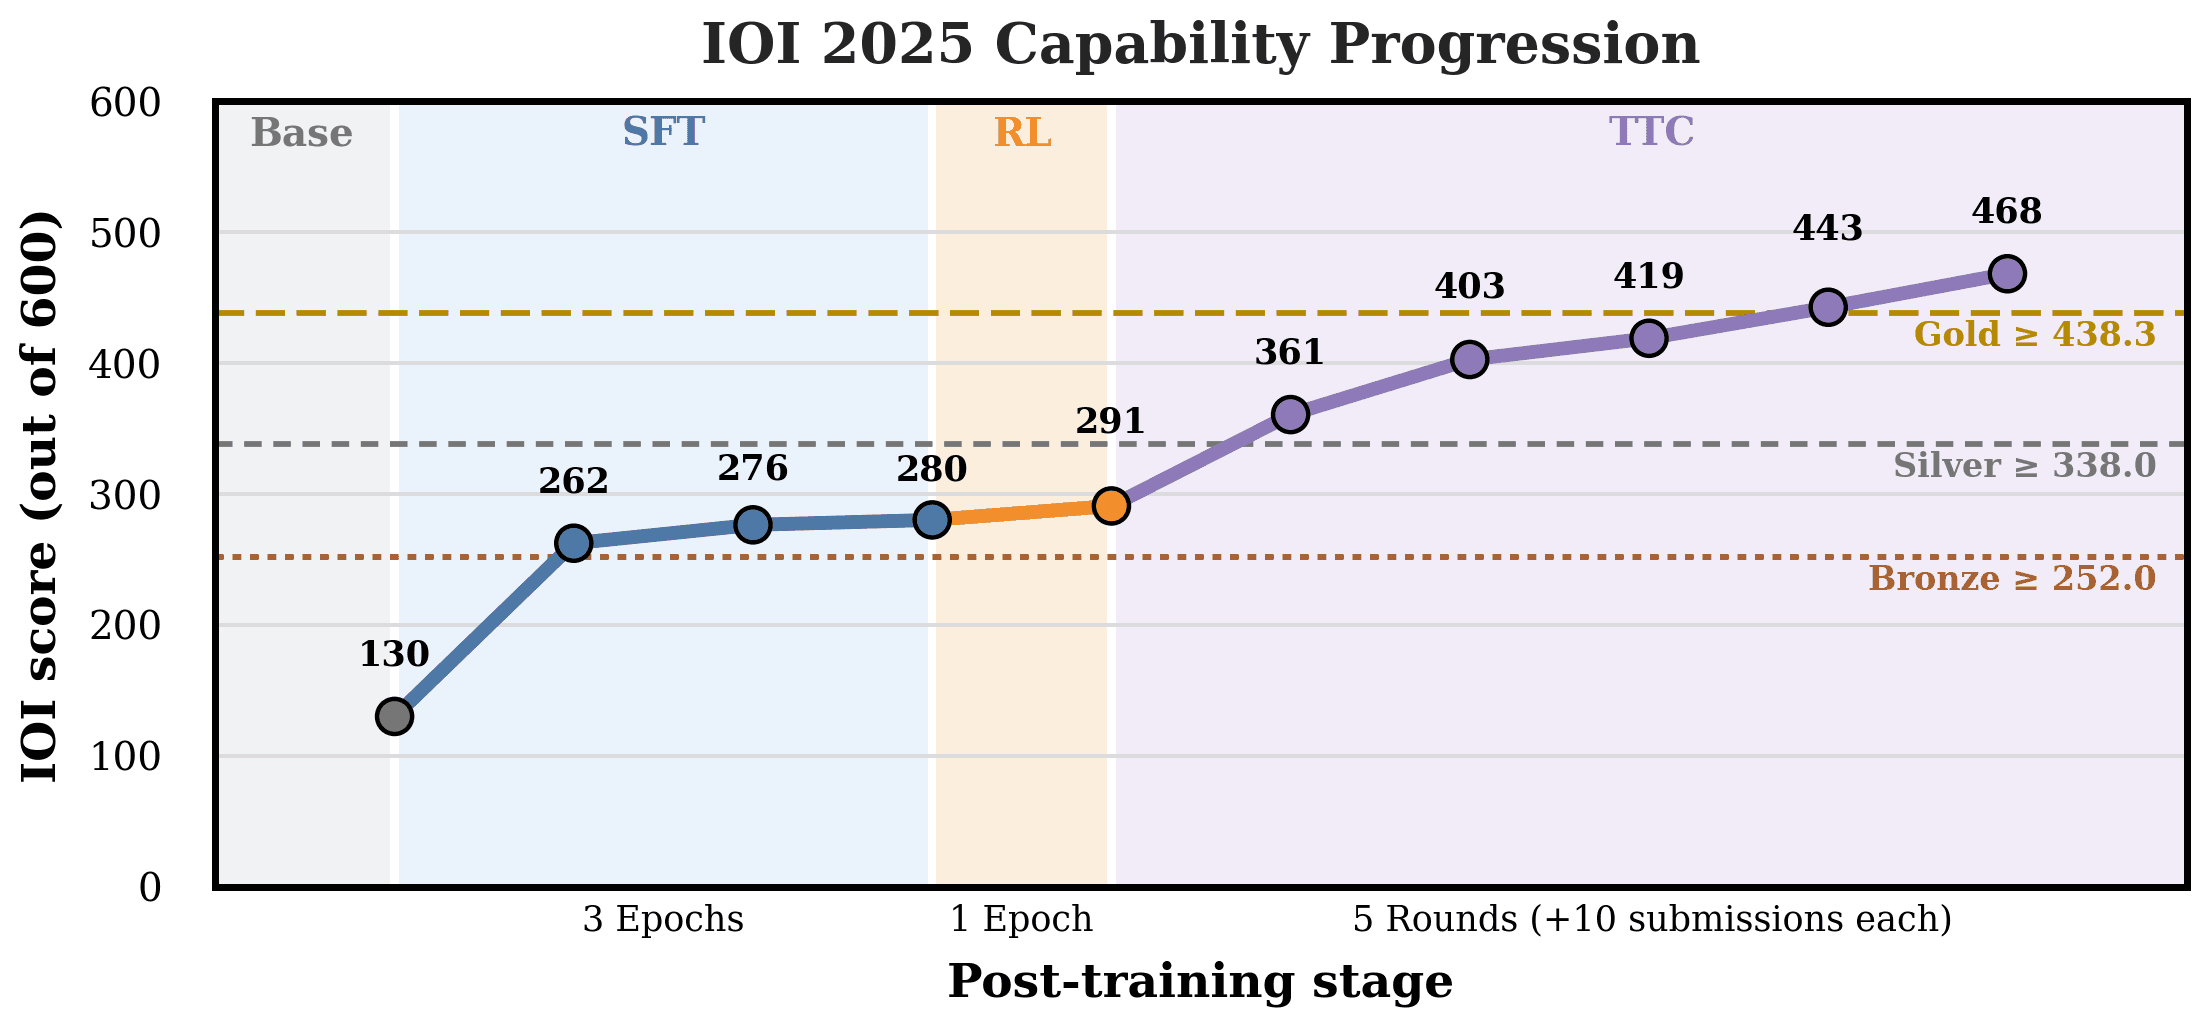
การทดสอบยังพบว่า SFT เป็นกุญแจสำคัญที่ช่วยเพิ่มประสิทธิภาพในช่วงแรกได้อย่างมหาศาล ขณะที่ RL เข้ามาช่วยปรับปรุงในส่วนเล็กๆ อย่างสม่ำเสมอ ข้อค้นพบนี้ทำให้ระบบ Ultra-CC เฉพาะกิจมีประสิทธิภาพเหนือกว่าโมเดลอื่นๆ ทั้งในรายการ IOI, ICPC และ LiveCodeBench Pro
สอนให้ Nemotron พิสูจน์ ตรวจสอบ และแก้ไข
ในด้านคณิตศาสตร์โอลิมปิก ทีมวิจัยได้ฝึกฝน Nemotron 3 Ultra ด้วยชุดข้อมูล SFT กว่า 4 แสนตัวอย่าง เพื่อสอนให้โมเดลไม่เพียงแค่หาคำตอบ แต่ยังรวมถึงการสร้างข้อโต้แย้ง ระบุช่องโหว่ และตรวจสอบความสมบูรณ์ของบทพิสูจน์ โดยมีโมเดล RL ที่ถูกฝึกด้วยโจทย์ระดับยากเข้ามาเสริมความแข็งแกร่ง
ระบบสุดท้ายทำงานด้วยภาษาธรรมชาติทั้งหมดโดยไม่มีเครื่องมือช่วยภายนอก ระบบจะสร้างบทพิสูจน์ ให้คะแนน และปรับแต่งความพยายามที่มีแนวโน้มดีที่สุด จนสามารถทำคะแนนได้ 30 จาก 42 คะแนน และได้คะแนนเต็มในโจทย์ 4 ข้อจากทั้งหมด 6 ข้อ
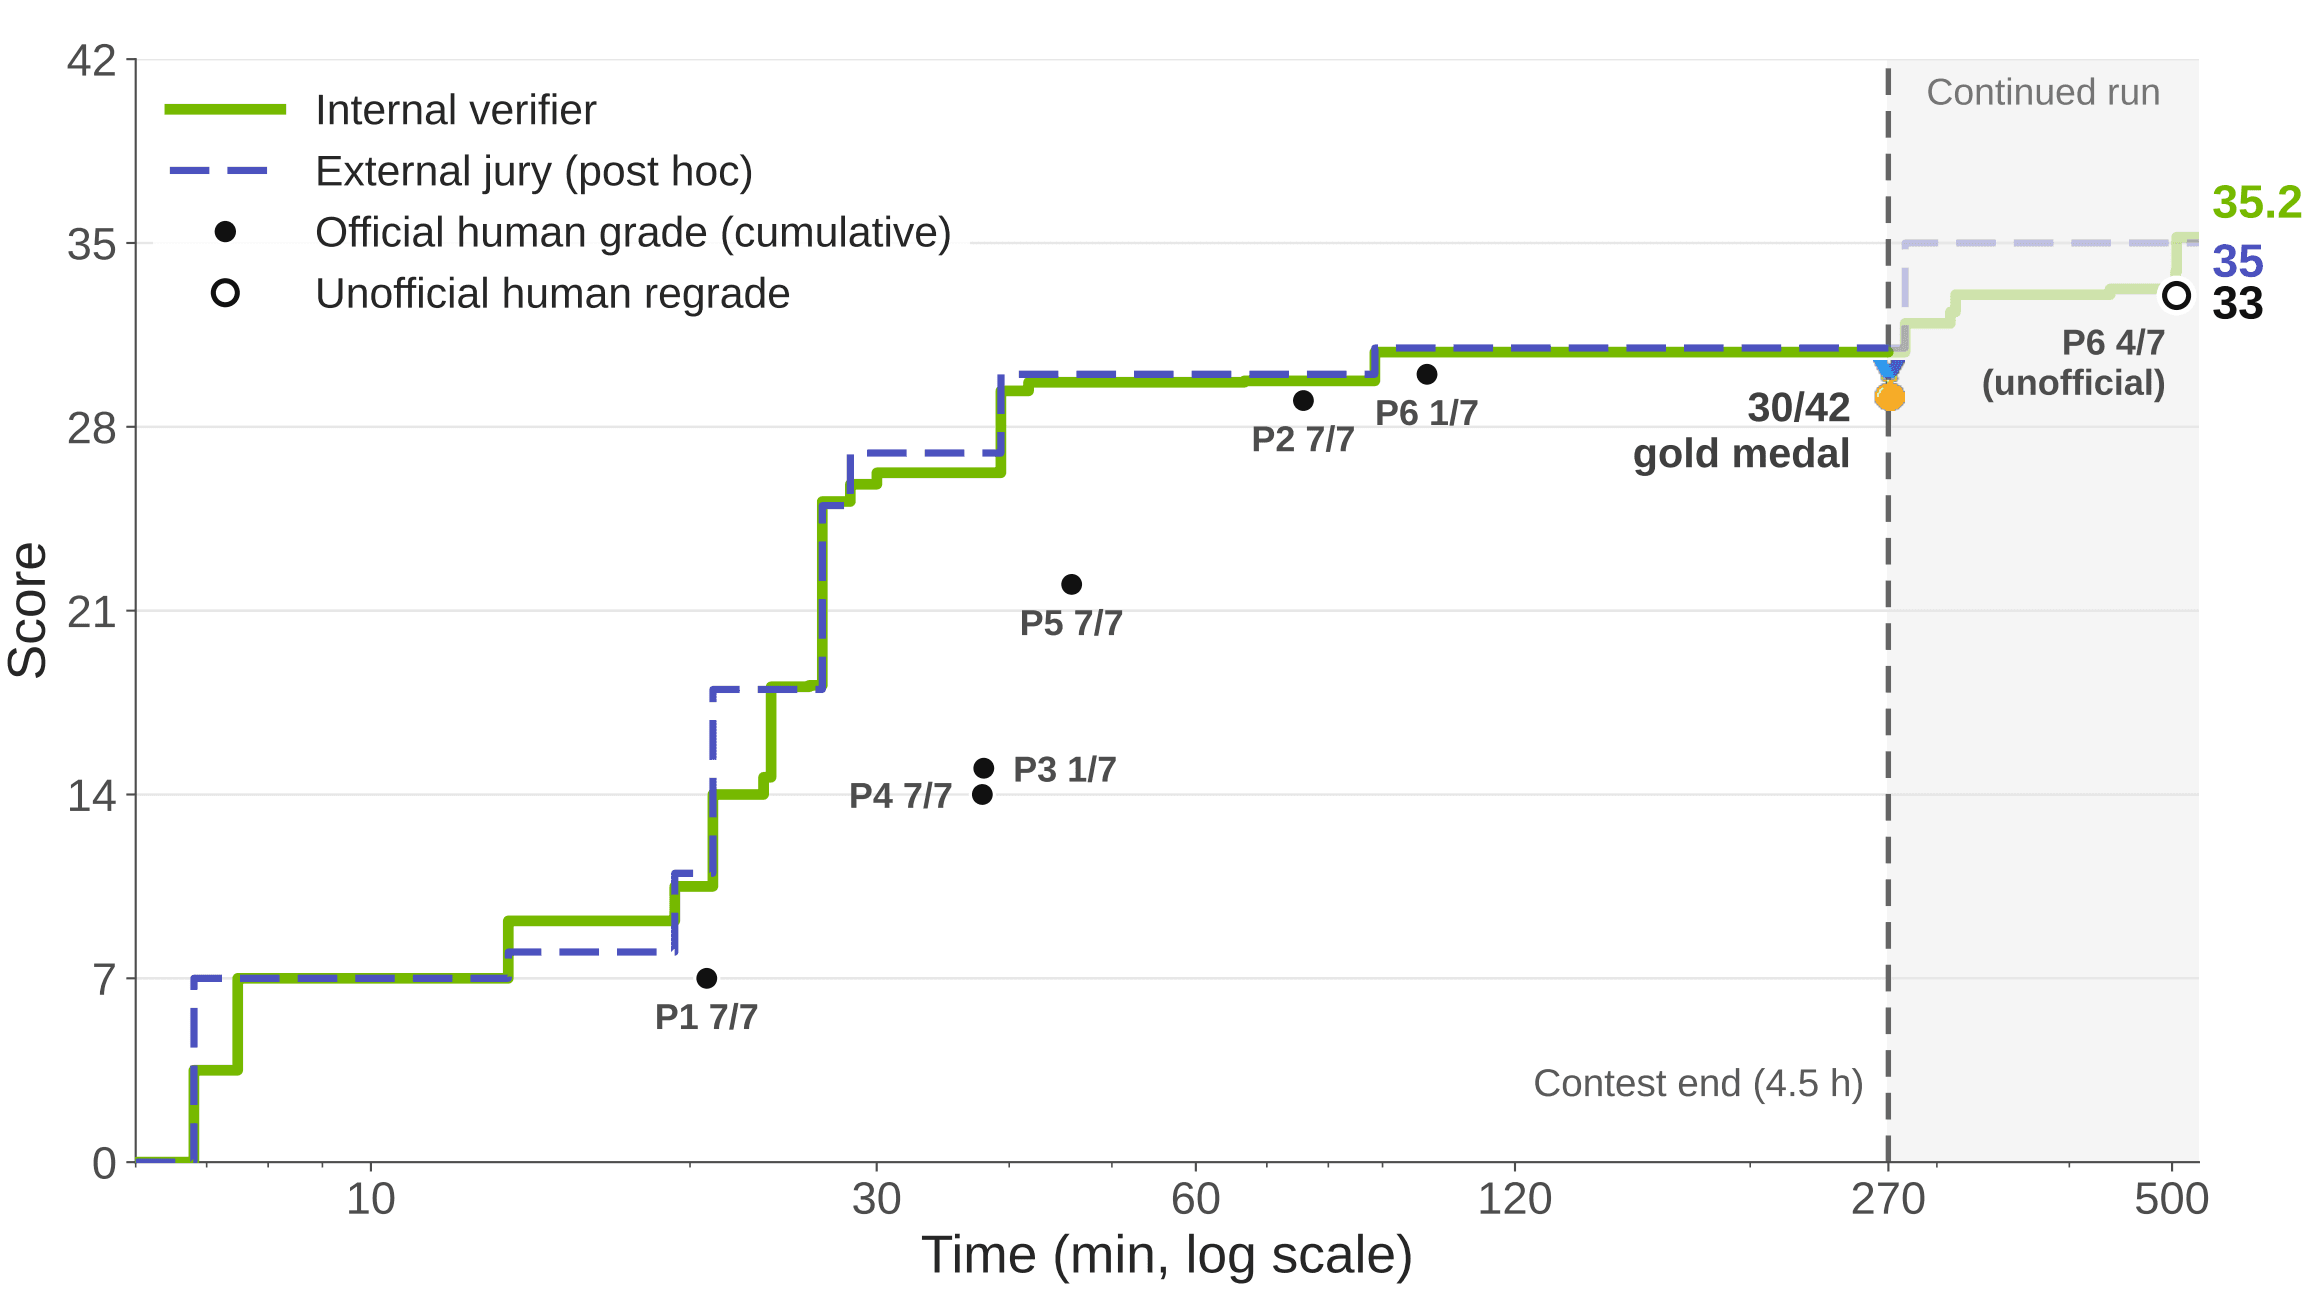
พลังผสานของการ Fine-tuning และการคำนวณช่วงเวลาทดสอบ
ความสำเร็จนี้ชี้ให้เห็นว่าเหรียญทองไม่ได้เกิดจากการปรับจูนหรือการสุ่มตัวอย่างแบบใช้แรงเข้าว่าเพียงอย่างเดียว แต่มาจากการออกแบบร่วมกันระหว่างโมเดล ข้อมูล และระบบการอนุมานที่มีประสิทธิภาพ การปรับเฉพาะทางช่วยให้ระบบมี "ตัววิจารณ์" และ "ตัวเลือก" ที่ดีขึ้น ส่งผลให้การแก้ปัญหาที่ซับซ้อนเป็นไปได้จริง
เปิดข้อมูลสู่สาธารณะผ่าน Hugging Face เพื่อเป็นประโยชน์ต่อชุมชนนักพัฒนา NVIDIA ได้เผยแพร่ คอลเลกชัน Nemotron Labs IMO 2026 ซึ่งรวมทั้ง Checkpoint, ชุดข้อมูล และเกณฑ์มาตรฐานใหม่ไว้บน Hugging Face รวมถึงเผยแพร่บทความวิจัยและสูตรการฝึกฝนใน NeMo-Skills เพื่อให้ทุกคนสามารถนำไปศึกษาและต่อยอดได้ต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร