
HarnessDev เผยศักยภาพ LLM ในการออกแบบ Agent Harness: พัฒนาเองได้ดีเทียบเท่ามนุษย์ในบางด้าน แต่ผลลัพธ์ยังไม่เสถียร
Agent Harness คือชุดโค้ดพื้นฐานที่ควบคุมการทำงานรอบตัวโมเดล ไม่ว่าจะเป็นลูปการประมวลผล เครื่องมือ บริบท ไปจนถึงการกู้คืนระบบ ข้อมูลจากตารางอันดับของ Terminal-Bench 2.1 ชี้ให้เห็นว่าโครงสร้าง Harness ที่ต่างกันส่งผลต่อประสิทธิภาพอย่างมาก โดย GPT-5 สามารถแก้โจทย์ได้ 35.2% เมื่ออยู่บน Terminus 2 แต่พุ่งสูงถึง 49.6% บน Codex CLI แม้จะใช้โมเดลตัวเดิม
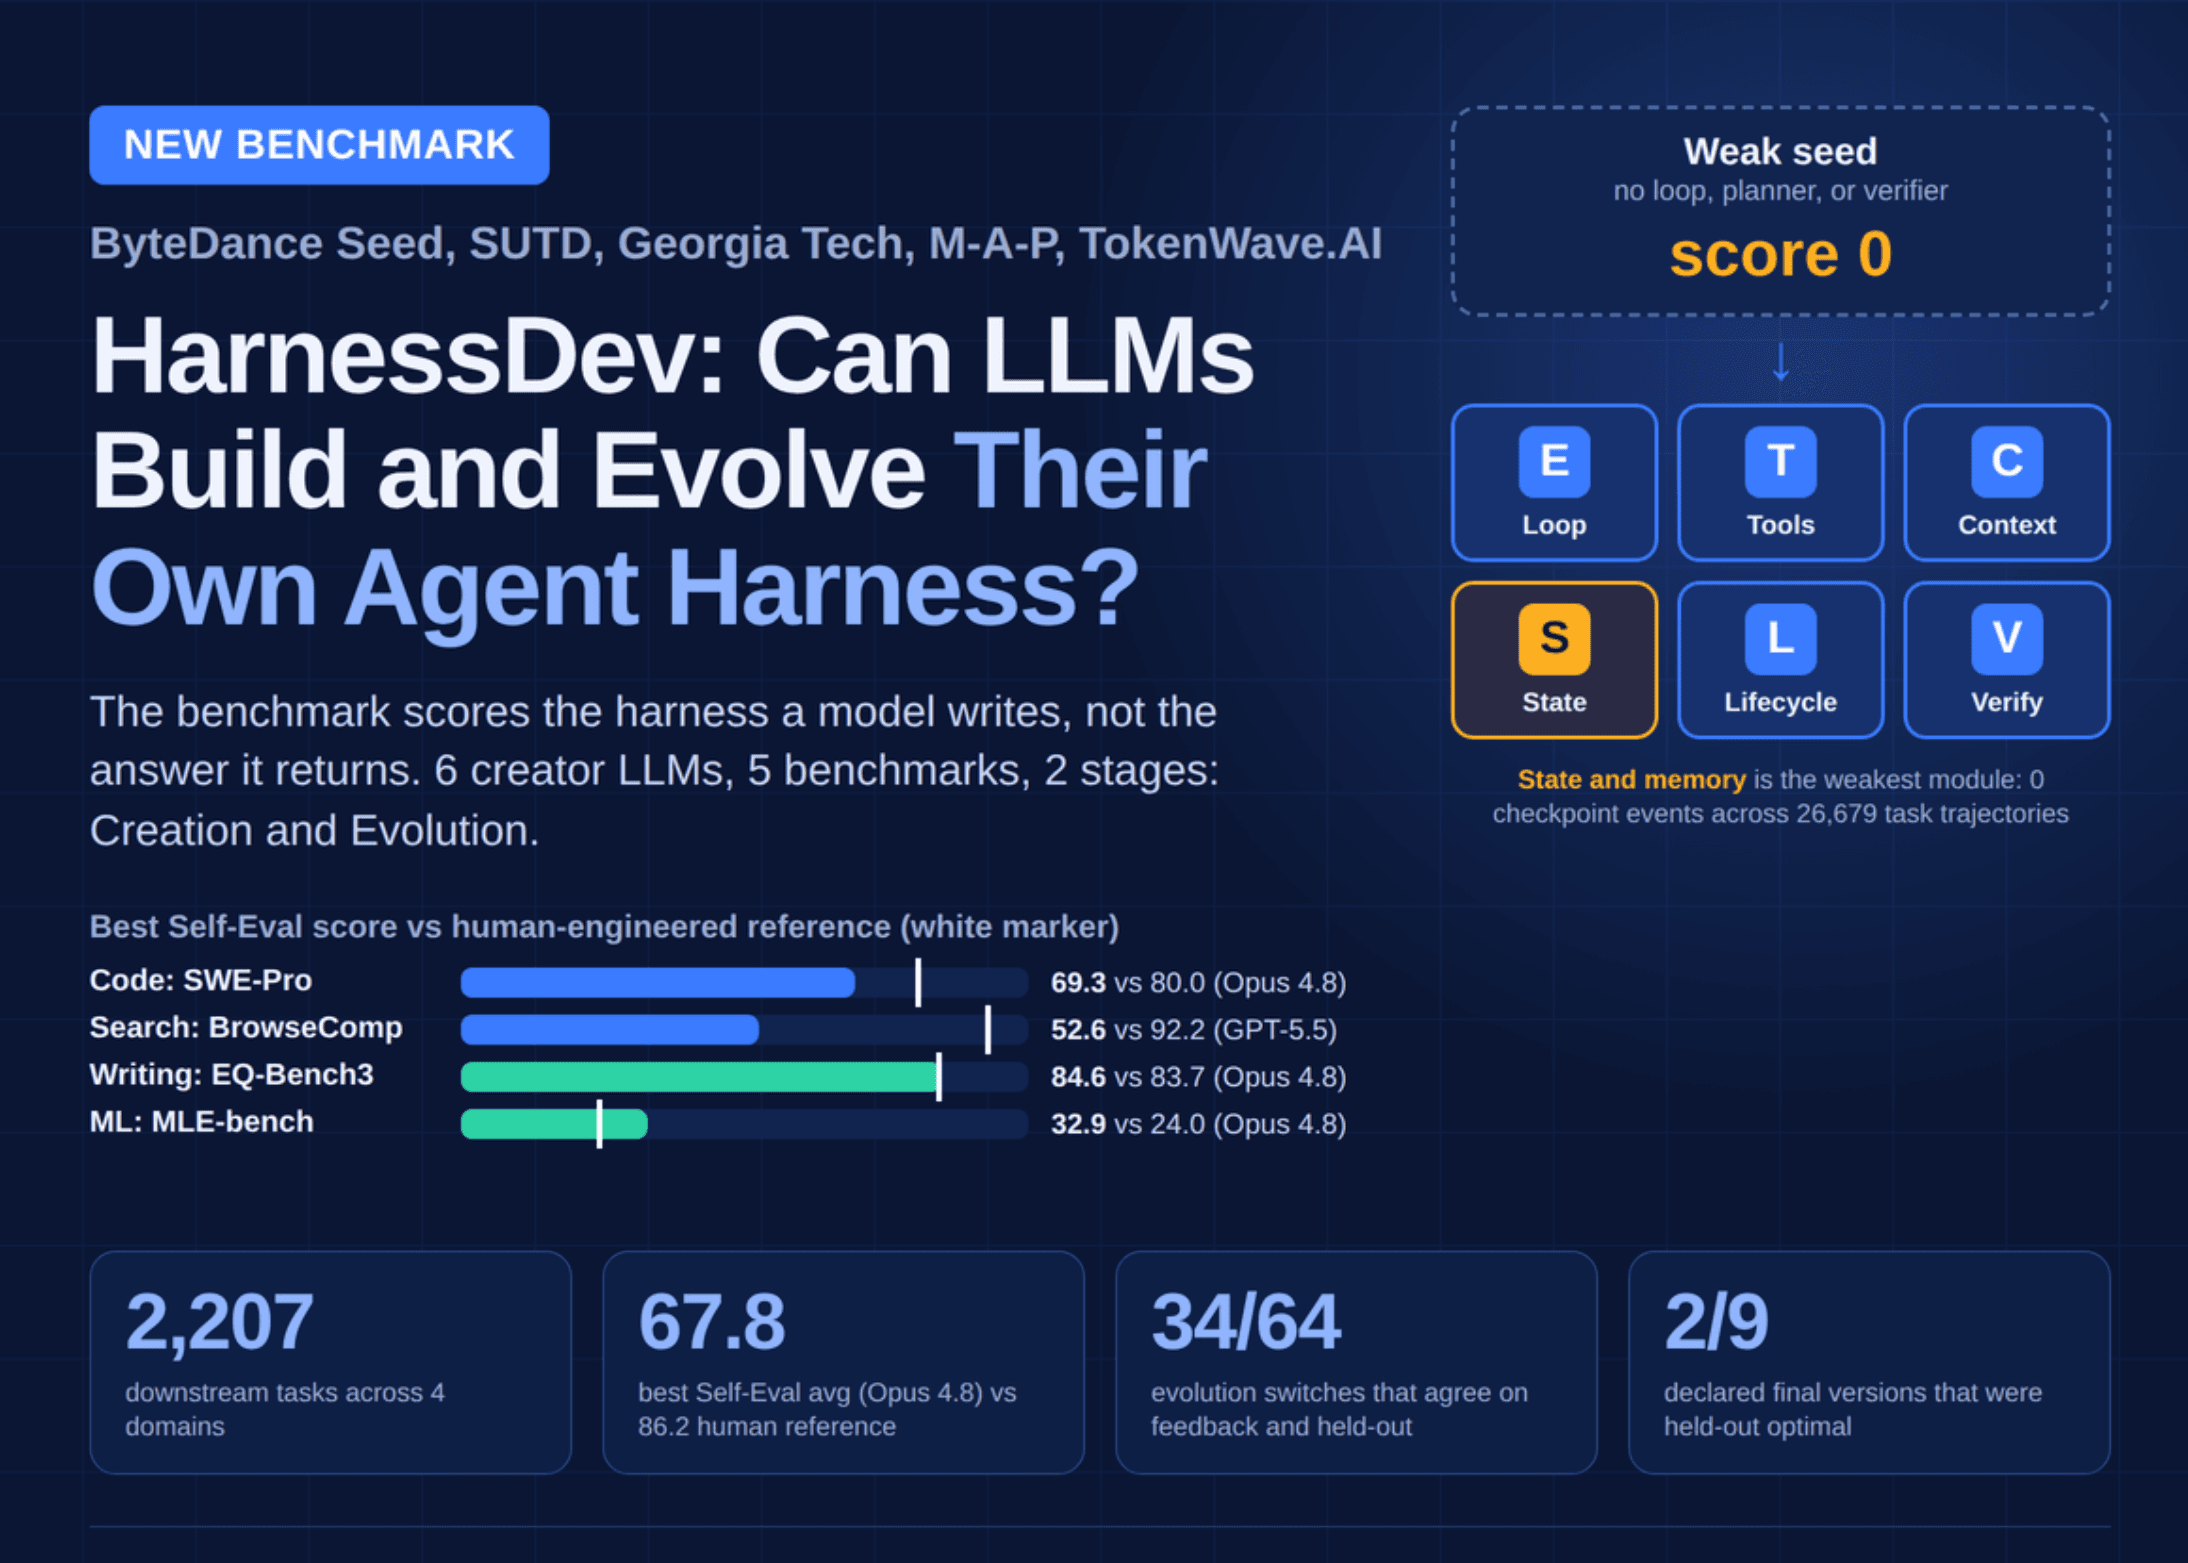
ด้วยเหตุนี้ เกณฑ์มาตรฐาน HarnessDev ที่พัฒนาโดย ByteDance Seed ร่วมกับ SUTD, Georgia Tech, M-A-P และ TokenWave.AI จึงถูกออกแบบมาเพื่อประเมิน "ความสามารถในการสร้าง Runnable Harness" ของโมเดลโดยเฉพาะ แทนที่จะวัดผลแค่คำตอบสุดท้ายเพียงอย่างเดียว
2 ขั้นตอนสำคัญ: การสร้าง (Creation) และวิวัฒนาการ (Evolution)
กระบวนการทดสอบเริ่มจากขั้นตอน Creation ซึ่งโมเดลจะได้รับเพียงไฟล์พื้นฐาน (Seed) ที่ไม่สามารถทำงานเองได้ หากไม่มีการแก้ไขจะได้คะแนนเป็น 0 โมเดลต้องสร้าง Harness ที่สมบูรณ์จากข้อกำหนดและกรณีตัวอย่างที่ได้รับ ก่อนจะถูกแช่แข็งโค้ดเพื่อนำไปทดสอบกับโจทย์ที่ถูกซ่อนไว้
ต่อมาคือขั้นตอน Evolution โมเดลจะนำโค้ดที่สร้างไว้มาปรับปรุงต่อโดยใช้ผลตอบรับจากการรันจริงในชุดงาน SWE-bench Pro และ Terminal-Bench 2.1 โดยมีการกำหนดงบประมาณในการทดสอบและปรับปรุงอย่างจำกัด เพื่อดูว่าโมเดลสามารถเรียนรู้และพัฒนาเครื่องมือของตนเองได้ดีเพียงใด ซึ่งผลลัพธ์จะถูกตัดสินจากความสำเร็จของงานและประสิทธิภาพในการใช้ Token
การตั้งค่าการทดสอบ
การทดลองนี้รวบรวม 6 โมเดลชั้นนำ ได้แก่ Opus 4.8, GPT-5.5, Gemini 3.1 Pro, DeepSeek V4 Pro, Qwen 3.7 Max และ Seed 2.0 Pro ทำงานบนสภาพแวดล้อมที่ต่างกัน ครอบคลุม 5 เกณฑ์มาตรฐาน รวมกว่า 2,207 งานวิจัย เช่น MLE-bench, EQ-Bench3 และ BrowseComp โดยมีการวัดผลทั้งแบบประเมินตนเอง (Self-Eval) และประเมินด้วยโมเดลกลาง (Unified-Eval)
ผลลัพธ์การสร้าง (Creation results)
จากการประเมินตนเอง พบว่า Opus 4.8 ทำคะแนนเฉลี่ยสูงสุดที่ 67.8 แม้จะยังตามหลังเกณฑ์ที่มนุษย์สร้างขึ้น (86.2) แต่ผลลัพธ์ในแต่ละโดเมนมีความน่าสนใจต่างกัน
- ด้านโค้ด: Opus 4.8 ทำได้ 69.3 ใน SWE-Pro (มนุษย์ทำได้ 80.0) ขณะที่ Gemini 3.1 Pro นำใน Terminal-Bench
- ด้านการค้นหา: มีช่องว่างกว้างที่สุด โดย GPT-5.5 ทำได้เพียง 52.6 เทียบกับมนุษย์ที่ 92.2
- ด้านการเขียน: Opus 4.8 ทำได้ 84.6 ซึ่งสูงกว่าเกณฑ์ของมนุษย์เล็กน้อย
- ด้านการทดลอง ML: ทั้ง Opus 4.8 และ Gemini สามารถเอาชนะเกณฑ์อ้างอิงเดิมของ MLE-bench ได้สำเร็จ
อย่างไรก็ตาม ปริมาณโค้ดที่โมเดลเขียนไม่ได้สะท้อนถึงคุณภาพเสมอไป พบว่าฟีเจอร์ที่สร้างขึ้นจำนวนมากกลายเป็น "Dead Code" หรือโค้ดที่ไม่ได้ถูกใช้งานจริง โดยเฉพาะในส่วนการจัดการ State และ Memory ที่นิยามไว้แต่ไม่เคยถูกเรียกใช้ตลอดการทำงานกว่า 26,000 เส้นทาง
ต้นทุนและการเปลี่ยนตัวประมวลผล (executor transfer)
ความคุ้มค่าเป็นอีกประเด็นที่น่าจับตา GPT-5.5 ใช้อัตรา Token เพียง 29.3 ล้านเพื่อสร้างผลสำเร็จใกล้เคียงกับ DeepSeek V4 ที่ใช้ถึง 208.4 ล้าน Token นอกจากนี้ ประสิทธิภาพของ Harness ยังยึดติดกับตัวประมวลผลเดิมอย่างมาก เมื่อสลับจากสภาพแวดล้อมเดิมมาเป็น Gemini คะแนนของ Opus 4.8 ใน SWE-Pro ร่วงดิ่งจาก 69.3 เหลือเพียง 33.0 เนื่องจากการตั้งค่าบางอย่างถูก Hard-code ไว้กับระบบเดิม
ผลลัพธ์วิวัฒนาการ (Evolution results)
ในขั้นตอนการพัฒนาต่อยอด พบว่ามีเพียง 34 จาก 64 การเปลี่ยนแปลง (53.1%) เท่านั้นที่ให้ผลไปในทิศทางเดียวกันเมื่อนำไปใช้กับชุดทดสอบภายนอก หลายครั้งที่โมเดลพยายามแก้ไขโค้ดแต่กลับทำให้ผลงานแย่ลง หรือก้าวหน้าเพียงเล็กน้อยในช่วงที่มีสัญญาณรบกวนของข้อมูล
บทเรียนสำคัญจาก Opus 4.8 คือโมเดลเริ่มรู้จักการสร้าง "Completion Gate" เพื่อตรวจสอบความสำเร็จของงานจริง หลังจากพบว่าการรันส่วนใหญ่รายงานว่าสำเร็จทั้งที่งานยังล้มเหลว อย่างไรก็ตาม การวินิจฉัยความล้มเหลวยังคงเป็นจุดที่อ่อนแอที่สุด เนื่องจากเครื่องมือวิเคราะห์ที่สร้างขึ้นมาถูกใช้งานจริงเพียงไม่กี่ครั้งเท่านั้น
ประเด็นสำคัญ
- HarnessDev มุ่งเน้นวัดคุณภาพของโครงสร้างระบบ (Harness) ที่โมเดลสร้างขึ้นเอง
- LLM เริ่มทำงานได้เทียบเท่าหรือดีกว่ามนุษย์ในด้านงานเขียนและการทดลอง ML แต่ยังตามหลังในด้านการเขียนโค้ดและการค้นหาข้อมูล
- ประสิทธิภาพของ Harness มักผูกติดกับตัวประมวลผลที่ใช้พัฒนา ทำให้ขาดความยืดหยุ่นในการย้ายระบบ
- กระบวนการพัฒนาตัวเองของโมเดลยังไม่เสถียร โดยมีเพียงครึ่งเดียวของการปรับปรุงที่เห็นผลบวกชัดเจนในงานใหม่ๆ
- ปัญหาหลักคือการสร้างโค้ดส่วนเกินที่ไม่ถูกใช้งานจริง (Dead Code) โดยเฉพาะระบบหน่วยความจำ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร