
ถอดบทเรียนการใช้ AI ทำซ้ำงานวิจัย 2,200 ฉบับจาก ICML: เมื่อ Agent กลายเป็นผู้ตรวจสอบความถูกต้อง
เมื่อช่วงเดือนกรกฎาคมที่ผ่านมา เราได้จัดงาน hackathon ที่มีสมาชิกชุมชนมากกว่า 1,200 คน นำ coding agents ของตนเองมาทดลองทำซ้ำ (reproduce) งานวิจัยที่ตีพิมพ์ใน ICML 2026 โดยตรวจสอบแบบทีละข้ออ้าง (claim by claim) ภายในเวลา 19 วัน ซึ่งผู้เข้าร่วมได้เผยแพร่ สมุดบันทึก Trackio จำนวน 6,816 เล่ม ครอบคลุมงานวิจัย 2,226 ฉบับ หรือประมาณหนึ่งในสามของงานประชุมทั้งหมด 🤯
ในโพสต์นี้ เราจะแบ่งปันสิ่งที่เราเรียนรู้จากการจัดงานครั้งนี้ และสิ่งที่บ่งชี้เกี่ยวกับบทบาทของมนุษย์ในอนาคต เมื่อเหล่า agent กลายเป็นผู้รับหน้าที่หลักในการทำการทดลองวิจัย
งานวิจัยที่มีจำนวนมากเกินกว่าใครจะตรวจสอบได้หมด
คำถามเกี่ยวกับความสามารถในการทำซ้ำงานวิจัย AI นั้นมีมานานแล้ว แต่ทวีความรุนแรงขึ้นตามขนาดที่ขยายตัวอย่างรวดเร็ว โดยใน ICML 2026 มีผลงานส่งเข้าประกวดถึง 23,918 ฉบับ และได้รับตอบรับ 6,352 ฉบับ เพิ่มขึ้นเกือบเท่าตัวจากปีก่อนหน้า ซึ่งส่วนหนึ่งเป็นผลมาจาก AI agents ที่ช่วยให้การทดลองและการเขียนงานวิจัยทำได้รวดเร็วยิ่งขึ้น
ทว่าความสามารถในการตรวจทาน (Reviewing capacity) กลับไม่ได้เพิ่มขึ้นตาม ผู้ตรวจทานส่วนใหญ่เป็นอาสาสมัครที่อาจขาดเวลาหรือความเชี่ยวชาญเพียงพอ ดังจะเห็นได้จากบทวิจารณ์งานวิจัยระดับ spotlight ฉบับหนึ่งใน ICML 2026 ที่ผู้ตรวจทานยอมรับตรงๆ ว่า:
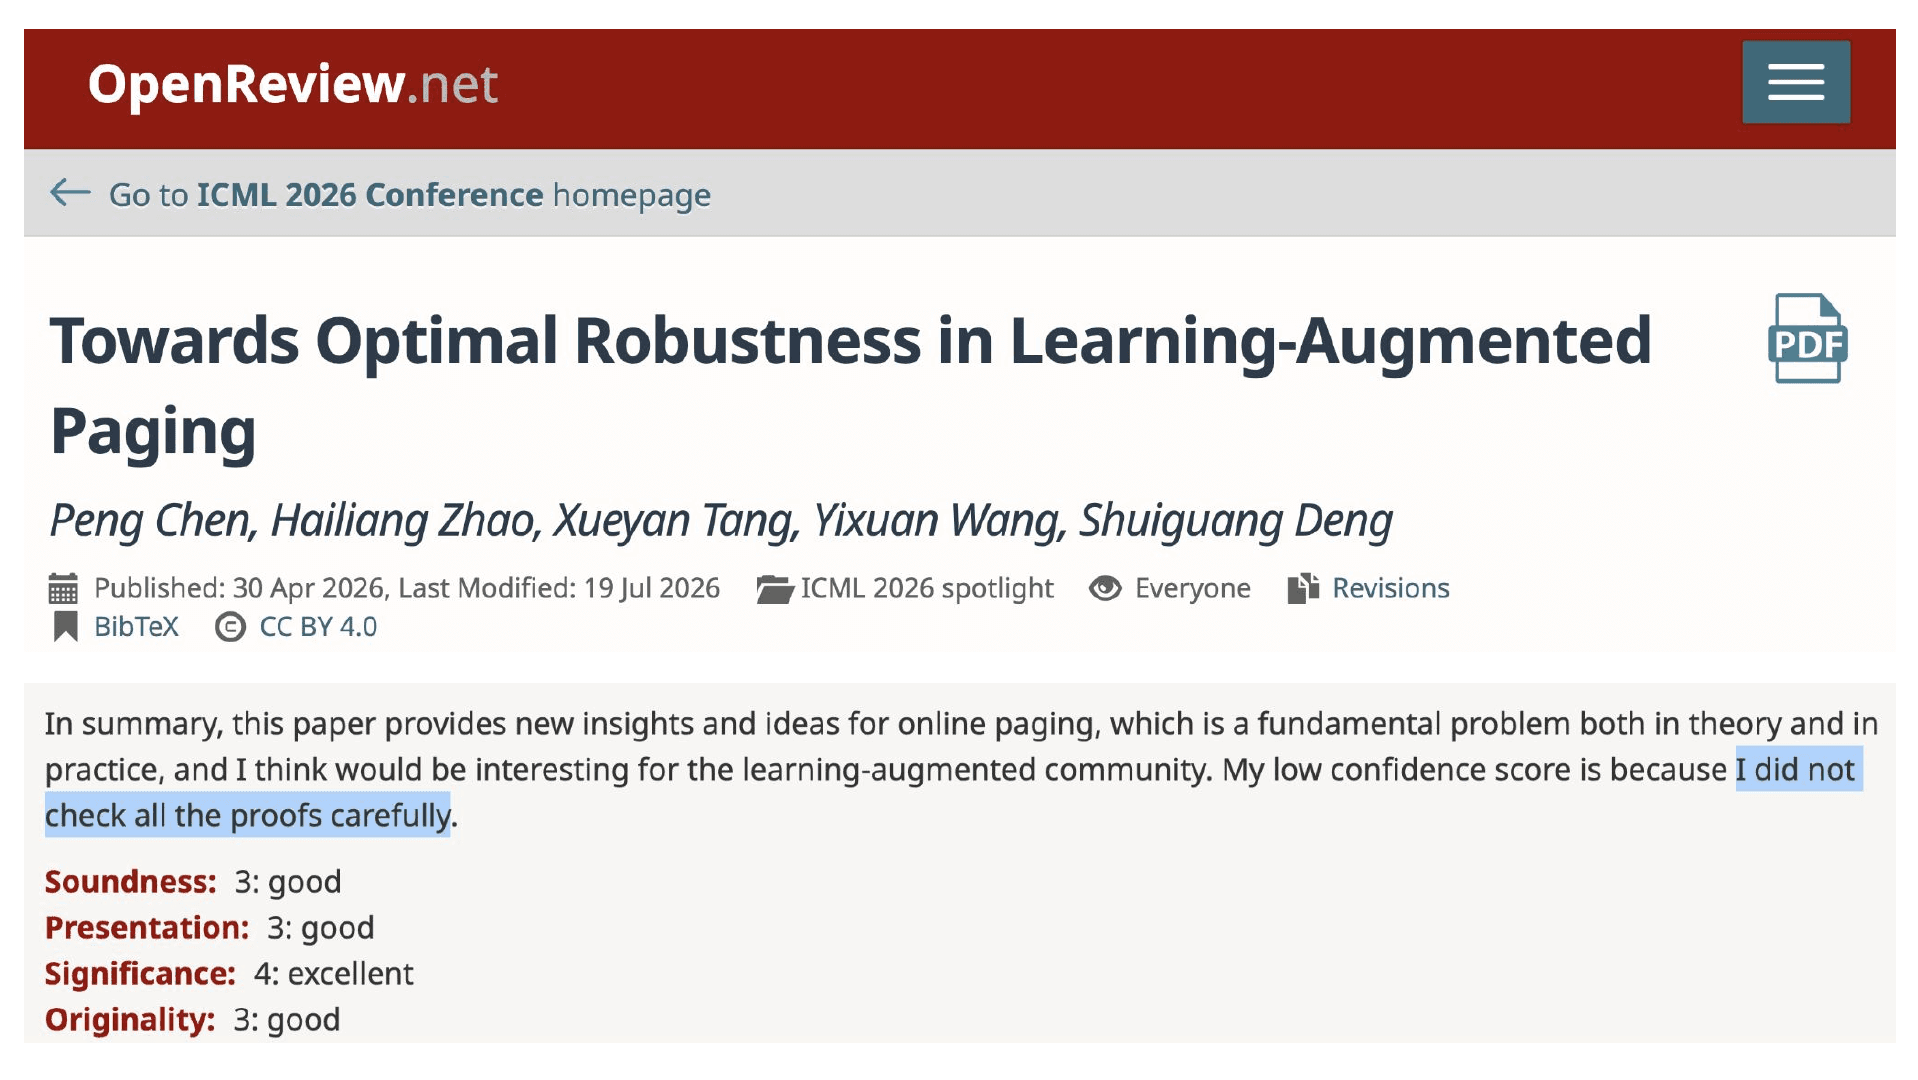
"คะแนนความมั่นใจที่ต่ำของฉันเป็นเพราะฉันไม่ได้ตรวจสอบบทพิสูจน์ทั้งหมดอย่างละเอียด"
แม้ผู้ตรวจทานจะไม่ได้เช็กอย่างถี่ถ้วน แต่งานวิจัยนี้กลับได้รับคะแนนสูงและได้รับเลือกเป็น spotlight ซึ่งเราจะกลับมาดูกันว่าเกิดอะไรขึ้นเมื่อเราใช้ AI ตรวจสอบบทพิสูจน์อย่างละเอียดในภายหลัง
อย่างไรก็ตาม เทคโนโลยีชนิดเดียวกับที่ทำให้งานวิจัยล้นหลาม ก็สามารถช่วยให้เราก้าวทันมันได้เช่นกัน Coding agents อย่าง Claude Code, Codex, Cursor และ Pi มีความสามารถในการอ่านงานวิจัย เขียนโค้ด เริ่มการทดลอง และรายงานผลได้ทันที การตรวจสอบที่เคยต้องใช้เวลาทั้งวันหยุดของมนุษย์ บัดนี้ agent สามารถทำเสร็จได้ภายในบ่ายวันเดียวและทำขนานกันได้เป็นพันครั้ง
เราจึงเกิดคำถามสำคัญว่า: หากเราลองตรวจสอบงานประชุมระดับโลกในวงกว้างและพยายามทำซ้ำงานวิจัยทุกฉบับ เราจะค้นพบอะไรบ้าง?
งาน Hackathon (15 กรกฎาคม - 2 สิงหาคม)
แทนที่จะลงมือตรวจสอบเอง เราเปิดโอกาสให้ชุมชนนำความหลากหลายของ framework และทรัพยากรประมวลผลมาร่วมพิสูจน์ โดยความท้าทาย ICML 2026 Open Reproductions มีขั้นตอนดังนี้:
- เลือกงานวิจัย: เราสกัดข้ออ้างทางวิทยาศาสตร์หลักจากงานวิจัย 6,341 ฉบับ เพื่อให้ agent มีเป้าหมายที่ชัดเจนแทนการเริ่มจากไฟล์ PDF เปล่าๆ
- นำ agent ของคุณมาเอง: ผู้เข้าร่วมใช้เครื่องมือหลากหลาย ตั้งแต่ Claude Code ไปจนถึง
orxของ OpenResearch - ทำซ้ำ แล้วเผยแพร่: ทุกการทำงานจะถูกบันทึกใน Trackio logbook ซึ่งเป็น Hugging Face Space ที่รวบรวมทั้งโค้ด ผลลัพธ์ และร่องรอยการทำงาน (trace) เพื่อความโปร่งใส
- รับการตัดสิน: ใช้ Logbook Judge อัตโนมัติ (โมเดล GLM-5.2) ตัดสินผลเป็น verified (ยืนยันแล้ว), falsified (พิสูจน์ว่าผิด), toy (ระดับย่อส่วน) หรือ inconclusive (ไม่ชัดเจน)
ผู้เข้าร่วมได้รับเครดิตประมวลผล Hugging Face มูลค่า $20 เพื่อรันงานบน HF Jobs โดยมีการเริ่มงานบนคลาวด์เกือบ 3,000 ครั้ง ในกรณีที่ไม่สามารถเข้าถึงชุดข้อมูลเฉพาะได้ ผู้เข้าร่วมจะใช้วิธีทำซ้ำแบบย่อส่วนบนข้อมูลสังเคราะห์แทน
นี่คือลักษณะของงานทำซ้ำที่สมบูรณ์:
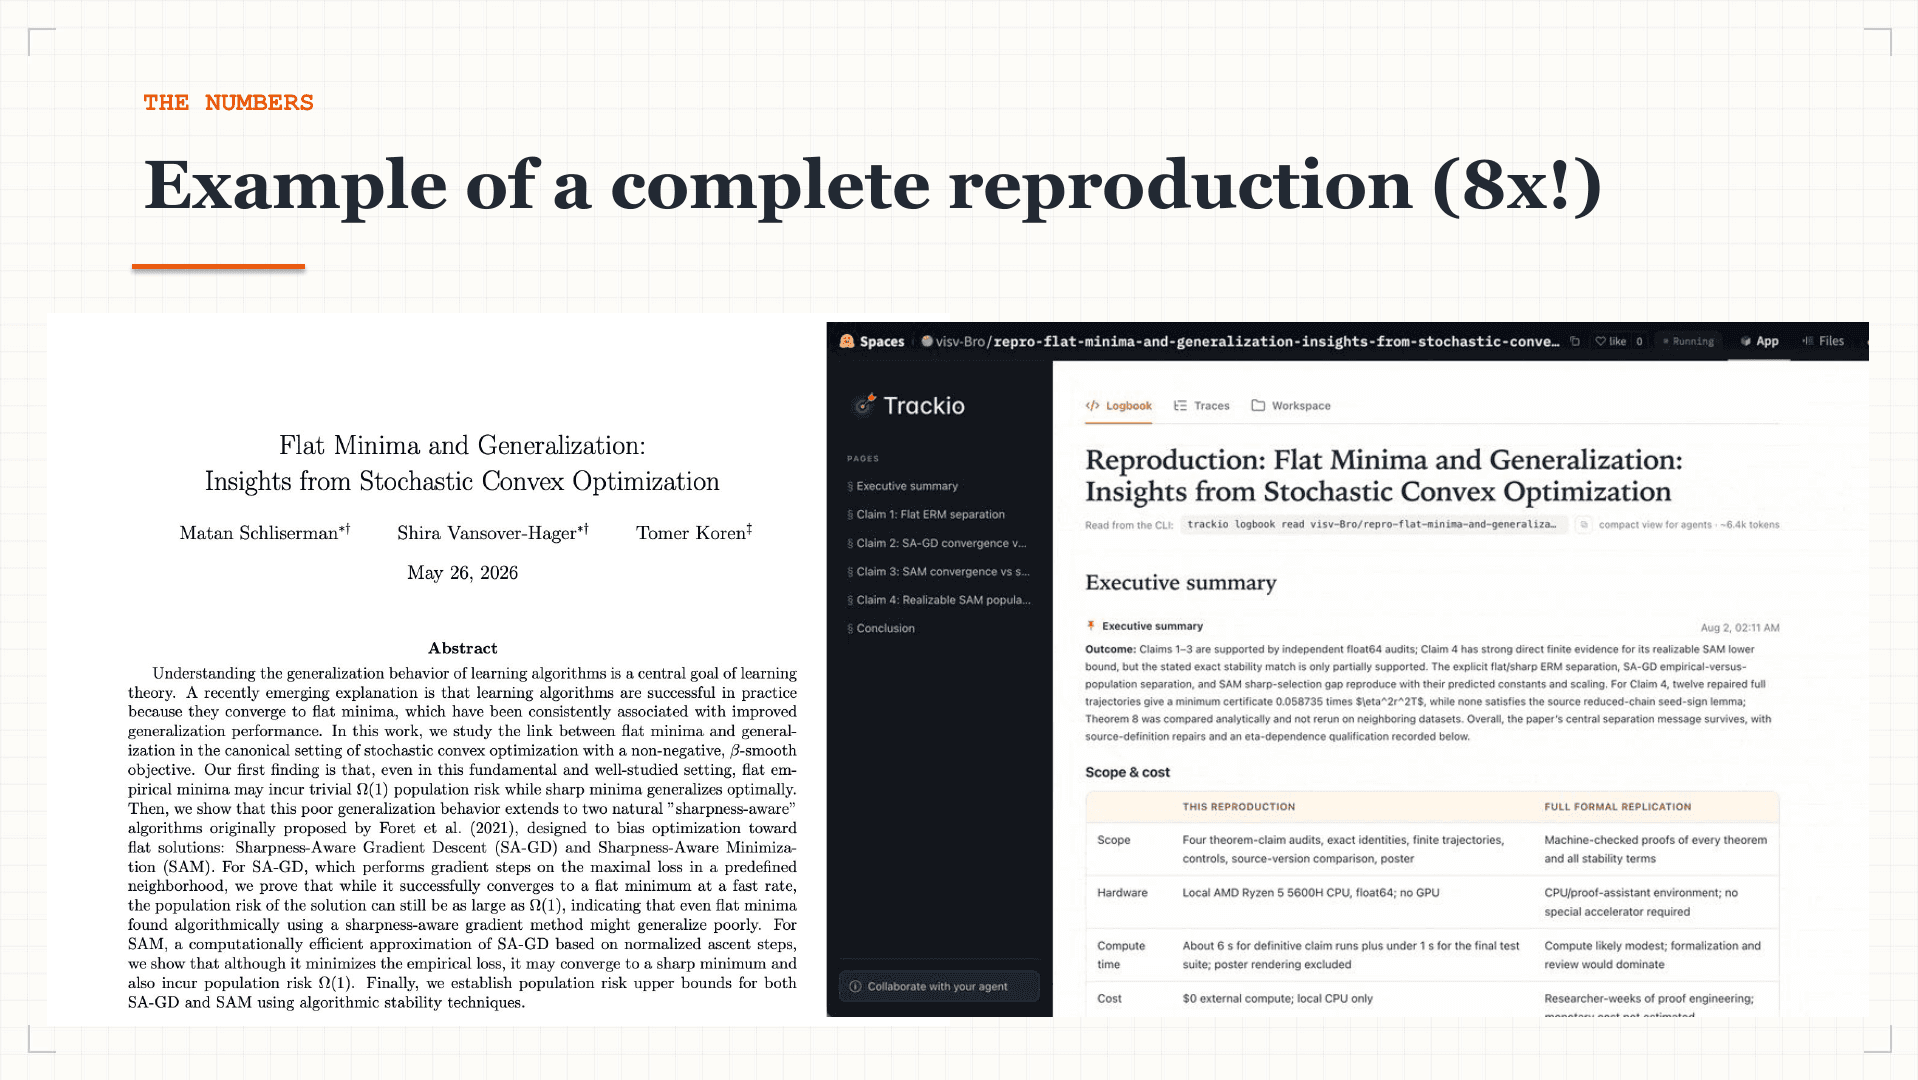
จากตัวเลขที่ปรากฏ งานนี้ถือเป็นความพยายามทำซ้ำงานวิจัยทางวิทยาศาสตร์ที่ใหญ่ที่สุดครั้งหนึ่ง:
- สมาชิกชุมชน 1,221 คนเข้าร่วม
- เผยแพร่สมุดบันทึกการทำซ้ำ 6,816 เล่ม
- พยายามทำซ้ำงานวิจัยรวม 2,226 ฉบับ (34% ของงานประชุม)
- ตรวจสอบข้ออ้างไปทั้งสิ้น 35,908 ข้อ
สิ่งที่เราค้นพบ
จากการรวบรวมคำตัดสินในระดับข้ออ้างต่องานวิจัยแต่ละฉบับ พบข้อมูลที่น่าสนใจดังนี้:
51% ของงานวิจัยที่ตรวจสอบ (1,103 ฉบับ) มีข้ออ้างอย่างน้อยหนึ่งข้อที่ได้รับการยืนยันโดยอิสระ โดยมี 266 ฉบับที่ทำซ้ำได้สมบูรณ์แบบ และอีก 632 ฉบับที่ทำซ้ำได้บางส่วนโดยไม่มีข้อโต้แย้ง รวมแล้วมีข้ออ้างถึง 3,978 ข้อที่ได้รับการยืนยันจากการทดลองจริง
23% ของงานวิจัยที่ตรวจสอบ (496 ฉบับ) มีข้ออ้างอย่างน้อยหนึ่งข้อที่ถูกพิสูจน์ว่าผิดหรือถูกโต้แย้ง ในจำนวนนี้มี 49 ฉบับที่ข้ออ้างทั้งหมดไม่สามารถยืนยันได้เลย และมีงานวิจัย 242 ฉบับที่ทีมทำซ้ำอิสระได้ข้อสรุปที่ขัดแย้งกันเองในข้ออ้างเดียวกัน สะท้อนว่าความสามารถในการทำซ้ำไม่ใช่เรื่องขาวกับดำ แต่เป็นกระบวนการที่ต้องมีการถกเถียงและตรวจสอบอย่างเข้มข้น
สำหรับส่วนที่เหลือ 502 ฉบับมีหลักฐานเฉพาะในระดับย่อส่วน และอีก 280 ฉบับไม่สามารถหาข้อสรุปได้ ซึ่งส่วนใหญ่เกิดจากการขาดแคลน artifacts ที่จำเป็น
การทำซ้ำที่ทำออกมาได้ดี
งานวิจัยบางฉบับผ่านการทดสอบได้อย่างยอดเยี่ยม เช่น:
- "Flat Minima and Generalization: Insights from Stochastic Convex Optimization" ถูกทำซ้ำโดย 20 ทีม และ 12 ทีมยืนยันผลได้ครบถ้วน
- "A Coin Flip for Safety: LLM Judges Fail to Reliably Measure Adversarial Robustness" น่าสนใจว่างานวิจัยที่พูดถึงความไม่น่าเชื่อถือของ LLM judges กลับถูกยืนยันความถูกต้องโดย LLM agents ได้สำเร็จ
การพิสูจน์ว่าผิด และสิ่งที่เกิดขึ้นเมื่อเราตรวจสอบพวกมัน
เมื่อผู้เข้าร่วมอ้างว่าพบข้อผิดพลาด เราได้ทำการตรวจสอบซ้ำอย่างละเอียด ทั้งการไล่เรียงคณิตศาสตร์และทดลองรันใหม่ ตัวอย่างที่น่าสนใจ ได้แก่:
งานวิจัยเรื่อง paging ที่ถูกปล่อยผ่าน: งานวิจัย "Towards Optimal Robustness in Learning-Augmented Paging" ที่ได้รับ spotlight อ้างความทนทานในระดับหนึ่ง แต่ สมุดบันทึกของผู้เข้าร่วม พบว่าตัวแปรเสริมเติบโตเร็วกว่าที่อ้าง และระบุจุดผิดในบทพิสูจน์ได้อย่างแม่นยำ ซึ่งการทดลองใหม่ของเราก็ยืนยันข้อผิดพลาดนี้
ทฤษฎีบทที่พังทลายหลังจากขั้นตอนที่ 224: งานวิจัยเรื่อง "Attention's forward pass and Frank-Wolfe" ถูกพบตัวอย่างค้านโดยทีมอิสระ 3 ทีม เนื่องจากความผิดปกติจะปรากฏหลังจากรันไปนานกว่าที่คนทั่วไปมักตรวจสอบ ตัวอย่างค้านที่ชัดเจนที่สุด ถูกระบุด้วยเลขคณิตที่แม่นยำจนผู้เขียนยอมรับและกำลังแก้ไข
การใช้ Loss ผิดตัว: ในงานวิจัย "Self-Distillation Enables Continual Learning" ทฤษฎีวิเคราะห์ reverse KL divergence แต่โค้ดจริงกลับใช้ forward KL ทำให้ไม่สามารถทำซ้ำผลลัพธ์หลักได้ สมุดบันทึกที่ตรวจพบเรื่องนี้ ส่งผลให้ผู้เขียนต้องอัปโหลดเวอร์ชันแก้ไขไปยัง arXiv
🚨 การพิสูจน์ว่าผิดที่ผิดพลาด (False falsifications): บางครั้ง agent หรือผู้เข้าร่วมก็ทำพลาดเอง เช่น การอ้างว่าวิธีการใหม่ช้ากว่าเดิม 2 เท่า แต่แท้จริงแล้วเป็นเพราะบักในการทำซ้ำที่นำหน่วยเวลาคนละแบบมาเปรียบเทียบกัน เมื่อแก้ไขแล้วพบว่าเร็วกว่าเดิมถึง 8 เท่าตามที่งานวิจัยอ้างไว้
การสื่อสารกับผู้เขียนงานวิจัย
เราได้ติดต่อผู้เขียนงานวิจัยทุกฉบับที่มีประเด็น โดยใช้หลักฐานจากการทำซ้ำเข้าพูดคุย ซึ่งส่วนใหญ่ได้รับการตอบรับในเชิงบวกอย่างมาก:
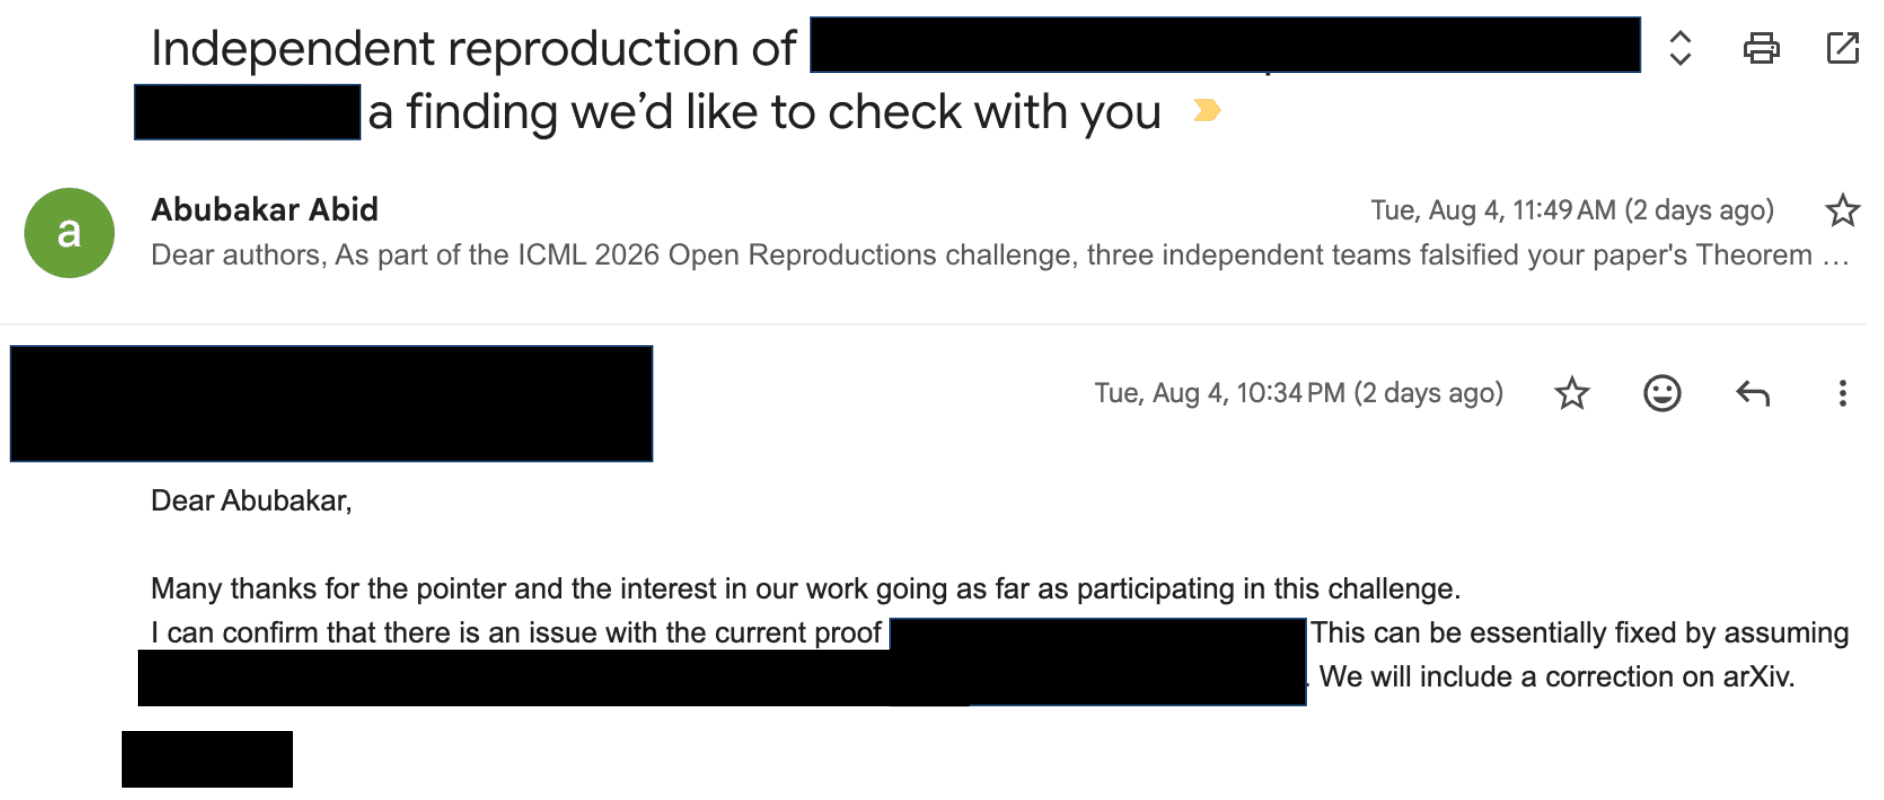
ปัจจุบันมีการแก้ไขบน arXiv แล้วหลายฉบับ และบางกรณีผู้เขียนได้แอบแก้ไขข้อผิดพลาดก่อนที่เราจะตรวจพบ ซึ่งถือเป็นเรื่องน่ายินดีที่ความเห็นตรงกันโดยอิสระ
บทบาทของมนุษย์
คำถามสำคัญคือ มนุษย์ยังจำเป็นอยู่ไหม? เราเชื่อว่าคำตอบคือ "จำเป็นอย่างยิ่ง" ด้วยเหตุผลดังนี้:
ขีดจำกัดของ Agent: Agent มักติดลูปเดิมๆ หรือแปลความหมายผิดพลาด ผลลัพธ์ที่น่าเชื่อถือที่สุดในงานนี้จึงมาจากเวิร์กโฟลว์ที่มีมนุษย์คอยควบคุม (human-in-the-loop) เพื่อคอยชี้แนะ ตั้งคำถามต่อสมมติฐาน และตัดสินใจในเชิงยุทธศาสตร์ก่อนที่จะเสียทรัพยากรไปโดยเปล่าประโยชน์
การประเมินเชิงคุณภาพ: เช่นใน ผลงานผู้ชนะหมวด human-in-the-loop ที่ตรวจสอบการสร้างภาพ แม้ตัวเลขจะบอกว่าปกติ แต่มนุษย์ต้องเป็นผู้ตัดสินว่าภาพนั้น "ใช้งานได้จริง" หรือไม่ โดยมีการใช้ AI ช่วยสร้างเครื่องมือตรวจทานให้มนุษย์ตัดสินได้ง่ายขึ้น
ดังนั้น บทบาทใหม่ของมนุษย์คือการเป็น "ผู้จัดการสติปัญญา" (Manager of Intelligence) เหมือนศาสตราจารย์ที่คอยจัดเตรียมสภาพแวดล้อมและตั้งคำถามที่ถูกต้อง เพื่อให้ agent ทำงานได้อย่างมีประสิทธิภาพสูงสุด
ขอขอบคุณ
ขอขอบคุณสมาชิกทั้ง 1,221 คน และความร่วมมือจาก Hugging Face และ alphaXiv ที่ทำให้การตรวจสอบงานประชุม Machine Learning แบบเปิดครั้งใหญ่ที่สุดนี้เกิดขึ้นได้ ข้อมูลสมุดบันทึกและร่องรอยการทำงานทั้งหมดเป็นสาธารณะ สามารถดูได้ที่ Space ของการแข่งขัน และเราหวังว่านี่จะเป็นเพียงจุดเริ่มต้นของการยกระดับมาตรฐานงานวิจัยในอนาคต 🤗
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร