
NVIDIA เปิดตัว PivotOPD สอน AI Agent แก้ไขข้อผิดพลาดและกู้คืนสถานการณ์
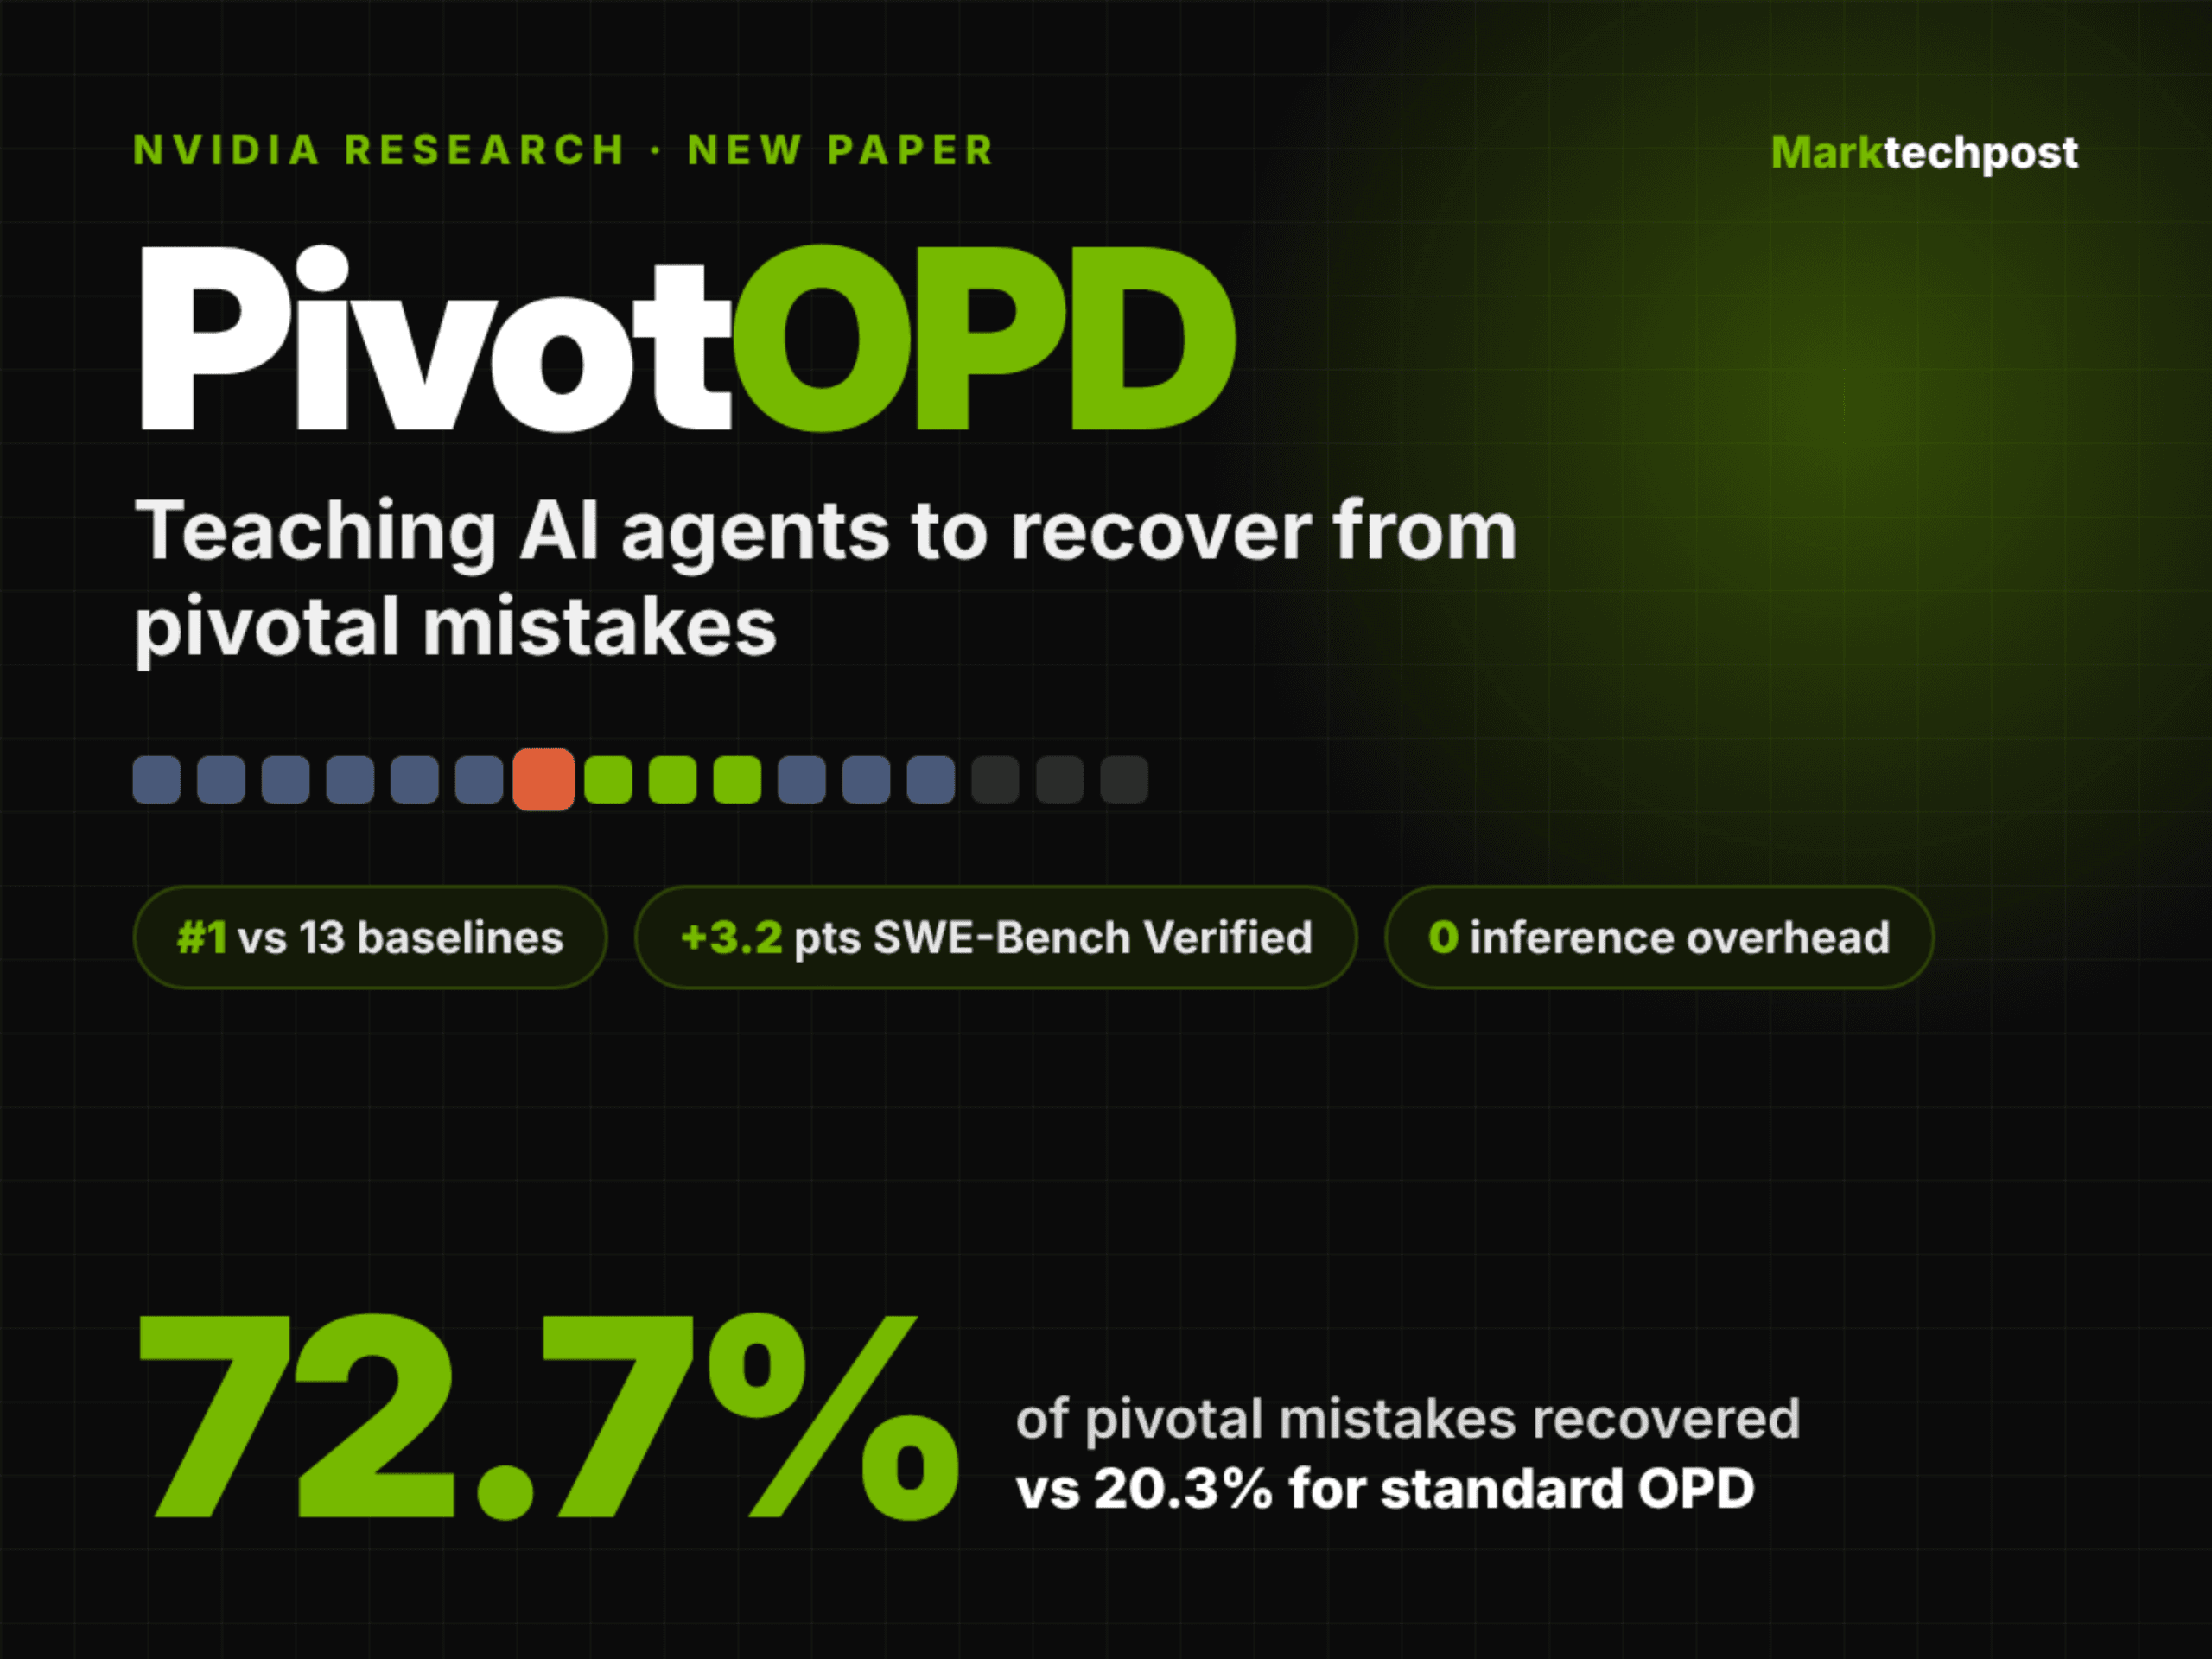
นักวิจัยจาก NVIDIA ร่วมกับมหาวิทยาลัย Princeton และมหาวิทยาลัย Maryland เปิดตัว PivotOPD ซึ่งเป็นวิธีการ on-policy distillation สำหรับ LLM agent แบบหลายขั้นตอน (multi-turn) โดยมุ่งเน้นการฝึกสอนให้ agent หลีกเลี่ยงข้อผิดพลาดในช่วงแรกที่สร้างความเสียหายรุนแรงที่สุด และเรียนรู้วิธีกู้คืนสถานการณ์เมื่อเกิดความผิดพลาดขึ้น
ผลการทดสอบพบว่า PivotOPD ทำคะแนนเฉลี่ยได้ดีที่สุดในชุดทดสอบ ALFWorld, WebShop และ Search-based QA เมื่อเทียบกับ 13 baselines โดยใช้โมเดลนักเรียน Qwen3-1.7B และ Qwen3-8B ข้อสรุปสำคัญชี้ให้เห็นว่าทักษะการกู้คืนสถานการณ์เป็นสิ่งที่เรียนรู้ได้ แต่วิธี OPD มาตรฐานในปัจจุบันแทบจะไม่เคยสอนทักษะนี้เลย
TL;DR
- ขนาด: เป็นวิธีการฝึกสอนที่ทดสอบกับโมเดล Qwen3-1.7B, Qwen3-8B และ Nemotron-3.5-SFT บน SWE-Bench Verified
- การใช้งาน: ฝึกสอนบน NVIDIA H100 nodes โดยไม่มีค่าใช้จ่ายส่วนเกินในการทำ inference ทำให้ agent ที่ผ่านการฝึกสามารถรันได้ทุกที่ตามสเปกของ base model
- ประสิทธิภาพ: ครองอันดับหนึ่งจากค่าเฉลี่ย 8 รายการในทุกชุดทดสอบ และกู้คืนสถานการณ์ได้ถึง 72.7% จากข้อผิดพลาดสำคัญ เมื่อเทียบกับ OPD มาตรฐานที่ทำได้เพียง 20.3%
- ข้อดีและข้อจำกัด: ช่วยสอนการกู้คืนสถานการณ์ในระดับที่ RL แบบเน้นผลลัพธ์ (outcome-only RL) เข้าไม่ถึง แต่จำเป็นต้องใช้สภาพแวดล้อมที่เล่นซ้ำได้ (replayable environments)
ข้อผิดพลาดที่สำคัญ (pivotal mistake) ใน agent แบบหลายขั้นตอนคืออะไร?
ข้อผิดพลาดที่สำคัญคือการกระทำที่ส่งผลให้แนวทางการทำงานที่เหลืออยู่ต้องยาวขึ้น หรือทำให้งานนั้นล้มเหลวโดยไม่สามารถแก้ไขได้อีกต่อไป ซึ่งระบบ symbolic oracle ของ ALFWorld จะวัดค่านี้ในทุกขั้นตอน (turn)
จากการทดสอบพบว่า 59% ของการทำงานที่ล้มเหลวมักมีข้อผิดพลาดนี้เกิดขึ้นในช่วงแรก (ขั้นตอนที่ 8 ถึง 12 จาก 30 ขั้นตอน) หลังจากนั้น agent มักจะเสียเวลาเปล่าไปอีกกว่า 18-21 ขั้นตอนโดยไม่สามารถกู้คืนสถานการณ์ได้ การแก้ไขที่ขั้นตอนสำคัญนี้เพียงจุดเดียวสามารถเพิ่มอัตราความสำเร็จจาก 8% เป็น 59% ได้ทันที
ทำไม on-policy distillation มาตรฐานถึงพลาดจุดนี้?
OPD มาตรฐานช่วยลดอัตราความล้มเหลวโดยรวมได้ แต่กลับลดความล้มเหลวที่เกิดจากขั้นตอนสำคัญได้เพียงเล็กน้อย (จาก 51% เหลือ 49%) เนื่องจากแอคชันที่ถูกต้องในจุดวิกฤตมักมีความน่าจะเป็นต่ำกว่า 1% ทำให้การสุ่มรันแบบปกติแทบไม่เจอทางออกที่ถูกต้อง ส่งผลให้ RL แบบเน้นผลลัพธ์ (Outcome-based RL) เกิดจุดบอดเพราะค่าความได้เปรียบสัมพัทธ์ในกลุ่มเป็นศูนย์
PivotOPD ทำงานอย่างไร?
PivotOPD เพิ่ม 3 ส่วนประกอบเข้าไปใน RL แบบกลุ่ม โดยรวมอยู่ในการอัปเดต PPO เพียงครั้งเดียว ดังนี้:
- Pivot detection: ใช้โมเดลตัวสอนขนาดใหญ่ระบุขั้นตอนที่เป็นจุดสำคัญ (candidate turns) และกำหนดแอคชันที่ดีที่สุด (gold action) โดยจะถือเป็นจุดสำคัญเมื่อโมเดลนักเรียนเลือกทำต่างจากที่ตัวสอนแนะนำ
- Preventive distillation (reverse KL): ใช้สำเนาที่ถูกแช่แข็งของนักเรียนร่วมกับ gold action เพื่อให้คะแนนการตอบสนองใหม่ วิธีนี้จะผลักดันให้นักเรียนออกห่างจากข้อผิดพลาดเดิมที่เคยทำ
- Recovery distillation (forward KL): ตัวสอนจะกำหนดแอคชันเพื่อกู้คืนสถานการณ์สูงสุด K ขั้นตอน เพื่อให้โมเดลนักเรียนฝึกฝนตาม ช่วยยกความน่าจะเป็นของแอคชันที่ปกติโมเดลนักเรียนแทบจะไม่เคยสุ่มเจอ
ประสิทธิภาพของ PivotOPD ในการทดสอบ
ในการทดสอบกับโมเดล Qwen3-1.7B PivotOPD ทำคะแนนใน ALFWorld ได้ 73.7% สูงกว่า SDAR ถึง 5.5 จุด และใน WebShop มีอัตราความสำเร็จสูงถึง 76.6% ส่วนโมเดล Qwen3-8B สามารถทำคะแนนใน ALFWorld ได้สูงถึง 93.0%
สำหรับบทบาทตัวสอน ใน SWE-Bench Verified โมเดล Nemotron-3.5-SFT ที่สอนโดย Nemotron-3-Super มีคะแนนเพิ่มขึ้นเป็น 66.0% ซึ่งเหนือกว่าทั้ง base model และ OPD มาตรฐานอย่างชัดเจน
จุดเด่นที่สุดคือความสามารถในการกู้คืนสถานการณ์ โดย PivotOPD สามารถแก้ไขข้อผิดพลาดสำคัญได้สำเร็จถึง 72.7% โดยใช้เวลาเฉลี่ย 9.7 ขั้นตอนในการกู้คืน ซึ่งใกล้เคียงกับค่าที่เหมาะสมที่สุด (6.2 ขั้นตอน)
PivotOPD เปรียบเทียบกับวิธีการทำ agent distillation อื่นๆ
| Metrics | PivotOPD | OPSD (standard OPD) | OPID | SDAR | RLSD |
|---|---|---|---|---|---|
| แนวคิดหลัก | ป้องกันและกู้คืนที่ขั้นตอนสำคัญซึ่งตรวจพบโดยตัวสอน | Self-teacher ที่ได้รับสิทธิพิเศษในทุกการตอบสนอง | ทักษะตามลำดับขั้นจากข้อมูลย้อนหลัง on-policy | OPSD ในรูปแบบ sigmoid-gated auxiliary loss | Self-distillation กำหนดขนาดการอัปเดต |
| ฝึกจากคำตอบเพื่อกู้คืน | ใช่ (forward KL) | ไม่ | ไม่ | ไม่ | ไม่ |
| ALFWorld เฉลี่ย (1.7B) | 73.7 | 12.4 | 61.3 | 68.2 | 60.7 |
| Search QA เฉลี่ย (1.7B) | 44.5 | 36.8 | 37.5 | 37.1 | 38.6 |
| WebShop สำเร็จ (1.7B) | 76.6 | 10.1 | 68.0 | 57.0 | 62.5 |
แหล่งที่มา: PivotOPD Table 1
ค่าใช้จ่ายในการฝึกและสถานะปัจจุบัน
PivotOPD เน้นการปรับปรุงในขั้นตอนการฝึก จึงไม่มีภาระค่าใช้จ่ายเพิ่มเติมในช่วง inference การฝึกบน GPU H100 จำนวน 4 ตัว มีภาระงานส่วนเกิน (overhead) เพิ่มขึ้นตามจำนวนขั้นตอนกู้คืน (K) ที่กำหนด โดยทีมวิจัยเลือกใช้ค่าที่สมดุลที่สุดสำหรับแต่ละชุดทดสอบ ปัจจุบันงานวิจัยนี้ยังไม่มีการปล่อยซอร์สโค้ดออกมาอย่างเป็นทางการ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร