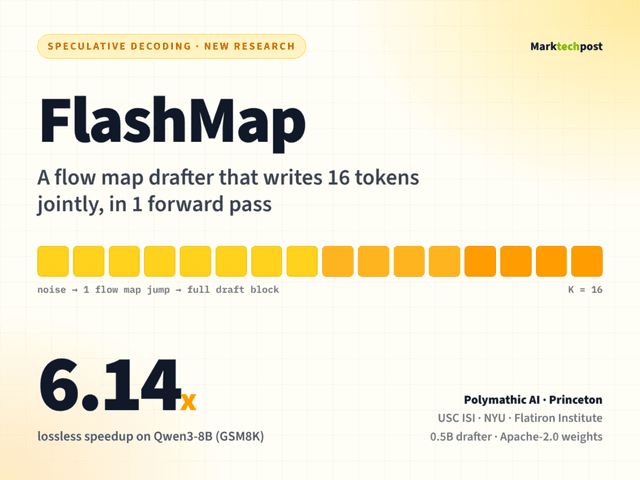
เปิดตัว FlashMap ระบบร่าง Token ใหม่ เร่งความเร็ว LLM สูงสุด 6.14 เท่าtag: FlashMap, LLM, Polymathic AI, Princeton University, Qwen3, Speculative DecodingOct 28, 2026 · By: AttapolKสรุปข่าว 1:20คณะวิจัยจาก Polymathic AI และ Princeton เปิดตัว FlashMap ตัวร่างสำหรับ speculative decoding ที่ใช้เทคนิค continuous flow map ช่วยให้ร่าง 16 token ได้พร้อมกันในครั้งเดียวและเร่งความเร็วแบบ lossless ได้มหาศาล
5 โปรเจกต์วิศวกรรม LLM Inference เพื่อความเข้าใจระบบเบื้องหลังtag: FlashAttention, Hugging Face, LLM Inference, Quantization, Speculative Decoding, vLLMOct 14, 2026 · By: SirilukPสรุปข่าว 1:27เจาะลึกกลไกที่ทำให้ LLM ทำงานได้รวดเร็วผ่าน 5 โปรเจกต์ลงมือทำจริง ตั้งแต่การสร้างระบบจัดการหน่วยความจำไปจนถึงการเขียน GPU Kernel
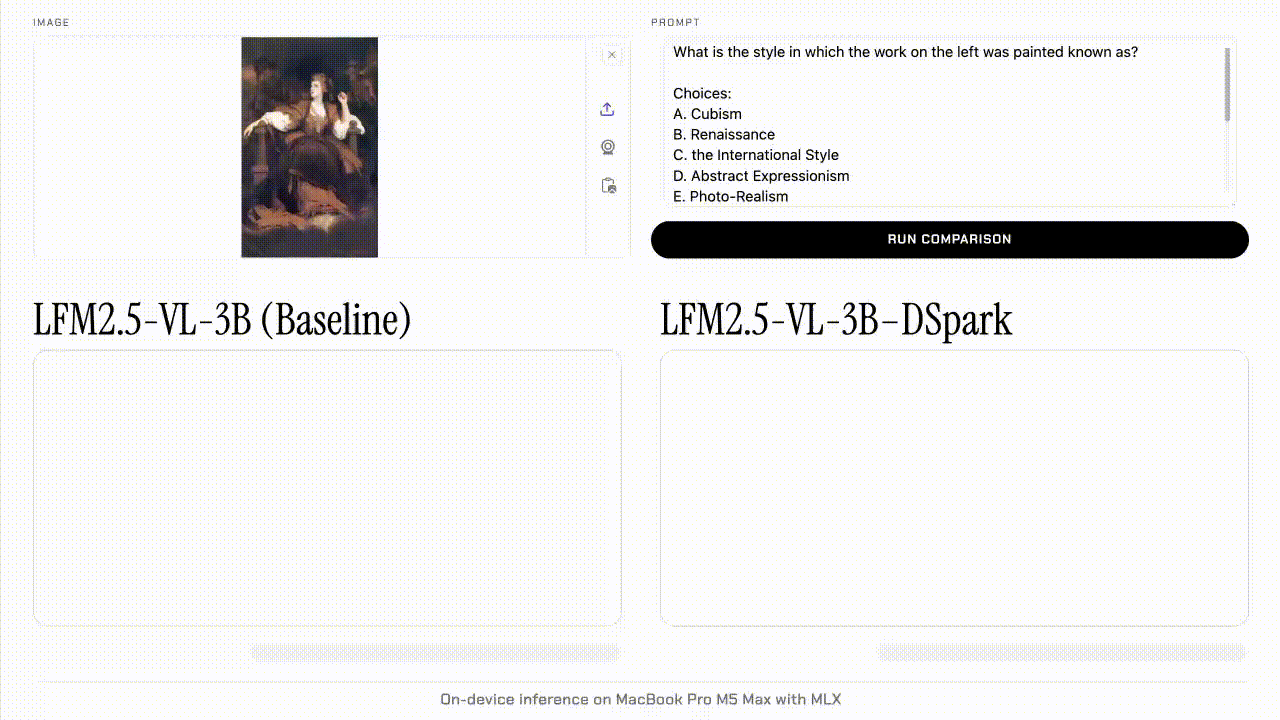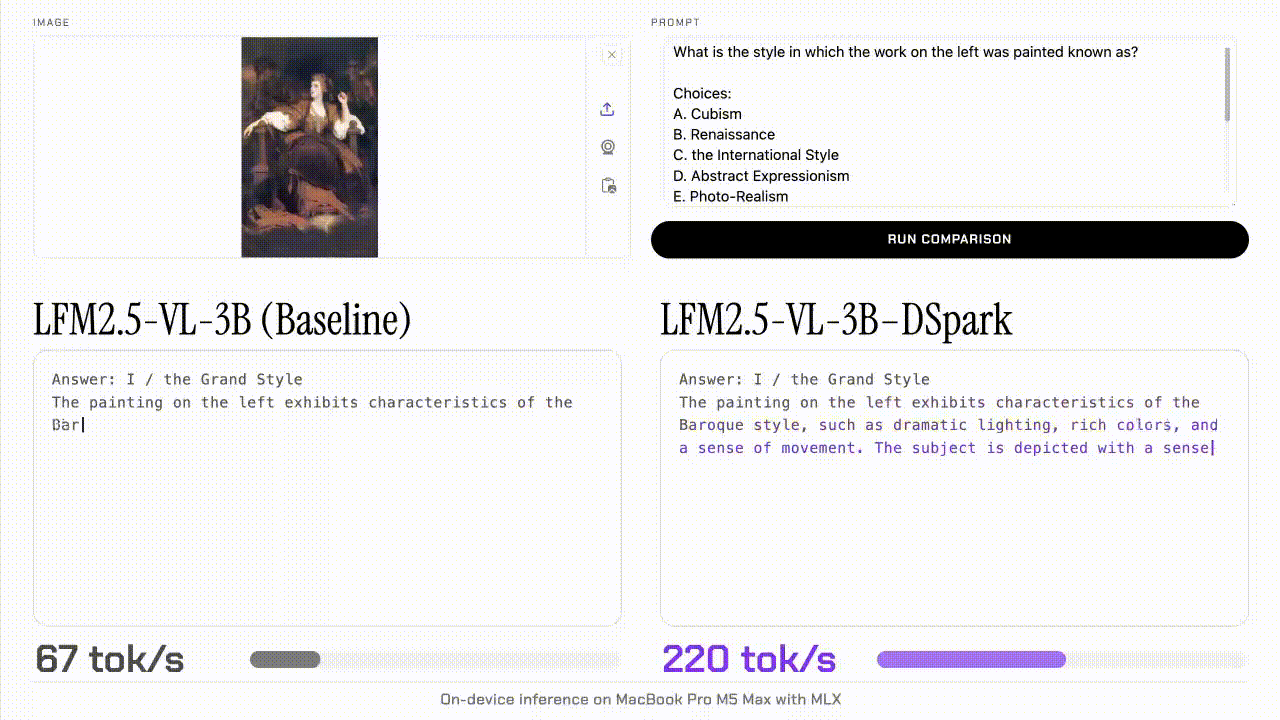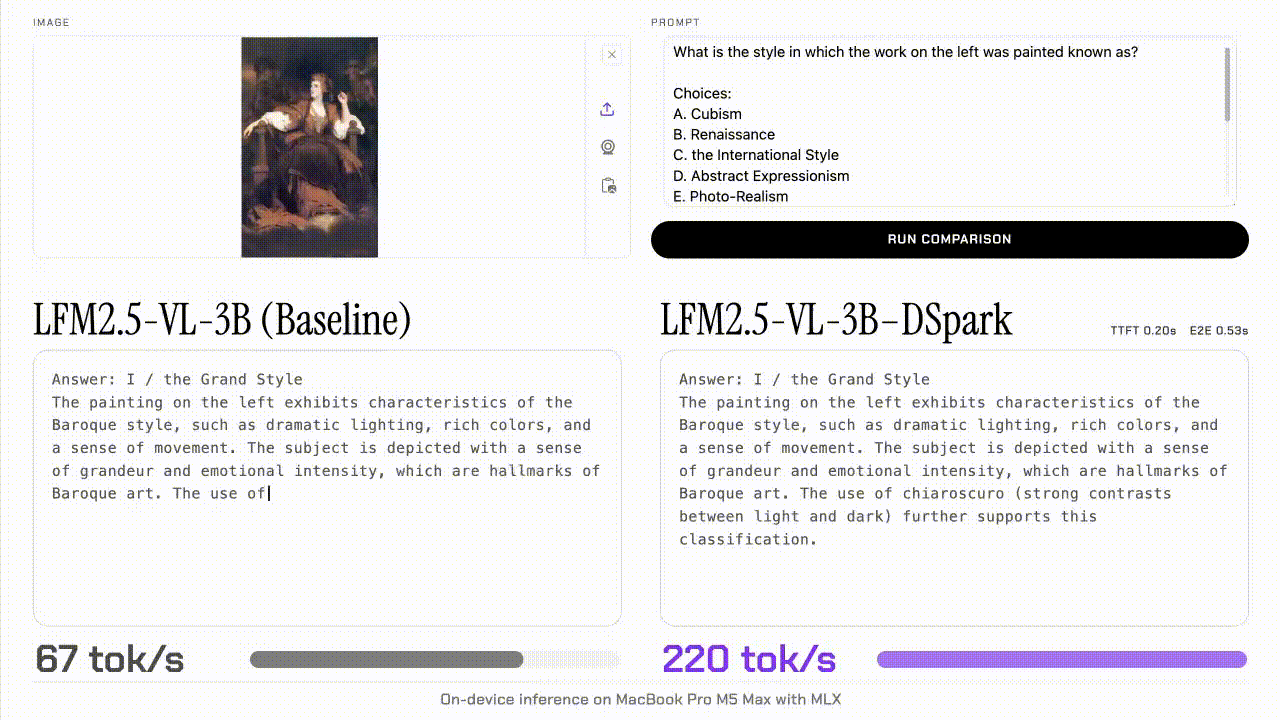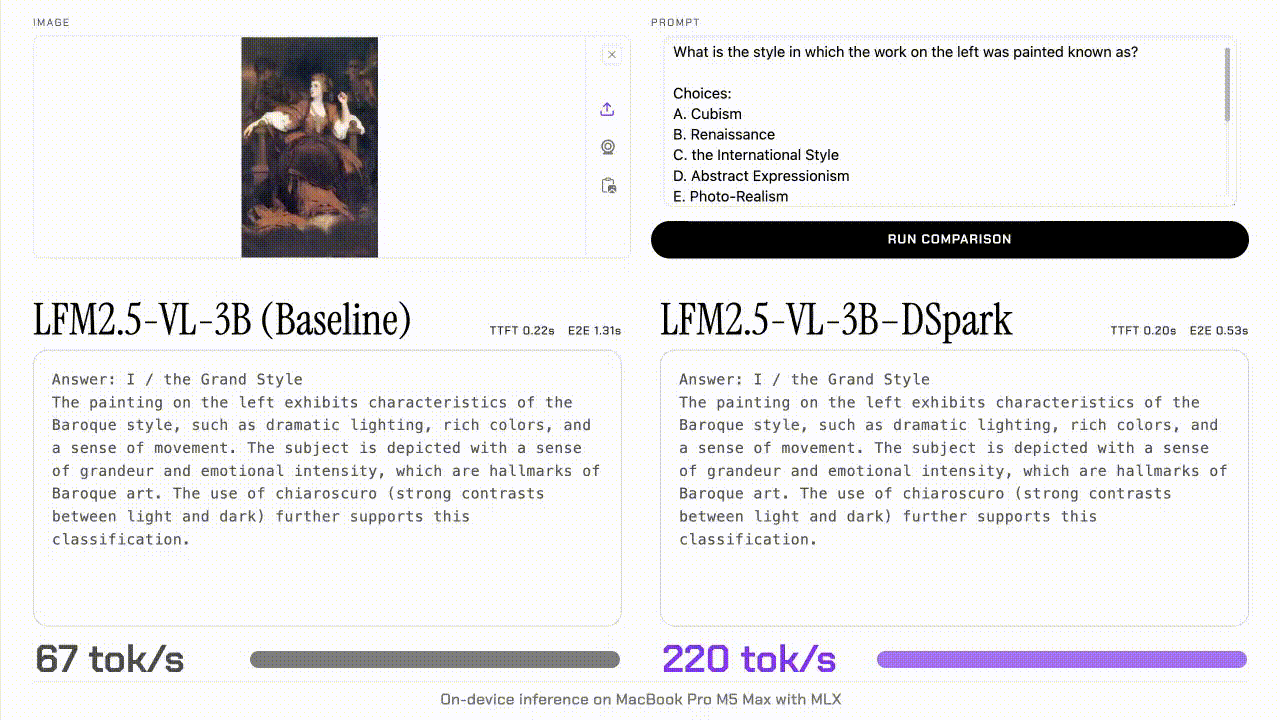
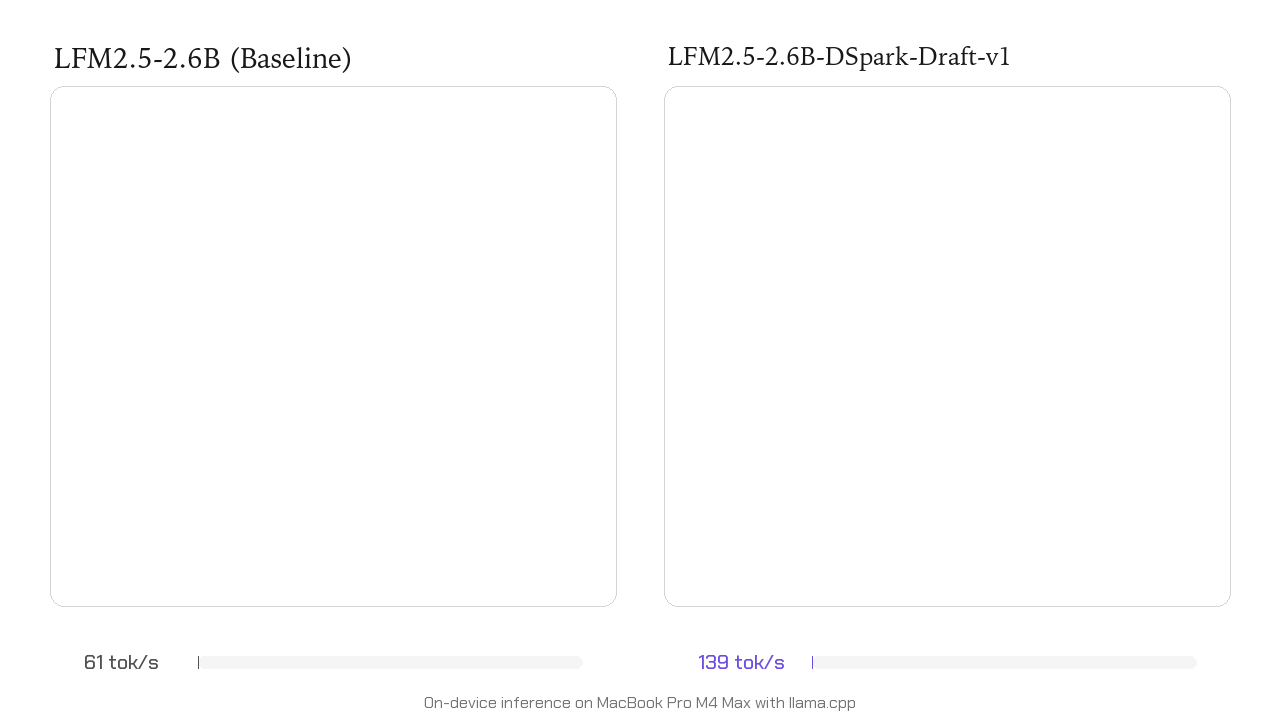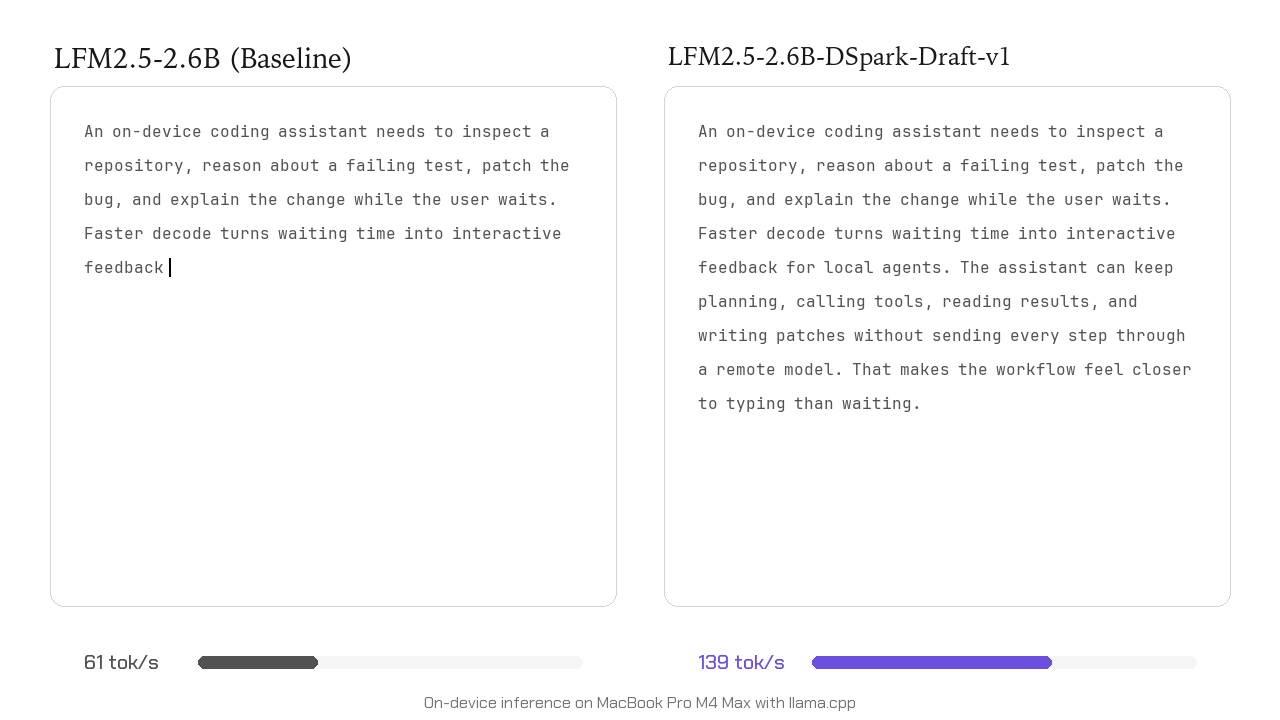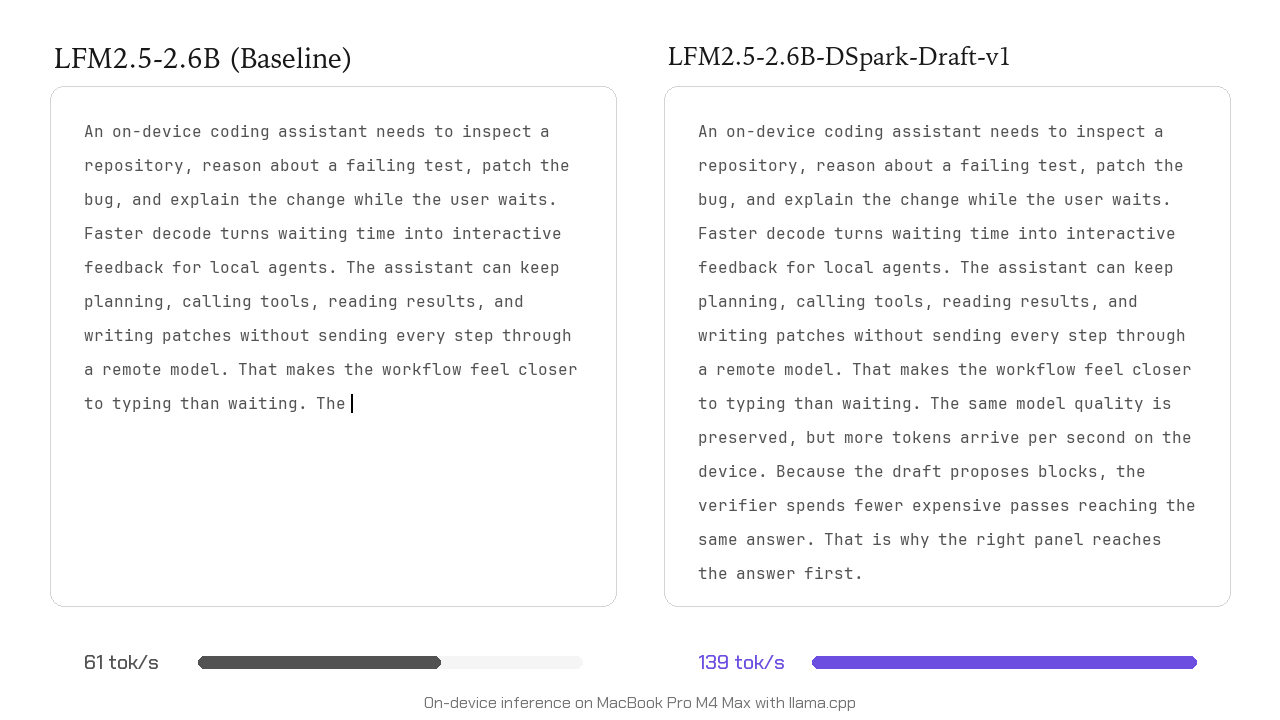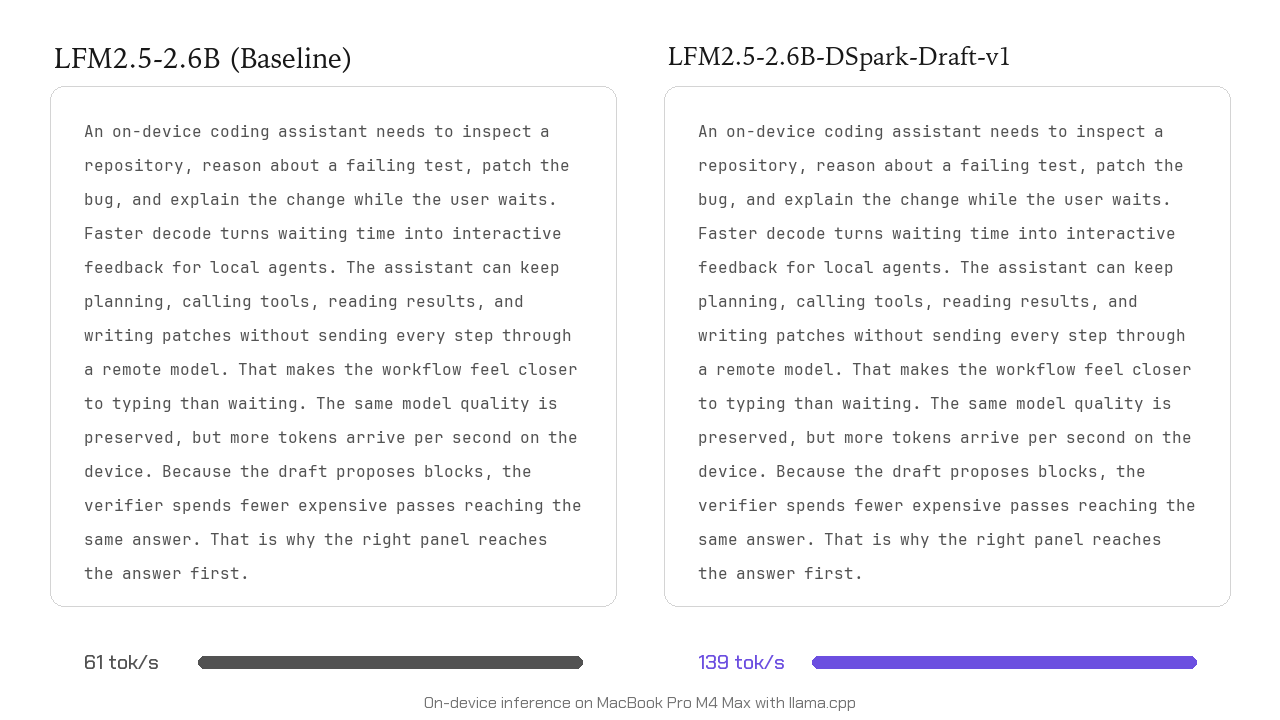
เร่งความเร็ว VLM ด้วย DSpark โมเดลร่างใหม่จาก Liquid AItag: DSpark, LFM2.5-VL, Liquid AI, Speculative Decoding, VLMSep 24, 2026 · By: SirilukPสรุปข่าว 1:18Liquid AI เปิดตัว DSpark รุ่นทดลองสำหรับ LFM2.5-VL-3B ช่วยเร่งความเร็วในการ Decode สูงสุด 3.13 เท่าบนอุปกรณ์พกพา โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม
Liquid AI เปิดตัว LFM2.5-DSpark เร่งความเร็วการประมวลผลโมเดลภาษาได้สูงสุด 3.2 เท่าtag: DSpark, LFM2.5, Liquid AI, LLM Inference, Speculative DecodingAug 21, 2026 · By: SirilukPLiquid AI เปิดตัว DSpark draft model สำหรับโมเดลตระกูล LFM2.5 ช่วยเร่งความเร็วการประมวลผล (inference) สูงสุด 3.2 เท่าบน GPU และอุปกรณ์พกพา ผ่านเทคนิค speculative decoding โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม พร้อมรองรับ llama.cpp และ SGLang ทันที
Tencent เปิดตัว AngelSpec เฟรมเวิร์ก Open-Source เร่งสปีดการเทรน Speculative Decoding ให้โมเดล AItag: AngelSpec, DFly, Hy3, Open-Source, Speculative Decoding, TencentJul 31, 2026 · By: AttapolKTencent เปิดตัว AngelSpec เฟรมเวิร์กแบบ torch-native สำหรับเทรน draft models ช่วยเพิ่มความเร็วในการประมวลผลสูงสุด 2.4 เท่า โดยมาพร้อมสถาปัตยกรรม DFly ที่โดดเด่นด้านงานเขียนโค้ดและคณิตศาสตร์