
Liquid AI เปิดตัว LFM2.5-DSpark เร่งความเร็วการประมวลผลโมเดลภาษาได้สูงสุด 3.2 เท่า
Liquid AI ประกาศเปิดตัว DSpark draft model checkpoints สำหรับโมเดล 3 รุ่นในตระกูล LFM2.5 ได้แก่ LFM2.5-1.2B-Instruct, LFM2.5-2.6B และ LFM2.5-8B-A1B การพัฒนานี้เป็นการเพิ่มกระบวนการถอดรหัสแบบเก็งกำไร (speculative decoding) ที่ใช้หน่วยความจำเพิ่มขึ้นเพียงเล็กน้อย แต่สามารถเพิ่มความเร็วในการประมวลผลได้อย่างมหาศาลโดยไม่ลดทอนคุณภาพของผลลัพธ์
หัวใจสำคัญของการอัปเดตนี้ประกอบด้วยการปรับปรุง throughput สูงสุด 3.18 เท่าบน GPU และสูงสุด 2.87 เท่าสำหรับอุปกรณ์พกพา (on-device) ซึ่งช่วยผลักดันการประมวลผลแบบเอเจนท์บนอุปกรณ์ให้มีประสิทธิภาพยิ่งขึ้น โดยเฉพาะรุ่น LFM2.5-2.6B ที่สามารถลดความหน่วงในการเรียกใช้ฟังก์ชัน (function-calling) ลงเฉลี่ยถึง 57% นอกจากนี้ยังเปิดซอร์สแบบ upstream ให้รองรับ llama.cpp และ SGLang ได้ทันทีตั้งแต่วันแรก
DSpark ทำงานอย่างไร โดยปกติแล้ว ระยะการถอดรหัส (decode phase) ของโมเดลภาษาขนาดใหญ่ (LLM) มักถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ เนื่องจากความหน่วงส่วนใหญ่เกิดขึ้นจากการส่งผ่านข้อมูลน้ำหนักโมเดล (weights) จาก DRAM เข้าสู่ SRAM ไม่ใช่จากการคำนวณ เทคนิค Speculative decoding จึงเข้ามาแก้ปัญหานี้ด้วยการใช้ draft model ขนาดเล็กสร้างโทเค็นที่คาดหวังไว้ก่อน จากนั้นให้ target model ตรวจสอบความถูกต้องทั้งหมดในการส่งผ่านข้อมูลเพียงครั้งเดียว ซึ่งช่วยประหยัดเวลาในการโหลดน้ำหนักโมเดลซ้ำซ้อน
DSpark พัฒนาต่อยอดจากวิธีการเก็งกำไรที่โดดเด่นอย่าง EAGLE-3 และ DFlash โดยรวม 3 องค์ประกอบหลักเข้าด้วยกัน ได้แก่ โครงสร้างหลักแบบขนาน DFlash-style ที่สร้าง hidden states ได้รวดเร็ว, ส่วนหัวแบบลำดับที่มีน้ำหนักเบา (Markov chain) เพื่อเพิ่มอัตราการยอมรับโทเค็น และตัวตรวจสอบแบบกำหนดตารางความมั่นใจที่จะช่วยตัดการประมวลผลส่วนเกินที่ให้ผลตอบแทนไม่คุ้มค่าออกไป
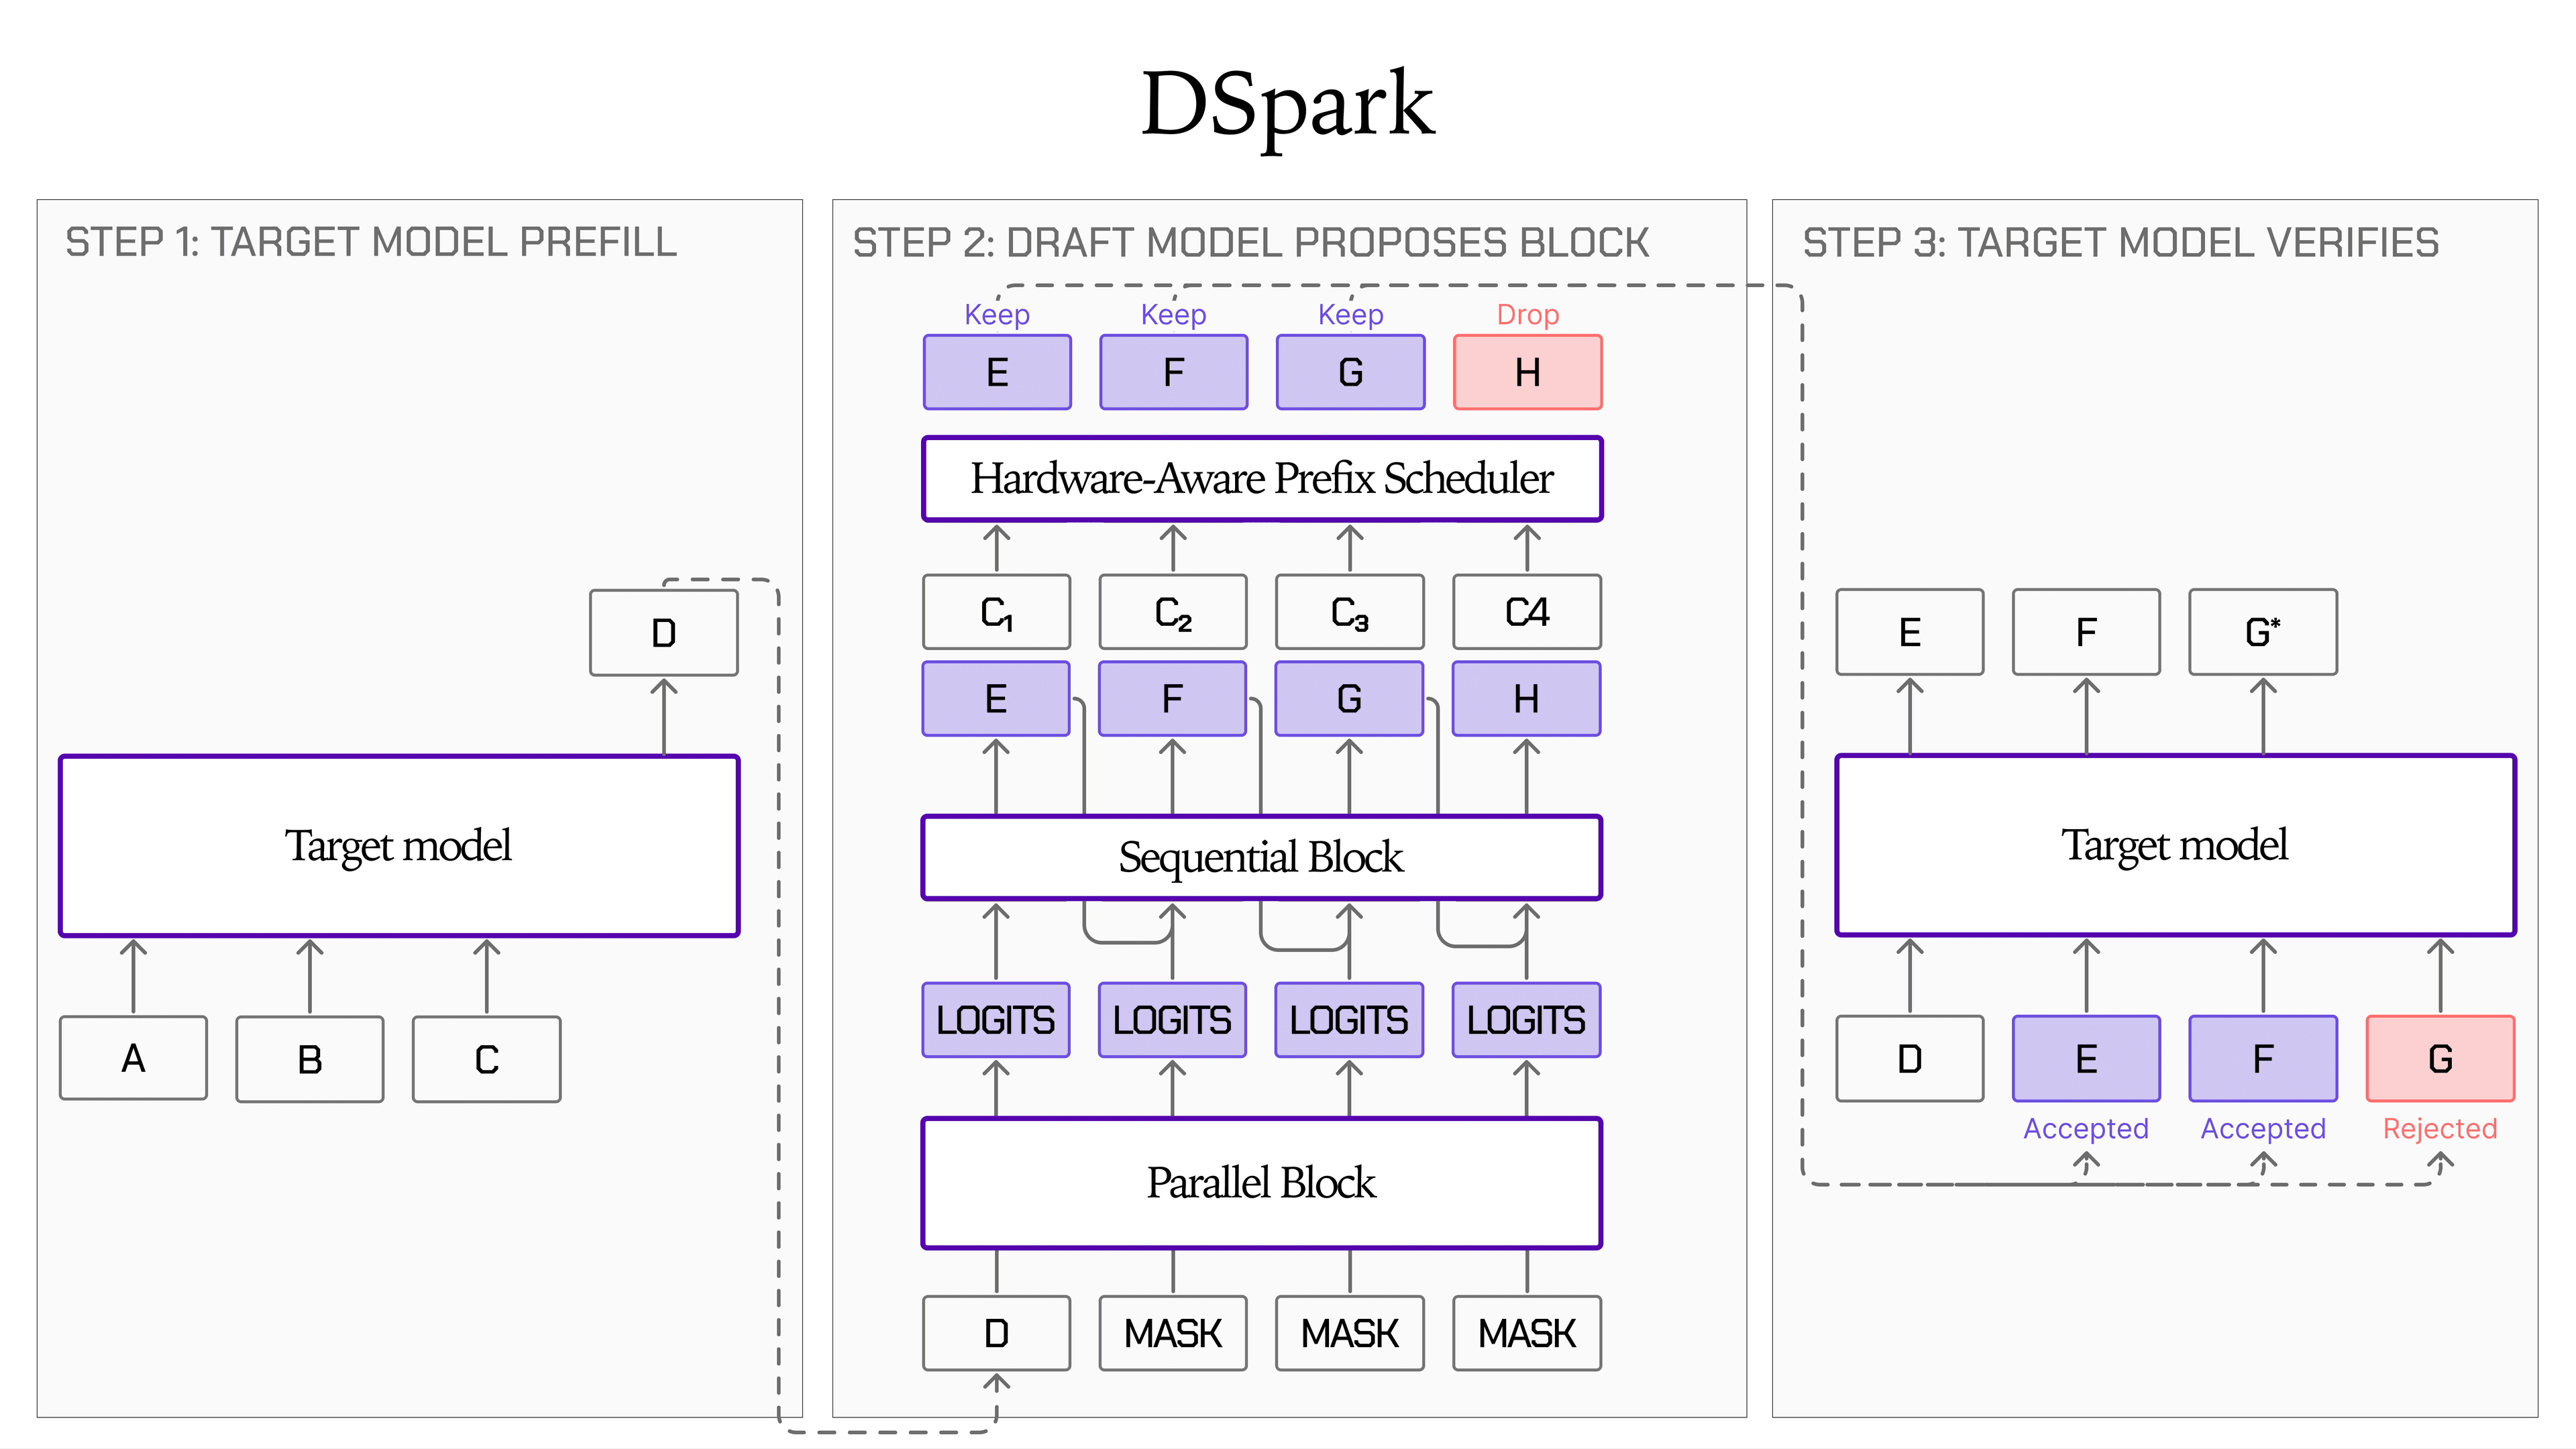
การฝึกฝนและสถาปัตยกรรม
ทีมงานได้ฝึกฝน DSpark ด้วยชุดข้อมูลขนาดใหญ่และหลากหลาย ครอบคลุมทั้งข้อมูลการปรับแต่ง (SFT), การแชท, โค้ด และการเรียกใช้ฟังก์ชัน โดยเลือกใช้โครงสร้างแบบ attention-only 5 เลเยอร์ ที่ปรับให้เรียบง่ายขึ้น ผลลัพธ์ที่ได้คือ draft models ขนาดจิ๋วที่มีพารามิเตอร์เพียงประมาณ 300 ล้านพารามิเตอร์ ซึ่งถือว่าเล็กมากเมื่อเทียบกับประสิทธิภาพที่ได้รับ
สำหรับการทดสอบประสิทธิภาพ ภายใต้การถอดรหัสแบบ greedy โทเค็นจาก draft จะถูกยอมรับก็ต่อเมื่อตรงกับผลลัพธ์ของ target model เท่านั้น หากไม่ตรง target model จะทำหน้าที่แก้ไขให้ถูกต้องทันที ทำให้ลำดับของคำที่ส่งออกมา เหมือนกับผลลัพธ์ปกติทุกประการ โดยไม่มีความแม่นยำใดๆ สูญเสียไป
ความเร็วการประมวลผลบน CPU และ GPU
การวัดผล throughput บนชิป M4 Max (MacBook Pro) ผ่าน llama.cpp และบน NVIDIA H100 ผ่าน SGLang แสดงให้เห็นว่าโมเดลรุ่น LFM2.5-2.6B มีความเร็วเพิ่มขึ้นอย่างน่าทึ่ง โดยบน MacBook นั้นให้ประสิทธิภาพการตอบสนองที่เหนือกว่าโมเดลคลาวด์แบบปิดส่วนใหญ่ ด้วยความเร็วเฉลี่ยกว่า 140 tok/s
| ชุดข้อมูล | การยอมรับ (จาก 10) | ความเร็วเพิ่มขึ้นบน H100 | ความเร็วเพิ่มขึ้นบน M4 Max |
|---|---|---|---|
| MATH500 | 5.42 | 3.06x 326 → 1000 tok/s | 2.25x 61 → 137 tok/s |
| HumanEval | 4.54 | 2.56x 326 → 835 tok/s | 2.63x 61 → 161 tok/s |
| MBPP | 4.71 | 2.64x 326 → 861 tok/s | 2.11x 62 → 132 tok/s |
| GSM8K | 4.32 | 2.22x 312 → 693 tok/s | 2.36x 60 → 143 tok/s |
| MT-Bench | 5.07 | 2.87x 325 → 933 tok/s | 1.99x 62 → 123 tok/s |
| ค่าเฉลี่ย | 4.81 | 2.67x 323 → 864 tok/s | 2.27x 61 → 139 tok/s |
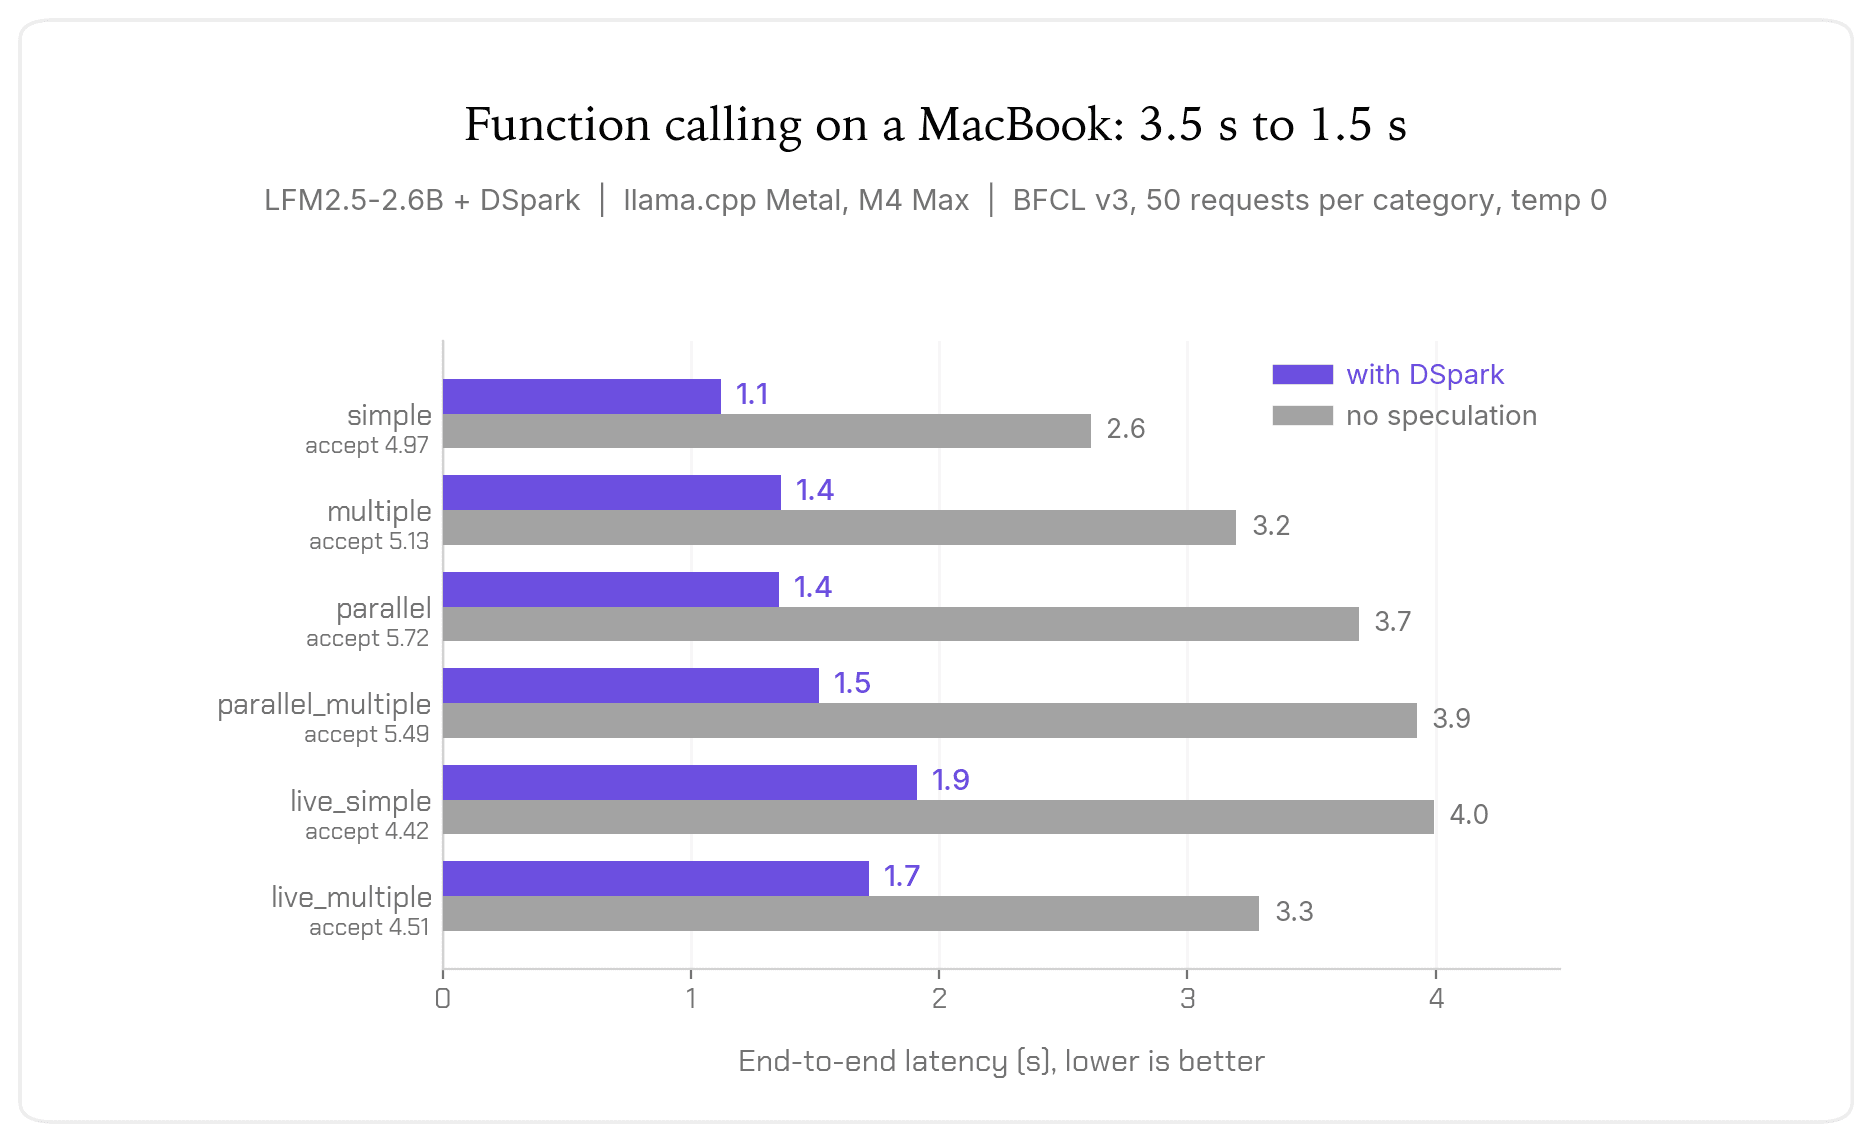
อย่างไรก็ตาม สำหรับรุ่น LFM2.5-8B-A1B แม้จะมีอัตราการยอมรับโทเค็นสูง แต่ความเร็วบนอุปกรณ์พกพาเพิ่มขึ้นเฉลี่ยเพียง 18% เนื่องจากข้อจำกัดของการนำสถาปัตยกรรม MoE (Mixture of Experts) ไปใช้ใน Metal backend ของ llama.cpp ในปัจจุบัน ซึ่งยังคงต้องมีการรับส่งข้อมูลน้ำหนักจำนวนมากในขั้นตอนการตรวจสอบ
วิธีใช้งาน LFM2.5-DSpark
ผู้ใช้งานสามารถรัน DSpark draft models ด้วย SGLang (ตั้งแต่ PR #31041 เป็นต้นไป) โดยเรียกใช้งานโมเดลหลักพร้อมระบุ draft model ดังนี้:
python -m sglang.launch_server \
  --model-path LiquidAI/LFM2.5-2.6B \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path LiquidAI/LFM2.5-2.6B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --disable-radix-cache --mem-fraction-static 0.75 --port 30000
สำหรับผู้ที่ต้องการใช้งานผ่าน llama.cpp สามารถใช้คำสั่งผ่าน llama-server เพื่อเปิดการทำงาน speculative decoding ได้เช่นกัน:
llama-server -m LFM2.5-2.6B-F16.gguf \
  -md LFM2.5-2.6B-DSpark-F16.gguf \
  --spec-type draft-dspark --spec-draft-n-max 10 --spec-draft-n-min 0 \
  -fa on -ngl 99
เริ่มต้นใช้งาน
DSpark draft model checkpoints พร้อมให้ดาวน์โหลดแล้วบน Hugging Face ทั้งในรูปแบบ Safetensors สำหรับการประมวลผลทั่วไป และ GGUF สำหรับการใช้งานบนอุปกรณ์ปลายทางผ่าน llama.cpp
- Safetensors: LFM2.5-2.6B-DSpark, LFM2.5-1.2B-Instruct-DSpark, และ LFM2.5-8B-A1B-DSpark
- GGUF: LFM2.5-2.6B-DSpark-GGUF, LFM2.5-1.2B-Instruct-DSpark-GGUF, LFM2.5-8B-A1B-DSpark-GGUF
การอ้างอิง
สำหรับการนำไปอ้างอิงทางวิชาการ โปรดใช้ข้อมูลดังนี้:
Liquid AI, "LFM2.5-DSpark: Up to 3.2x Faster Inference from H100 to MacBook", Liquid AI Blog, Aug 2026.
@article{liquidAI2026dspark,
  author = {Liquid AI},
  title = {LFM2.5-DSpark: Up to 3.2x Faster Inference from H100 to MacBook},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2.5-dspark},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร