OpenAI เปิดตัว GPT-6.1 Terra โมเดล AI ระดับกลางที่ลดต้นทุน API ลงครึ่งหนึ่งจากรุ่นก่อนหน้า โดยเน้นประสิทธิภาพด้านความฉลาดต่อราคาที่คุ้มค่าสูงสุดสำหรับการทำงานอัตโนมัติและงานออฟฟิศ
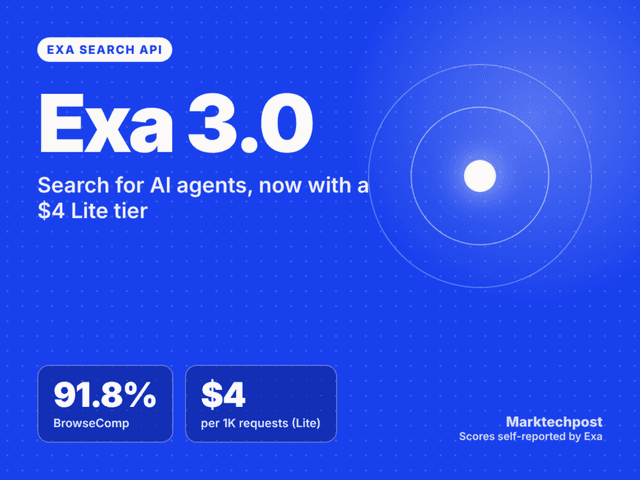
Exa เปิดตัว Search API เวอร์ชัน 3.0 สำหรับ AI Agents พร้อมโมเดล embedding ใหม่และแพลน Lite ราคาประหยัด โดยทำคะแนนนำคู่แข่งในผลการทดสอบประสิทธิภาพที่จัดทำขึ้นเอง
Epoch AI และ MIT พบต้นทุนการทำคะแนนเบนช์มาร์ก AI ลดลงอย่างก้าวกระโดดจากความก้าวหน้าทางอัลกอริทึมและการแข่งขันที่สูงขึ้น แต่โมเดลรุ่นท็อปอาจมีค่าใช้จ่ายสูงขึ้นจากการใช้พลังประมวลผลที่มากขึ้น
Keenable AI เปิดตัว NEEDLE เบนช์มาร์กแบบ Live สำหรับทดสอบ Web Search API เพื่อแก้ปัญหา AI ท่องจำคำตอบจากชุดข้อมูลเก่า โดยระบบจะสร้างชุดคำถามใหม่จากแหล่งข้อมูลสดทุกชั่วโมง
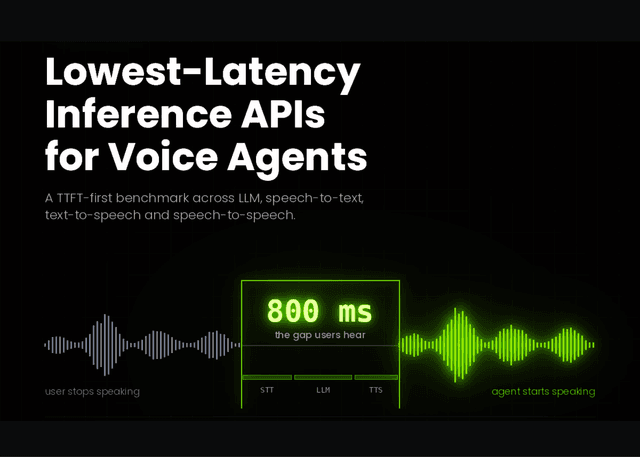
เจาะลึกประสิทธิภาพ Voice Stack ทุกเลเยอร์ตั้งแต่ LLM ถึง Speech-to-Speech พร้อมชี้ให้เห็นว่า Time to First Token (TTFT) อาจไม่ใช่มาตรวัดที่สะท้อนประสบการณ์ผู้ใช้จริงได้ดีเท่ากับความเร็วในการสร้างประโยค
MiLM Plus จาก Xiaomi เปิดตัว PROVE เกณฑ์วัดประสิทธิภาพการลบวัตถุด้วย AI ที่เน้นความสอดคล้องทางสายตาโดยไม่ต้องใช้ภาพต้นฉบับอ้างอิง เพื่อแก้ปัญหาเกณฑ์วัดเดิมที่มักให้คะแนนผิดพลาด
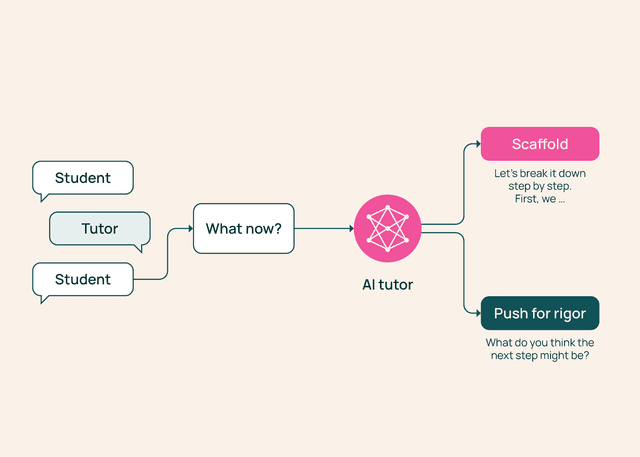
Allen Institute for AI เปิดตัว TutorMoments พรีวิวเฟรมเวิร์กสำหรับประเมินโมเดลภาษา (LLMs) ในบทบาทครูสอนพิเศษ โดยเน้นจุดตัดสินใจสำคัญว่าโมเดลควรยื่นมือเข้าช่วยหรือผลักดันให้นักเรียนใช้ความคิดด้วยตัวเอง
Perplexity AI เปิดตัว WANDR ซึ่งเป็นเบนช์มาร์กแบบเปิดตัวใหม่ที่เน้นการประเมิน AI Research Agent ในการทำงานวิจัยที่ทั้งกว้างและลึกผ่านงานรวบรวมข้อมูลสมจริง 500 รายการ โดยมีการตรวจสอบหลักฐานอ้างอิงและรองรับโครงสร้างข้อมูลที่ซับซ้อน
OpenAI ตรวจสอบเกณฑ์มาตรฐานการเขียนโปรแกรม SWE-Bench Pro พบงานกว่า 30% บกพร่องและคลุมเครือ จนนำไปสู่การยกเลิกการรับรองเพื่อป้องกันความคลาดเคลื่อนในการประเมินความสามารถ AI