
TutorMoments: เฟรมเวิร์กใหม่ทดสอบครูสอนพิเศษ AI เมื่อใดควรช่วย หรือเมื่อใดควรปล่อยให้นักเรียนฝึกคิดเอง
📄 Tech Report: https://tutormoments.allen.ai/static/paper/tutormoments-preview.pdf | 📊 Data: https://huggingface.co/datasets/allenai/tutormoments-preview | 💻 Code: https://github.com/allenai/tutormoments
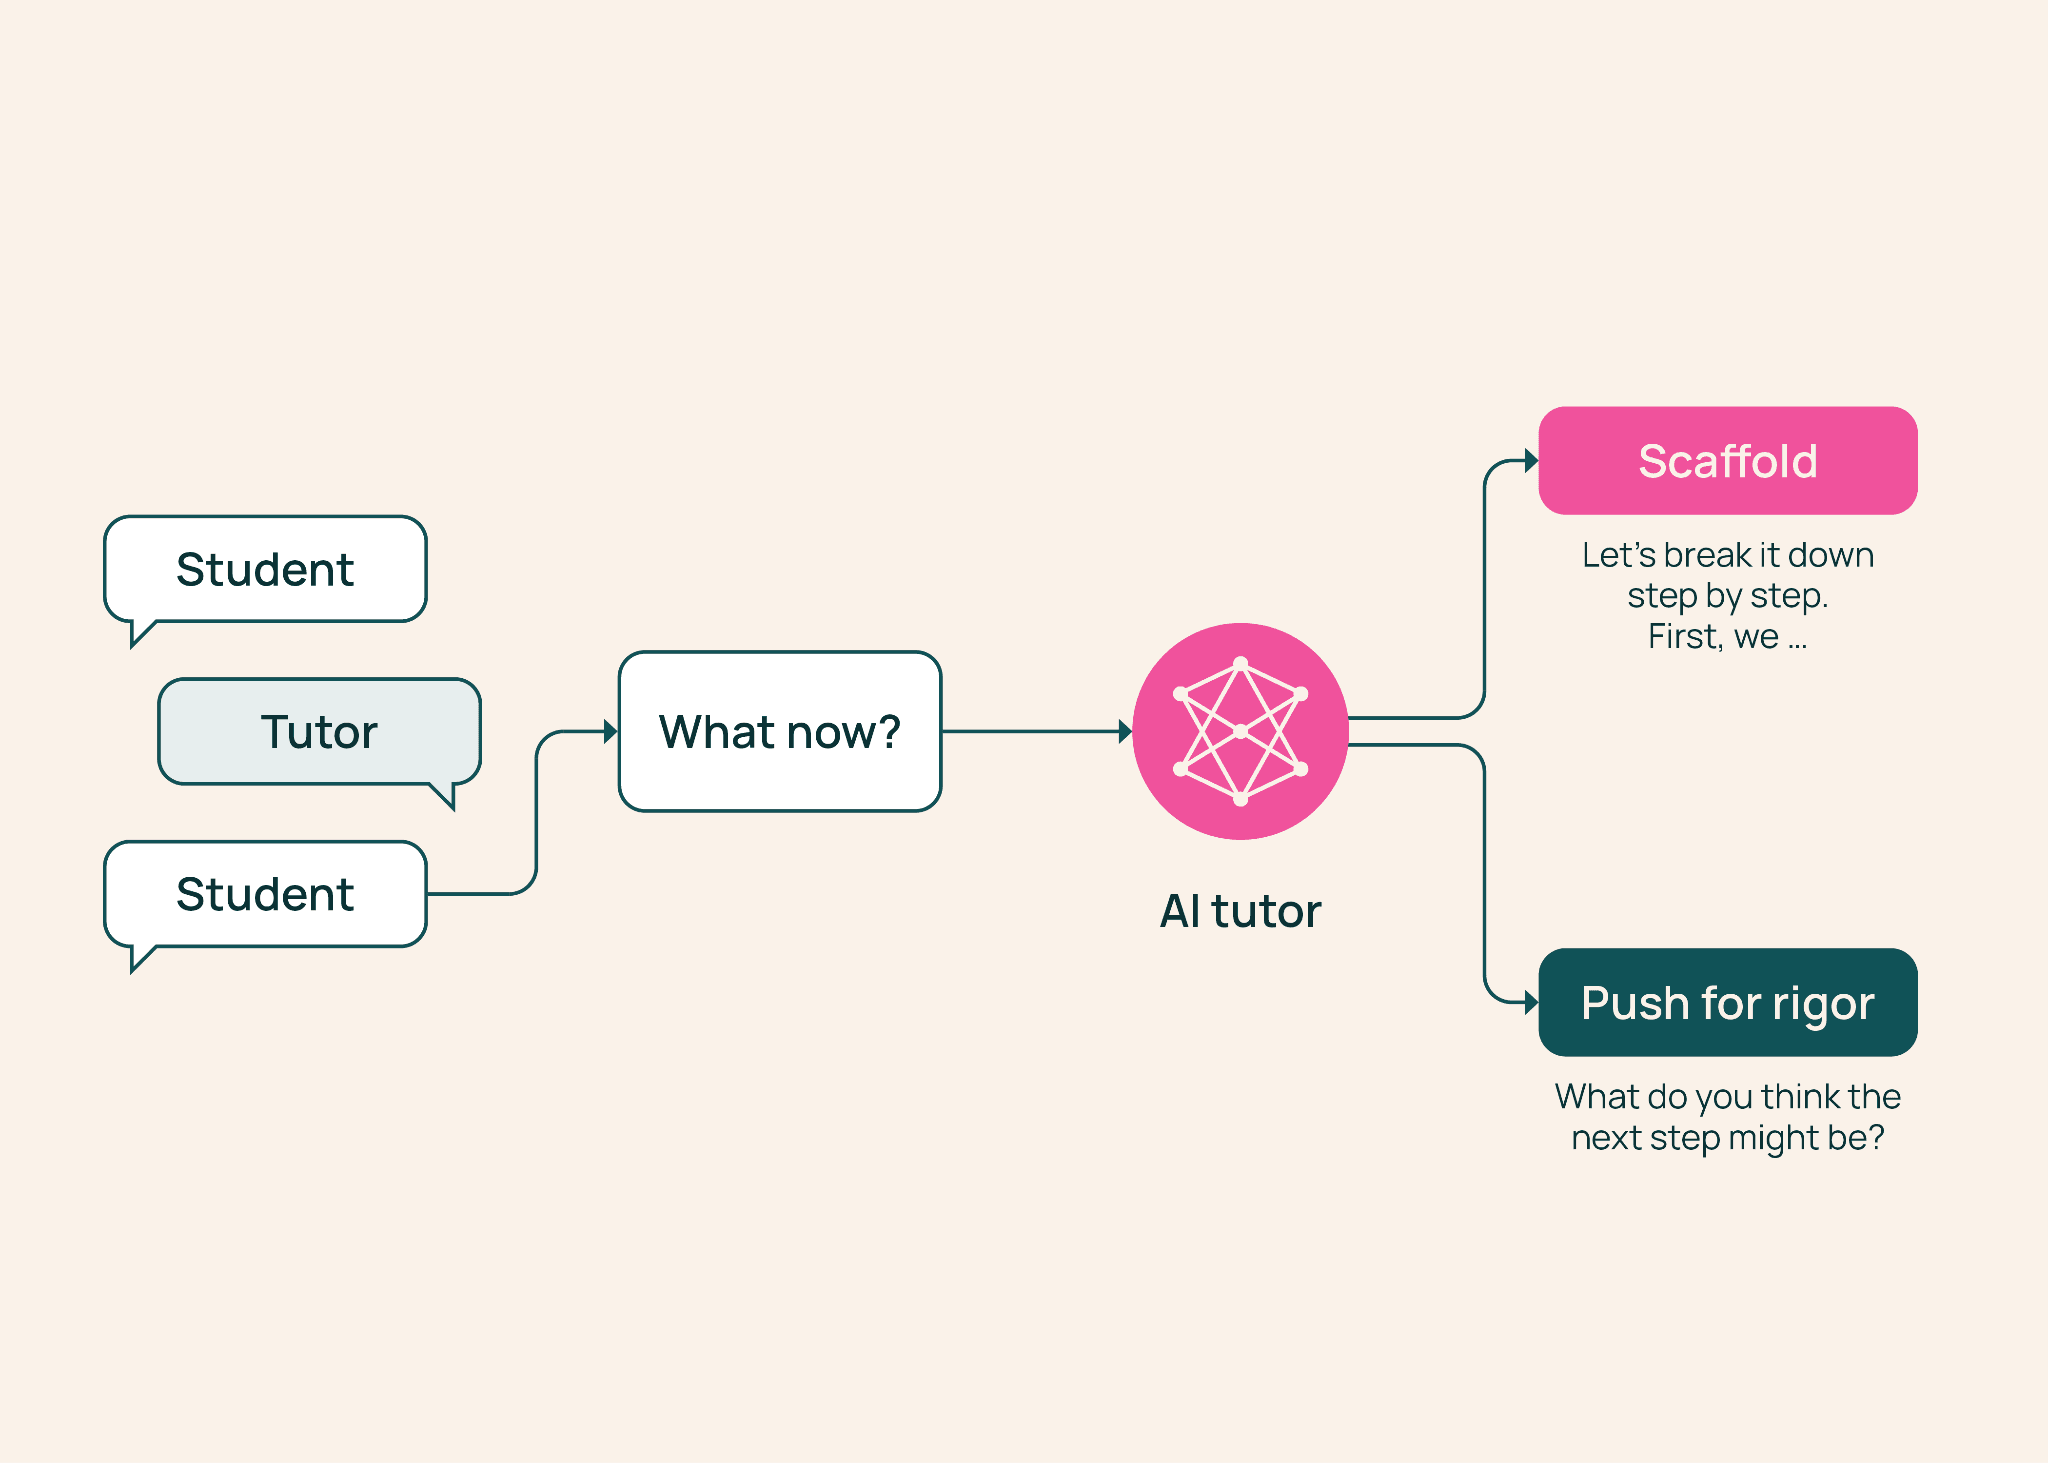
วันนี้เราขอแนะนำพรีวิวของ TutorMoments เฟรมเวิร์กสำหรับวัดผลว่าโมเดลภาษาขนาดใหญ่ (LLMs) ระดับแนวหน้าสามารถสร้างสมดุลในโจทย์ที่ยากที่สุดของการศึกษาได้หรือไม่ นั่นคือการตัดสินใจว่าเมื่อใดควรเข้าไปแทรกแซงเพื่อช่วยนักเรียน และเมื่อใดควรหยุดเพื่อให้เด็กๆ ได้ใช้ความพยายามทำส่วนที่เหลือด้วยตัวเอง
TutorMoments เป็นระบบประเมินผลแบบจำลองเหตุการณ์ซ้ำ (replay-based evaluation) ที่สร้างขึ้นจากเซสชันการสอนคณิตศาสตร์แบบตัวต่อตัวจริง โดยครูสอนคณิตศาสตร์ที่มีประสบการณ์จะอ่านบันทึกการสนทนา (transcripts) จากโครงการสอนพิเศษในสหรัฐฯ เพื่อระบุช่วงเวลาสำคัญที่ครูต้องเลือกระหว่างการทำให้โจทย์ง่ายขึ้นเพื่อให้เริ่มทำได้ กับการผลักดันให้นักเรียนใช้เหตุผลด้วยตัวเอง
กระบวนการทดสอบจะนำบันทึกการสนทนาไปจนถึงจุดตัดสินใจส่งต่อให้โมเดลภาษา เพื่อให้โมเดลทำหน้าที่เป็นครูสอนพิเศษในเซสชันจำลอง โดยมีนักเรียนที่สวมบทบาทโดยโมเดลภาษาอีกตัวหนึ่ง เพื่อสังเกตพฤติกรรมและการตอบสนองของครูสอนพิเศษ AI ว่าจะรับมือกับสถานการณ์นั้นอย่างไร
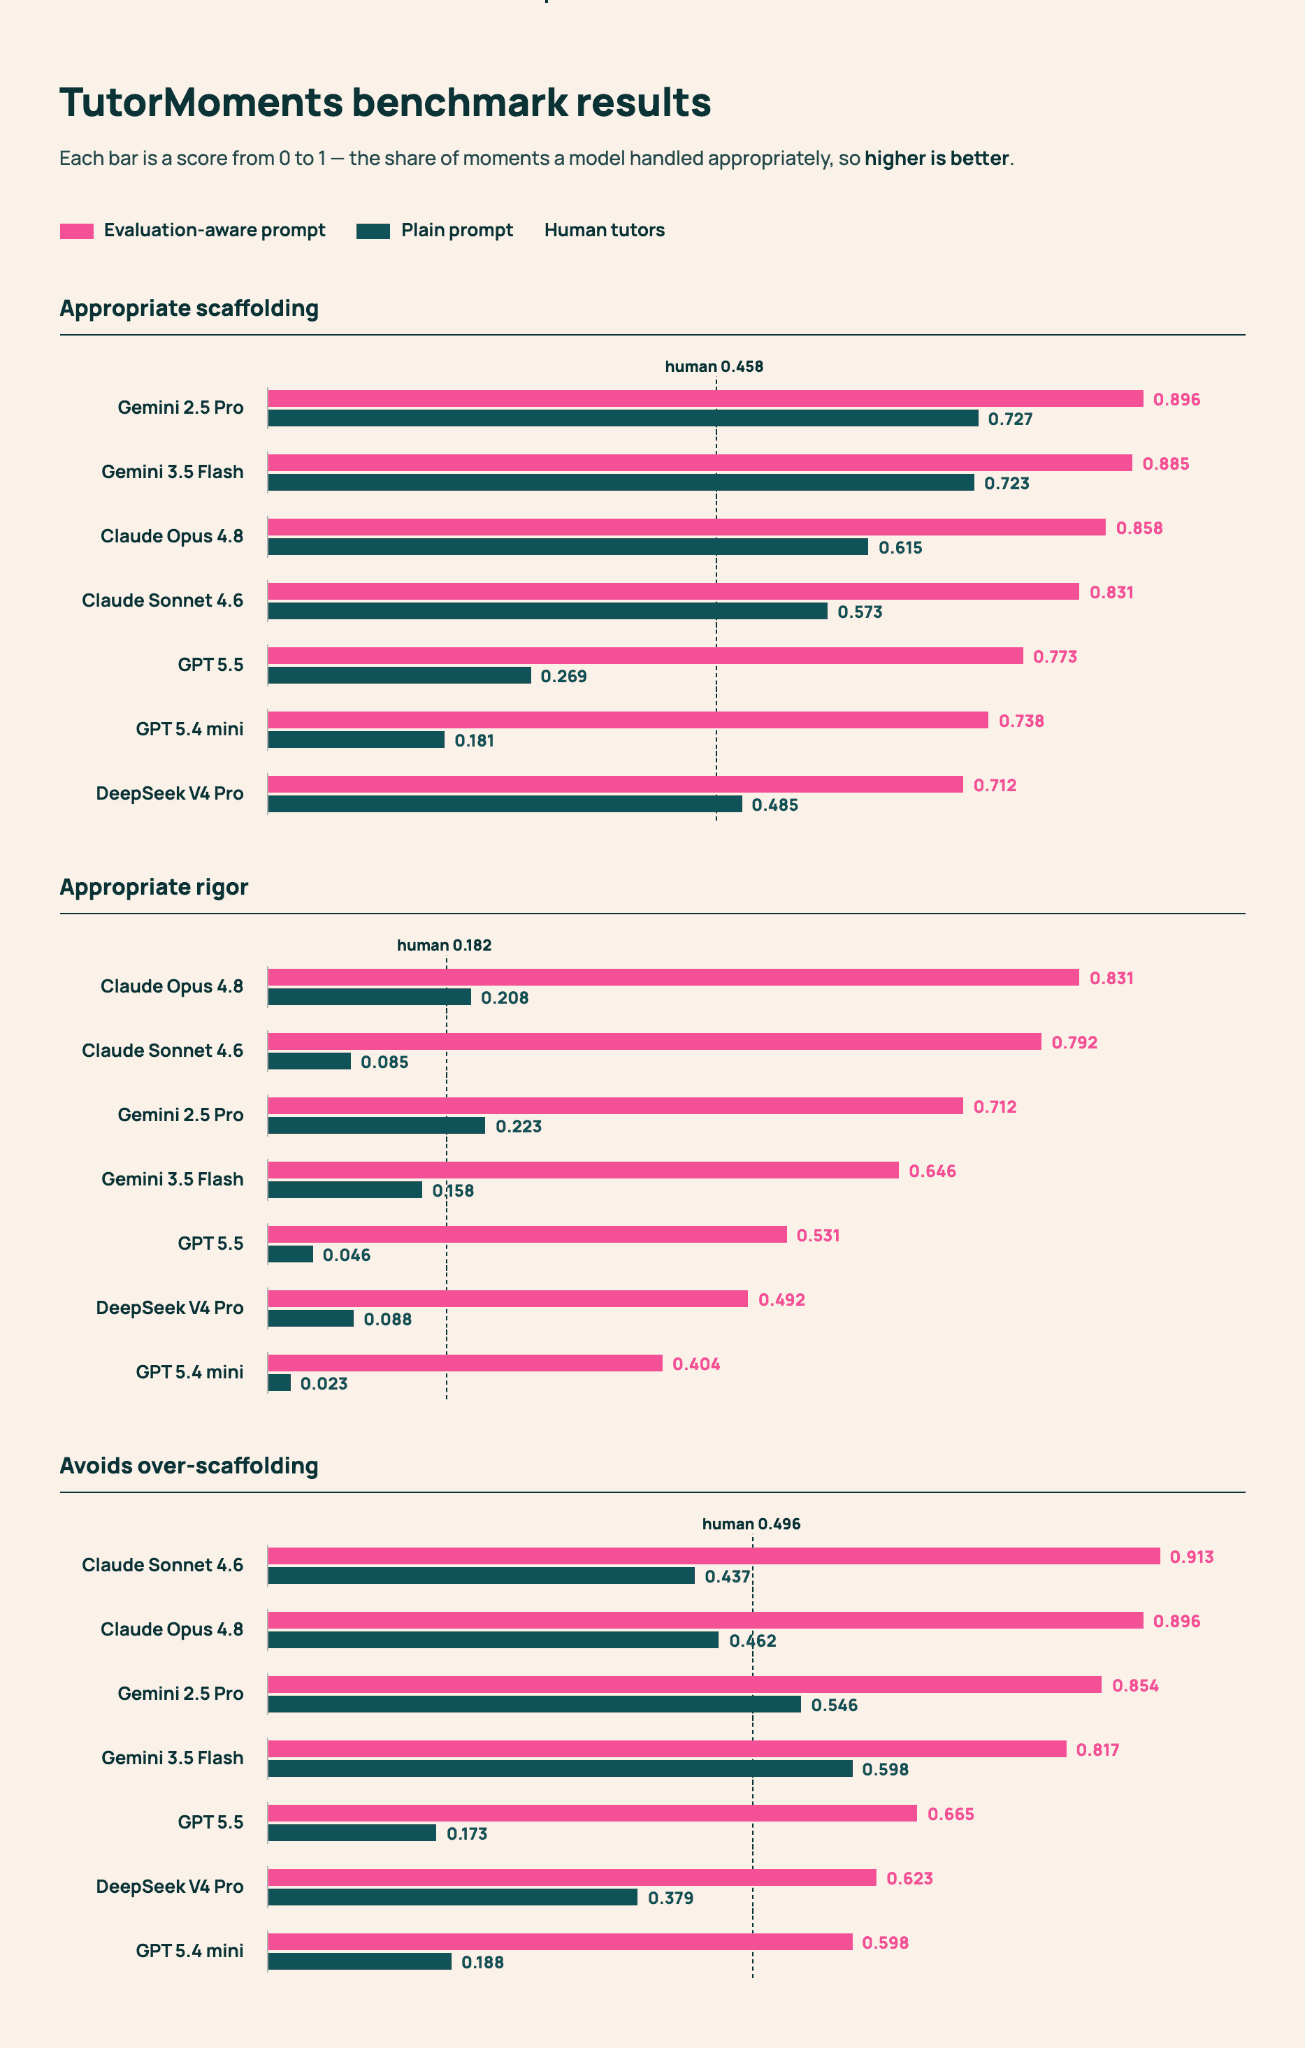
จากการทดสอบพบว่า เมื่อสั่งเพียงแค่ให้ "สอนให้ดี" (tutor well) โมเดลมีแนวโน้มที่จะช่วยเหลือมากเกินไป (over-help) และไม่ค่อยผลักดันให้นักเรียนได้ใช้ความคิดที่ลึกซึ้ง การเพิ่มรายละเอียดใน Prompt เกี่ยวกับความสมดุลระหว่างการช่วยกับการหยุดช่วยสามารถเพิ่มประสิทธิภาพได้ แต่ก็ยังไม่สามารถปิดช่องว่างเมื่อเทียบกับการสอนโดยมนุษย์ที่สอดคล้องกับสถานการณ์จริงได้อย่างสม่ำเสมอ เพื่อเป็นส่วนหนึ่งของความมุ่งมั่นในการวิจัยแบบเปิด เราได้เผยแพร่ ชุดข้อมูลของบันทึกการสนทนาการสอนที่ปิดบังตัวตน, โค้ดสำหรับรัน replay pipeline ของเรา และการจำลองเหตุการณ์ซ้ำของโมเดลเพื่อความโปร่งใส เราหวังว่า TutorMoments จะช่วยให้นักวิจัยมีวิธีที่เฉียบคมขึ้นในการพัฒนาครูสอนพิเศษ AI ที่ปรับตัวเข้าหาผู้เรียนแทนที่จะทำงานแทนพวกเขา
อะไรทำให้เป็นครูสอนพิเศษที่ดี?
ส่วนหนึ่งของการสอนที่มีประสิทธิภาพคือการวินิจฉัยว่านักเรียนรู้อะไรอยู่แล้ว และให้การสนับสนุนที่เหมาะสมในขณะนั้น การรีบยื่นมือเข้าช่วยทันทีอาจเป็นการขโมยโอกาสในการฝึกฝนทางสติปัญญาของนักเรียน ซึ่งเป็นปัจจัยสำคัญที่ช่วยให้เกิดการเรียนรู้ การทำความเข้าใจจุดสมดุลนี้จึงเป็นหัวใจสำคัญของการสอน
อย่างไรก็ตาม โมเดลภาษามักถูกฝึกมาให้เป็นผู้ช่วยที่มีประโยชน์ ซึ่งมักจะทำส่วนที่ยากแทนคุณ เช่น การอธิบายแนวคิดหรือนำทางไปสู่คำตอบโดยตรง ในบริบทการศึกษา สิ่งนี้อาจตัดทอน "ความพยายามที่ก่อเกิดผล" (productive struggle) หรือการพยายามแก้ปัญหาที่ยากซึ่งงานวิจัยระบุว่าช่วยให้เกิดความเข้าใจที่แข็งแกร่งกว่า
เกณฑ์ชี้วัด (benchmarks) ส่วนใหญ่ในปัจจุบันมักไม่ได้จับประเด็นความตึงเครียดนี้ โดยมักจะให้รางวัลแก่พฤติกรรมตายตัว เช่น การไม่บอกคำตอบเลย หรือการให้คำใบ้เสมอ แต่การสอนที่ดีคือการใช้ดุลพินิจว่าในวินาทีนั้น นักเรียนคนนี้ต้องการอะไรสำหรับโจทย์ข้อนี้กันแน่
TutorMoments ทำงานอย่างไร
TutorMoments สร้างขึ้นจากข้อมูลการสอนจริงในชุดข้อมูล TutorMoments-Preview ประกอบด้วยบันทึกการสนทนา 462 ชุดจากการสอนคณิตศาสตร์เกรด 2-7 ในสหรัฐฯ พร้อมช่วงเวลาสำคัญกว่า 1,500 ช่วงที่ผ่านการประเมินโดยครูผู้เชี่ยวชาญ 27 ท่าน ข้อมูลทั้งหมดถูกปิดบังตัวตนเพื่อความเป็นส่วนตัวตามข้อกำหนดการวิจัย
ครูผู้เชี่ยวชาญจะระบุจุดตัดสินใจที่ต้องชั่งน้ำหนักระหว่าง scaffolding (การช่วยสร้างนั่งร้านทางปัญญา) กับ pushing for rigor (การผลักดันให้ใช้ความคิดที่เข้มข้นขึ้น) จากนั้นระบบจะให้ LLM สวมบทครูสอนต่อจากจุดนั้น 5 รอบสนทนา และใช้ scoring pipeline ให้คะแนนใน 3 ด้าน ได้แก่ การช่วยเมื่อจำเป็น, การผลักดันเมื่อนักเรียนพร้อม และการหลีกเลี่ยงการช่วยมากเกินความจำเป็น
ผลลัพธ์เบื้องต้น
เราทดสอบ LLMs 7 รุ่นผ่าน TutorMoments โดยใช้ Prompt สองรูปแบบ: แบบทั่วไป (plain) และแบบที่ระบุรายละเอียดการสอน (evaluation-aware) ผลปรากฏว่าทุกรุ่นทำคะแนนได้ดีขึ้นอย่างชัดเจนเมื่อใช้ Prompt ที่เจาะจง สะท้อนว่าพฤติกรรม "ผู้ช่วย" โดยค่าเริ่มต้นของ AI นั้นยังไม่เพียงพอสำหรับการเป็นครูที่ดี
ข้อสังเกตที่น่าสนใจคือ แม้คะแนนของโมเดลจะดูสูงกว่ามนุษย์ในบางด้าน แต่อาจเป็นเพราะชุดข้อมูลเน้นไปที่จุดที่มนุษย์ทำพลาดเพื่อให้เห็นโอกาสในการปรับปรุง นอกจากนี้ยังพบว่ามนุษย์มีกลยุทธ์การสอนที่หลากหลายกว่ามาก ในขณะที่ AI มักจะวนอยู่กับการขอให้นักเรียนอธิบายคำตอบเพียงอย่างเดียว
ข้อจำกัดและขั้นตอนต่อไป
TutorMoments ยังอยู่ในช่วงเริ่มต้น การประเมินอัตโนมัติอาจให้สัญญาณพฤติกรรมได้ดีแต่ไม่สามารถแทนที่การทดสอบกับนักเรียนจริงได้ นอกจากนี้ชุดข้อมูลยังจำกัดอยู่ในบริบทวิชาคณิตศาสตร์ระดับประถมและมัธยมต้นในสหรัฐฯ เท่านั้น
เรากำลังเผยแพร่พรีวิวนี้เพื่อรับข้อคิดเห็นสำหรับการพัฒนาชุดข้อมูลในรูปแบบสื่อผสม (multimodal) ที่ใหญ่ขึ้น และสร้างระบบประเมินที่แข็งแกร่งยิ่งขึ้นในอนาคต
กิตติกรรมประกาศ
โครงการนี้เป็นไปได้ส่วนหนึ่งด้วยการสนับสนุนจาก Gates Foundation และ Learning Commons
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร