
Datalab เปิดตัว Marker v2: โชว์ผลทดสอบ Benchmark ชนะขาดทั้งความเร็วและความแม่นยำเหนือคู่แข่ง
Datalab ได้เปิดตัว Marker 2 ซึ่งเป็นการเขียนระบบไพพไลน์การแปลงเอกสารแบบ open source ใหม่ทั้งหมด รองรับการแปลงไฟล์ได้หลากหลายทั้ง PDF, รูปภาพ, PPTX, DOCX, XLSX, HTML และ EPUB ให้กลายเป็นรูปแบบ markdown, JSON, HTML หรือ chunks
ทีมงาน Datalab สร้างระบบขึ้นมาใหม่โดยผสานส่วนประกอบสำคัญ 3 ส่วนที่เปิดตัวในช่วงที่ผ่านมา ได้แก่ Surya OCR 2, โมเดลเลย์เอาต์ความเร็วสูงขนาด 20M-param และ pdftext ล่าสุดที่ทำงานเร็วกว่าเดิมถึง 3 เท่า
ผลการทดสอบผ่าน olmOCR-bench ซึ่งเป็นเกณฑ์มาตรฐานจากบุคคลที่สามโดย Allen AI พบว่า Marker 2’s ในโหมด balanced ทำคะแนนภาพรวมได้ 76.0% และสูงถึง 83.5% สำหรับไฟล์ PDF แบบ born-digital
ในด้านประสิทธิภาพการประมวลผล Marker 2 สามารถทำความเร็วได้ 2.9 หน้าต่อวินาทีบน GPU B200 เพียงตัวเดียว ซึ่งคิดเป็นความครอบคลุม (throughput) ที่มากกว่าไพพไลน์ของ MinerU ถึง 5 เท่า (MinerU ทำได้ 72.7% ที่ความเร็ว 0.54 หน้าต่อวินาที) ขณะที่ Docling ทำคะแนนได้ 50.3% ที่ความเร็ว 2.1 หน้าต่อวินาทีบนชุดทดสอบเดียวกัน
มีอะไรใหม่ใน Marker 2
Marker 2 มาพร้อมเส้นทางการแปลงข้อมูล 3 โหมดเพื่อตอบโจทย์การใช้งานที่แตกต่างกัน:
- balanced — ใช้ Surya VLM จัดการเลย์เอาต์และทำ OCR ใหม่เมื่อจำเป็น ให้คุณภาพสูงสุด เหมาะสำหรับ GPU โดยทำคะแนนได้ 76.0% บน olmOCR-bench
- fast — ใช้ตัวตรวจจับเลย์เอาต์ rf-detr/onnx น้ำหนักเบาควบคู่กับ pdftext ใช้ VLM เฉพาะจุดที่จำเป็น ทำคะแนนได้ 66.6% และประหยัดทรัพยากรอย่างมาก
- –disable_ocr — ดึงข้อมูลจาก text-layer โดยตรง ไม่ใช้ VLM รันบน CPU ทั้งหมด ทำคะแนนได้ 43.6% ด้วยความเร็วสูงถึง 23.7 หน้าต่อวินาที
ระบบเวอร์ชันปัจจุบันเป็น device-aware โดยค่าเริ่มต้น ซึ่งจะเลือกใช้โหมด balanced บน GPU และโหมด fast บน CPU/MPS โดยอัตโนมัติ การปรับปรุงสถาปัตยกรรมยังช่วยให้ CPU worker จำนวนมากสามารถแชร์ Surya inference server ตัวเดียวกันได้ ส่งผลให้ throughput ขยายตัวตามความสามารถของเซิร์ฟเวอร์แทนที่จะจำกัดอยู่ที่ VRAM ต่อกระบวนการ
สำหรับการอัปเกรดมีจุดที่ควรระวัง (Breaking changes) คือต้องใช้ Python 3.10 ขึ้นไป และเปลี่ยนมาจัดการแพ็กเกจด้วย uv โดยใช้ hatchling เป็น build backend นอกจากนี้ยังมีการตัดตัวแปลง structured-extraction และตัวสกัดข้อมูลออก โดยแนะนำให้ขยับไปใช้ API แบบ hosted หรือเวิร์กโฟลว์ –use_llm แทน
การเปรียบเทียบ
การวัดผลใช้เกณฑ์ olmOCR-bench จาก Ai2 ซึ่งประกอบด้วย PDF 1,403 ไฟล์ และการทดสอบย่อยกว่า 8,400 รายการ ครอบคลุมทั้งสูตรคณิตศาสตร์ โครงสร้างตาราง และการสแกนเอกสารเก่า โดยตัวเลขประสิทธิภาพชี้ให้เห็นว่าผลลัพธ์อาจแตกต่างกันไปตามชุดเอกสารของแต่ละองค์กร
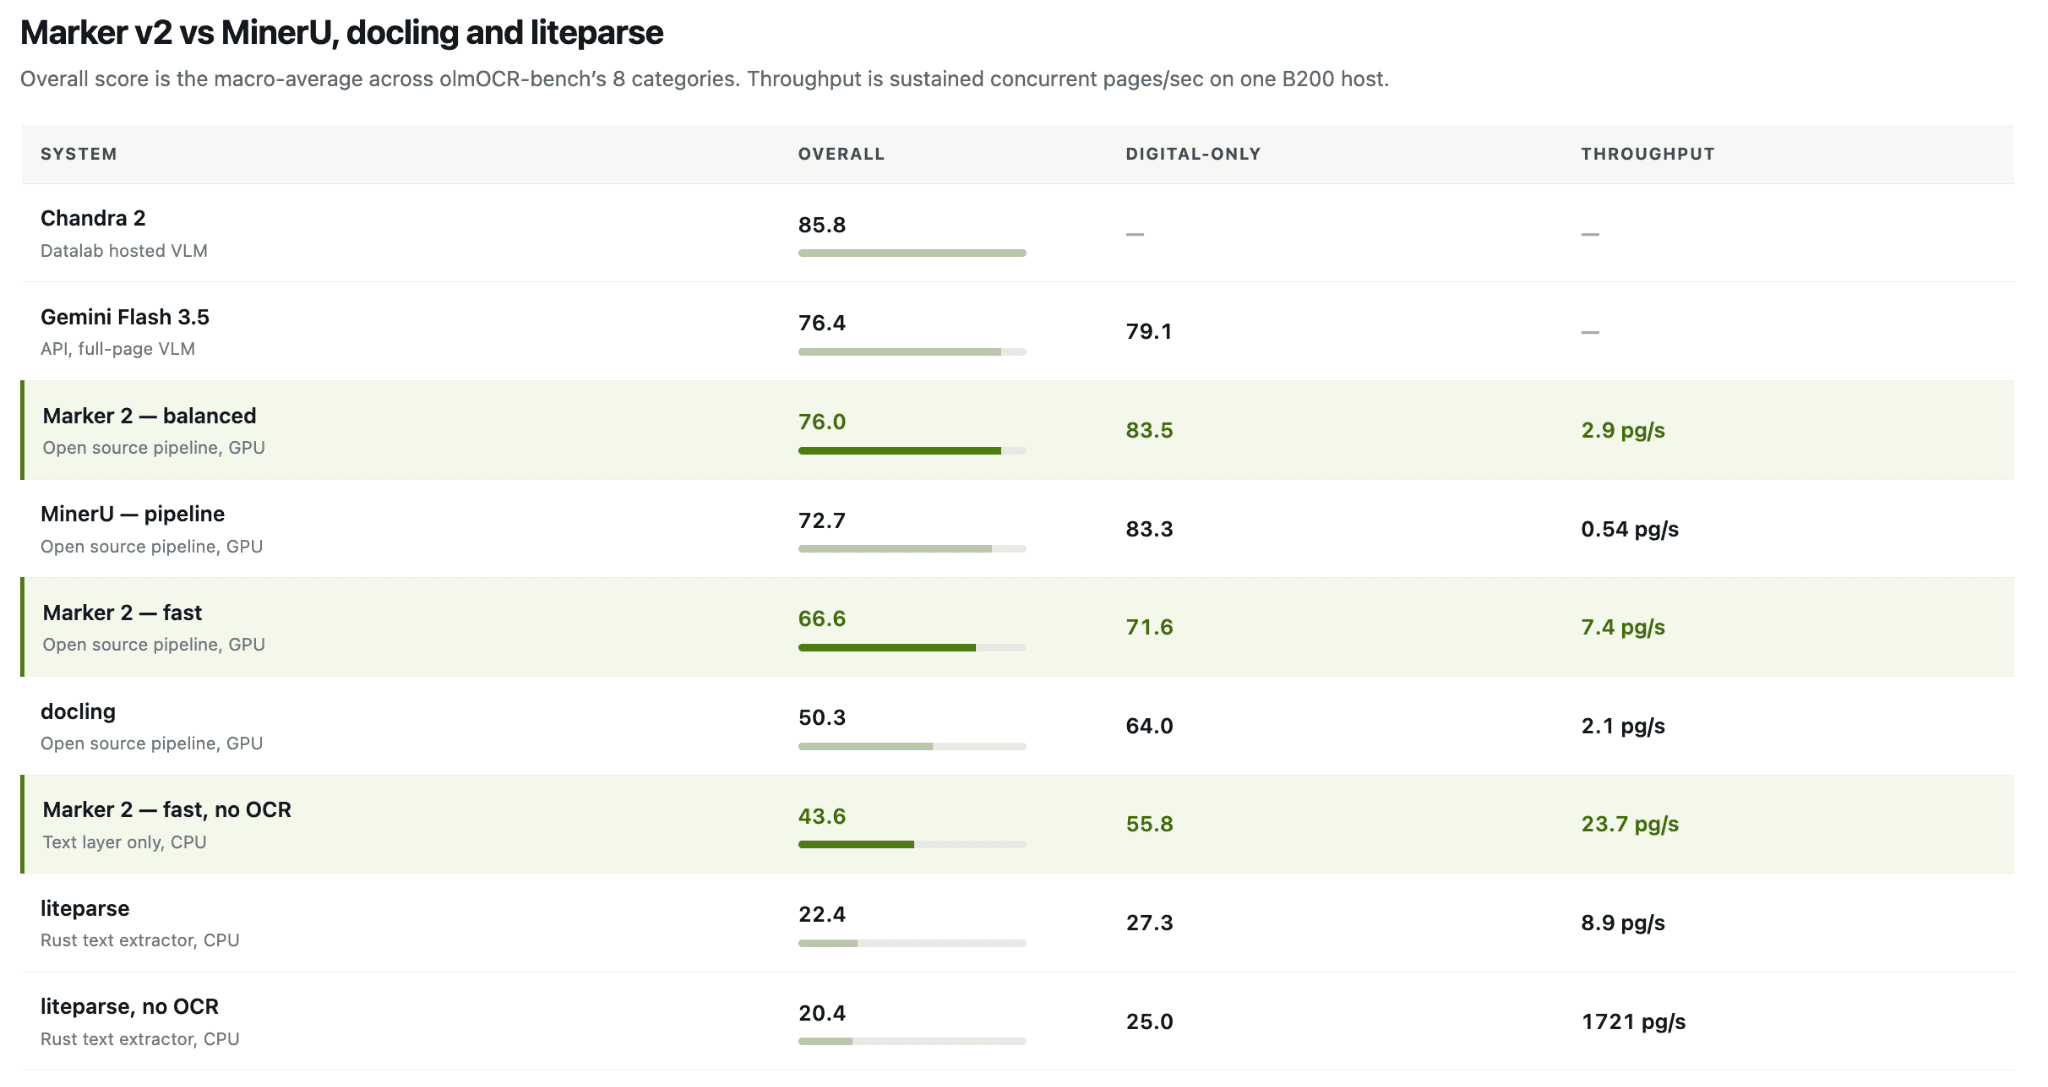
Marker 2 vs MinerU
แม้ทั้งคู่จะมีสถาปัตยกรรมที่ใกล้เคียงกัน แต่ Marker balanced นำอยู่ในด้านคะแนนรวมที่ 76.0 ต่อ 72.7 โดยจุดที่ต่างกันอย่างชัดเจนคือความเร็ว ซึ่ง Marker เร็วกว่า MinerU ถึง 5.4 เท่า ในขณะที่โหมด fast ของ Marker สามารถทำความเร็วได้มากกว่า MinerU ถึง 13.7 เท่า แม้คะแนนความแม่นยำจะลดลงมาบ้างเล็กน้อย
Marker 2 vs Docling
ในกลุ่มไพพไลน์ที่ใช้ GPU พบว่า Marker balanced มีส่วนต่างชนะ Docling อย่างชัดเจนทั้งในด้านความแม่นยำ (76.0% ต่อ 50.3%) และความเร็ว (2.9 ต่อ 2.1 หน้าต่อวินาที) อย่างไรก็ตาม Docling ยังมีจุดแข็งอยู่ที่การได้รับสิทธิ์การใช้งานแบบ MIT-licensed และรองรับไฟล์ที่หลากหลายกว่า รวมถึงไฟล์เสียงและอีเมล
Marker 2 vs LiteParse
LiteParse จากทีม LlamaIndex เน้นความเร็วบน CPU เป็นหลัก ซึ่งสามารถทำความเร็วได้ถึง 1721 หน้าต่อวินาที เมื่อปิด OCR เร็วกว่าโหมด CPU ของ Marker ถึง 73 เท่า แต่คะแนนความแม่นยำจะต่ำกว่ามากเนื่องจากไม่มีโมเดลเลย์เอาต์ ทำให้การกู้คืนโครงสร้างผิดพลาดในข้อมูลที่ไม่ใช่เชิงเส้น
Marker 2 vs ระดับ full-page VLM
Datalab ระบุว่า Marker คือไพพไลน์ไม่ใช่ VLM โดยตรง ซึ่งในงานที่ต้องการความแม่นยำสูงสุดอย่างเอกสารสแกนหรือสูตรคณิตศาสตร์จำนวนมาก ระดับ VLM อย่าง Chandra 2 (85.8%) หรือ Gemini Flash 3.5 (76.4%) ยังคงทำได้ดีกว่า อย่างไรก็ตาม Marker 2 ในโหมด balanced สามารถลดช่องว่างความแม่นยำลงมาเหลือเพียง 0.4 จุดเมื่อเทียบกับ Gemini Flash 3.5 โดยไม่ต้องพึ่งพา API รายหน้า
พฤติกรรมในแต่ละหมวดหมู่
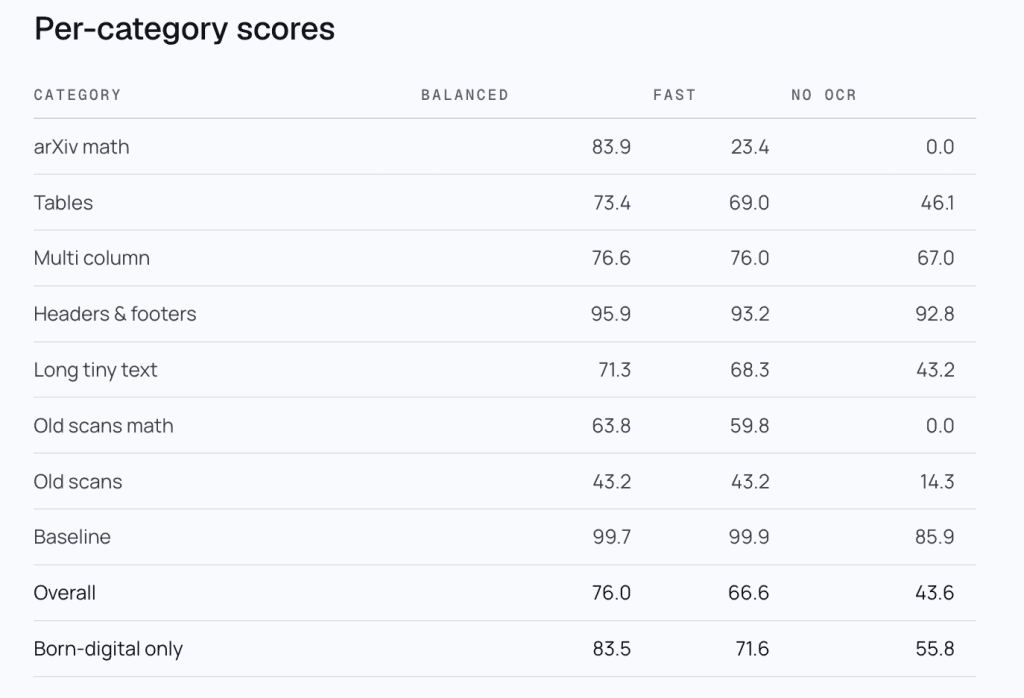
การเลือกโหมดจะส่งผลต่อรูปแบบความผิดพลาดที่เกิดขึ้น เช่น งานด้านคณิตศาสตร์จะเป็นจุดที่โหมด fast เสียคะแนนมากที่สุดเนื่องจากการดึงข้อมูลจาก text-layer พลาดส่วนที่เป็นสูตร ขณะที่การสแกนเอกสารเก่า (Old scans) ยังเป็นจุดที่ทุกโหมดทำคะแนนได้ค่อนข้างต่ำโดยมีคะแนนสูงสุดเพียง 43.2
การอนุญาตใช้งาน (Licensing)
ความแตกต่างสำคัญในเชิงพาณิชย์ที่ผู้ใช้ต้องพิจารณา:
- Marker: โค้ดเป็น Apache 2.0 แต่ค่าน้ำหนักโมเดล (Model weights) ต้องซื้อไลเซนส์หากเป็นองค์กรที่มีรายได้หรือเงินทุนเกิน 5 ล้านเหรียญสหรัฐ
- MinerU: ใช้ไลเซนส์ Apache 2.0 ที่เพิ่มเงื่อนไขว่าต้องขออนุญาตเชิงพาณิชย์หากมี MAU เกิน 100 ล้าน หรือรายได้เกิน 20 ล้านเหรียญสหรัฐต่อเดือน
- Docling: ใช้ไลเซนส์ MIT ซึ่งมีความยืดหยุ่นสูงสุด
สรุปประเด็นสำคัญ
- Marker 2 balanced ให้ประสิทธิภาพความเร็วสูงกว่า MinerU ถึง 5 เท่าบนความแม่นยำที่ 76.0%
- เร็วกว่าและแม่นยำกว่า Docling ในทุกมิติการทดสอบ
- LiteParse ครองแชมป์ความเร็วบน CPU แต่แลกมาด้วยความแม่นยำที่ลดลงเหลือ 20.4%
- โหมด Fast –disable_ocr ของ Marker ทำงานบน CPU ได้โดยไม่ต้องใช้ inference server ที่ความเร็ว 23.7 หน้าต่อวินาที
ช่องทางติดตามข้อมูลเพิ่มเติม: GitHub repo | Release notes | Blog post | Announcement tweet
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร