
Ant Group เปิดตัว LingBot-World-Infinity: โมเดลโลกแบบ Causal 14B จำลองวิดีโอ 60 นาทีแบบเรียลไทม์
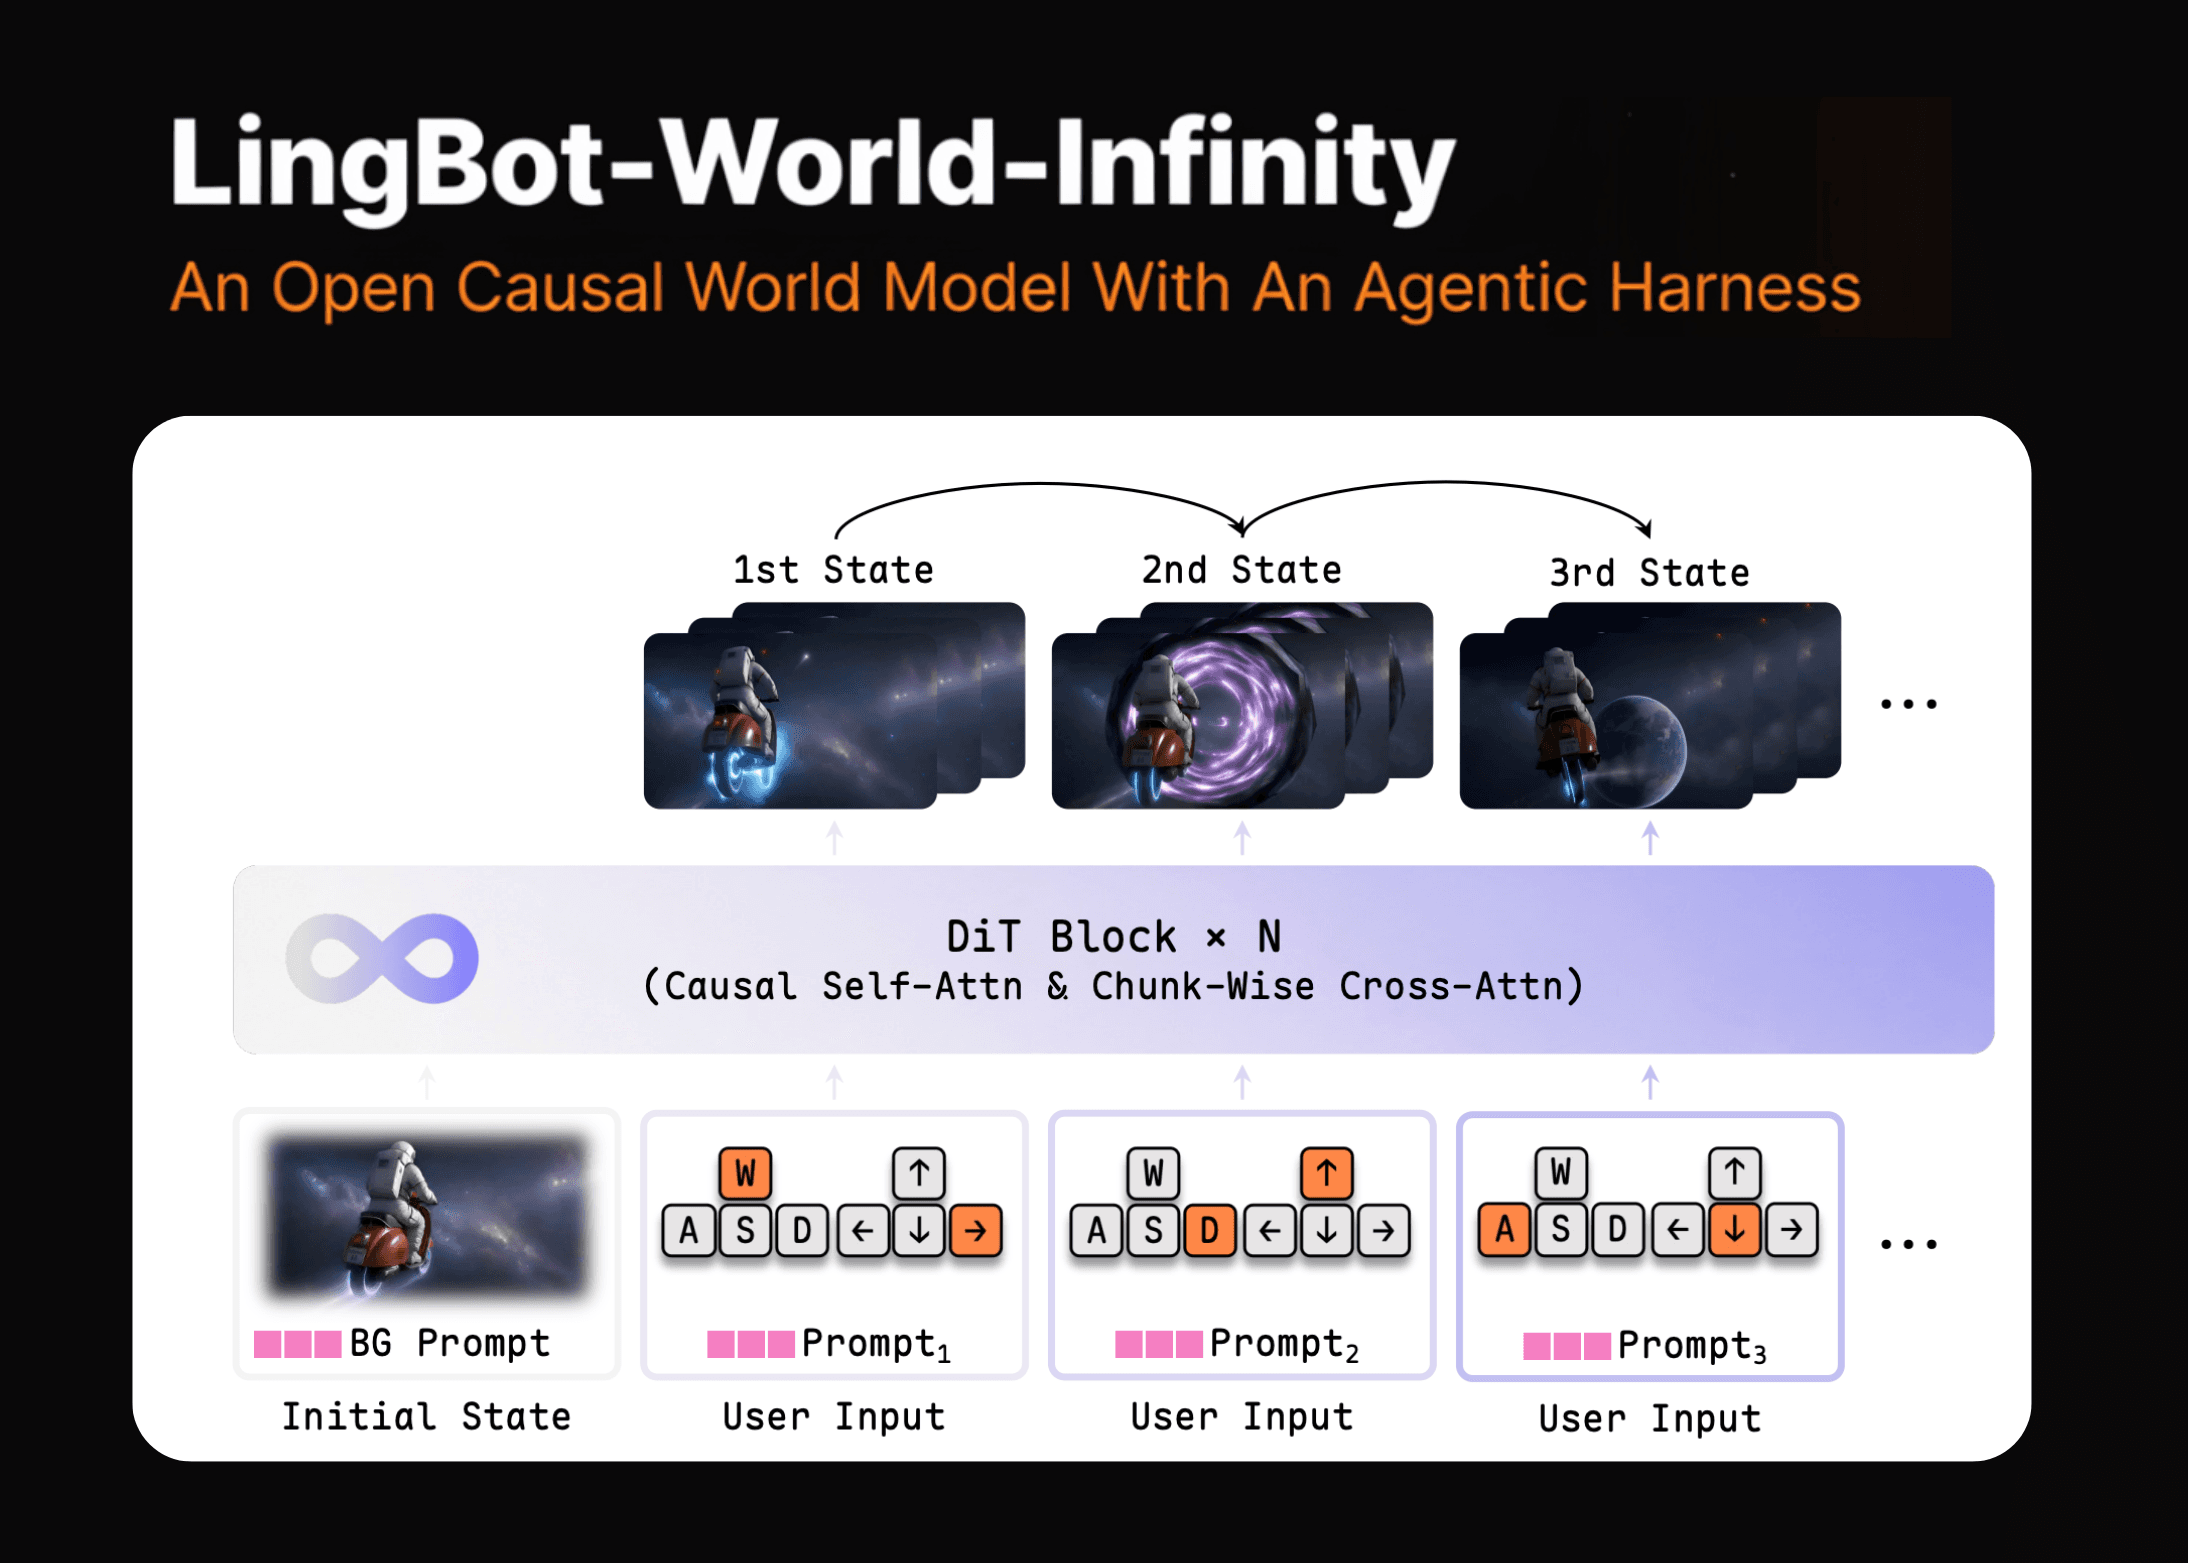
Robbyant หน่วยงานด้าน embodied-intelligence ของ Ant Group ได้เปิดตัว LingBot-World-Infinity (LingBot-World 2.0) โมเดลสร้างวิดีโอแบบ Causal ที่ทำหน้าที่เป็นตัวจำลองโลกเสมือนแบบโต้ตอบได้ (Interactive World Simulator) โดยทีมวิจัยมุ่งเน้นแก้ปัญหาสำคัญสองประการคือ การเลื่อนไหลของภาพในระยะยาว (long-horizon drift) และความหน่วงในการตอบสนอง (interactive latency)
LingBot-World-Infinity คืออะไร?
โมเดลโลกแบบโต้ตอบจะสร้างวิดีโอทีละเฟรม ตามคำสั่งการกระทำของผู้ใช้ โดยแต่ละสถานะจะคำนวณจากเฟรมในอดีตและอินพุตปัจจุบันเท่านั้น ทีมวิจัยได้กำหนดรูปแบบนี้เป็นการแยกปัจจัยเชิงเหตุผล (Causal Factorization):
p_θ(x_1:T | a_1:T) = Π_t p_θ(x_t | x_<t, a_≤t)
ในที่นี้ x_t คือสถานะทางภาพ ณ เวลา t ส่วนการกระทำ a_t จะประกอบด้วยการเคลื่อนกล้อง (camera pose) และข้อความพรอมต์ (text prompt) โดยท่าทางกล้องจะใช้ Plücker embeddings ส่งผ่าน adaptive layer normalization (AdaLN) และข้อความจะถูกป้อนเข้าสู่ระบบแบบพรอมต์รายส่วน (chunk-wise prompts) ผ่านทาง cross-attention
การอัปเกรด 4 ด้านที่เหนือกว่า LingBot-World รุ่นแรก:
- ขยายขอบเขตการโต้ตอบได้ไม่จำกัดพร้อมรักษาคุณภาพผลลัพธ์ให้สม่ำเสมอ
- รุ่นย่อยที่ผ่านการ Distilled สามารถทำงานแบบเรียลไทม์ รองรับวิดีโอ 720p ที่ 60 fps
- เพิ่มพื้นที่การกระทำ (action space) ที่หลากหลาย เช่น การโจมตี การยิงธนู การร่ายเวทมนตร์ และการยิงปืน
- โครงสร้างเอเจนต์ (Agentic Harness) ที่ผสมผสานการทำงานระหว่าง Pilot Agent และ Director Agent
โมเดลหลักมีขนาด 14B และมีรุ่นคู่ขนานขนาดเล็ก 1.3B ที่สามารถใช้งานบน GPU เพียงตัวเดียวได้
สถาปัตยกรรม: MoBA และการฝึกฝนสองขั้นตอน
นวัตกรรมหลักคือ Mixture of Bidirectional and Autoregressive (MoBA) Attention Mask ที่ออกแบบมาเพื่อแก้ปัญหาการเลื่อนไหลของภาพ (Drift) โดยปกติการฝึกวิดีโอแบบ Autoregressive มักเกิดปัญหา Overfitting เมื่อบริบทเพิ่มขึ้นจนโมเดลพึ่งพาแต่อดีตมากเกินไปจนคุณภาพภาพลดลง MoBA จึงเพิ่มบล็อก bidirectional full-attention เข้าไปทำหน้าที่เป็นตัวควบคุม (Regularizer) ช่วยให้โมเดลจัดการวิดีโอที่มีความยาวแบบยืดหยุ่นได้ดีขึ้น
การฝึกฝนแบ่งเป็นสองช่วงคือ Pre-training ที่ปรับปรุงด้วยเป้าหมาย conditional flow-matching และ Post-training ที่บีบอัดโมเดลตัวสอน (Teacher) มาเป็นตัวเรียน (Student) ผ่านกระบวนการ:
- Consistency distillation: เพื่อให้การพยากรณ์มีความสอดคล้องกันตามเส้นทาง PF-ODE
- Distribution matching distillation (DMD): ทีมวิจัยใช้ DMD กับวิถีแบบระยะยาว (long self-rollout trajectories) เพื่อให้ตัวเรียนปรับตัวตามสถานะที่เกิดจากการคาดการณ์ของตัวเอง ช่วยต่อต้านการเกิดภาพเบลอหรือรูปทรงบิดเบี้ยว (Anti-drift)
โครงสร้างเอเจนต์: หัวใจของการโต้ตอบ
Robbyant ได้ติดตั้งระบบ Director-Pilot Co-Simulation Framework เพื่อให้โมเดลทำงานได้อย่างสมบูรณ์
ในรายงานวิจัยระบุว่า Vision-Language Model (VLM) ทำหน้าที่เป็น Director คอยควบคุมกฎเกณฑ์เชิงความหมายและการใช้เหตุผลในภาพรวม ส่วน Diffusion Transformer (DiT) คือ Pilot ที่ทำหน้าที่สร้างภาพและเรนเดอร์การเปลี่ยนแปลงทางกายภาพระดับละเอียด
โหมดการโต้ตอบหลัก:
โหมด A: การโต้ตอบเชิงความหมายโดยตรง (Direct Semantic Interaction) VLM จะวิเคราะห์เฟรมปัจจุบันและสร้างการ์ดเหตุการณ์ขึ้นมาโดยไม่ต้องใช้ object masks
โหมด B: การโต้ตอบกับวัตถุด้วยการติดตาม (Tracking-Assisted Object Interaction) ใช้พื้นฐานจาก SAM (Segment Anything Model) เพื่อติดตามวัตถุ ผู้ใช้สามารถเลือกวัตถุและสั่งการกระทำ เช่น การเปิดประตู หรือหมุนลูกบอล
นอกจากนี้ยังรองรับการป้อนคำสั่งข้อความเพื่อเปลี่ยนสภาพแวดล้อม เช่น เปลี่ยนจากกลางวันเป็นกลางคืน หรือ เสกสิ่งมีชีวิตขึ้นมาในตำแหน่งที่สมเหตุสมผลผ่าน VLM
การใช้งานจริง: สิ่งที่มีให้ในปัจจุบัน
ชุดรหัสต้นฉบับพัฒนาขึ้นบน Wan2.2 โดยขณะนี้เปิดให้ดาวน์โหลดเฉพาะรุ่น lingbot-world-v2-14b-causal-fast เท่านั้น ส่วนรุ่นอื่นยังอยู่ในสถานะ TODO
git clone https://github.com/robbyant/lingbot-world-v2.git
cd lingbot-world-v2
pip install -r requirements.txt            # torch >= 2.4.0
pip install flash-attn --no-build-isolation
huggingface-cli download robbyant/lingbot-world-v2-14b-causal-fast \
  --local-dir ./lingbot-world-v2-14b-causal-fast
สำหรับการรันคำสั่งอ้างอิงที่ความละเอียด 480P บน 8-GPU:
torchrun --nproc_per_node=8 generate.py \
  --task i2v-A14B --size 480*832 \
  --ckpt_dir lingbot-world-v2-14b-causal-fast \
  --image examples/03/image.jpg --action_path examples/03 \
  --dit_fsdp --t5_fsdp --ulysses_size 8 \
  --frame_num 361 --local_attn_size 18 --sink_size 6 \
  --prompt "A serene lakeside scene with a lone tree standing in calm water..."
นอกจากนี้ยังรองรับการใช้งานผ่าน Diffusers:
import torch
from diffusers import DiffusionPipeline
from diffusers.utils import load_image, export_to_video
pipe = DiffusionPipeline.from_pretrained(
    "robbyant/lingbot-world-v2-14b-causal-fast",
    dtype=torch.bfloat16, device_map="cuda")
frames = pipe(image=load_image("seed.png"), prompt="...").frames[0]
export_to_video(frames, "output.mp4")
ตารางเปรียบเทียบคุณสมบัติ
การเปรียบเทียบในรายงานวิจัยเป็นเชิงคุณภาพ โดยแสดงให้เห็นถึงความได้เปรียบในแง่ระยะเวลาการสร้างที่ต่อเนื่อง:
| คุณสมบัติ | M-G 3.0 | D-W | LingBot-World | HappyOyster | Genie 3 | LingBot-World-Infinity |
|---|---|---|---|---|---|---|
| ระยะเวลาการสร้าง | นาที | นาที | นาที | นาที | นาที | ชั่วโมง (ไม่จำกัด) |
| การโต้ตอบเชิงความหมาย | ไม่มี | ไม่มี | ไม่มี | เล็กน้อย | เล็กน้อย | ไม่จำกัด |
| โดเมน | เกม | ทั่วไป | ทั่วไป | ทั่วไป | ทั่วไป | ทั่วไป |
| ระดับไดนามิก | กลาง | กลาง | สูง | กลาง | กลาง | สูง |
| เรียลไทม์ | ใช่ | ใช่ | ใช่ | ใช่ | ใช่ | ใช่ |
| โอเพนซอร์ส | ใช่ | ใช่ | ใช่ | ไม่ | ไม่ | ใช่ |
กรณีการใช้งาน (Use Cases)
- การทำเกมต้นแบบ (Game Prototyping): ใช้รูปภาพตั้งต้นแล้วใช้พรอมต์เปลี่ยนสภาพอากาศหรืออารมณ์ของฉากได้ทันที
- การจำลองสำหรับหุ่นยนต์ (Embodied Simulation): สร้างวิดีโอมุมมองบุคคลที่หนึ่งตามการเคลื่อนกล้อง เพื่อใช้ฝึกสอน Policy Learner
- การสร้างข้อมูลสังเคราะห์ (Synthetic Data): สร้างวิดีโอที่ระบุเวลาและเหตุการณ์ได้อย่างแม่นยำเพื่อใช้เทรนโมเดลอื่น
- การจำลองภาพก่อนถ่ายจริง (Previsualization): กำหนดมุมกล้องและสไตล์ของโลกได้โดยไม่เสียภาพอ้างอิงเดิม
สรุปประเด็นสำคัญ
- LingBot-World-Infinity เป็นโมเดลโลกแบบ Causal ขนาด 14B ของ Robbyant ที่เน้นความต่อเนื่องของการโต้ตอบ
- เป็นการผสมผสานระหว่าง VLM (Director) และ DiT (Pilot) เพื่อการจำลองภาพที่สมจริง
- ปล่อยโมเดลภายใต้สัญญาอนุญาตแบบไม่ใช้เพื่อการค้า CC BY-NC-SA 4.0
ข้อมูลเพิ่มเติม
ตรวจสอบ รายงานวิจัย,
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร