
Black Forest Labs เปิดตัว FLUX 3 โมเดล Multimodal ล้ำสมัย รองรับทั้งภาพ วิดีโอ เสียง และหุ่นยนต์ในตัวเดียว
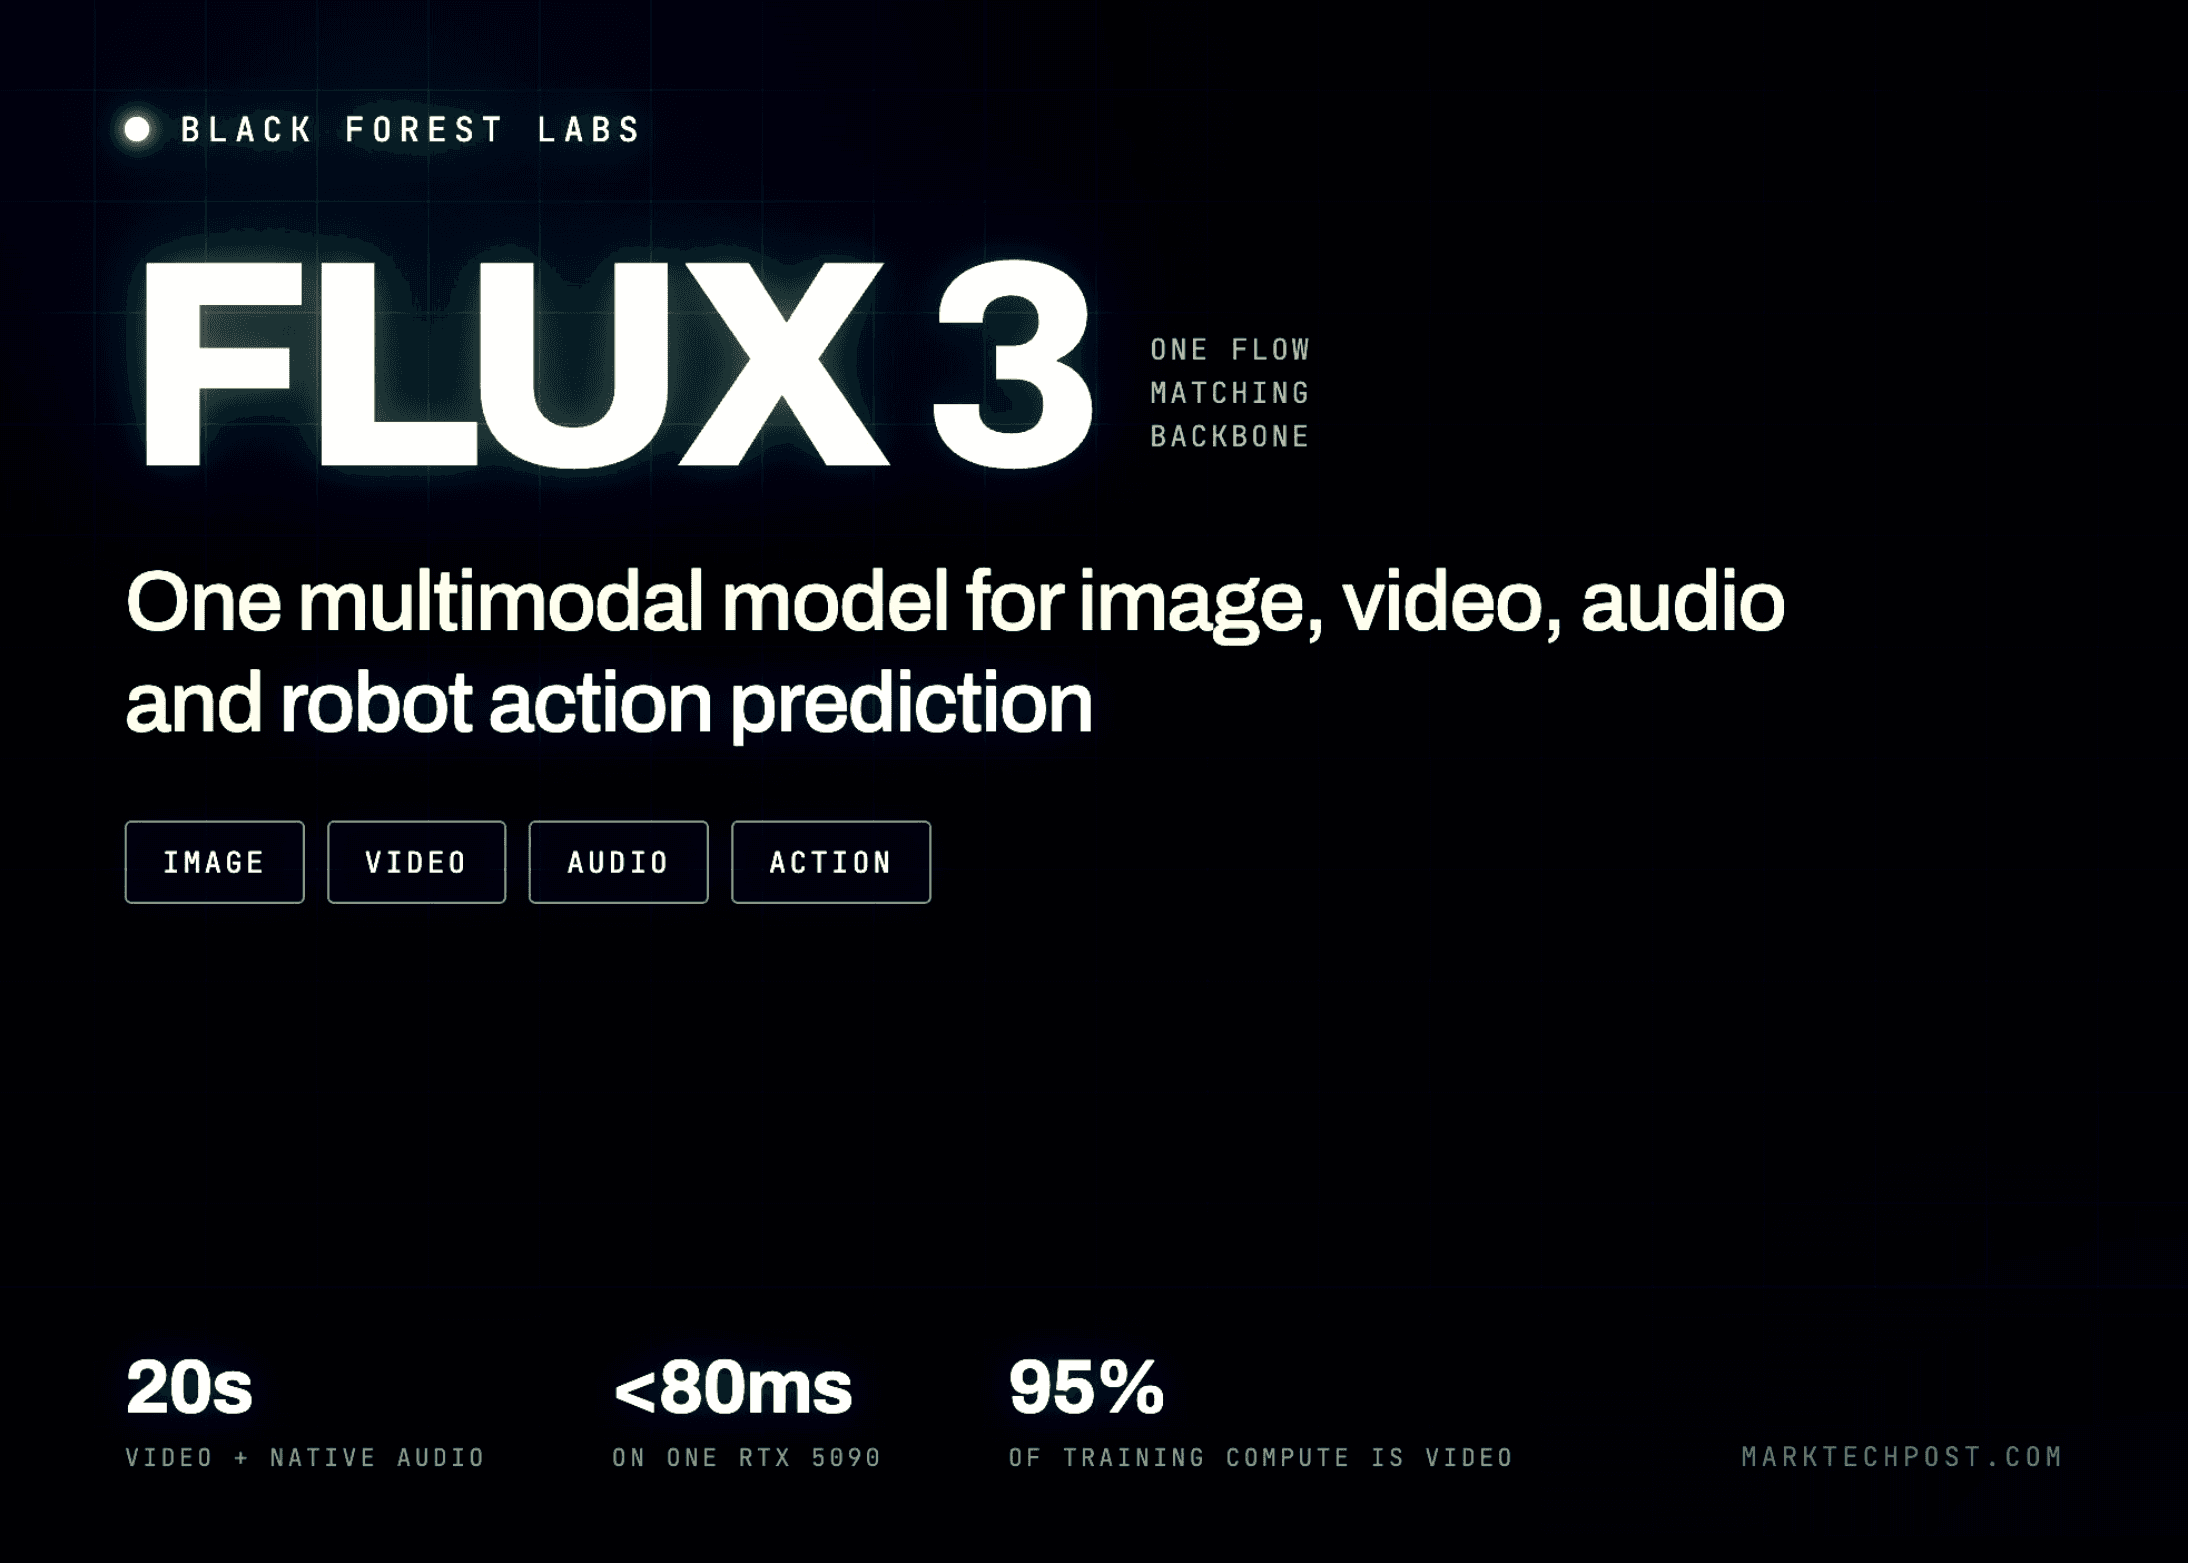
Black Forest Labs (BFL) ประกาศเปิดตัว FLUX 3 โมเดลพื้นฐานแบบ Multimodal รุ่นใหม่ล่าสุดที่ถูกออกแบบมาให้เรียนรู้ข้อมูลภาพ วิดีโอ และเสียงภายใต้สถาปัตยกรรมเดียวกัน ถือเป็นโมเดลตระกูล FLUX รุ่นแรกที่สามารถสร้างวิดีโอ เสียง และทำนายการกระทำ (action prediction) ได้อย่างสมบูรณ์จากชุดน้ำหนัก (weights) เพียงหนึ่งชุด
ทีมวิจัยของ Black Forest Labs ให้เหตุผลว่าไม่มีข้อมูลรูปแบบใดเพียงมิติเดียวที่อธิบายโลกได้อย่างสมบูรณ์ โดยรูปภาพช่วยจับโครงสร้างเชิงพื้นที่ วิดีโอช่วยเปิดเผยพลวัตทางกายภาพตามช่วงเวลา ส่วนเสียงนั้นเผยให้เห็นความสัมพันธ์เชิงเหตุผลของเหตุการณ์ต่างๆ ซึ่งการมองแยกส่วนจะทำให้สูญเสียรายละเอียดสำคัญบางอย่างไป
การฝึกฝนระบบด้วยข้อมูลทุกรูปแบบพร้อมกันช่วยให้ข้อมูลแต่ละมิติทำหน้าที่ควบคุมความสมจริงซึ่งกันและกัน เช่น เสียงต้องสอดคล้องกับแรงกระทบ และการเคลื่อนไหวต้องเป็นไปตามมวลของวัตถุ โดยทีมวิจัยยืนยันว่า FLUX 3 คือโมเดลแรกที่สร้างขึ้นบนหลักการนี้อย่างเต็มรูปแบบ
วิธีการเบื้องหลัง: Self-Flow
FLUX 3 ต่อยอดมาจาก Self-Flow ซึ่งเป็นวิธีการของ BFL ในการปรับจูนการสร้างและการทำความเข้าใจแบบ Multimodal ให้รวมอยู่ในโครงสร้างเดียว โดยได้นำวัตถุประสงค์แบบ flow matching มาใช้ร่วมกับการสร้างฟีเจอร์ใหม่แบบกำกับตนเอง (self-supervised feature reconstruction)
ทั้งนี้ reference implementation บน GitHub เป็นโอเพนซอร์สแบบ Apache-2.0 ที่ใช้สถาปัตยกรรม SiT-XL/2 พร้อมระบบกำหนดเงื่อนไข timestep แบบต่อโทเค็น (per-token timestep conditioning) ฝึกฝนด้วยอัตราส่วน mask 25% และใช้เทคนิคการกลั่นกรองตนเอง (self-distillation) จาก EMA teacher เลเยอร์ 20 ไปยัง student เลเยอร์ 8
สำหรับ checkpoint ที่เผยแพร่ออกมานั้นเป็นเพียงโมเดลวิจัย ImageNet ขนาด 256×256 ไม่ใช่ตัว FLUX 3 โดยตรง เนื่องจาก BFL ได้ขยายทรัพยากรประมวลผลและฐานข้อมูลขึ้นอย่างมหาศาลเพื่อฝึกฝน FLUX 3 ให้ครอบคลุมทั้งวิดีโอ ภาพ และเสียงไปพร้อมกัน แม้ตัวแนวทาง Self-Flow จะถูกแนะนำไปตั้งแต่เดือนมีนาคม 2026 แต่ความโดดเด่นในครั้งนี้อยู่ที่ขนาดการประมวลผลที่ใหญ่ขึ้นกว่าเดิม
ความสามารถของ FLUX 3 Video
FLUX 3 Video สามารถสร้างคลิปวิดีโอได้ยาวสูงสุด 20 วินาทีพร้อมเสียงในตัว (native audio) รองรับการทำงานหลากหลายรูปแบบ ตั้งแต่ text-to-video, image-to-video, video-to-video ไปจนถึง keyframe-to-video เพื่อการเปลี่ยนผ่านที่แม่นยำ รวมถึงการสร้างวิดีโอและเสียงต่อเนื่องจากอินพุตเดิม
นอกจากนี้ BFL ยังระบุถึงความสามารถในการสร้างบทสนทนาหลายภาษา การเชื่อมโยงคลิปแบบหลายช็อต (multi-shot sequences) และการสร้างตัวอักษร (typography) ที่แข็งแกร่งในงานเคลื่อนไหว โดยเฉพาะการแสดงออกทางสีหน้าของมนุษย์ที่ทีมวิจัยรายงานว่ามีความสมจริงเป็นพิเศษ
ประสิทธิภาพการทดสอบ (Performance)
จากการทดสอบความพึงพอใจของผู้ใช้งานในเบื้องต้นกับวิดีโอความละเอียด 720p ยาว 10 วินาทีพร้อมเสียง พบว่า FLUX 3 ได้รับคะแนนความพึงพอใจเหนือกว่าคู่แข่งรายใหญ่อย่าง Luma Ray 3.2 ถึง 93% และชนะ Runway Gen-4.5 ที่ 77%
ในขณะที่การเปรียบเทียบกับ Grok Imagine Video มีคะแนนพึงพอใจอยู่ที่ 69% ตามด้วย Kling v3 Pro (60%), Happy Horse v1 (59%) และ Happy Horse 1.1 (57%) ส่วนผลการทดสอบเมื่อเทียบกับ Seedance 2.0 และ Gemini Omni Flash นั้นได้ผลลัพธ์อยู่ที่ 52% ซึ่งสูสีกันอย่างมาก
ประเด็นสำคัญ
- FLUX 3 คือโครงสร้างหลัก (backbone) แบบ flow matching หนึ่งเดียวที่ฝึกฝนภาพ วิดีโอ และเสียงร่วมกัน
- สามารถสร้างวิดีโอพร้อมเสียงในตัวได้นานถึง 20 วินาทีจากการประมวลผลครั้งเดียว
- กระบวนการฝึกฝนใช้พื้นที่ประมวลผลไปกับวิดีโอกว่า 95% ขณะที่เสียงใช้โทเค็นไม่ถึง 0.5%
- โครงสร้างเดียวกันนี้ขับเคลื่อน FLUX-mimic ซึ่งใช้นโยบายสำหรับหุ่นยนต์ที่ทำงานได้รวดเร็วต่ำกว่า 80 ms บนการ์ดจอ RTX 5090 เพียงตัวเดียว
- ช่วงแรกเปิดให้เข้าใช้งานแบบจำกัด (Early Access) สำหรับ Video และ Action โดยเวอร์ชัน Image จะตามมา และจะเปิดแจกจ่ายชุดน้ำหนัก (open weights) เป็นลำดับสุดท้าย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร