
NVIDIA เปิดตัว Molt เฟรมเวิร์ก Agentic RL ขนาดกะทัดรัด รองรับ PyTorch แบบ Native
การวิจัยด้าน Agentic Reinforcement Learning (RL) มักเผชิญกับความท้าทายในการปรับแต่งอัลกอริทึมอย่างต่อเนื่อง ไม่ว่าจะเป็นการเพิ่มตัวประเมินใหม่หรือการปรับเปลี่ยนขั้นตอนการประมวลผล (Rollout) ซึ่งในเฟรมเวิร์กกระแสหลัก การเปลี่ยนแปลงแต่ละครั้งมักต้องแก้ไขโค้ดผ่านหลายชั้น ทั้งส่วนของ Trainer, Distributed Backend และส่วนเชื่อมต่อต่างๆ ทำให้เกิดต้นทุนด้านเวลาและทรัพยากรที่สูงสำหรับนักวิจัย
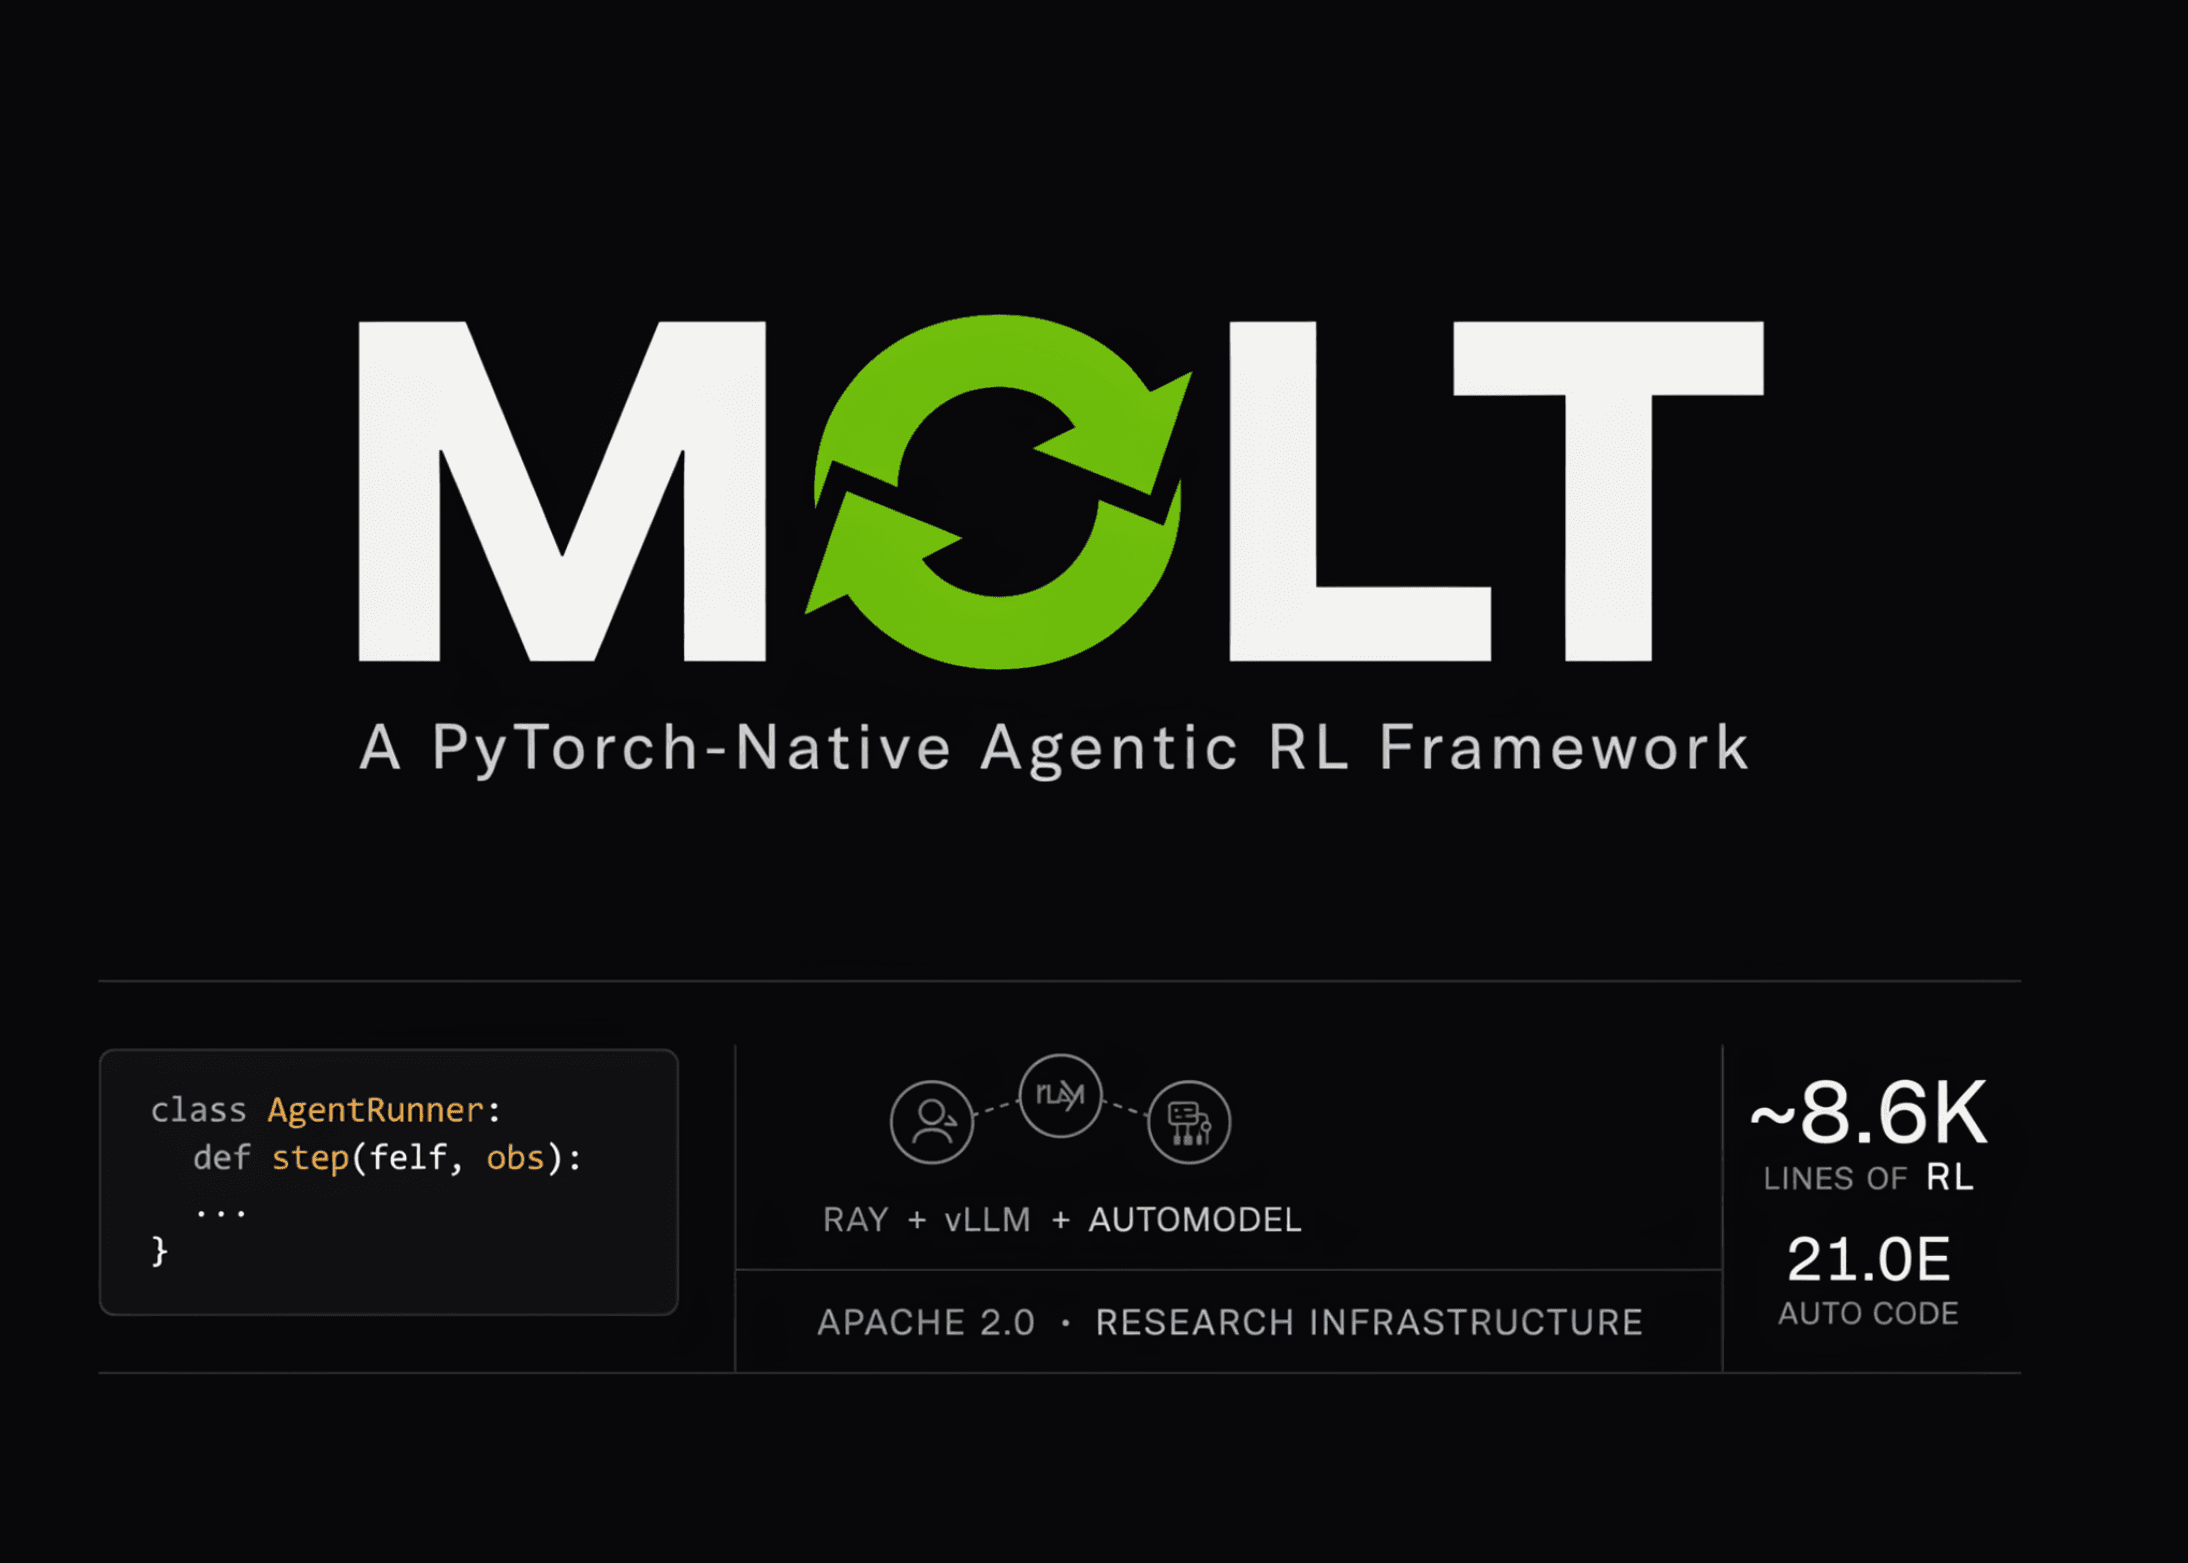
Molt จากทีม NeMo ของ NVIDIA ถูกพัฒนาขึ้นเพื่อแก้ปัญหานี้โดยเฉพาะ โดยเป็นเฟรมเวิร์ก Agentic RL แบบ PyTorch-native ที่ออกแบบมาให้มีความกะทัดรัด ด้วยชุดโค้ดเพียงประมาณ 8,600 บรรทัด ซึ่งน้อยกว่าเฟรมเวิร์กอื่นๆ ในระดับเดียวกันอย่าง verl ที่มีโค้ดถึง 62,000 บรรทัด ช่วยให้นักวิจัยและ AI Coding Assistant สามารถทำความเข้าใจและจัดการระบบทั้งหมดได้อย่างรวดเร็ว
ความพร้อมในการใช้งานจริงและกลุ่มเป้าหมาย
Molt เผยแพร่ภายใต้สัญญาอนุญาตแบบ Apache 2.0 พร้อมโค้ดเปิดใช้งาน สคริปต์ Slurm และ Container ที่พร้อมรัน อย่างไรก็ตาม NVIDIA วางตำแหน่งให้ Molt เป็นโครงสร้างพื้นฐานสำหรับการวิจัยมากกว่าการเป็นบริการฝึกฝนระดับโปรดักชัน โดยข้อจำกัดหลักจะอยู่ที่ฮาร์ดแวร์ ซึ่งสูตรการใช้งานพื้นฐานที่แนะนำคือการใช้ 8 H100 GPUs จำนวน 2 โหนด แบ่งสำหรับการฝึกฝนและประมวลผลอย่างละโหนด
เฟรมเวิร์กนี้จึงเหมาะอย่างยิ่งสำหรับห้องปฏิบัติการวิจัยระดับแนวหน้า สตาร์ทอัพ AI ที่เน้นขั้นตอน Post-training รวมถึงหน่วยงานวิจัยในองค์กรด้านการแพทย์ การเงิน และหุ่นยนต์ แอปพลิเคชันที่รองรับมีตั้งแต่เอเจนต์ที่ทำงานแบบหลายขั้นตอน (Multi-turn tool-use) ไปจนถึงการทำ Knowledge Distillation แบบ On-policy ไปยังโมเดลขนาดเล็ก
สถาปัตยกรรมแบบสามส่วนประกอบในลูปเดียว
โครงสร้างของ Molt เกิดจากการรวมเทคโนโลยีสำคัญ 3 อย่างเข้าด้วยกัน ได้แก่ Ray สำหรับจัดการคิวงานแบบ Asynchronous, vLLM สำหรับการทำ Rollout และ NVIDIA AutoModel พร้อม FSDP2 สำหรับการฝึกฝน โดยทั้งสามส่วนนี้เป็นการเรียกใช้โดยตรง ไม่มีการแยกสาขาโค้ด (Forked) ทำให้สามารถอัปเดตฟีเจอร์ใหม่จากต้นทางได้ทันที
ระบบรันไทม์ประกอบด้วยพูลของเอเจนต์และเอนจิน vLLM ที่ทำงานผ่าน Request Router โดยมีตัวนโยบาย (Policy Actor) เพียงตัวเดียวที่ฝึกฝนได้ การทำงานแบบสตรีมมิ่งช่วยให้เอนจินประมวลผลได้อย่างต่อเนื่องแม้ในขณะที่ตัวละครหลักกำลังฝึกฝน และหากมีการทำ Partial Rollout ระบบจะใช้วิธีส่งชิ้นส่วนตัวละครผ่าน NCCL ไปยังแต่ละเอนจินโดยตรงเพื่อดำเนินการต่อทันที
การใช้งานผ่าน Python ที่เรียบง่าย
ในการรัน RL แต่ละครั้ง ผู้ใช้เพียงแค่ระบุโมดูล Python ที่ส่งออก AgentRunner ส่วนที่เหลือรวมถึงระบบการให้รางวัล (Reward) สามารถเขียนเป็นโค้ดปกติได้เลย โดยรองรับสองรูปแบบหลักคือ Env สำหรับลูป LLM ที่สอดคล้องกับ Gymnasium และ ChatAgent ที่ให้ผู้ใช้ควบคุมลูปผ่าน SDK มาตรฐานของ OpenAI หรือ Anthropic
Molt จะทำงานผ่านเซิร์ฟเวอร์ Loopback ที่รองรับโปรโตคอลการสื่อสารมาตรฐาน โดยทุกคำขอจะถูกถอดรหัสในฝั่งเซิร์ฟเวอร์เพื่อให้ได้ความแม่นยำระดับโทเค็น แม้เอเจนต์จะมีการบีบอัดบริบทหรือเขียนคำนำหน้าใหม่ ระบบจะจัดการปิดและเปิดส่วนใหม่ให้อัตโนมัติ เพื่อให้ข้อมูลการฝึกฝนมีความถูกต้องสูงสุด
หลักความถูกต้องสามประการเพื่อประสิทธิภาพสูงสุด
การออกแบบของ Molt ยึดหลักความถูกต้อง 3 ด้าน ได้แก่ เอกลักษณ์ของโทเค็น (Token Identity) ที่เน้นรหัสโทเค็นจริงแทนการแปลงข้อความกลับไปมา, อรรถศาสตร์เวอร์ชันนโยบาย (Policy-version Semantics) ที่คงค่าความน่าจะเป็นของนโยบายพฤติกรรมในแต่ละโทเค็น และความสอดคล้องไปข้างหน้า (Forward Consistency) เพื่อให้ส่วน Rollout และ Actor มีความเข้าใจที่ตรงกัน โดยเฉพาะในโมเดลแบบ Mixture-of-Experts (MoE) Molt ได้นำเทคนิค rollout routing replay มาใช้ เพื่อให้ vLLM คืนค่ารหัสผู้เชี่ยวชาญต่อโทเค็น และการฝึกฝนจะทำตามเส้นทางนั้นอย่างแม่นยำ ป้องกันปัญหาความต่างทางตัวเลขที่อาจทำให้การเลือก Expert ผิดเพี้ยนไป
ประเด็นสำคัญ
- Molt เป็นเฟรมเวิร์กเปิด (Apache-2.0) ที่มีขนาดโค้ด RL เพียง 8,600 บรรทัด เล็กกว่าเฟรมเวิร์กอื่นถึง 7 เท่า
- ใช้ Ray, vLLM และ NVIDIA AutoModel แบบ Native ทำให้ง่ายต่อการอัปเดตและบำรุงรักษา
- เอเจนต์เขียนด้วย Python ปกติ รองรับ SDK ของ OpenAI และ Anthropic ได้ทันที
- ประสิทธิภาพ (Throughput) เทียบเคียงได้กับระบบขนาดใหญ่อย่าง Megatron
- ยืดหยุ่นสูง สามารถปรับขนาดได้ตั้งแต่โมเดล 4B ไปจนถึง 700B MoE ผ่านการตั้งค่า FSDP
ดูข้อมูลเพิ่มเติมที่** Paper **และ
ติดตามเราได้ที่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร