
Prime Intellect เปิดตัว Prime Inference รันโมเดลโอเพนซอร์สบน NVIDIA Blackwell
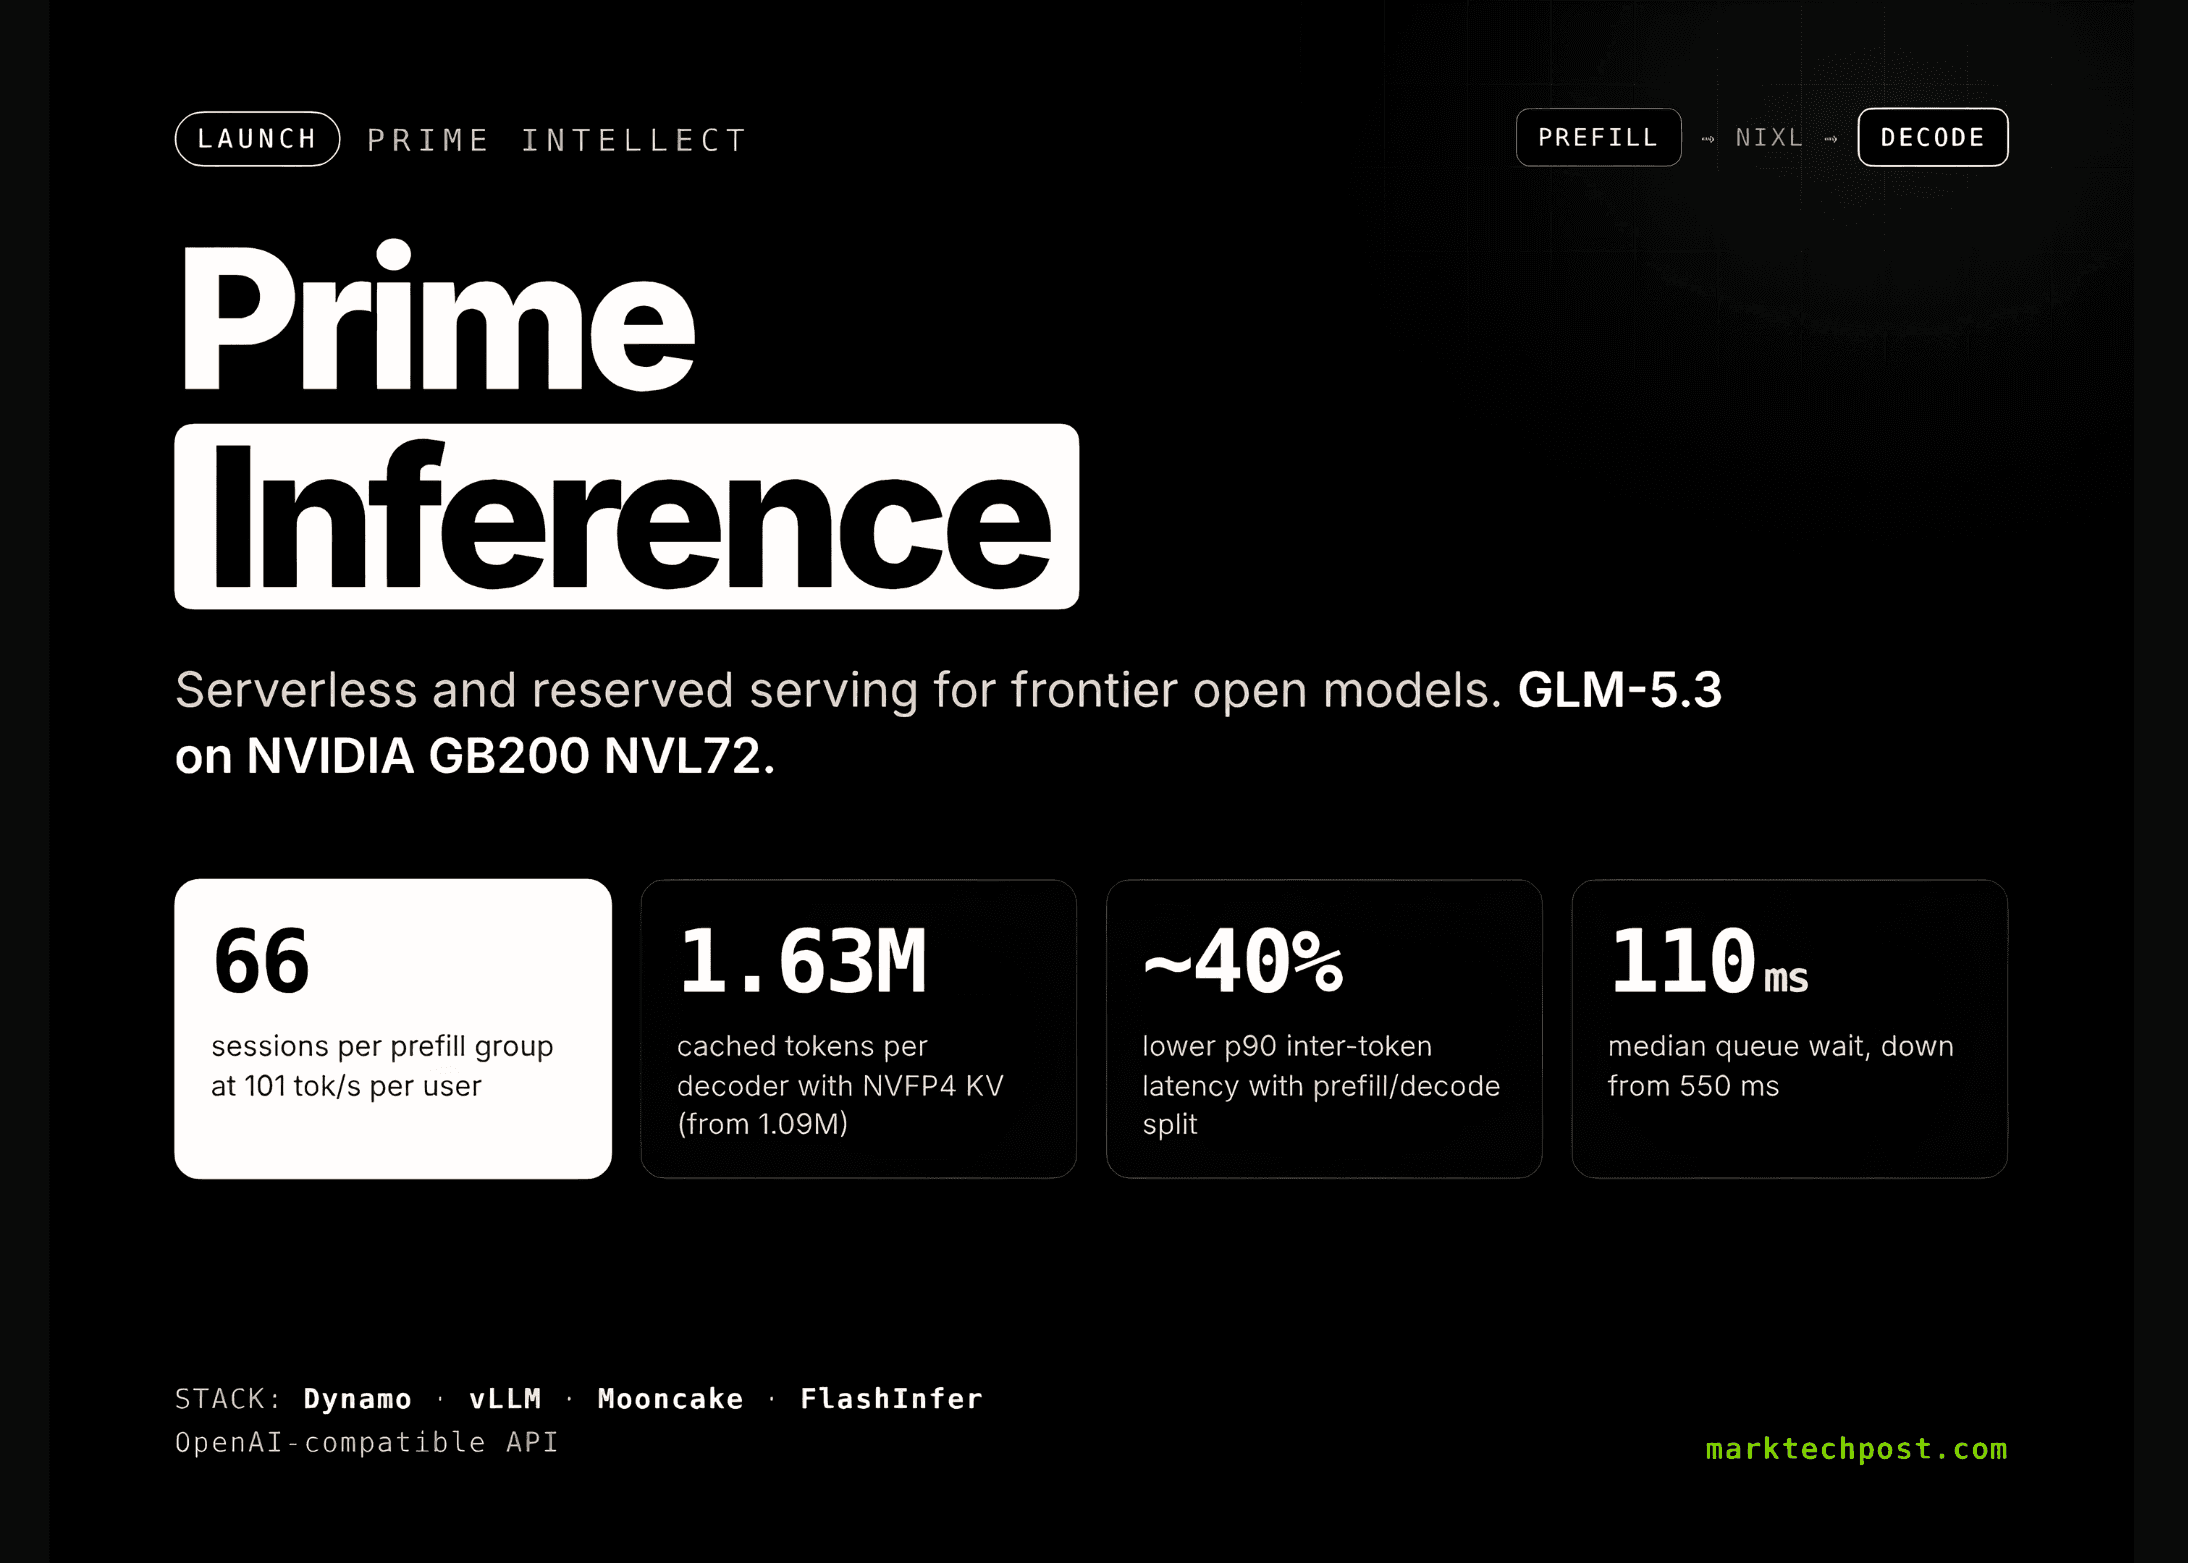
Prime Intellect เปิดตัว Prime Inference แพลตฟอร์มให้บริการโมเดล open-source ระดับแนวหน้า โดยรองรับทั้งการใช้งานแบบ serverless endpoints และความจุแบบ reserved บน GPU ของ Prime เองในศูนย์ข้อมูลหลายแห่ง ก่อนเปิดตัวสู่สาธารณะ ระบบนี้ได้ผ่านการประมวลผลโทเค็นเกือบหนึ่งล้านล้านโทเค็นต่อวันเป็นการภายใน เพื่อรองรับงานด้าน RL rollouts, การสร้างข้อมูลสังเคราะห์ (synthetic data), การประเมินผล และ coding agents
Prime Inference คืออะไร?
Prime Inference คือเลเยอร์การให้บริการภายใน open training stack ของ Prime Intellect ซึ่งช่วยเติมเต็มวงจรการพัฒนาต่อจากเครื่องมือหลังการฝึกฝน (post-training) อย่าง prime-rl และระบบตรวจสอบ (verifiers) โดยโมเดลที่ถูกนำมาใช้งานจะสร้างร่องรอยการผลิต (production traces) เพื่อนำกลับไปป้อนเข้าสู่การฝึกฝนโมเดลให้ดียิ่งขึ้น
ปัจจุบัน Prime รายงานว่า endpoint GLM-5.3 ของตนขึ้นแท่นเป็นหนึ่งในบริการที่เร็วที่สุดบน OpenRouter โดยมีอัตราความผิดพลาดในการเรียกใช้เครื่องมือ (tool-call) เกือบเป็นศูนย์ และรักษา Uptime ได้ 100% ตั้งแต่เริ่มเปิดใช้งาน
- สองโหมดการใช้งาน: เลือกได้ระหว่าง serverless endpoints สำหรับความต้องการที่ยืดหยุ่น และ reserved capacity สำหรับงานที่ต่อเนื่อง
- รองรับ OpenAI: นักพัฒนาสามารถเชื่อมต่อ OpenAI SDK เข้ากับ
https://api.pinference.ai/api/v1ได้ทันที (docs) - เสถียรภาพสูง: มีระบบ failover อัตโนมัติข้ามศูนย์ข้อมูลเพื่อรักษาความต่อเนื่องของทราฟฟิก
- ฮาร์ดแวร์ประสิทธิภาพสูง: ปัจจุบันให้บริการบน NVIDIA Blackwell และเตรียมรองรับสถาปัตยกรรม Vera Rubin ในเร็วๆ นี้
- การจัดการค่าใช้จ่าย: รวมศูนย์การเรียกเก็บเงินพร้อมระบบติดตามการใช้งานระดับทีม
การทำงานของ Serving Stack
โครงสร้างพื้นฐานนี้เป็นการผสมผสานระหว่าง NVIDIA Dynamo, vLLM, Mooncake และ FlashInfer ซึ่งถูกสร้างขึ้นร่วมกับ Inferact และ NVIDIA โดยมีการส่งข้อมูลการแก้ไขกลับไปยังต้นทาง (upstream) เพื่อพัฒนาชุมชนโอเพนซอร์ส
เป้าหมายหลักคือการรองรับปริมาณงานรูปแบบ agentic ซึ่งมักมีการเพิ่มโทเค็นประมาณ 6K ในพรอมต์ขนาดใหญ่ถึง 140K โทเค็น โดย Prime ได้ทดสอบประสิทธิภาพด้วย SemiAnalysis AgentX เพื่อวัดผลการทำงานในสภาวะต่างๆ รวมถึงช่วง cold arrivals
การแยกส่วน Prefill และ Decode (Prefill/decode disaggregation): ระบบแยกการทำงานสองส่วนนี้บนกลุ่ม GPU ที่ต่างกัน โดยมี Dynamo จัดการเรื่องเส้นทาง (routing) และ vLLM รันโมเดลในแต่ละกลุ่ม ตัวถอดรหัส (decoders) จะดึงค่า KV ที่คำนวณแล้วผ่าน NIXL ส่งผลให้ inter-token latency ระดับ p90 ลดลงเกือบ 40% ในการทดสอบ
การกำหนดเส้นทางที่รับรู้แคช (Cache-aware routing): ตัวเราเตอร์ของ Dynamo จะคำนวณน้ำหนักระหว่าง prefix ที่ถูกแคชไว้เทียบกับคิวงานที่ค้างอยู่ เพื่อรักษาเซสชันให้อยู่กับตัวถอดรหัสเดิมให้นานที่สุด ขณะที่ Mooncake จะช่วยเพิ่มเลเยอร์ KV ชั้นที่สองใน host DRAM เพื่อเพิ่มประสิทธิภาพการเข้าถึงข้อมูล
ประสิทธิภาพ GLM-5.3 บน GB200 NVL72
จากการทดสอบเพื่อทำความเร็วเป้าหมาย 100 end-to-end tokens ต่อวินาทีต่อผู้ใช้ พบว่าการใช้อัตราส่วน prefill/decode ที่ 1:4 สามารถรองรับผู้ใช้ได้สูงสุดถึง 66 sessions ต่อกลุ่ม prefill ด้วยความเร็ว 101 tok/s ต่อผู้ใช้ และทำความเร็วเอาต์พุตได้ 100 tok/s ต่อ GPU
ความสำเร็จทางเทคนิคประกอบด้วย:
- โครงสร้าง DEP8 prefill: เพิ่มความจุ prefix-cache ได้มากกว่า TEP8 บนฮาร์ดแวร์เดียวกันถึง 5 เท่า
- ลดเวลารอคิว: การปรับลดโทเค็นต่อขั้นตอนจาก 8K เหลือ 4K ต่อ GPU ช่วยลดเวลารอคิวค่ากลาง (median queue wait) จาก 550 ms เหลือ 110 ms
- การบีบอัด NVFP4 KV: ลดขนาดแคช MLA ต่อแถวจาก 576 เหลือ 352 ไบต์ ช่วยเพิ่มจำนวนโทเค็นที่แคชได้ต่อตัวถอดรหัสเป็น 1.63 ล้านโทเค็น
- Native sparse-MLA kernel: ทำความเร็วได้ 12.0 μs ที่ 15 query tokens ซึ่งเร็วกว่าแบบ FP8 ที่ใช้เวลา 13.7 μs
- BLHNC KV layout: ลดจำนวนตัวระบุการโอนย้าย (transfer descriptors) ลงเหลือประมาณ 1,940 รายการ ส่งผลให้เวลาโอนย้ายเฉลี่ยลดลงจาก 146 ms เหลือเพียง 78 ms
การเรียกใช้เครื่องมือที่แม่นยำ เพื่อป้องกันปัญหาเอเจนต์ทำงานล้มเหลวจากชื่อเครื่องมือผิดหรืออาร์กิวเมนต์ที่เสียหาย Prime Intellect ได้พัฒนาระบบ structural-tag builder ใน Dynamo สำหรับ GLM โดยเฉพาะ พร้อมใช้ xgrammar บน vLLM เพื่อบล็อกโทเค็นที่ไม่ตรงตาม schema และแก้ไขบั็กการพาร์สตัวอักษรพิเศษในโค้ดให้ถูกต้อง
ตารางเปรียบเทียบ Prime Inference กับคู่แข่ง
| คุณสมบัติ | Prime Inference | Together AI | Fireworks AI | Baseten |
|---|---|---|---|---|
| Serverless GLM-5.3 | ใช่ | ใช่ | ใช่ | ใช่ |
| ราคา GLM-5.3 (ต่อ 1M tokens) | ยังไม่เผยแพร่ | $1.40 / $4.40 | $1.40 / $4.40 | $1.40 / $4.40 |
| ความจุที่รองรับ | Reserved capacity | Dedicated endpoints | On-demand dedicated | Dedicated GPU |
| API รองรับ OpenAI | ใช่ | ใช่ | ใช่ | ใช่ |
| Serving stack | Open source (Dynamo, vLLM) | Together research stack | Fireworks stack | Baseten Stack |
หมายเหตุ: ข้อมูลราคาคู่แข่งตรวจสอบ ณ วันที่ 2 ตุลาคม 2026 จาก ComputePrices ซึ่งเป็นผู้ให้บริการติดตามราคาภายนอก
ในอนาคต Prime Intellect มีแผนที่จะเปิดให้บริการ Batch inference และระบบติดตั้ง dedicated แบบ 1-click เพื่อยกระดับความสะดวกในการใช้งานให้แก่ลูกค้ายิ่งขึ้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร