
Diffusers รองรับ Nunchaku 4-bit เพิ่มสปีดการรัน Diffusion Transformers โดยใช้หน่วยความจำน้อยลง
Large Diffusion Transformers สามารถสร้างผลลัพธ์ที่น่าทึ่งทั้งภาพ วิดีโอ และเสียง แต่การโหลดโมเดลสมัยใหม่ที่ความละเอียด BF16 มักต้องใช้ VRAM สูงถึง 20-30 GB ซึ่งเกินขีดจำกัดของ GPU ระดับผู้บริโภคทั่วไป แม้เทคนิค Quantization จะช่วยแก้ปัญหานี้ได้ แต่ Backend ส่วนใหญ่ในปัจจุบันมักเป็นแบบ weight-only ที่ลดเพียงการใช้หน่วยความจำ แต่ไม่ได้ช่วยให้ประมวลผลเร็วขึ้น
SVDQuant ซึ่งเป็นเทคนิคเบื้องหลัง Inference Engine อย่าง Nunchaku ใช้แนวทางที่ต่างออกไป โดยจะรันเลเยอร์ Transformer หลักด้วย Weight และ Activation แบบ 4-bit (W4A4) ซึ่งช่วยลดการใช้หน่วยความจำพร้อมกับเร่งความเร็วในขั้นตอน Denoising ไปในตัว
ปัจจุบัน Diffusers รองรับการโหลด Checkpoint ของ Nunchaku ผ่านคำสั่ง from_pretrained() ได้ทันที โดยไม่ต้องคอมไพล์ CUDA ในเครื่องเอง ด้วยความช่วยเหลือจากแพ็กเกจ kernels นอกจากนี้ยังมีชุดเครื่องมือ diffuse-compressor ที่ช่วยให้ผู้ใช้สามารถทำ Quantization กับโมเดลสถาปัตยกรรมใหม่ๆ ได้ด้วยตนเอง
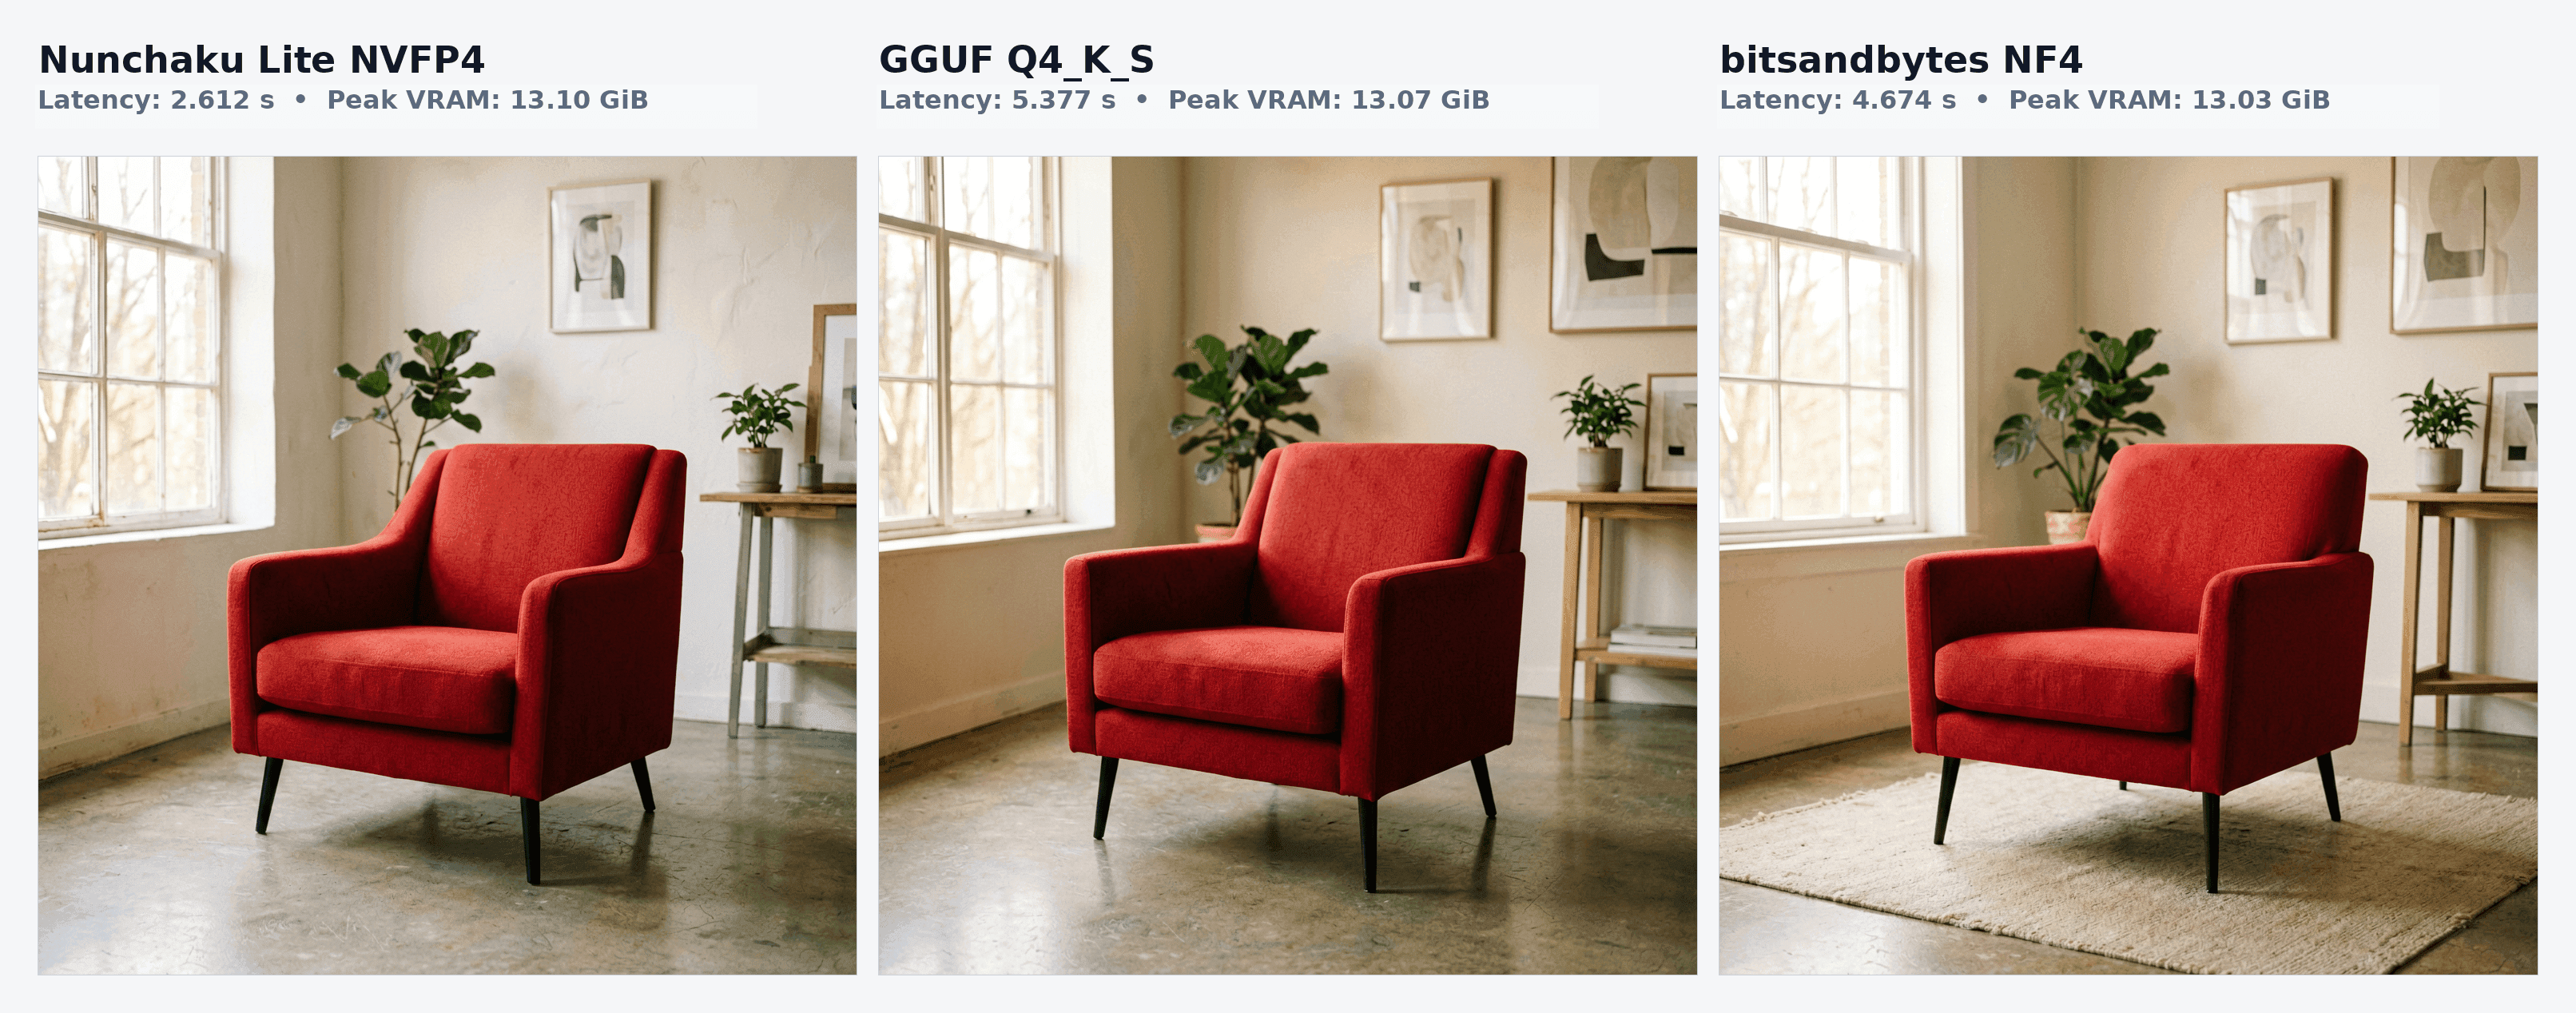
Table of Contents
- Getting started with Nunchaku Lite
- Background: SVDQuant and Nunchaku
- Introducing Nunchaku Lite
- Native loading in Diffusers
- Getting more speed and lower memory
- Benchmarks
- Quantizing your own model
- Ready-to-use checkpoints
- Conclusion
- Acknowledgements
Getting started with Nunchaku Lite
เริ่มต้นด้วยการติดตั้งไลบรารีที่จำเป็น ได้แก่ Diffusers เวอร์ชันล่าสุดและแพ็กเกจ Hugging Face kernels:
pip install -U diffusers transformers accelerate kernels bitsandbytesจากนั้นสามารถโหลด Pipeline ที่ผ่านการทำ Pre-quantized มาแล้วได้เหมือนโมเดลปกติ:
import torch
from diffusers import ErnieImagePipeline

pipe = ErnieImagePipeline.from_pretrained(
    "lite-infer/ERNIE-Image-Turbo-nunchaku-lite-nvfp4_r32-bnb4-text-encoder",
    torch_dtype=torch.bfloat16,
).to("cuda")

image = pipe(
    prompt="A cinematic portrait of a red fox in a misty forest at sunrise, "
           "detailed fur, volumetric light",
    height=1024,
    width=1024,
    num_inference_steps=8,
    guidance_scale=1.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("output.png")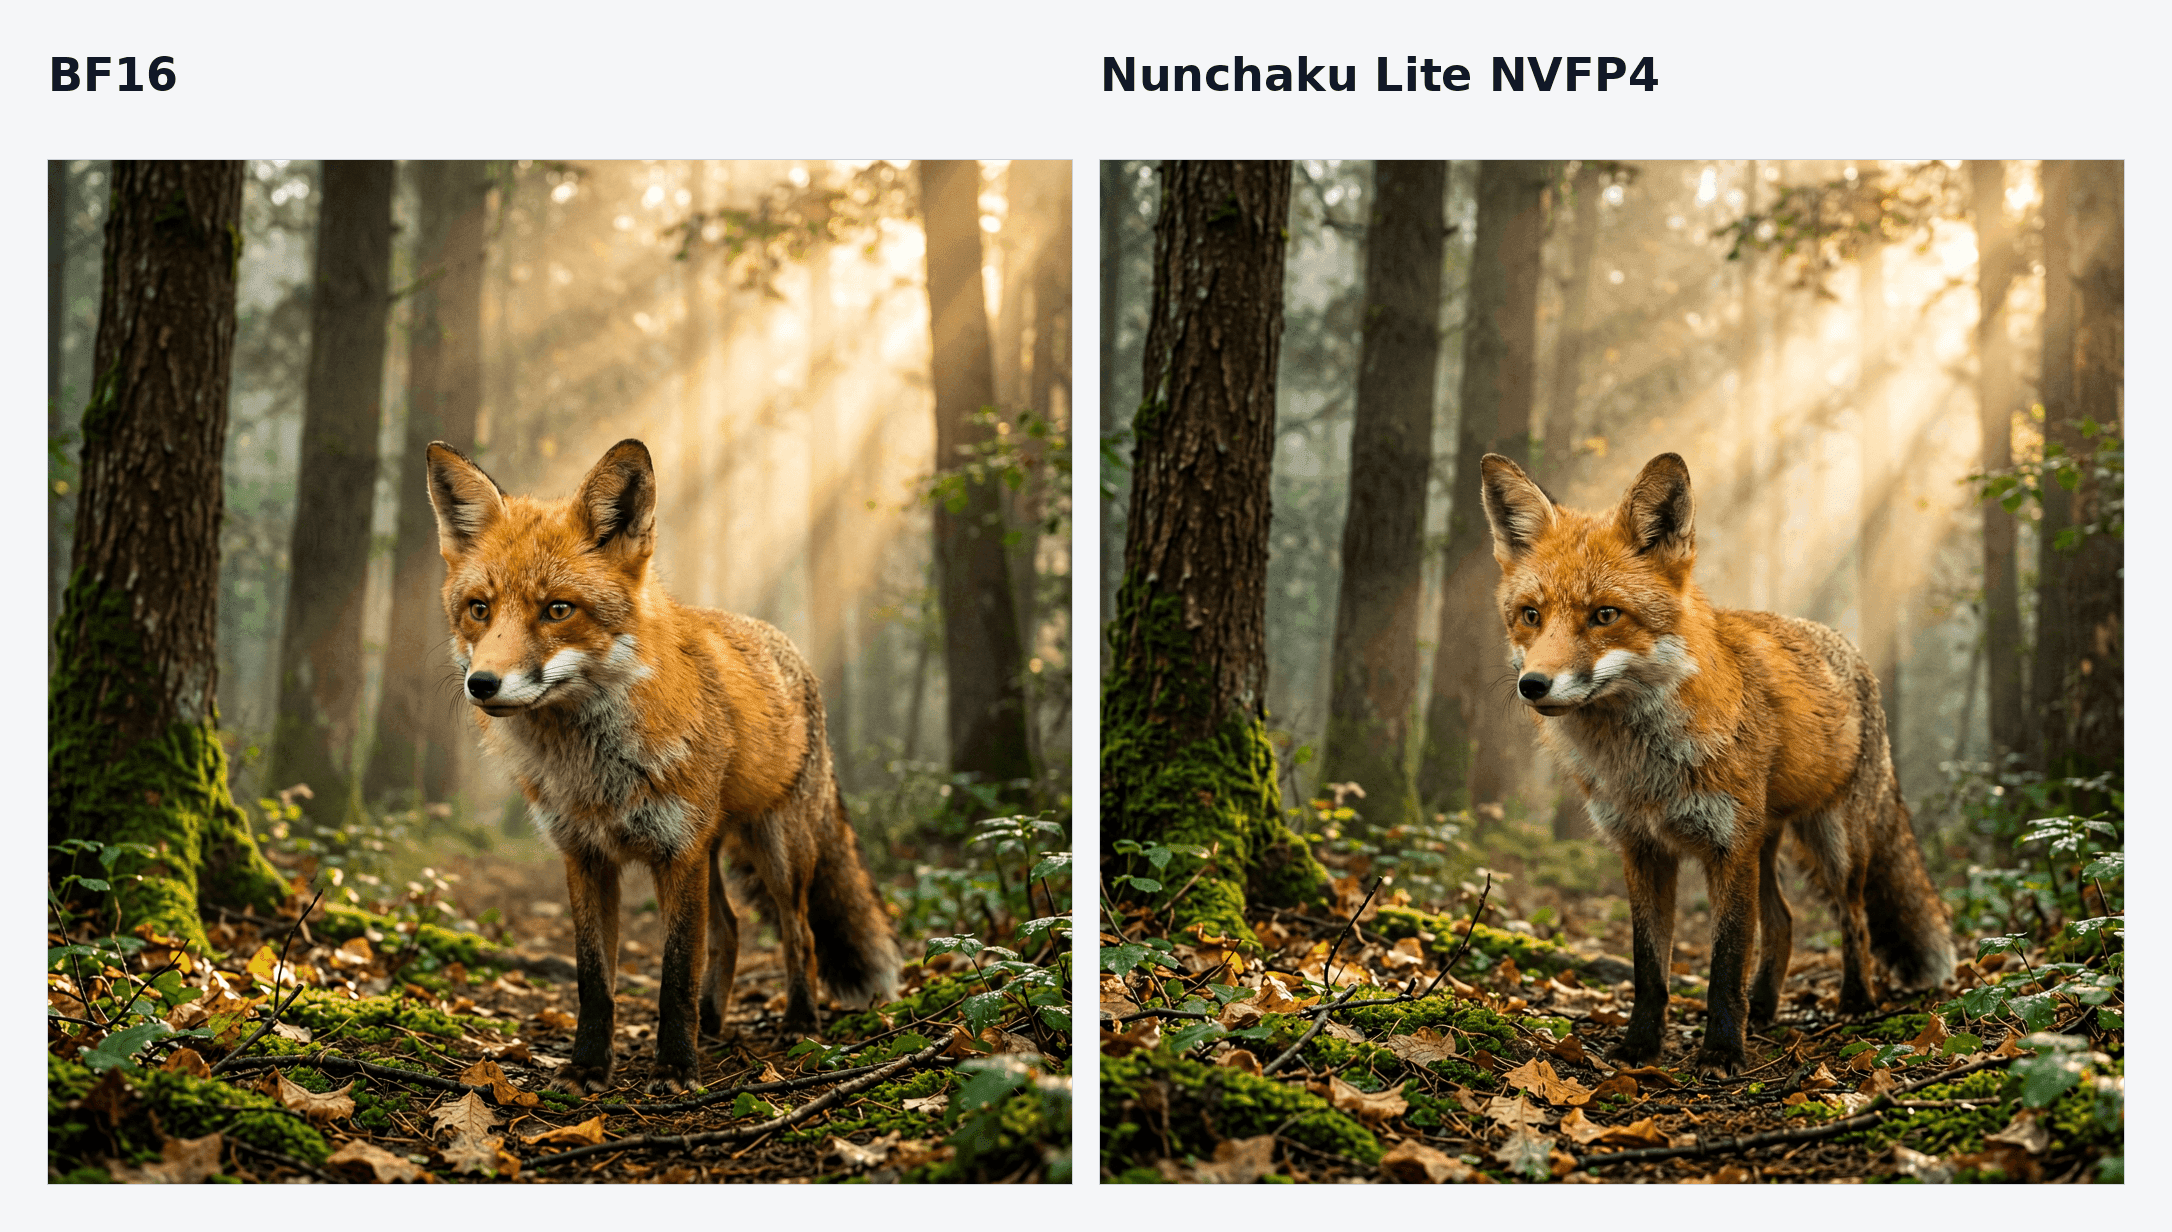
ข้อดีคือคุณไม่จำเป็นต้องใช้คลาส Pipeline พิเศษหรือ Engine แยกต่างหาก Kernel ของ NVFP4 จะถูกดาวน์โหลดอัตโนมัติจาก Nunchaku Lite kernels page เมื่อเรียกใช้งานครั้งแรก โดยสามารถสร้างภาพ 1024x1024 บน RTX 5090 ในเวลาเพียง 1.7 วินาที และใช้หน่วยความจำเพียง 12 GB เทียบกับ 24 GB ในโหมด BF16
สำหรับผู้ใช้ GPU รุ่นก่อนหน้า Blackwell (RTX 50 series) ให้ใช้ตัวเลือก INT4 แทน ตามตารางสนับสนุนฮาร์ดแวร์
Background: SVDQuant and Nunchaku
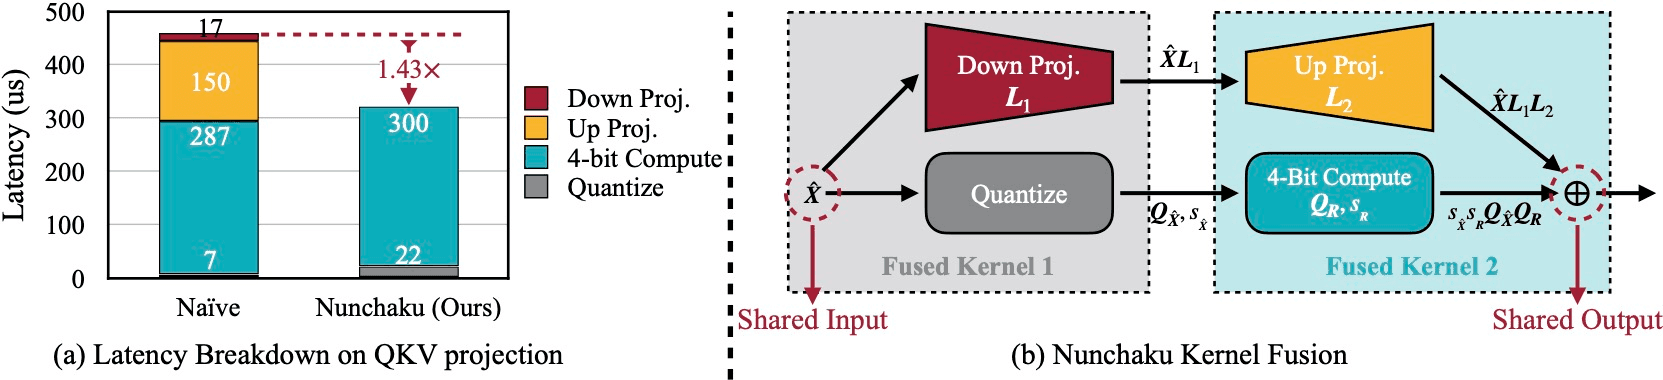
SVDQuant จัดการปัญหาค่า Outliers ใน Diffusion Transformers ที่ทำให้การทำ 4-bit Quantization ปกติทำได้ยาก โดยการย้าย Activation Outliers ไปไว้ที่ Weight และแทนที่ส่วนที่ประมวลผลยากด้วยโครงสร้าง Low-rank ขนาดเล็กแบบ 16-bit ส่วนที่เหลือจะประมวลผลเป็น 4-bit โดย Nunchaku จะใช้ Fused Kernels เพื่อเร่งความเร็วขั้นตอนนี้
Introducing Nunchaku Lite
Nunchaku Lite เป็นระบบการผสานการทำงานใหม่ใน Diffusers ที่ช่วยให้โหลดโมเดลสไตล์ Nunchaku ได้โดยตรง ระบบจะทำการ Patch โมดูล nn.Linear มาตรฐานให้เป็นเลเยอร์ SVDQ/AWQ แบบ Runtime ก่อนโหลด Checkpoint โดยแบ่งกลุ่ม Kernel เป็น:
svdq_w4a4: สำหรับส่วน Attention และ MLP ที่ประมวลผลหนักawq_w4a16: สำหรับเลเยอร์ที่ไวต่อความแม่นยำสูง เช่น Adaptive Normalization
แม้ Nunchaku Lite จะไม่เร็วเท่าหน่วยประมวลผล Nunchaku Engine ดั้งเดิมที่ปรับแต่งมาเฉพาะรุ่น แต่การใช้งานแบบ Native นี้ยังช่วยเพิ่มความเร็วได้ถึง 30% พร้อมลดการใช้ VRAM ได้ในระดับเดียวกัน
Native loading in Diffusers
การใช้งานจะให้ความรู้สึกเดียวกับการใช้ bitsandbytes หรือ torchao โดยในไฟล์ config.json จะมีบล็อก quantization_config เพื่อระบุรายละเอียดการทำ Quantize ของแต่ละโมดูล ทำให้ซอฟต์แวร์เครื่องมืออื่นๆ ในระบบนิเวศ (เช่น LoRA, offloading) ยังทำงานร่วมกันได้ตามปกติ
Hardware support
| Scheme | Precision | Supported GPUs |
|---|---|---|
svdq_w4a4 | nvfp4 | Blackwell (RTX 50 series, RTX PRO 6000, B200) |
svdq_w4a4 | int4 | Turing / Ampere / Ada (RTX 30 & 40 series, A100, L40S) |
awq_w4a16 | int4 | Turing / Ampere / Ada (RTX 30 & 40 series, A100, L40S) |
Getting more speed and lower memory
คุณสามารถเพิ่มประสิทธิภาพได้อีกผ่านเทคนิคต่างๆ ดังนี้:
torch.compile: ช่วยเพิ่มความเร็วขึ้นอีก 1.35 เท่า ถึง 1.8 เท่า- Quantized text encoders: การรัน Text Encoder (เช่น T5) ด้วยรูปแบบ NF4 ผ่าน bitsandbytes ช่วยลด Peak VRAM ได้อีกประมาณ 22%
- Offloading: รองรับคำสั่ง
enable_model_cpu_offload()สำหรับ GPU ที่มีหน่วยความจำจำกัดมากๆ
Benchmarks
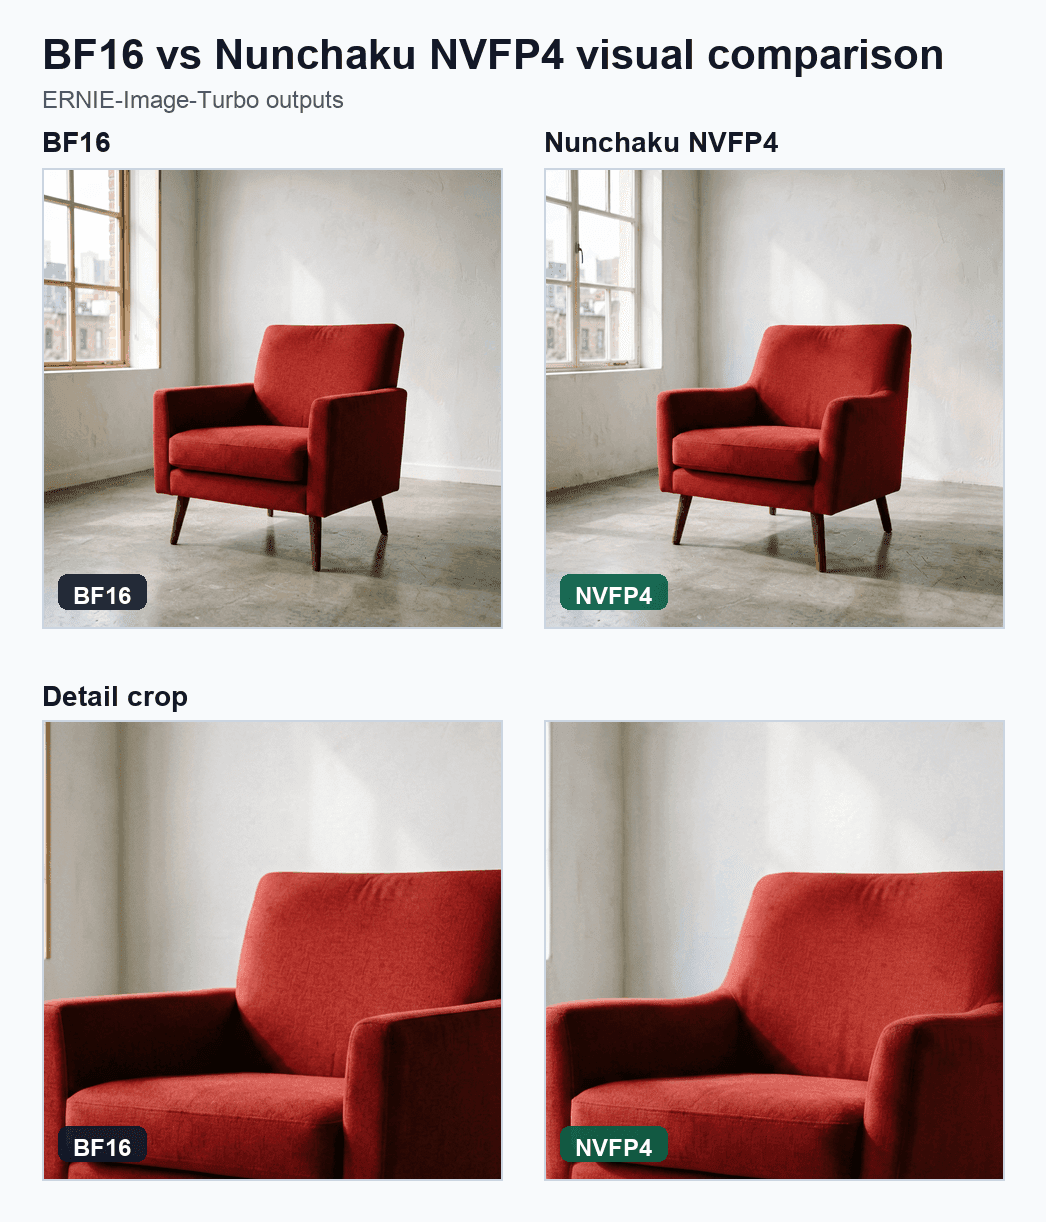
ทดสอบบน NVIDIA RTX PRO 6000 (Blackwell) ที่ความละเอียด 1024x1024:
| Configuration | Full pipeline | Denoise loop | Peak VRAM | Speedup |
|---|---|---|---|---|
| BF16 baseline | 3.00 s | 2.86 s | 31.1 GB | 1.0x |
| Nunchaku Lite NVFP4 | 2.27 s | 2.13 s | 20.6 GB | 1.35x |
Nunchaku Lite NVFP4 + torch.compile | 1.68 s | 1.53 s | 20.6 GB | 1.8x |
Quantizing your own model
กระบวนการทำ Quantization ผ่าน diffuse-compressor มีขั้นตอนหลักๆ คือ:
- ตรวจสอบโมดูลที่สามารถทำ Quantize ได้ด้วย
--inspect-config - รันการทำ Quantization บน Transformer
- รวมผลลัพธ์ลงใน Diffusers Pipeline
- ตรวจสอบภาพและอัปโหลดไปยัง Hugging Face Hub
ในบางโมเดลที่มีโครงสร้างซับซ้อน เช่น FLUX.1 อาจต้องมีการเขียนโครงสร้างโมดูลใหม่ (Structural Rewrite) เพื่อรวมเลเยอร์ Q, K, V ให้เป็นโมดูลเดียว ซึ่ง Nunchaku Lite รองรับผ่าน Runtime Adapter ที่จัดการให้โดยอัตโนมัติในตอนโหลด
Conclusion
SVDQuant และ Nunchaku เป็นหนึ่งในวิธีที่มีประสิทธิภาพสูงสุดในการรัน Diffusion Transformers บนคอมพิวเตอร์ทั่วไป การรองรับแบบ Native ใน Diffusers ช่วยให้ทุกคนเข้าถึงโมเดลคุณภาพสูงได้ง่ายขึ้น โดยใช้หน่วยความจำน้อยลงและทำงานได้เร็วขึ้นกว่าเดิม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร