
LFM2.5-2.6B โมเดลจิ๋วสเปกแรง ติดตั้ง AI Agent ได้ทุกที่แม้บนมือถือ
LFM2.5-2.6B ถูกสร้างขึ้นเพื่อขับเคลื่อน agent ที่มีความสามารถบนตัวอุปกรณ์โดยสมบูรณ์ รองรับการเรียกใช้เครื่องมือ (tool calling) และเวิร์กโฟลว์แบบหลายขั้นตอน (multi-step workflows) ในขณะที่ยังมีขนาดเล็กและเร็วพอสำหรับฮาร์ดแวร์ทั่วไป ตั้งแต่แล็ปท็อปไปจนถึงโทรศัพท์มือถือ สิ่งนี้ช่วยให้นักพัฒนาสามารถติดตั้ง agent ได้ทุกที่ รักษาความเป็นส่วนตัวของข้อมูลไว้บนอุปกรณ์ และขยายการใช้งานได้โดยไม่ต้องมีภาระค่าใช้จ่าย cloud inference
- Agent ระดับชั้นนำ (Best-in-class agent): มีความสามารถแข่งขันกับโมเดลที่ใหญ่กว่า 4 เท่า ในด้านการใช้เครื่องมือ การปฏิบัติตามคำสั่ง (instruction following) และงานเชิง agent หลายขั้นตอน
- Agentic reinforcement learning: ฝึกฝนภายใน harness ของ agent ที่ได้รับความนิยมสูงสุดเพื่อเพิ่มความเข้ากันได้
- การอนุมานที่มีประสิทธิภาพ (Efficient inference): 220 tok/s บน Apple M5 Max และ 113 tok/s บน CPU AMD Ryzen โดยใช้หน่วยความจำไม่ถึง 2.5 GB
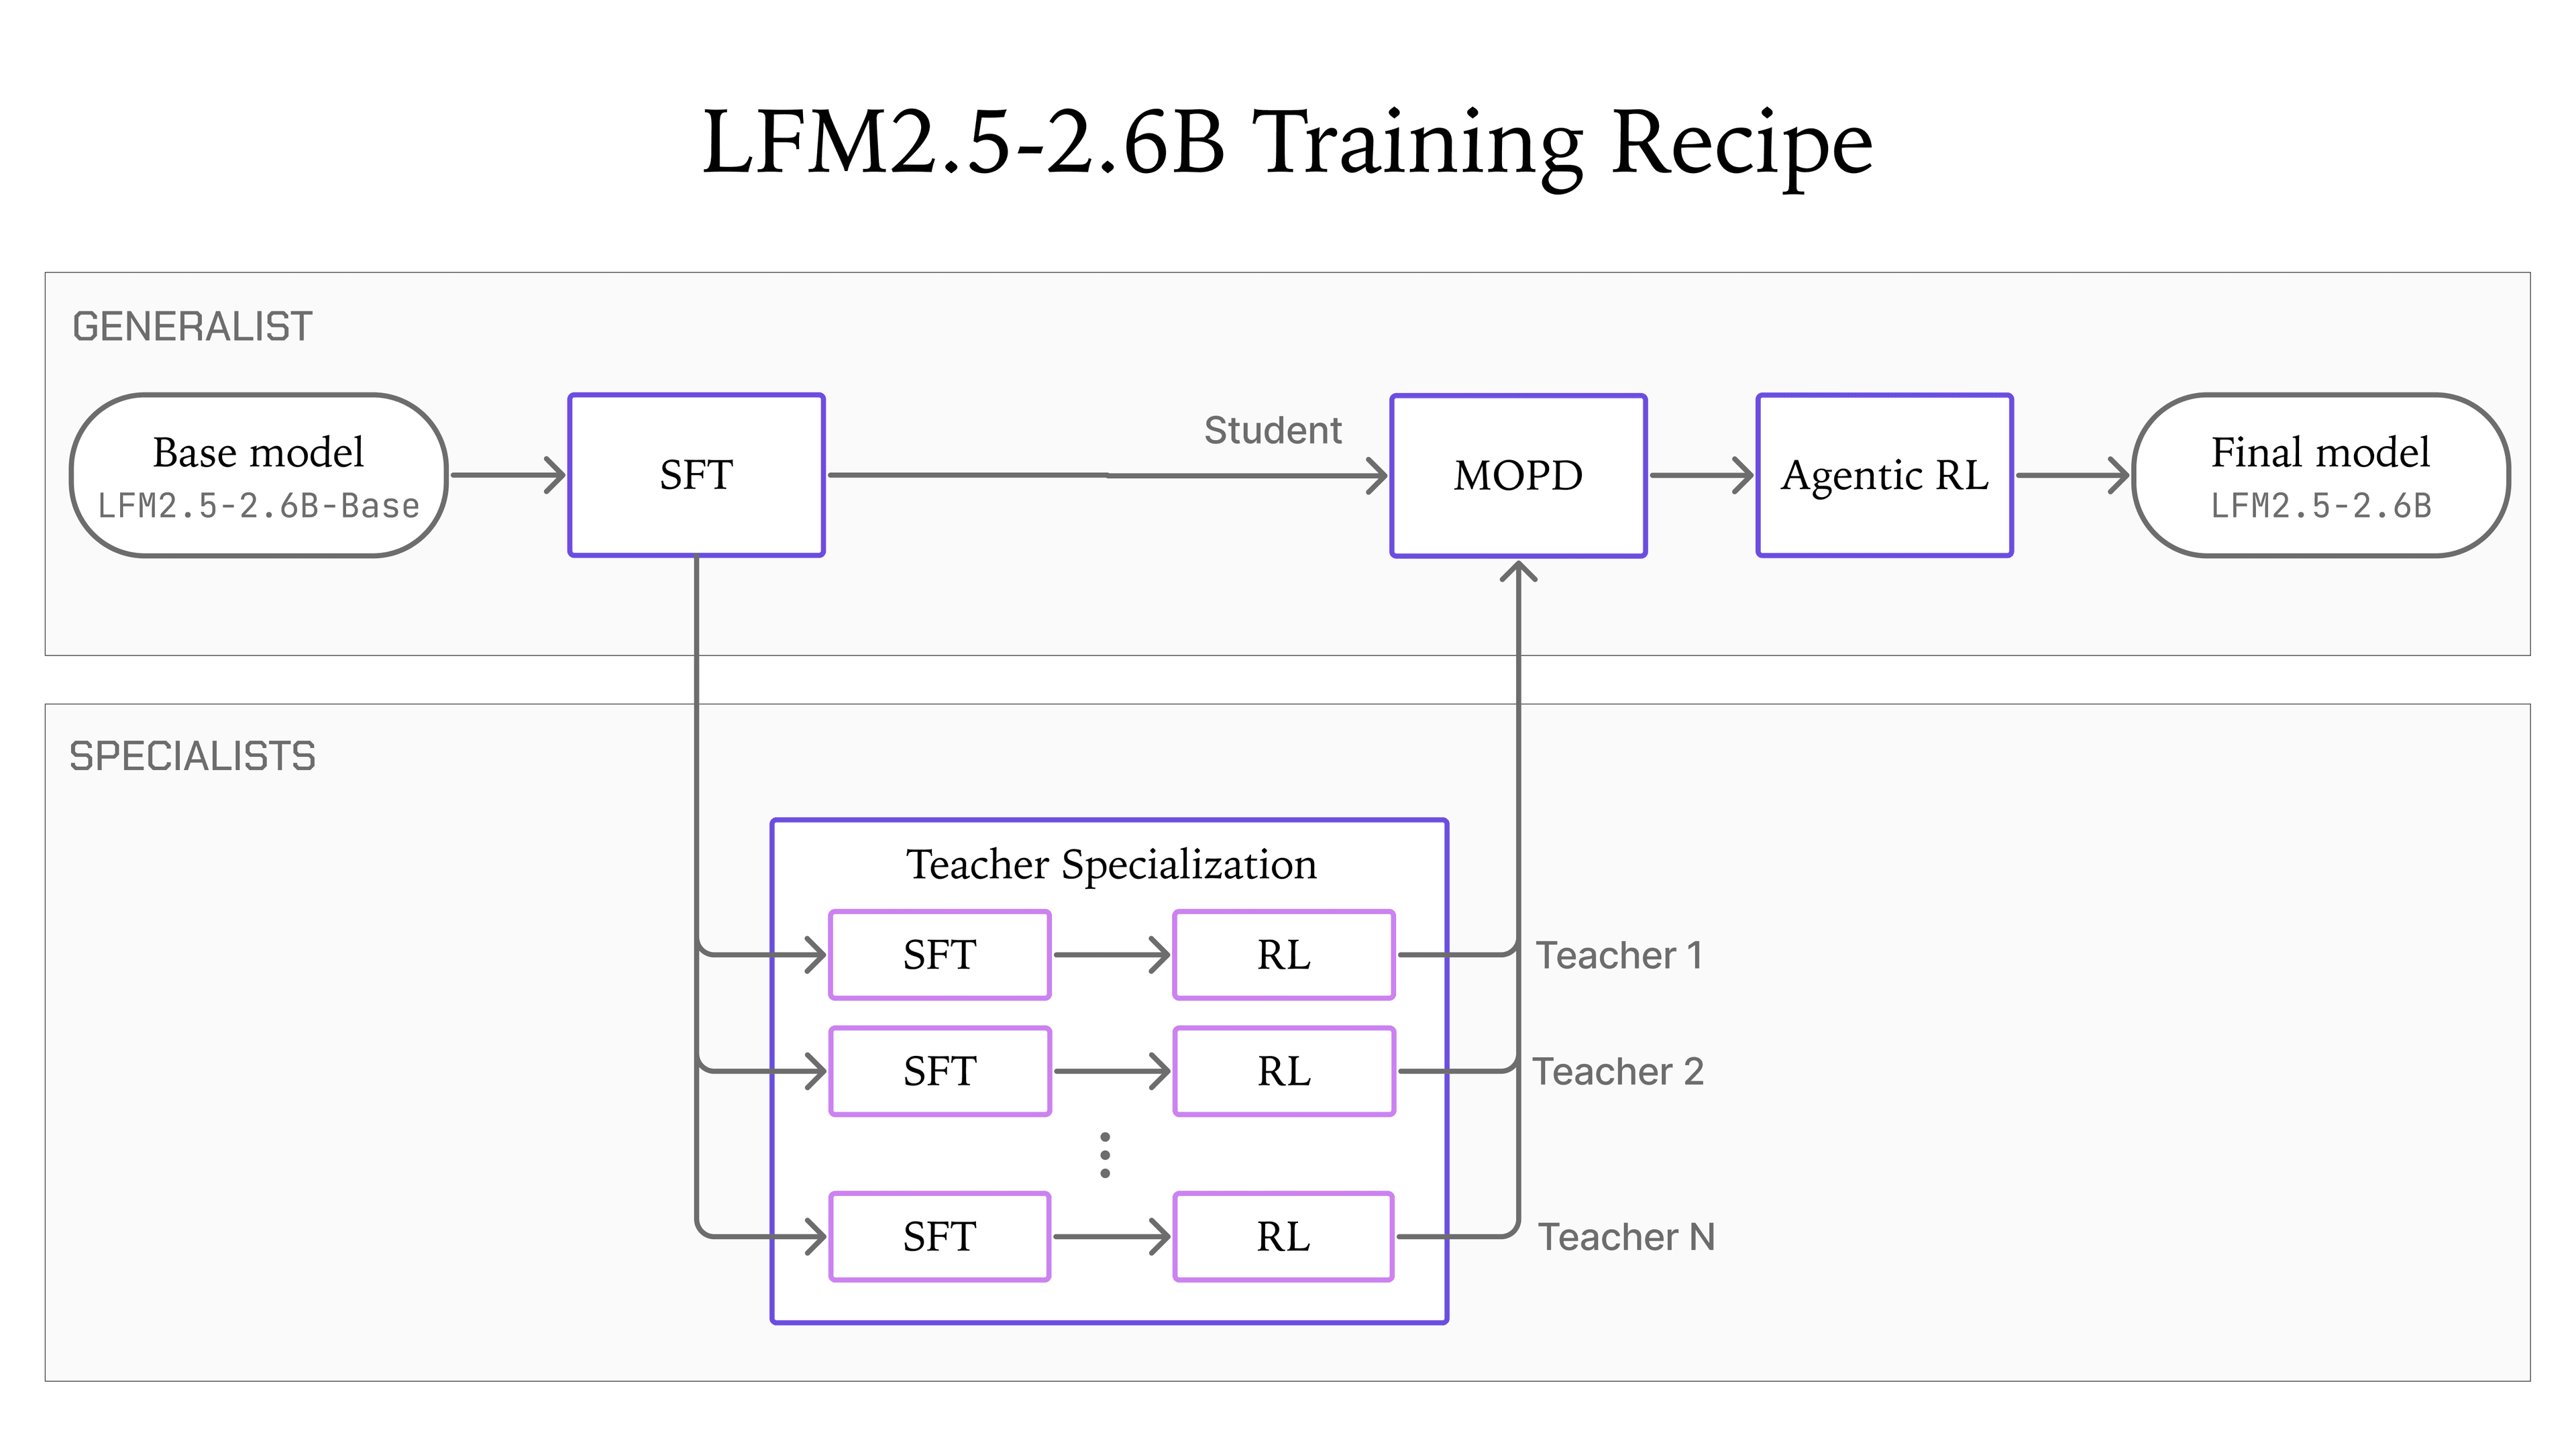
เราสร้างโมเดล agentic ที่เชื่อถือได้สำหรับอุปกรณ์ edge ได้อย่างไร
LFM2.5-2.6B ได้รับการ pre-trained บนโทเค็นประมาณ 34T โดยมีช่วง mid-training ที่ขยาย context window เป็น 128K จากนั้นขั้นตอน post-training จะเปลี่ยนโมเดลฐานให้กลายเป็น agent ใน 4 ระยะ:
- Supervised fine-tuning (SFT): การทำ SFT สองรอบ โดยเน้นหนักไปที่ข้อมูลเชิง agent เช่น การใช้เครื่องมือ การค้นหาเว็บ และเส้นทาง (trajectories) ของ harness
- Teacher specialization: ฝึกสอน teacher ที่เป็นผู้เชี่ยวชาญหนึ่งรายต่อหนึ่งโดเมน (คณิตศาสตร์, โค้ด, การใช้เครื่องมือ และอื่นๆ)
- Multi-domain on-policy distillation (MOPD): กลั่นกรอง (distill) ความรู้จาก teacher ผู้เชี่ยวชาญหลายรายลงสู่ student เพียงรายเดียว
- Agentic Reinforcement Learning (Agentic RL): รัน RL แบบหลายรอบ (multi-turn) ภายใน harness ของ agent จริง ซึ่งโมเดลจะเรียนรู้การทำงานผ่านเครื่องมือต่างๆ, system prompts และสภาพแวดล้อมของงานแบบหลายรอบ
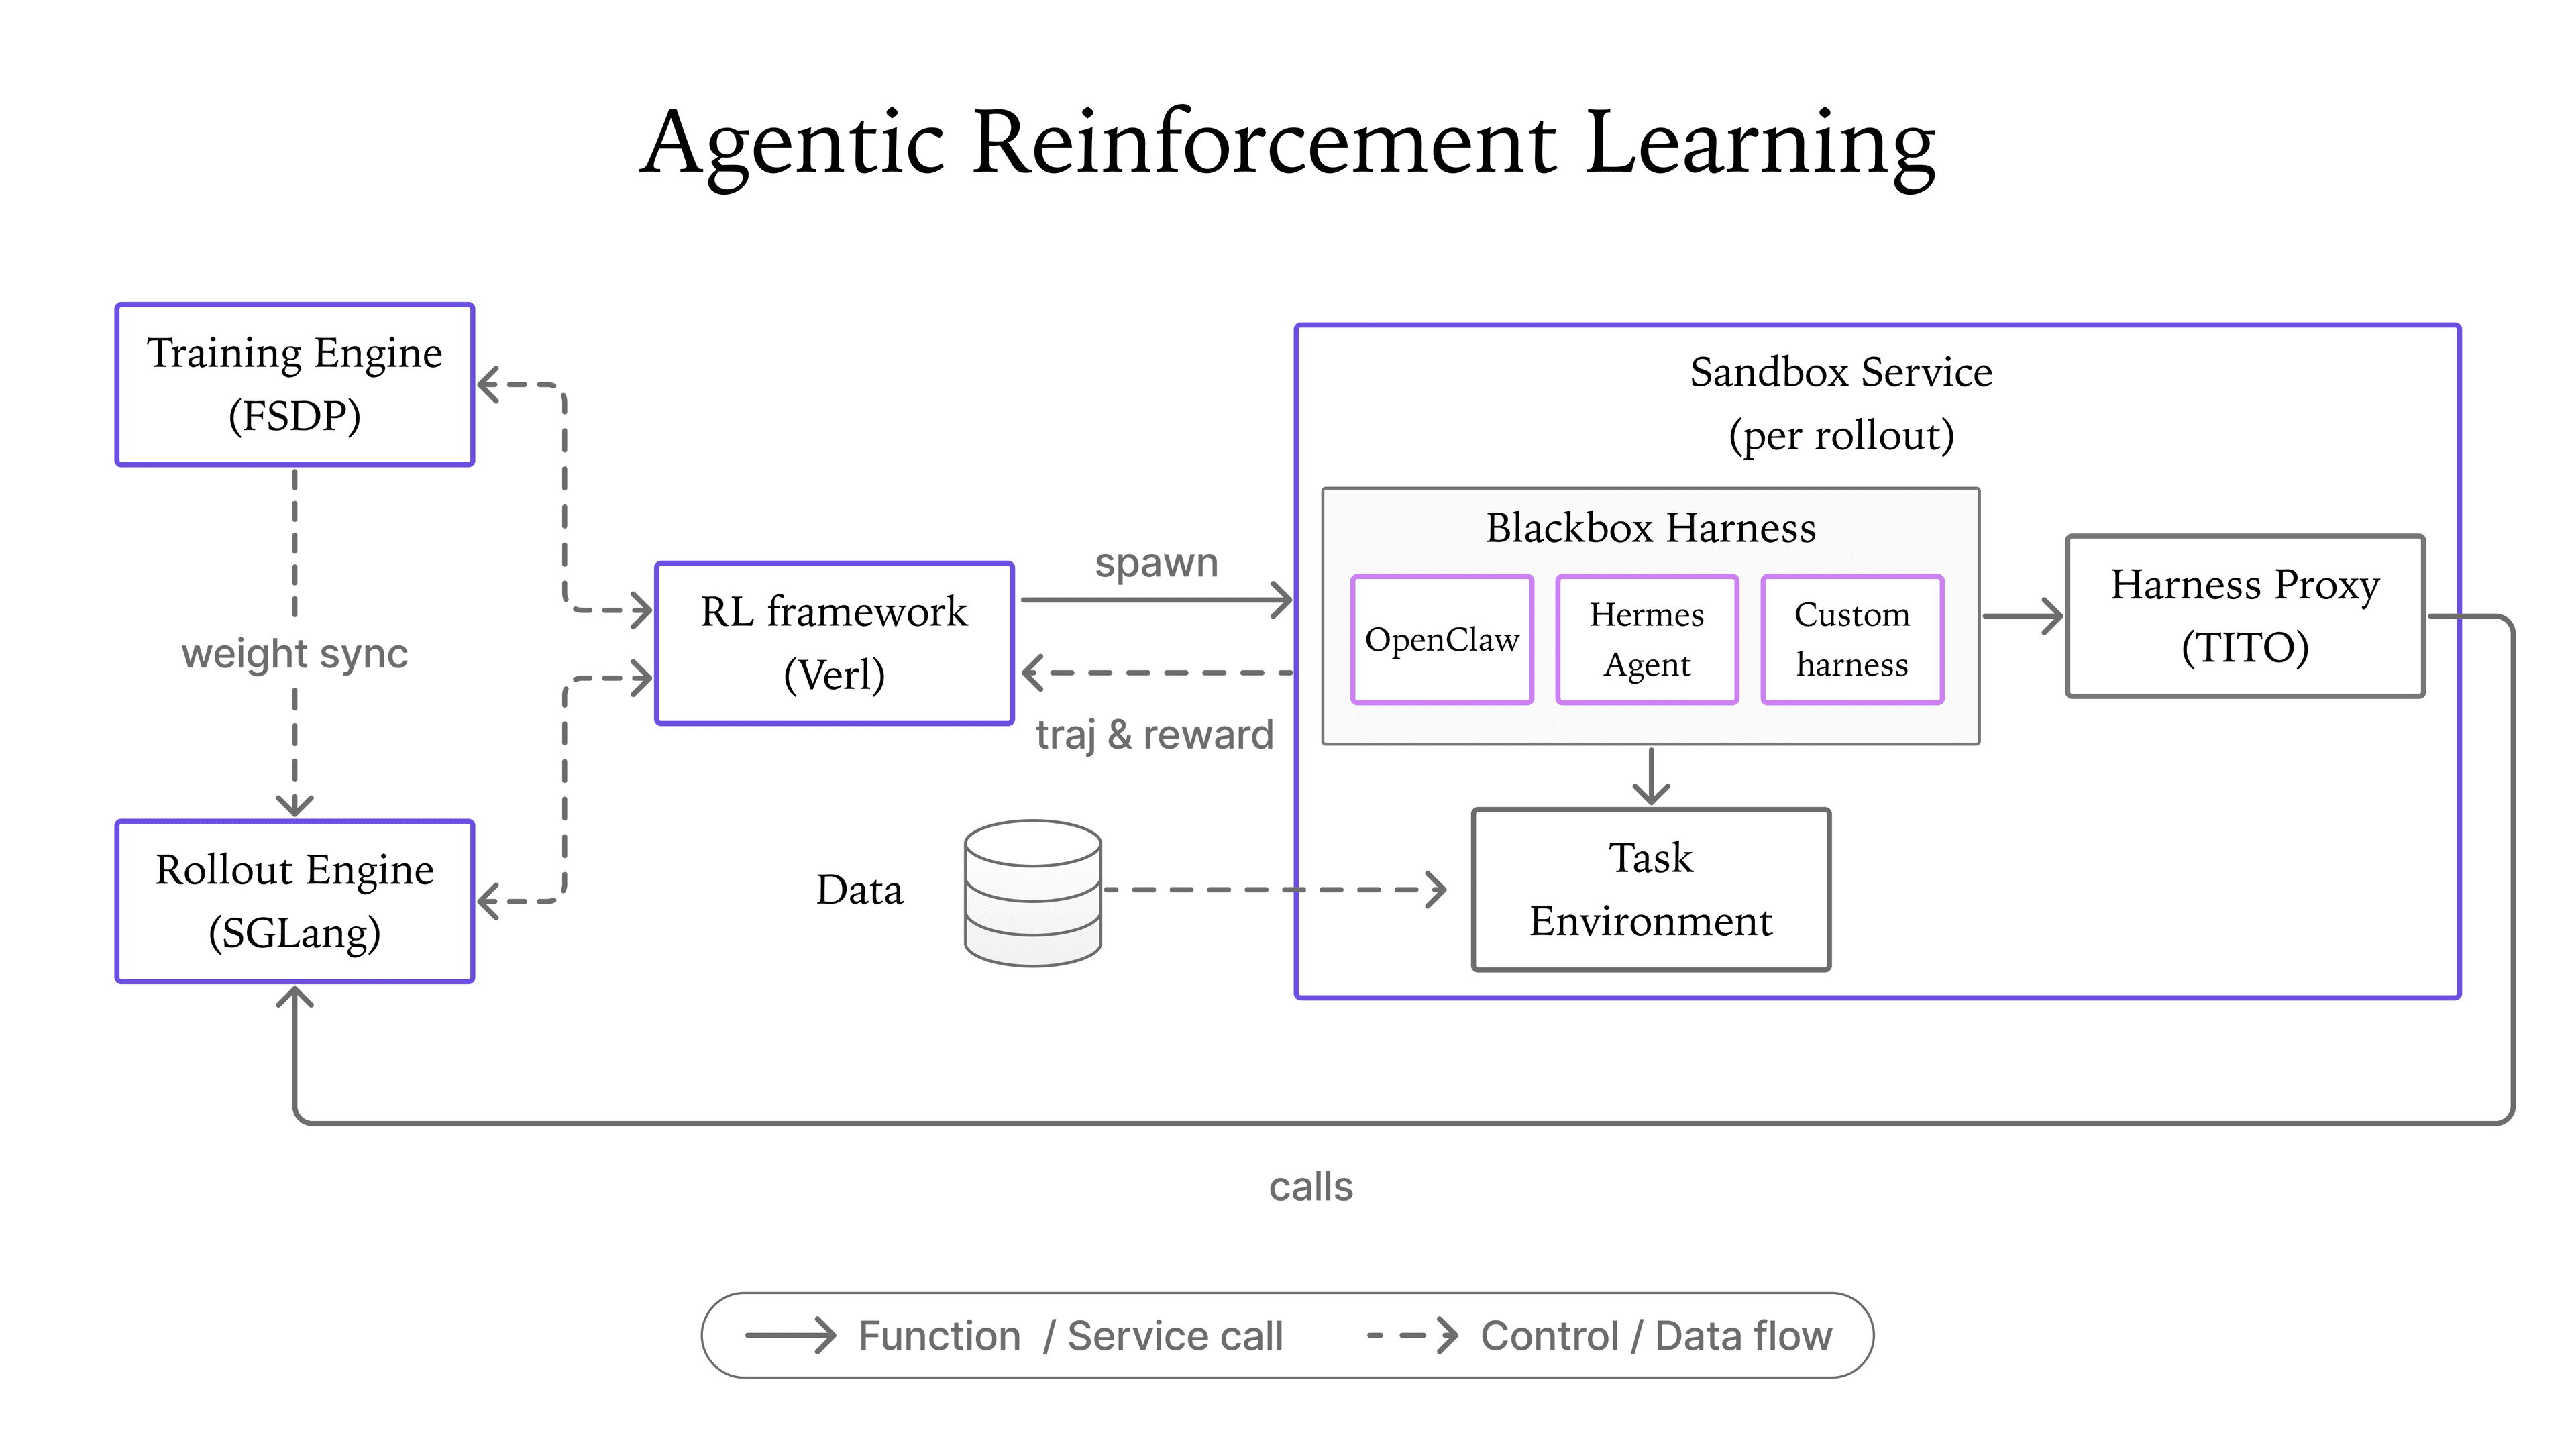
ไปป์ไลน์ Agentic RL แยกการเพิ่มประสิทธิภาพโมเดล (model optimization), การอนุมาน (inference) และการรันสภาพแวดล้อมออกเป็นส่วนประกอบที่ชัดเจน โดย Training Engine จะเพิ่มประสิทธิภาพโมเดล ในขณะที่ Rollout Engine จะสร้างการกระทำ (actions) โดยใช้ policy ล่าสุด ส่วน RL framework จะประสานลูปการฝึกฝนโดยการเปิดตัว rollout, รวบรวมเส้นทางและรางวัล (rewards) และอัปเดตโมเดล
การกระทำต่างๆ จะถูกดำเนินการภายใน Sandbox Service โดยมี Blackbox Harness ทำหน้าที่โฮสต์ agent (เช่น OpenClaw หรือ Hermes Agent) และประสานการโต้ตอบกับสภาพแวดล้อมของงาน Harness Proxy ช่วยให้เราสามารถปฏิบัติกับ harness ของ agent เสมือนเป็น black box ได้โดยไม่ต้องแก้ไขอะไรเลย ในขณะที่ยังดักจับเส้นทางในระดับโทเค็นที่จำเป็นต่อการสร้างใหม่และตรวจสอบความถูกต้องของตัวอย่างการฝึก RL ได้อย่างโปร่งใส
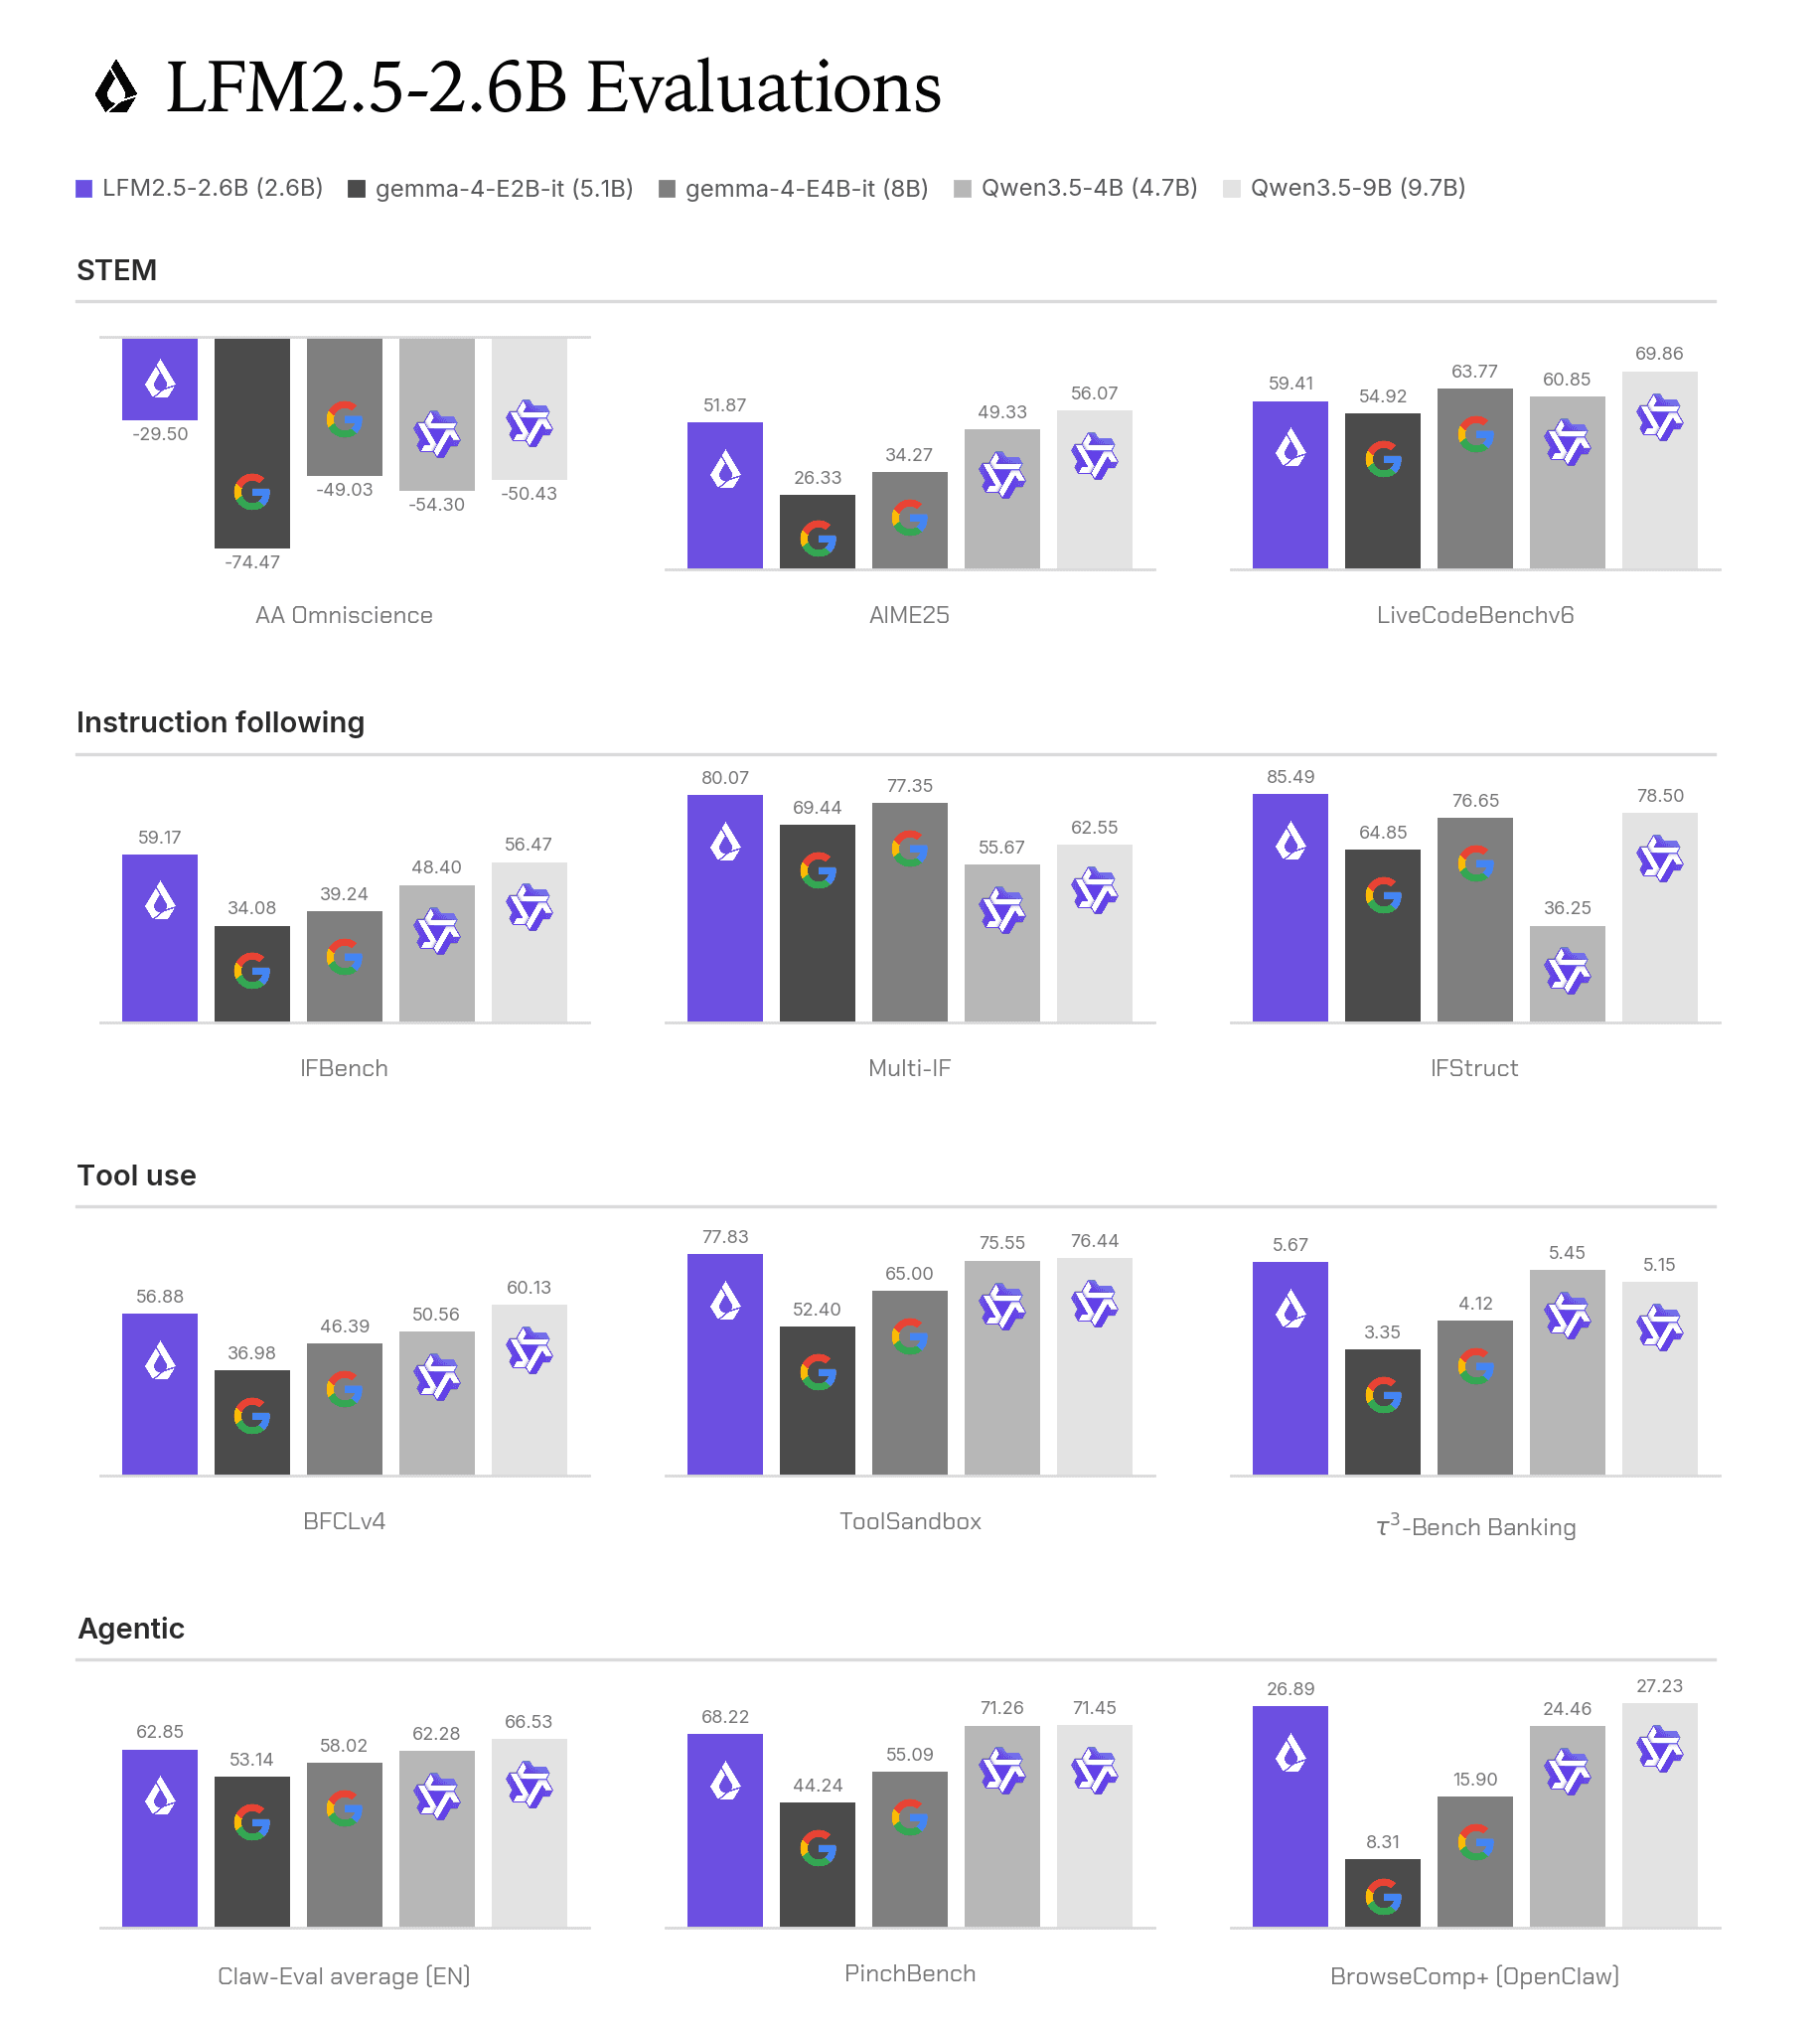
ผลการทดสอบ Benchmark
เราได้ประเมิน LFM2.5-2.6B เทียบกับโมเดลที่มีขนาดใหญ่กว่าถึงประมาณ 4 เท่า ในด้าน STEM, การปฏิบัติตามคำสั่ง, การใช้เครื่องมือ และงานเชิง agent แม้จะเป็นโมเดลที่เล็กที่สุดในกลุ่ม แต่มันสามารถแข่งขันได้และมักจะเอาชนะโมเดลอื่นๆ ได้
| Benchmark | LFM2.5-2.6B (2.6B) | gemma-4-E2B-it (5.1B) | gemma-4-E4B-it (8B) | Qwen3.5-4B (4.7B) | Qwen3.5-9B (9.7B) |
|---|---|---|---|---|---|
| AA Omniscience | -29.50 | -74.47 | -49.03 | -54.30 | -50.43 |
| AIME25 | 51.87 | 26.33 | 34.27 | 49.33 | 56.07 |
| LiveCodeBenchv6 | 59.41 | 54.92 | 63.77 | 60.85 | 69.86 |
| IFBench | 59.17 | 34.08 | 39.24 | 48.40 | 56.47 |
| Multi-IF | 80.07 | 69.44 | 77.35 | 55.67 | 62.55 |
| IFStruct | 85.49 | 64.85 | 76.65 | 36.25 | 78.50 |
| BFCLv4 | 56.88 | 36.98 | 46.39 | 50.56 | 60.13 |
| ToolSandbox | 77.83 | 52.40 | 65.00 | 75.55 | 76.44 |
| τ³-Bench Banking | 5.67 | 3.35 | 4.12 | 5.45 | 5.15 |
| Claw-Eval average (EN) | 62.85 | 53.14 | 58.02 | 62.28 | 66.53 |
| PinchBench | 68.22 | 44.24 | 55.09 | 71.26 | 71.45 |
| BrowseComp+ (OpenClaw) | 26.89 | 8.31 | 15.90 | 24.46 | 27.23 |
สำหรับแอปพลิเคชันของคุณ จุดแข็งคือการปฏิบัติตามคำสั่งและการใช้เครื่องมือ LFM2.5-2.6B เป็นอันดับหนึ่งในทุก benchmark ด้านการปฏิบัติตามคำสั่ง และเกือบทุก benchmark ด้านการใช้เครื่องมือ ยกเว้น BFCLv4 ที่มีเพียง Qwen 9.7B เท่านั้นที่เฉือนชนะไปได้ ในงานเชิง agent มันสามารถเอาชนะโมเดล Gemma ทั้งสองรุ่นและอยู่ในระดับเดียวกับตระกูล Qwen นอกจากนี้ยังนำในด้านความรู้และทำได้ใกล้เคียงในด้านคณิตศาสตร์ ส่วนการเขียนโค้ดเป็นจุดเดียวที่โมเดลขนาดใหญ่กว่ายังคงนำอยู่อย่างชัดเจน
ความเร็วในการอนุมานบน CPU และ GPU
LFM2.5-2.6B เปิดตัวพร้อมการรองรับตั้งแต่วันแรกในระบบนิเวศการอนุมาน รวมถึง llama.cpp, MLX, vLLM, SGLang และ ONNX
การอนุมานบน CPU: ด้วยสถาปัตยกรรม LFM2 ที่มีประสิทธิภาพ LFM2.5-2.6B จึงเป็นโมเดลที่เร็วที่สุดที่เราทดสอบ โดยมีความเร็วในการถอดรหัส (decode) 220 tokens/s บน M5 Max และ 113 tokens/s บน Ryzen AI Max+ 395 ด้วยความเร็ว 30 tokens/s มันช่วยให้คุณรัน agent ที่มีความสามารถได้แม้กระทั่งบนโทรศัพท์มือถือ
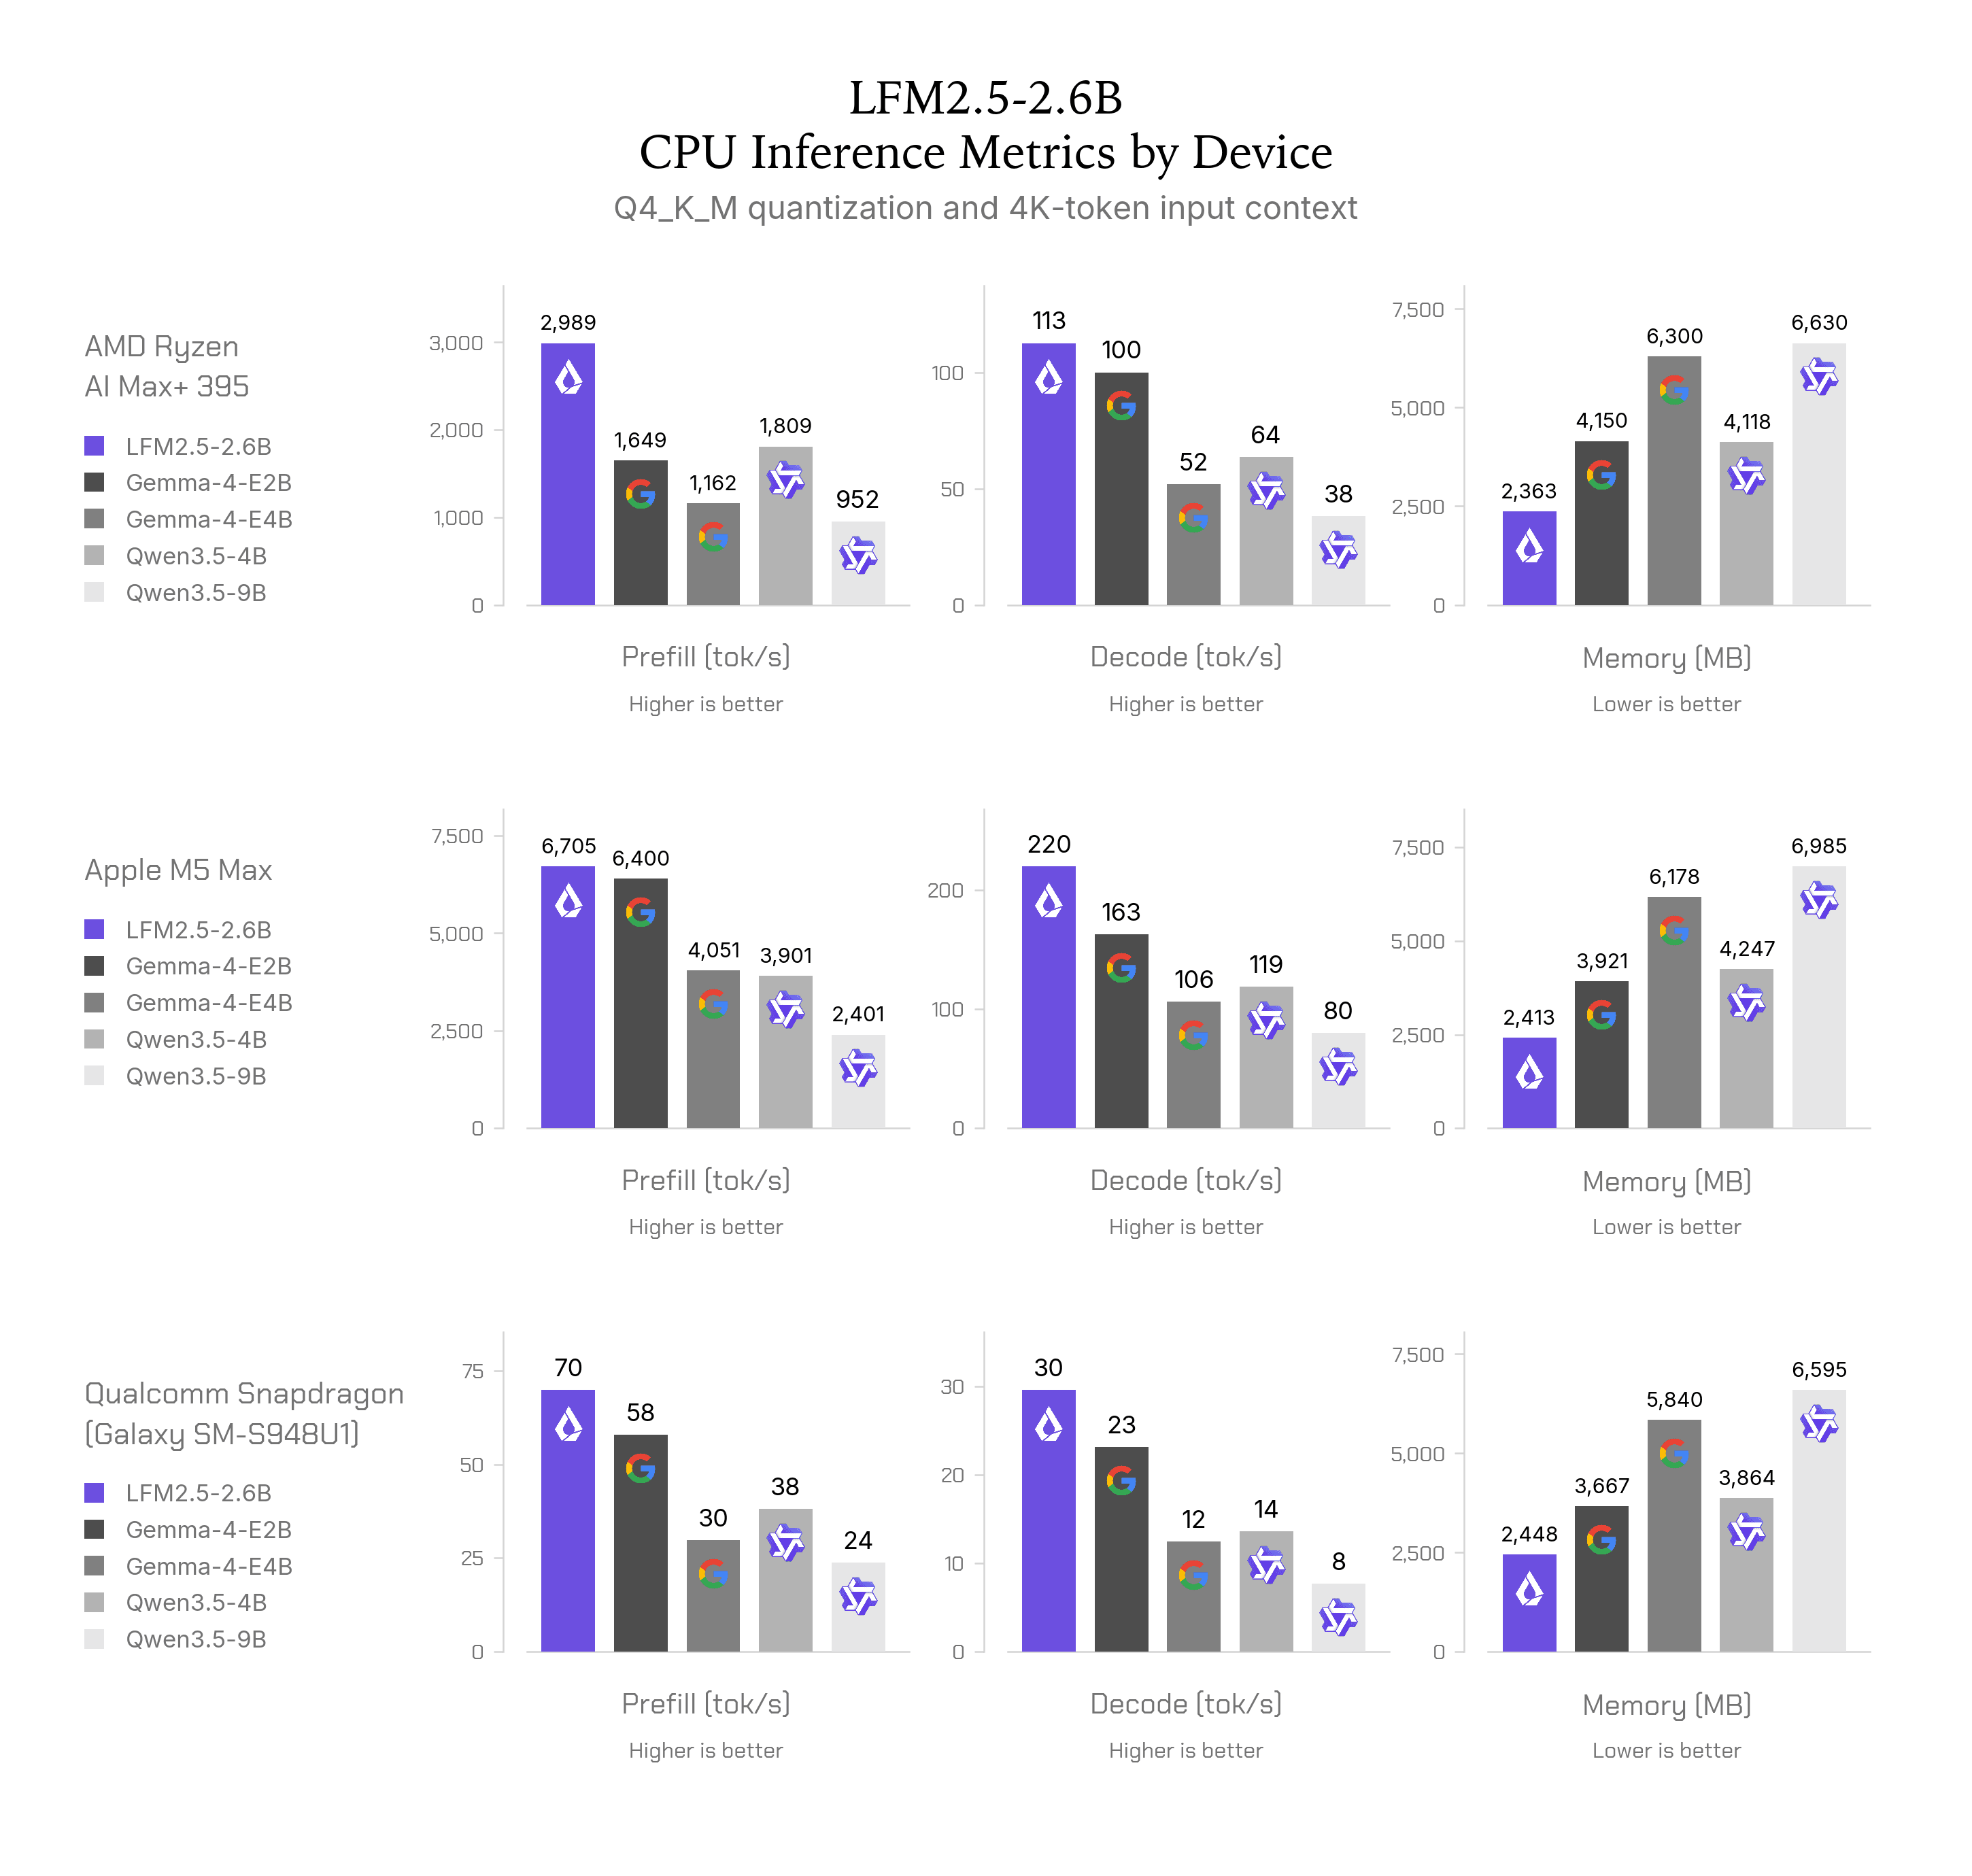
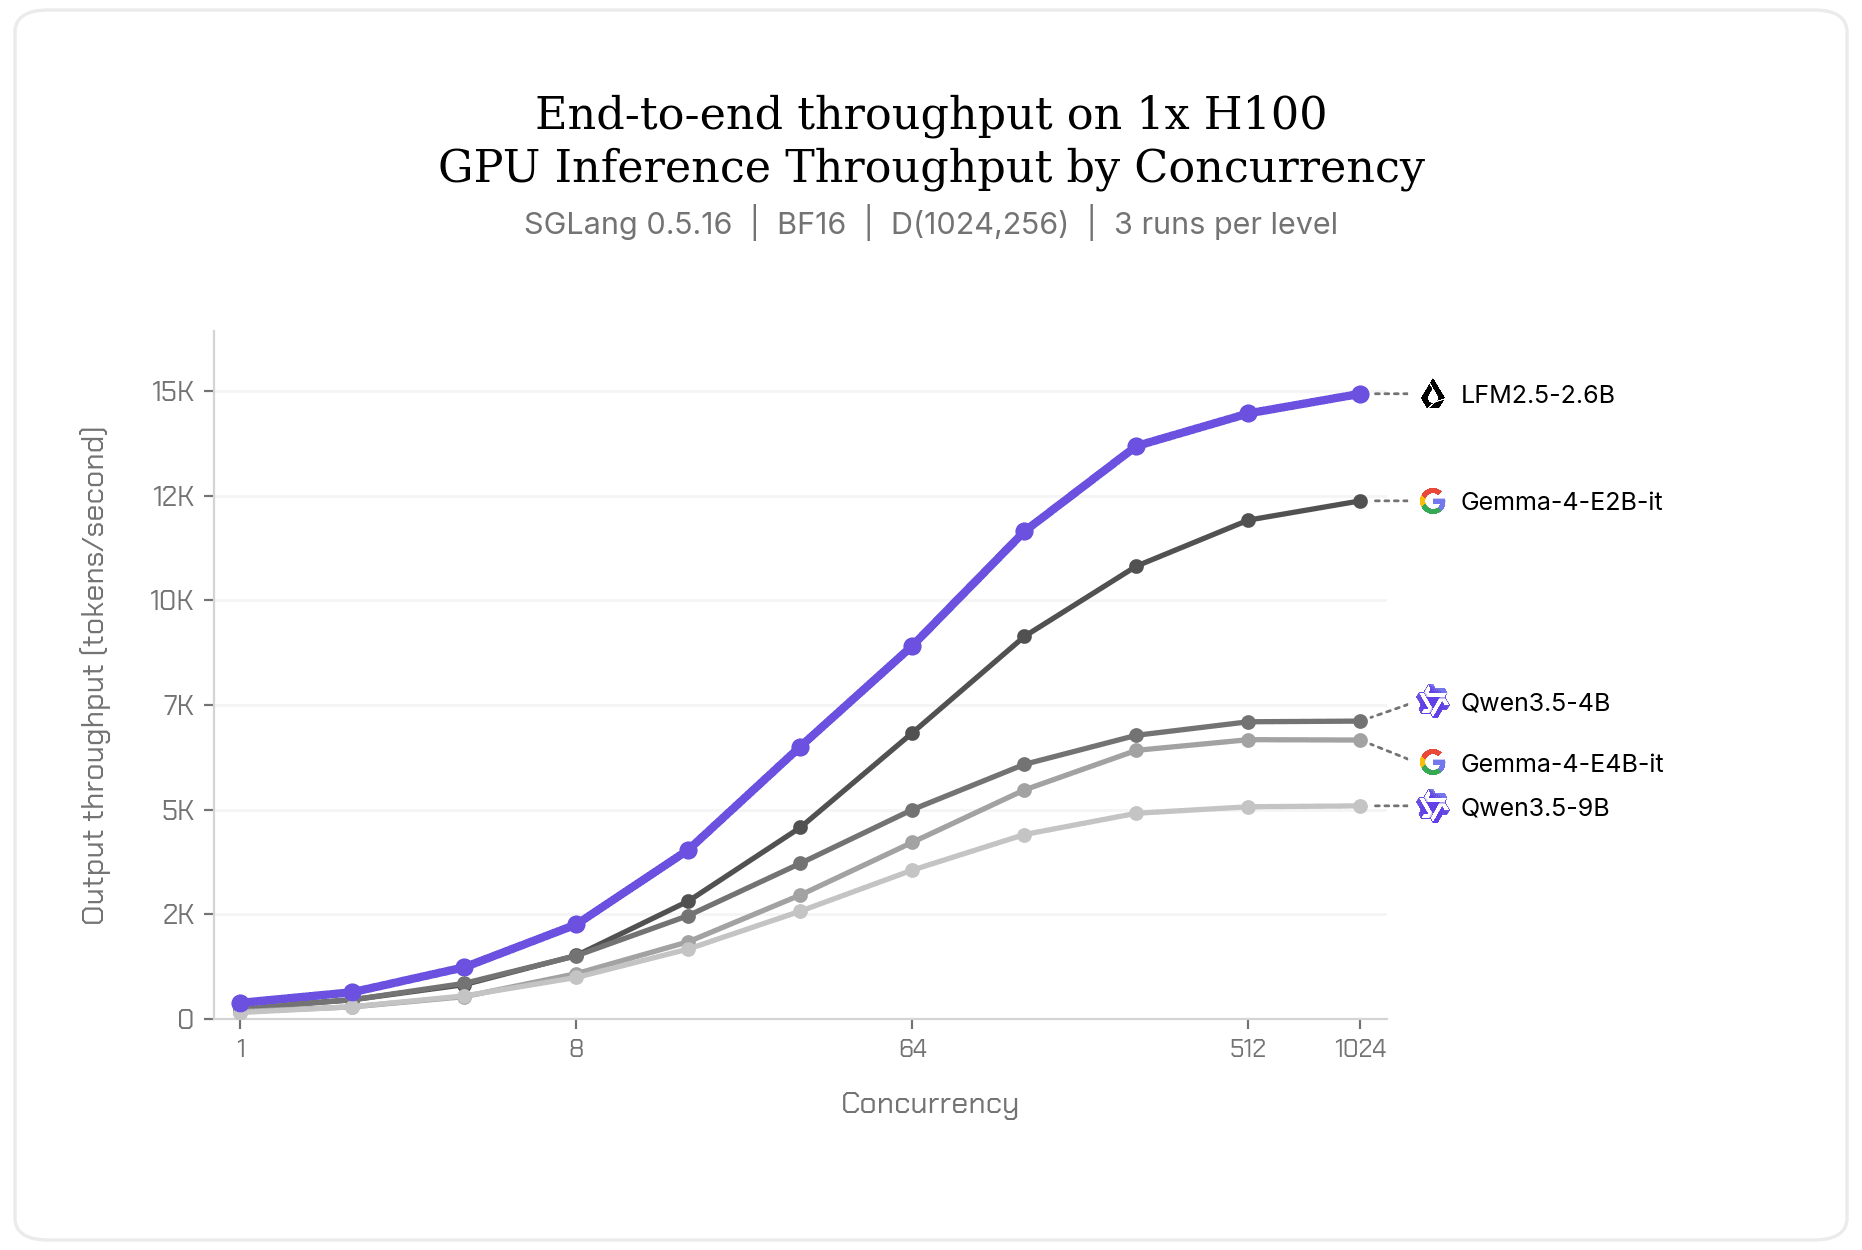
การอนุมานบน GPU: LFM2.5-2.6B เป็นโมเดลที่เร็วที่สุดในกลุ่มขนาดเดียวกัน โดยทำความเร็วได้เกือบ 15K output tokens ต่อวินาทีที่ระดับ concurrency สูง หรือประมาณ 1.3B tokens ต่อวันบน H100 เครื่องเดียว
วิธีการใช้งาน LFM2.5-2.6B
เลือกใช้ LFM2.5-2.6B เมื่อคุณต้องการ agent บนอุปกรณ์สำหรับเวิร์กโหลดปริมาณมาก โดยเริ่มจากการติดตั้ง transformers เวอร์ชันล่าสุด:
pip install -U transformersจากนั้นโหลดและรันโมเดลด้วยโค้ดดังนี้:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "LiquidAI/LFM2.5-2.6B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2"  # uncomment on a compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)

prompt = "What is C. elegans?"
input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
).to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.2,
    top_k=80,
    repetition_penalty=1.05,
    max_new_tokens=512,
)
print(tokenizer.decode(output[0], skip_special_tokens=False))
เดโม LFM2.5-2.6B
คุณสามารถลองใช้งาน เดโมบนเบราว์เซอร์ของ LFM2.5-2.6B ที่ขับเคลื่อน research agent โดย agent จะช่วยคุณหาข้อมูลสำหรับคำถามเฉพาะเจาะจงและสรุปเนื้อหาให้ทันที
เริ่มต้นใช้งาน
ทั้ง LFM2.5-2.6B และ LFM2.5-2.6B-Base พร้อมใช้งานบน Hugging Face แล้ววันนี้ ด้วย LFM2.5 เรากำลังทำให้วิสัยทัศน์ของ AI ที่รันได้ทุกที่กลายเป็นจริง:
- ดาวน์โหลด: LFM2.5-2.6B-Base และ LFM2.5-2.6B บน Hugging Face
- ทดลอง: รันเดโม WebGPU ในเบราว์เซอร์ได้ทันทีโดยไม่ต้องตั้งค่าใดๆ
- การปรับใช้: ศึกษา คู่มือ ของเราเพื่อรัน agent เฉพาะที่อย่าง OpenClaw, Hermes Agent และ Pi
การอ้างอิง (Citation)
โปรดอ้างอิงบทความนี้ดังนี้:
Liquid AI, "LFM2.5-2.6B: Deploy Agents Everywhere", Liquid AI Blog, Aug 2026.หรือใช้การอ้างอิงแบบ BibTeX:
@article{liquidAI202626B,
  author  = {Liquid AI},
  title   = {LFM2.5-2.6B: Deploy Agents Everywhere},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-2-6b},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร