
LFM2.5-24B-A2B โมเดลจิ๋วแต่แจ๋ว รัน Agent ส่วนตัวได้เร็วแรง
LFM2.5-24B-A2B คือโมเดลการให้เหตุผลขนาด 24B พารามิเตอร์ที่มีจุดเด่นคือมีพารามิเตอร์ทำงานจริง (active parameters) เพียง 2B เท่านั้น โมเดลนี้ถูกสร้างขึ้นเพื่อเป็น AI Agent บนอุปกรณ์ที่มีความเร็วสูงและมีความเป็นส่วนตัว
โมเดลสามารถคิดวิเคราะห์ก่อนตอบ เรียกใช้เครื่องมือ และจัดการภารกิจที่ซับซ้อนหลายขั้นตอนได้ผ่านเฟรมเวิร์ก agent ยอดนิยม ด้วยการใช้พารามิเตอร์ทำงานเพียง 2B ต่อหนึ่ง token ทำให้การประมวลผลการให้เหตุผลมีต้นทุนต่ำมาก ผู้ใช้จึงสามารถรัน agent ได้อย่างต่อเนื่องบนฮาร์ดแวร์ของตัวเอง
ความสามารถที่น่าสนใจของโมเดลนี้ประกอบด้วย:
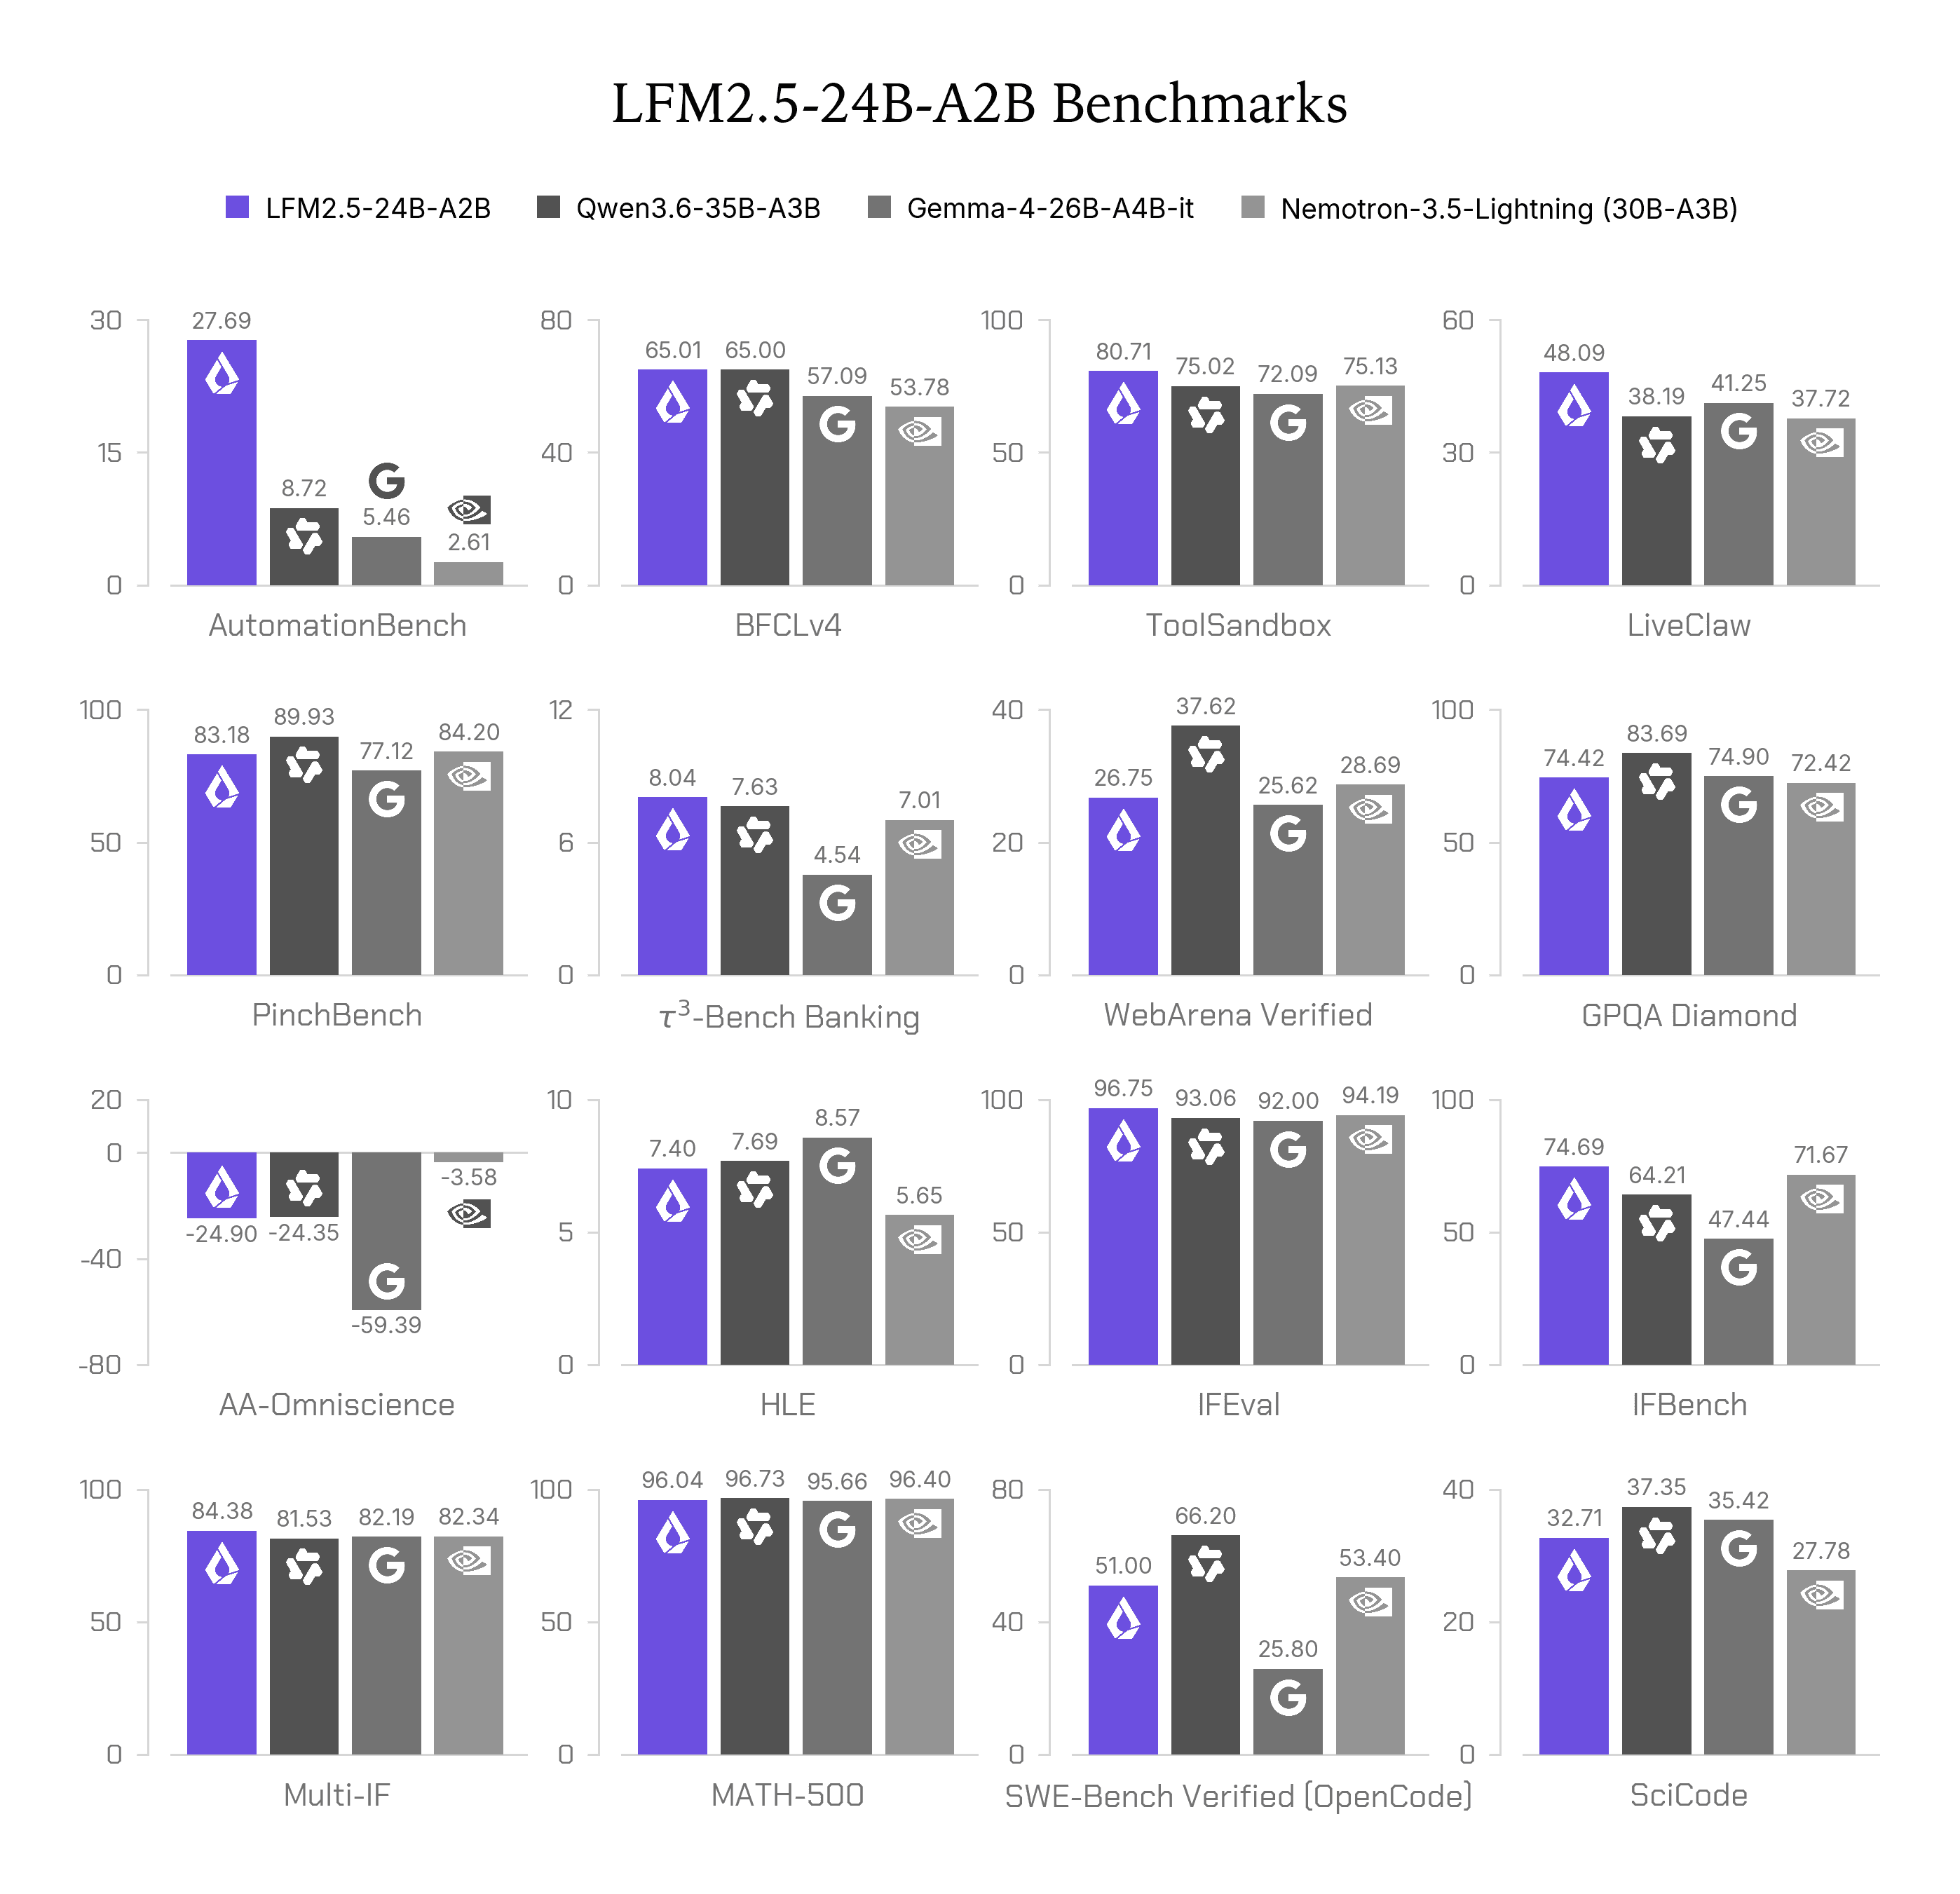
- Agent ระดับชั้นนำ: มีศักยภาพเหนือกว่า Qwen3.6-35B-A3B ในงานด้านการใช้เครื่องมือ โดยทำคะแนนบน LiveClaw ได้ 48.09 เทียบกับ 38.19 แม้จะมีพารามิเตอร์น้อยกว่า
- การให้เหตุผลด้วยความเร็ว MoE: ระบบจะคิดก่อนตอบเสมอ โดยใช้พารามิเตอร์ทำงานจริงเพียง 2B ต่อ token ช่วยให้การประมวลผลประหยัดทรัพยากร
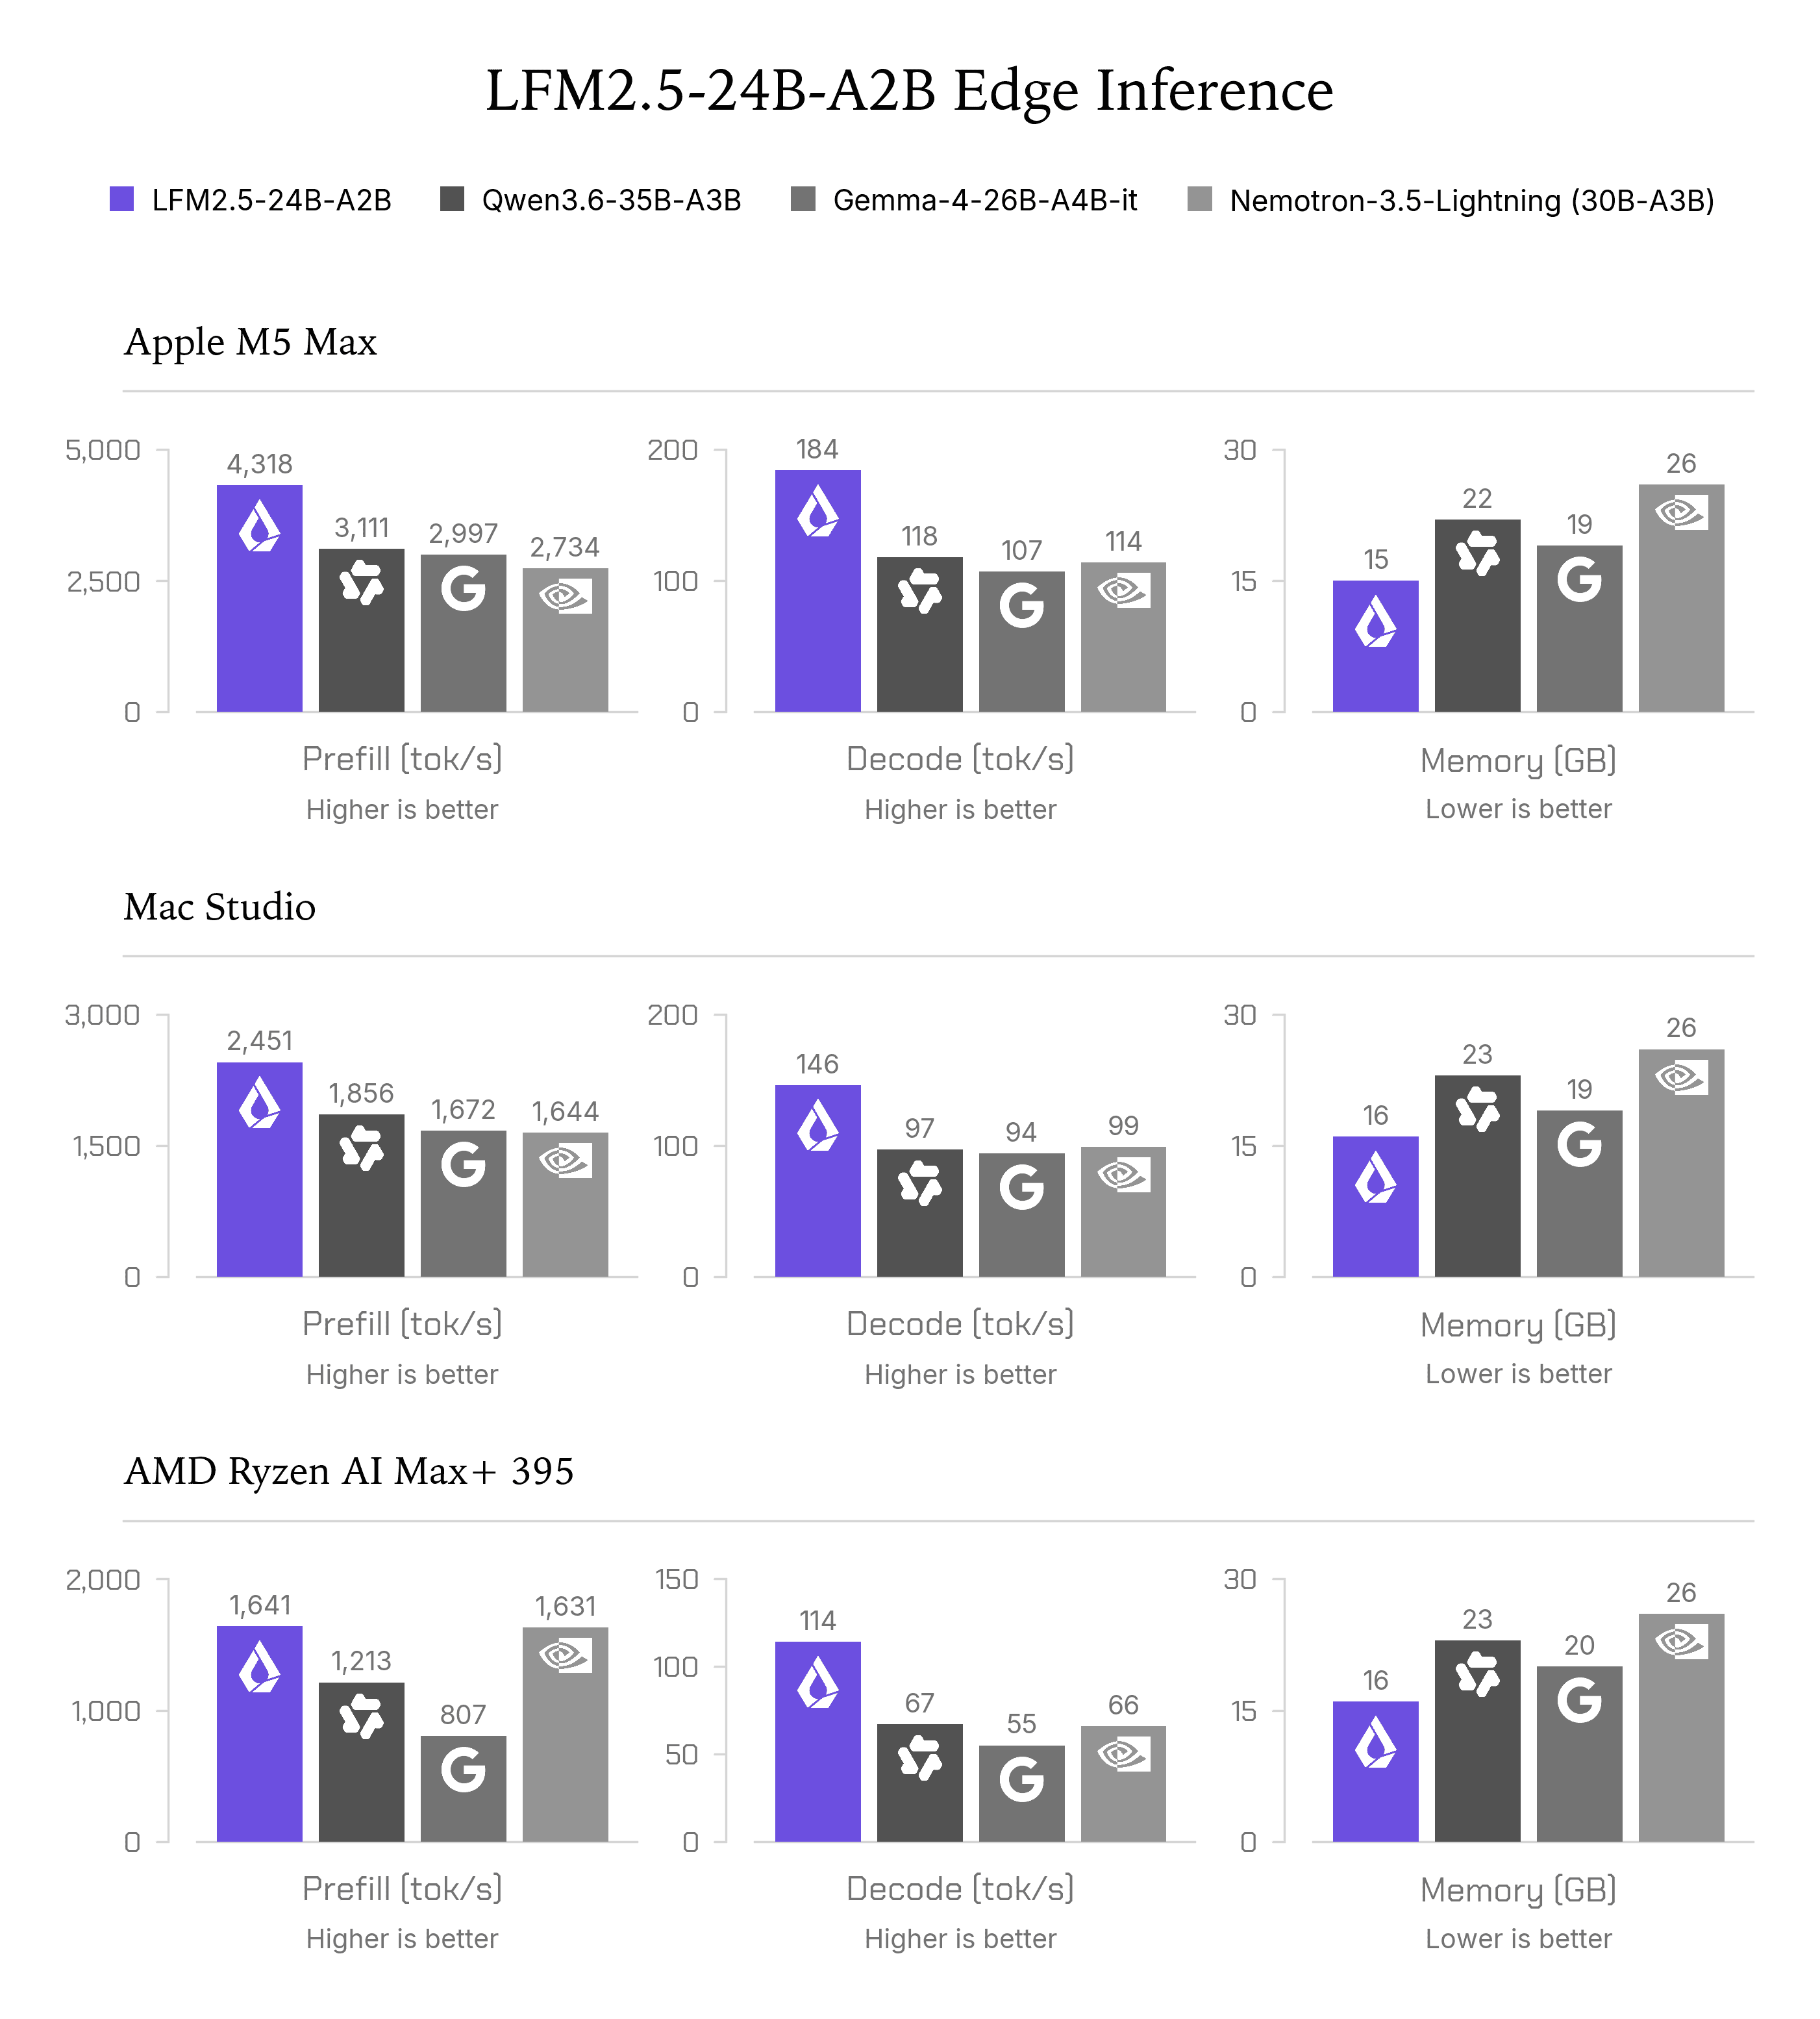
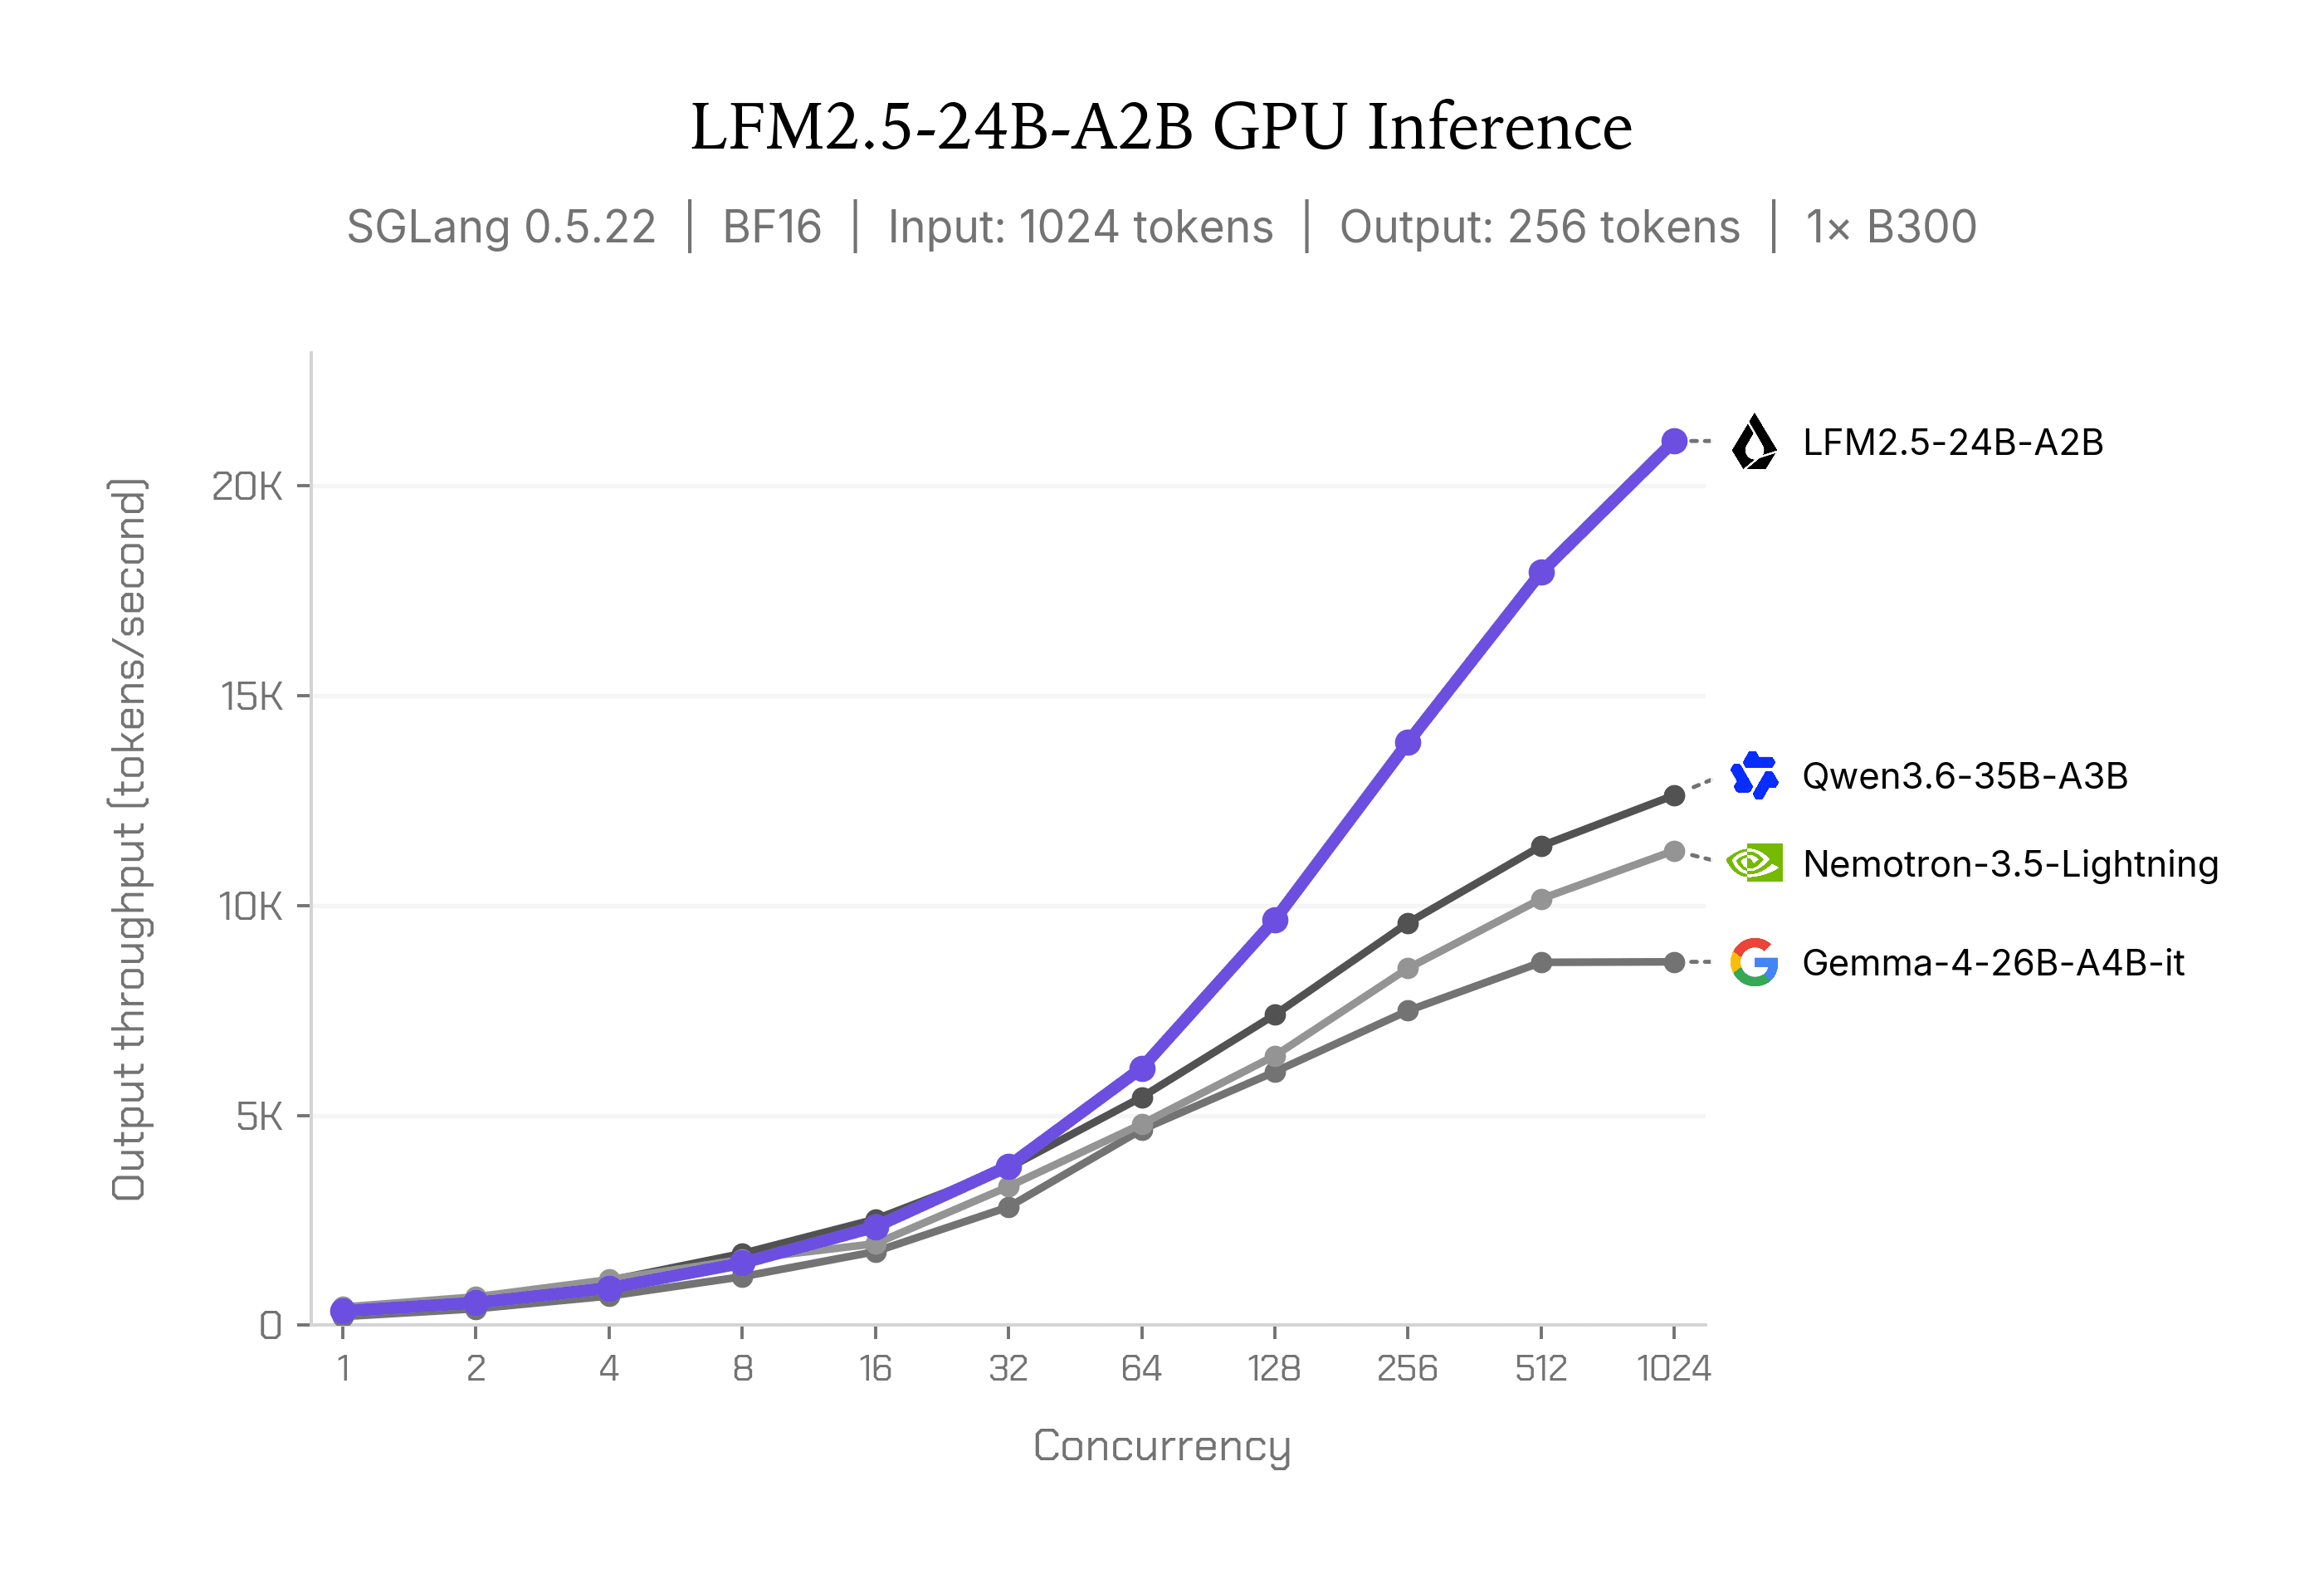
- ประสิทธิภาพที่เหนือชั้น: ทำความเร็วได้ 184 tok/s บน Apple M5 Max และสูงสุดถึง 21K output tok/s เมื่อใช้ GPU NVIDIA B300 เพียงตัวเดียว
กระบวนการสร้าง Agent การให้เหตุผลขนาด 2B
LFM2.5-24B-A2B พัฒนาต่อยอดจาก LFM2-24B-A2B โดยยังคงโครงสร้างหลักไว้ เช่น 40 เลเยอร์ และ 64 experts ต่อบล็อก MoE พร้อมการเลือกเส้นทางแบบ top-4 นอกจากนี้ยังมีการขยาย context window จาก 32K เป็น 131K tokens และใช้การทำ in-place tokenizer expansion เพื่อเพิ่มขนาดคำศัพท์เป็น 128K tokens ช่วยให้ประมวลผลภาษาที่ไม่ใช่ละตินได้ดีขึ้น
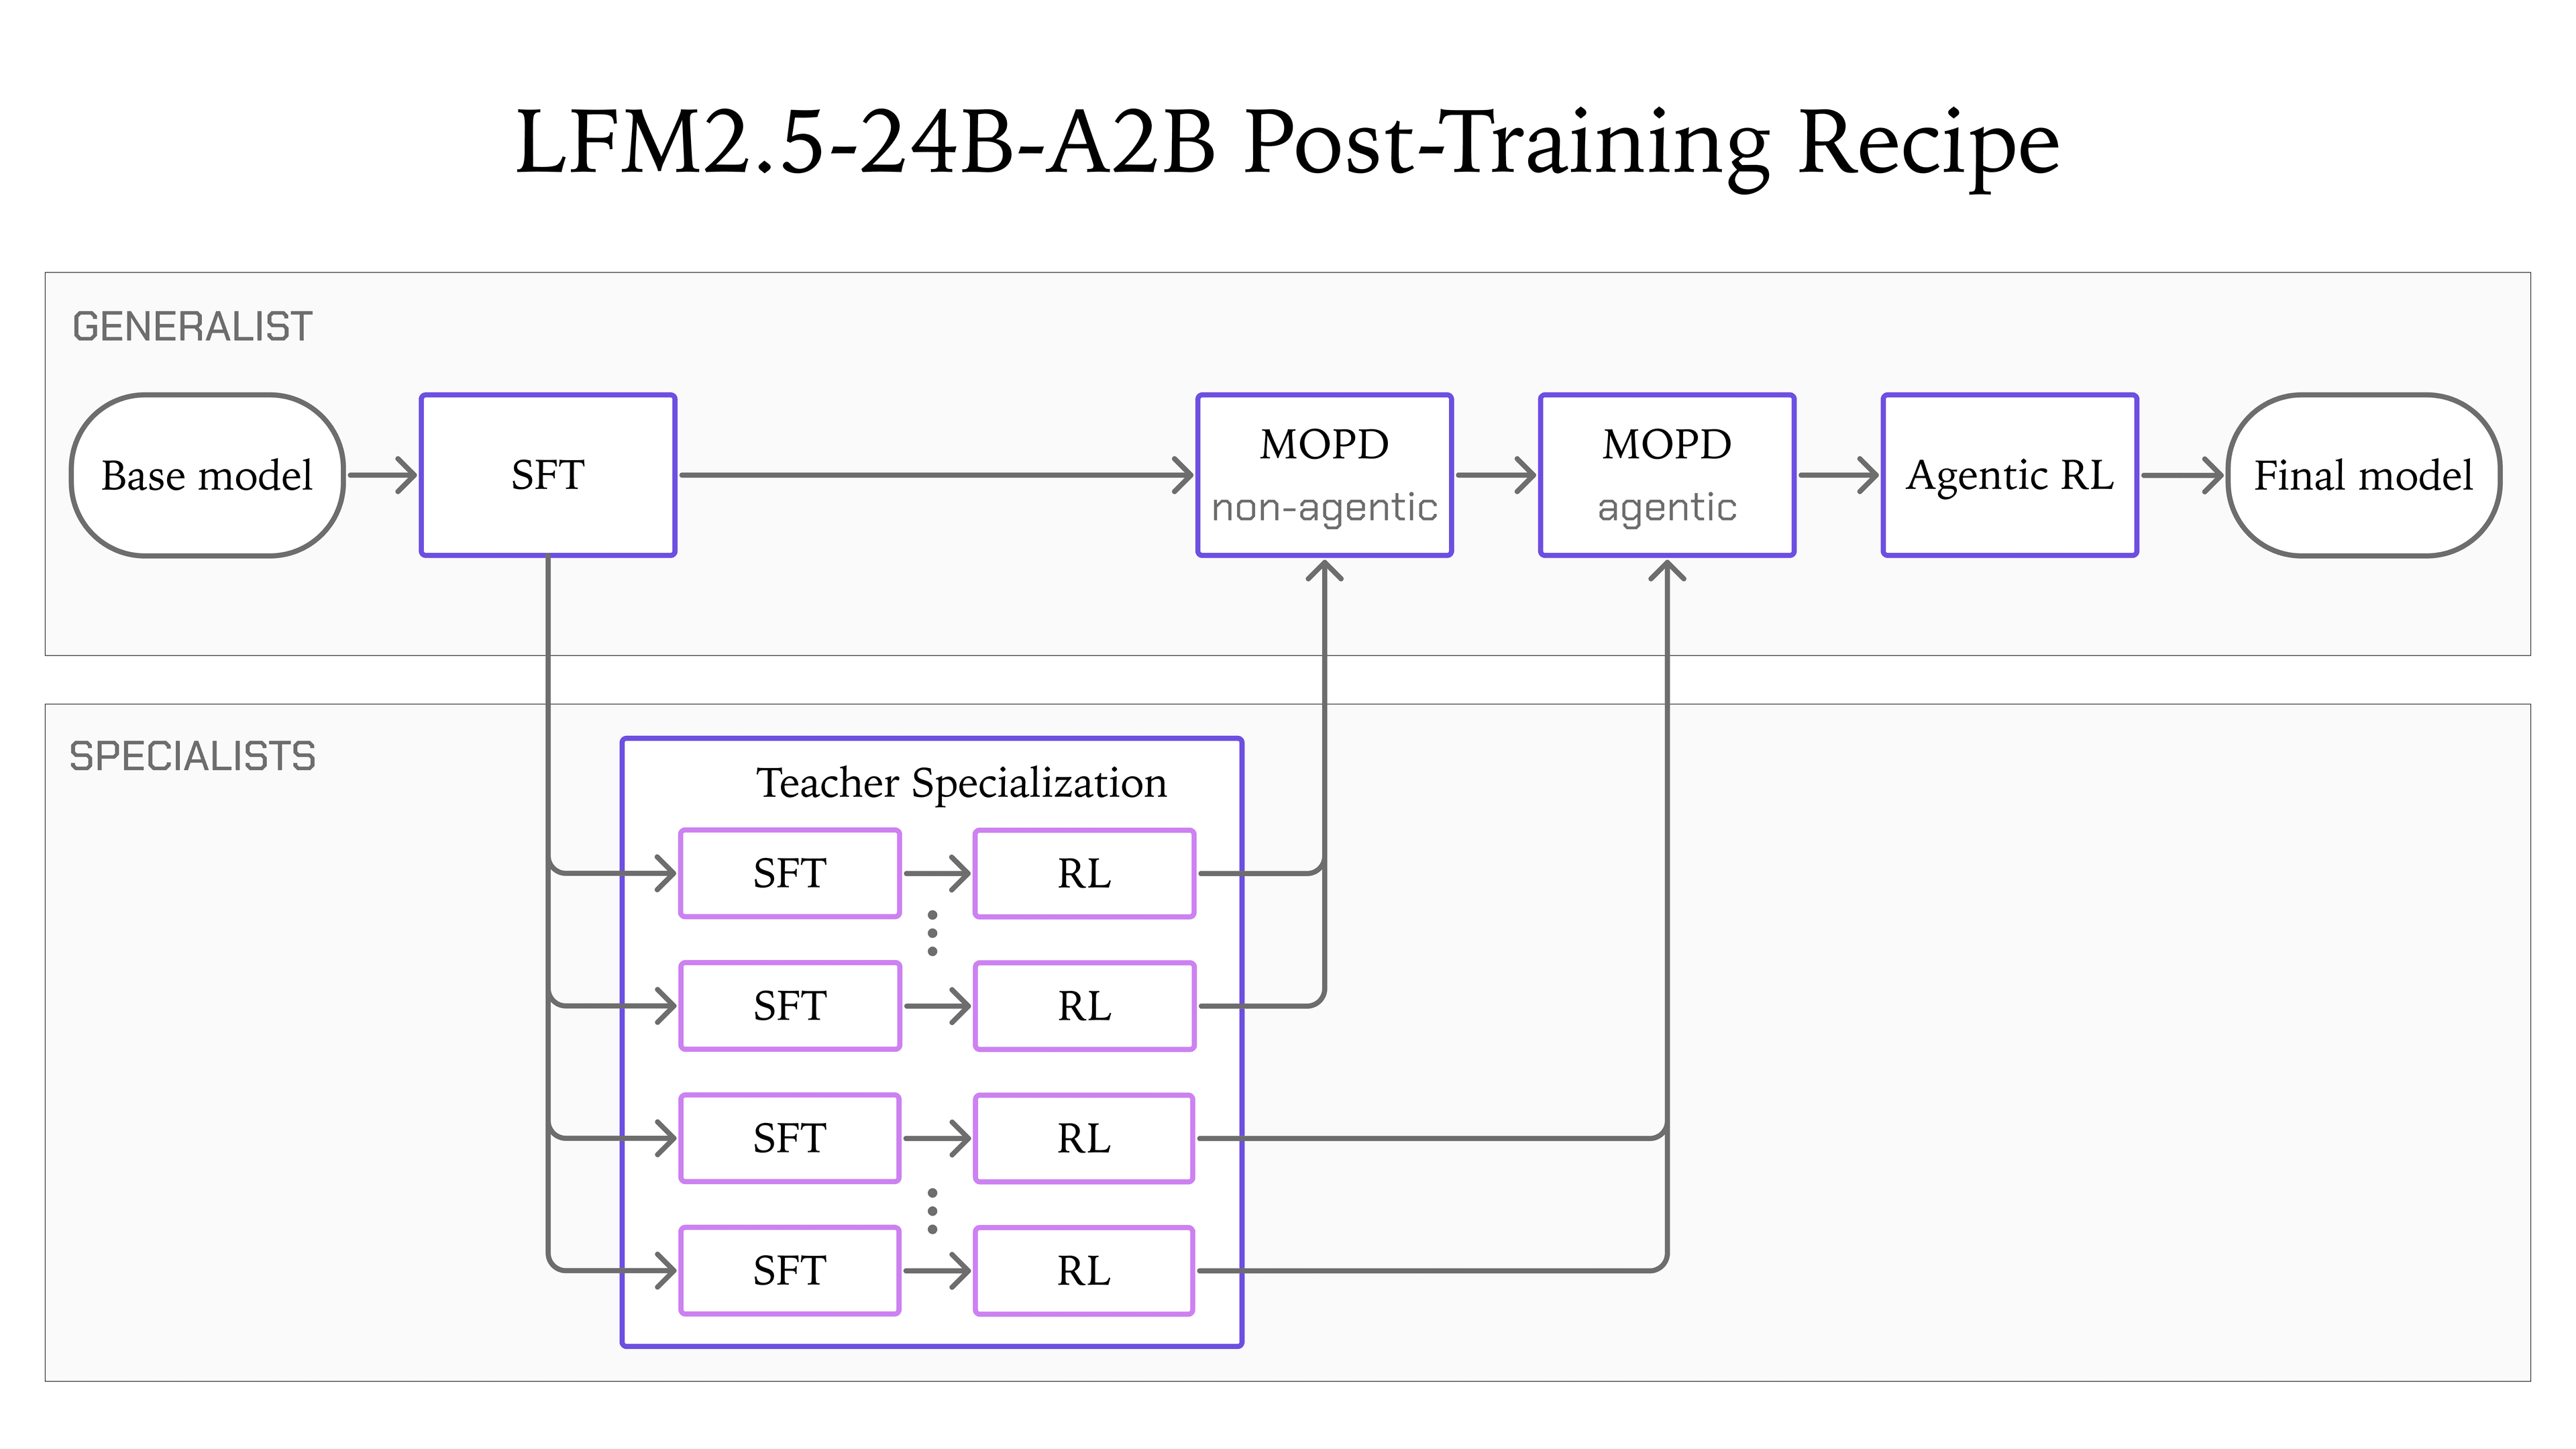
โมเดลนี้ผ่านการฝึกฝนแบบ Pre-training ที่ขยายขนาดข้อมูลจาก 17T เป็น 33T tokens และในช่วง Mid-training ได้เพิ่มข้อมูลเน้นการให้เหตุผล คณิตศาสตร์ โค้ด และการทำงานหลายภาษาอีก 2T tokens สำหรับส่วนการทำ Post-training ได้เปลี่ยนโมเดลฐานให้กลายเป็น agent ผ่าน 5 ขั้นตอนสำคัญ ได้แก่ Supervised fine-tuning (SFT), Teacher specialization, MOPD ทั้งในส่วน non-agentic และ agentic รวมถึงขั้นตอนสุดท้ายคือ Agentic Reinforcement Learning (Agentic RL) ภายในเฟรมเวิร์กอย่าง OpenClaw, Hermes Agent, Pi และ OpenCode
ผลการทดสอบ Benchmark
จากการประเมินผลเทียบกับคู่แข่งอย่าง Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it และ Nemotron-3.5-Lightning ใน 16 รายการทดสอบ พบว่า LFM2.5-24B-A2B เป็นโมเดลที่เล็กที่สุดในกลุ่มแต่มีประสิทธิภาพเทียบเท่าหรือเหนือกว่าโมเดลที่มีขนาดใหญ่กว่าถึง 50%
| Benchmark | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
จุดแข็งของโมเดลนี้คือการใช้เครื่องมือและการปฏิบัติตามคำสั่ง โดยทำคะแนนนำใน AutomationBench มากกว่าอันดับถัดไปถึง 3 เท่า อย่างไรก็ตาม โมเดลขนาดใหญ่อื่นๆ ยังคงได้เปรียบในงานที่เน้นฐานความรู้หนักๆ และการเขียนโค้ด จึงแนะนำให้ใช้ร่วมกับการดึงข้อมูล (retrieval) เพื่อประสิทธิภาพสูงสุด
ความเร็วในการประมวลผลบนอุปกรณ์
LFM2.5-24B-A2B รองรับระบบนิเวศการประมวลผลที่หลากหลาย เช่น llama.cpp, MLX, vLLM และ ONNX โดยในการทดสอบบน Edge inference พบว่าสามารถถอดรหัสได้เร็วถึง 184 tokens/s บน M5 Max และ 114 tokens/s บน Ryzen AI Max+ 395 ซึ่งเร็วกว่าคู่แข่งถึง 1.7 เท่า
สำหรับการใช้งานบน GPU โมเดลนี้สามารถทำความเร็วได้มากกว่า 21K output tokens ต่อวินาทีบน NVIDIA B300 เพียงตัวเดียวเมื่อใช้งานที่ระดับ concurrency สูง
วิธีเริ่มต้นใช้งาน LFM2.5-24B-A2B
ผู้ใช้สามารถติดตั้ง transformers เวอร์ชันล่าสุดเพื่อเริ่มต้นใช้งาน:
pip install -U transformersจากนั้นสามารถโหลดและรันโมเดลผ่านโค้ด Python ต่อไปนี้:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
นอกจากนี้ยังสามารถนำไปใช้ในเฟรมเวิร์ก agent เช่น Hermes Agent โดยตั้งค่าผ่านคำสั่ง bash ดังนี้:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
ผู้ที่สนใจสามารถดาวน์โหลดโมเดลทั้งเวอร์ชัน Base และ Chat ได้ที่ Hugging Face พร้อมดูรายละเอียดเพิ่มเติมใน model card และ คู่มือการรัน agent ของทางทีมงาน
การอ้างอิง
หากต้องการอ้างอิงผลงานนี้ในเชิงวิชาการ:
@article{liquidAI202624BA2B,
  author  = {Liquid AI},
  title   = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร