
Liquid AI เปิดตัว LFM2.5-Encoders ประมวลผล Long-Context เร็วกว่าเดิม 3.7 เท่าบน CPU
วันนี้เราประกาศเปิดตัวโมเดล encoder ใหม่ 2 รุ่นบน Hugging Face ได้แก่ LFM2.5-Encoder-230M และ LFM2.5-Encoder-350M ซึ่งให้ประสิทธิภาพการทำงานระดับสูงเทียบเท่าโมเดลขนาดใหญ่ แต่ยังคงความรวดเร็วแม้ในขณะประมวลผลข้อมูลที่มีความยาวมาก ช่วยให้คุณสามารถรันงานวิเคราะห์เอกสารบนฮาร์ดแวร์พื้นฐานอย่าง CPU ได้โดยไม่ต้องพึ่งพาทรัพยากรราคาแพง
จุดเด่นที่น่าสนใจของโมเดลรุ่นนี้ประกอบด้วย ประสิทธิภาพที่แข็งแกร่งเกินขนาดตัว โดยสามารถทำคะแนนทดสอบบน GLUE, SuperGLUE และงานด้านหลายภาษาได้เทียบเท่าหรือดีกว่า encoder ที่มีขนาดใหญ่กว่า อีกทั้งยังรองรับบริบทสูงสุดถึง 8,192-token โดยมีค่าความหน่วง (latency) เพิ่มขึ้นเพียงเล็กน้อยเมื่ออินพุตยาวขึ้น และที่สำคัญที่สุดคือความเร็วบน CPU ที่เร็วกว่า ModernBERT-base ถึง 3.7 เท่าในสถานการณ์ที่ต้องประมวลผลบริบทขนาดยาว
โมเดลเหล่านี้ได้รับการออกแบบมาเพื่อให้คุณนำไปสร้างเครื่องมือต่างๆ ได้อย่างคุ้มค่า เช่น intent routers, policy linters, PII detectors และ text classifiers ที่รันได้อย่างต่อเนื่องตลอดทั้งวันในงบประมาณที่ประหยัด โดยผู้ที่สนใจสามารถทดลองใช้งานเดโมสดได้ในลิงก์ด้านล่าง
ทำไมเราถึงสร้าง encoder อเนกประสงค์
หลังจากที่เราปล่อย LFM2.5-Retrievers ไปเมื่อเดือนก่อนเพื่อเน้นการค้นหาหลายภาษา LFM2.5-Encoders ถูกพัฒนาตามมาในตระกูลเดียวกันแต่ปรับให้ใช้งานได้กว้างขวางขึ้น โดยผ่านการโมเดลแบบ pre-trained ด้วยวัตถุประสงค์ masked-language ทำให้ผู้ใช้งานสามารถนำไป fine-tune ต่อเพื่อใช้ในงานจัดหมวดหมู่ (classification) งานระดับหน่วยคำ (token-level tasks) หรือการค้นหาข้อมูลได้ตามต้องการ
ในโลกของการใช้งานจริง Encoders เปรียบเหมือนขุมพลังหลังบ้านของแอปพลิเคชัน NLP มากมาย ไม่ว่าจะเป็นระบบตรวจจับความปลอดภัย (safety filters) หรือการคัดแยกประเภทข้อมูล ซึ่งงานเหล่านี้มักต้องรันตลอดเวลาและต้องรองรับข้อมูลที่ยาวขึ้นเรื่อยๆ แม้ว่า BERT และ ModernBERT จะทำมาตรฐานไว้ได้ดีมาก แต่ LFM2.5-Encoders ก้าวข้ามไปอีกขั้นด้วยสถาปัตยกรรม LFM2 ที่ช่วยคุมต้นทุนการประมวลผลให้เพิ่มขึ้นต่ำมากแม้ข้อมูลอินพุตจะยาวขึ้นก็ตาม
วิธีการสร้าง encoders
เราสร้าง encoders เหล่านี้โดยต่อยอดจากโครงสร้างหลัก LFM2 decoder ของรุ่น LFM2.5-230M และ LFM2.5-350M จากนั้นปรับเปลี่ยน causal decoder ให้กลายเป็น bidirectional encoder ด้วยเทคนิคสำคัญ 3 ประการคือ:
- Bidirectional attention mask: เพื่อให้แต่ละ token สามารถมองเห็นข้อมูลได้ทั้งสองด้าน (หน้า-หลัง)
- Non-causal short convolutions: ใช้การ pad แบบสมมาตรเพื่อให้แต่ละ token ผสมผสานกับข้อมูลข้างเคียงได้อย่างลื่นไหล
- Masked language modeling: สุ่มปิด (mask) ข้อมูล 30% ระหว่างการฝึกสอนเพื่อความแม่นยำ
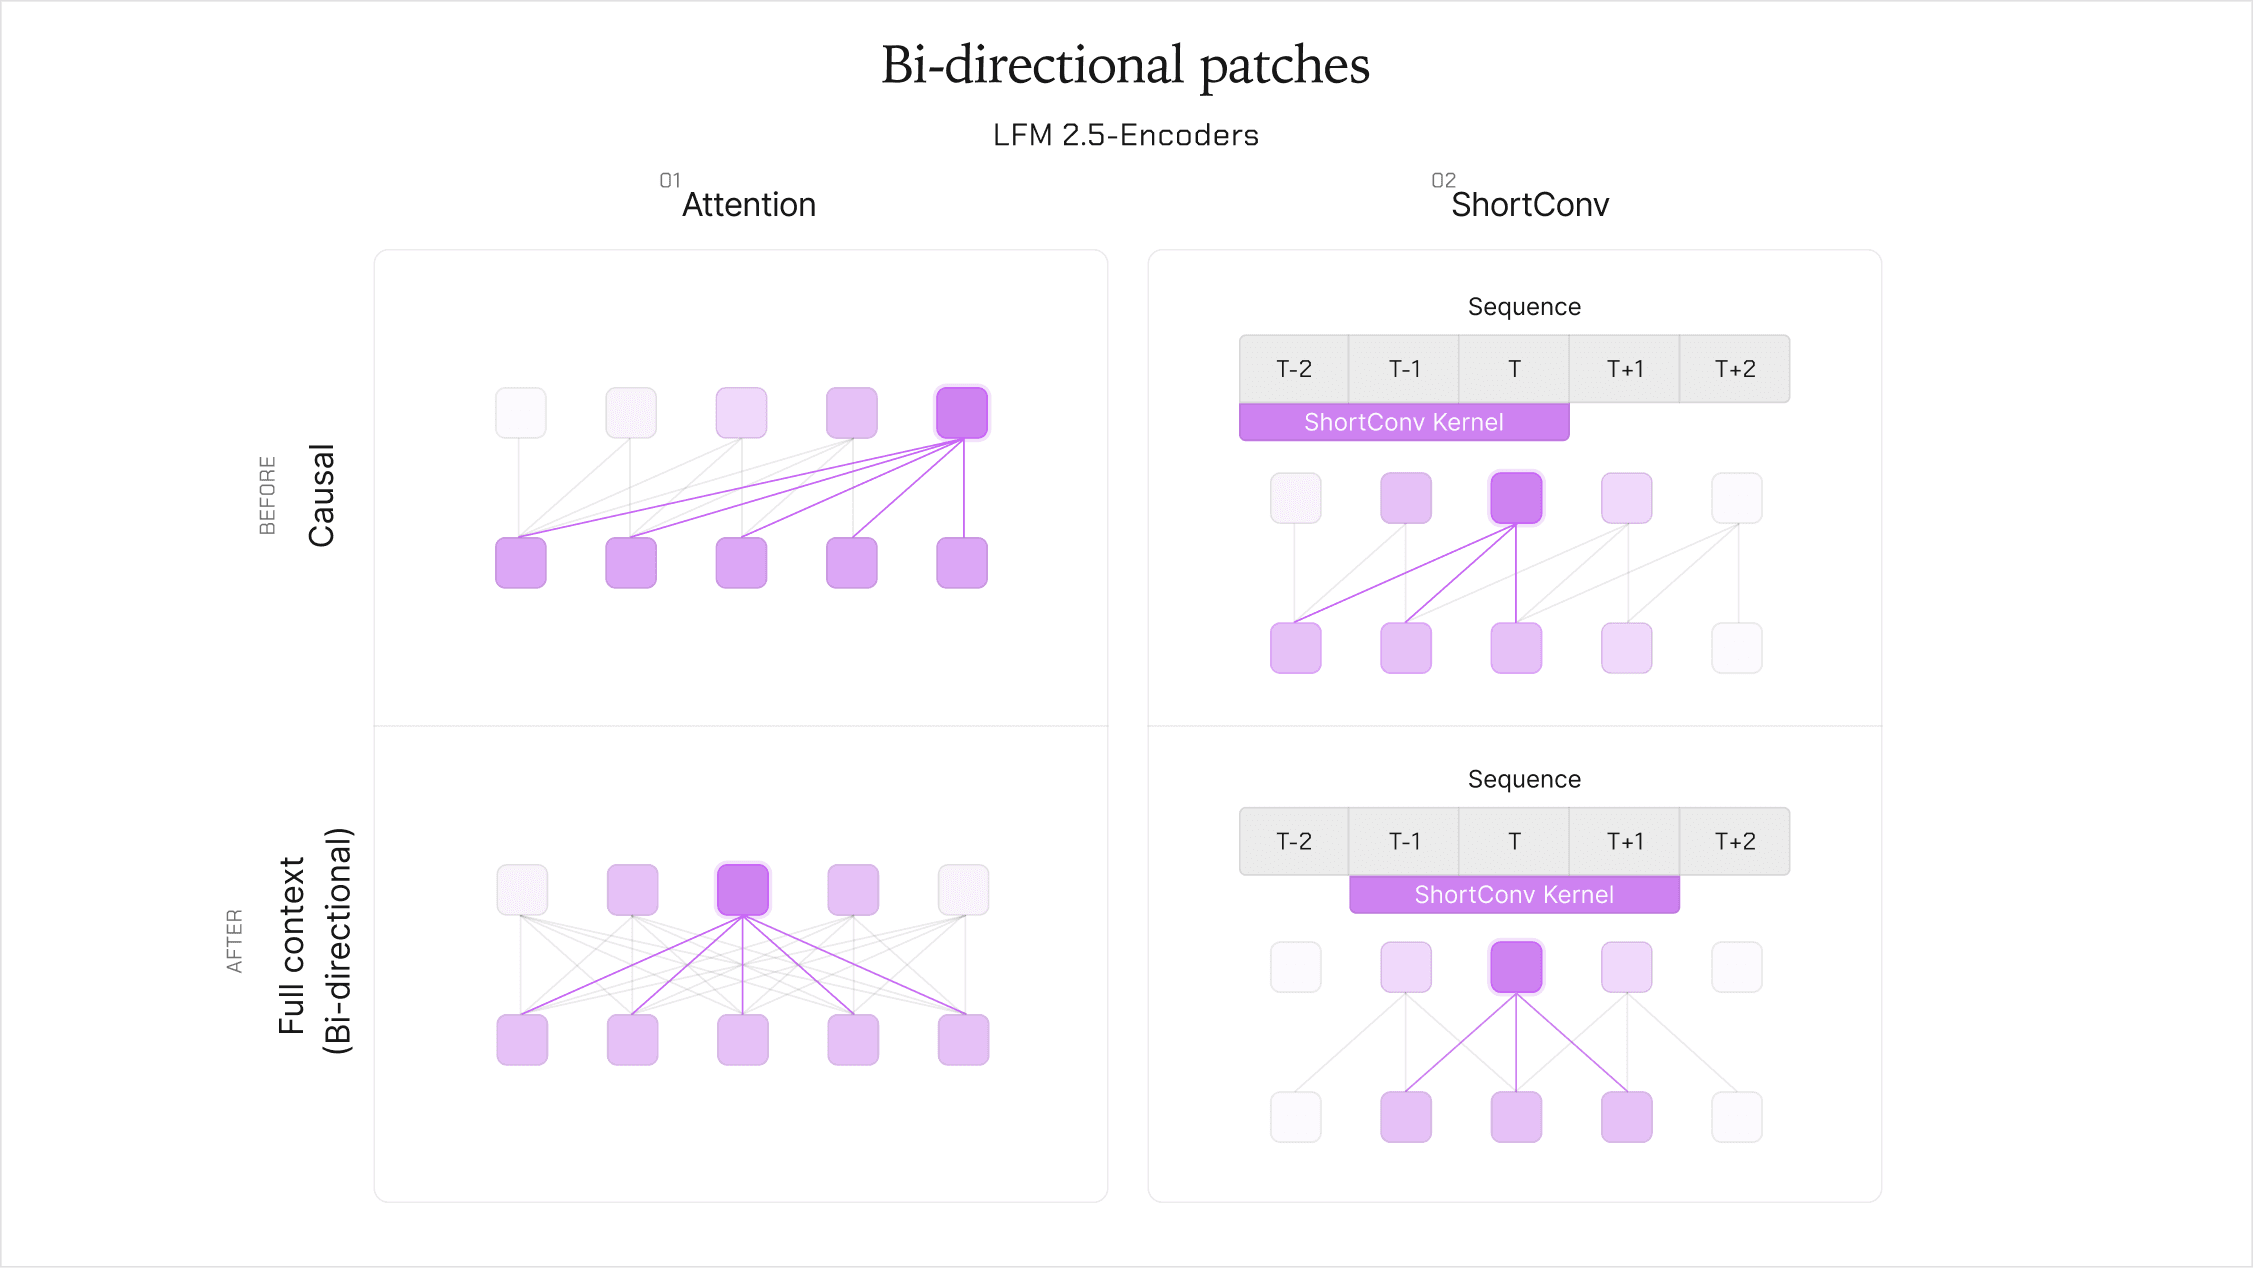
กระบวนการฝึกสอนถูกแบ่งเป็น 2 ขั้นตอน เริ่มจากการสร้างทักษะทางภาษาทั่วไปบนบริบท 1,024-token ด้วยข้อมูลเว็บจำนวนมหาศาล ตามด้วยระยะการปรับตัวกับบริบทขนาดยาว (Long-context adaptation) เพื่อขยายความจุเป็น 8,192 tokens เสริมสร้างความรู้เชิงลึกในด้านข้อเท็จจริง ภาษา และข้อบังคับทางกฎหมาย
ผลการทดสอบ Benchmark
เราได้ทำการ fine-tune โมเดลในงานต่างๆ และทดสอบกับ 14 โมเดลคู่แข่งผ่าน 17 ภารกิจสำคัญจาก GLUE, SuperGLUE และการจัดหมวดหมู่หลายภาษา โดยใช้ค่าเฉลี่ยจากการรัน 5 ครั้งเพื่อให้ได้ตัวเลขที่เชื่อถือได้มากที่สุด ซึ่งเราได้เผยแพร่ผลลัพธ์แบบ open-sourced ให้ทุกคนตรวจสอบได้ด้วย
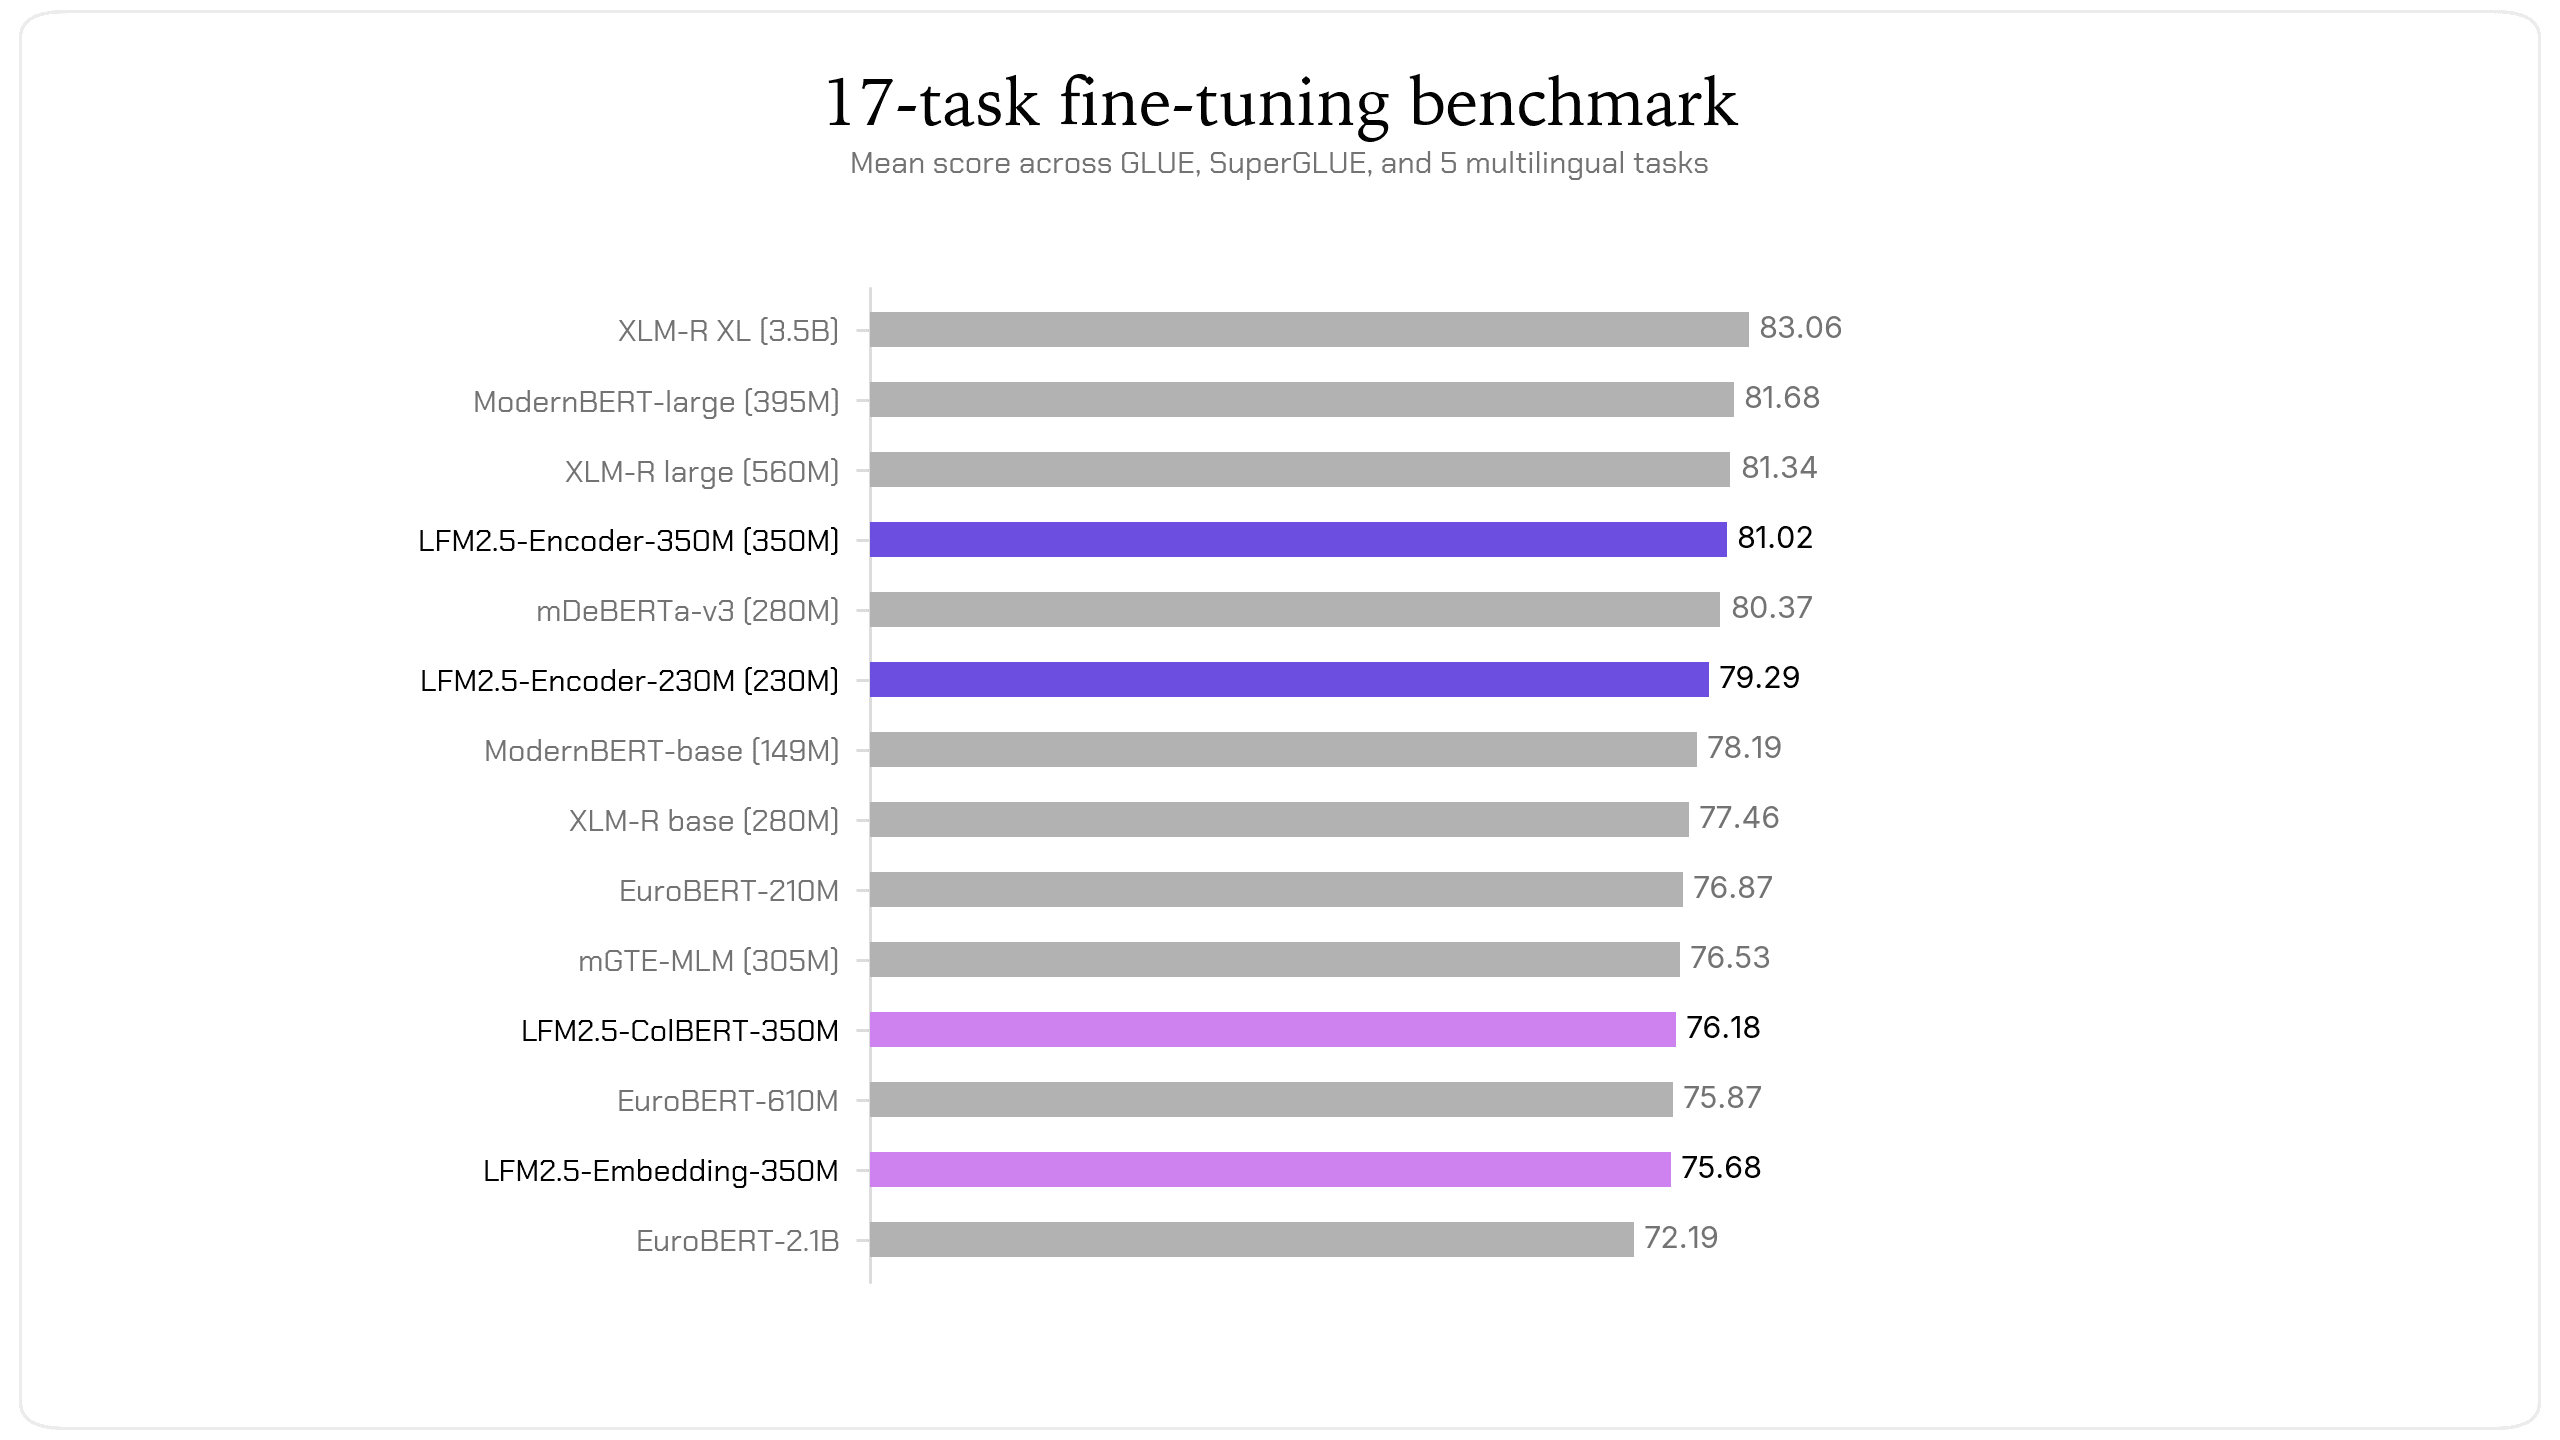
ผลการทดสอบพบว่า LFM2.5-Encoder-350M ติดอันดับที่ 4 จากทั้งหมด โดยเป็นรองเพียงโมเดลที่มีขนาดใหญ่กว่ามาก (บางรุ่นใหญ่กว่าเกือบ 10 เท่า) ขณะที่ LFM2.5-Encoder-230M สามารถทำคะแนนชนะ ModernBERT-base และ EuroBERT ทุกตัว แม้จะมีขนาดโมเดลที่เล็กกว่าก็ตาม
ความเร็วการประมวลผลบน CPU และ GPU
ด้วยมรดกความเร็วจากสถาปัตยกรรม LFM2 ทำให้ encoders ของเราทำงานได้รวดเร็วมาก เมื่อเปรียบเทียบในบริบท 8,192-token ความแตกต่างจะเห็นได้ชัดเจนที่สุดบน CPU
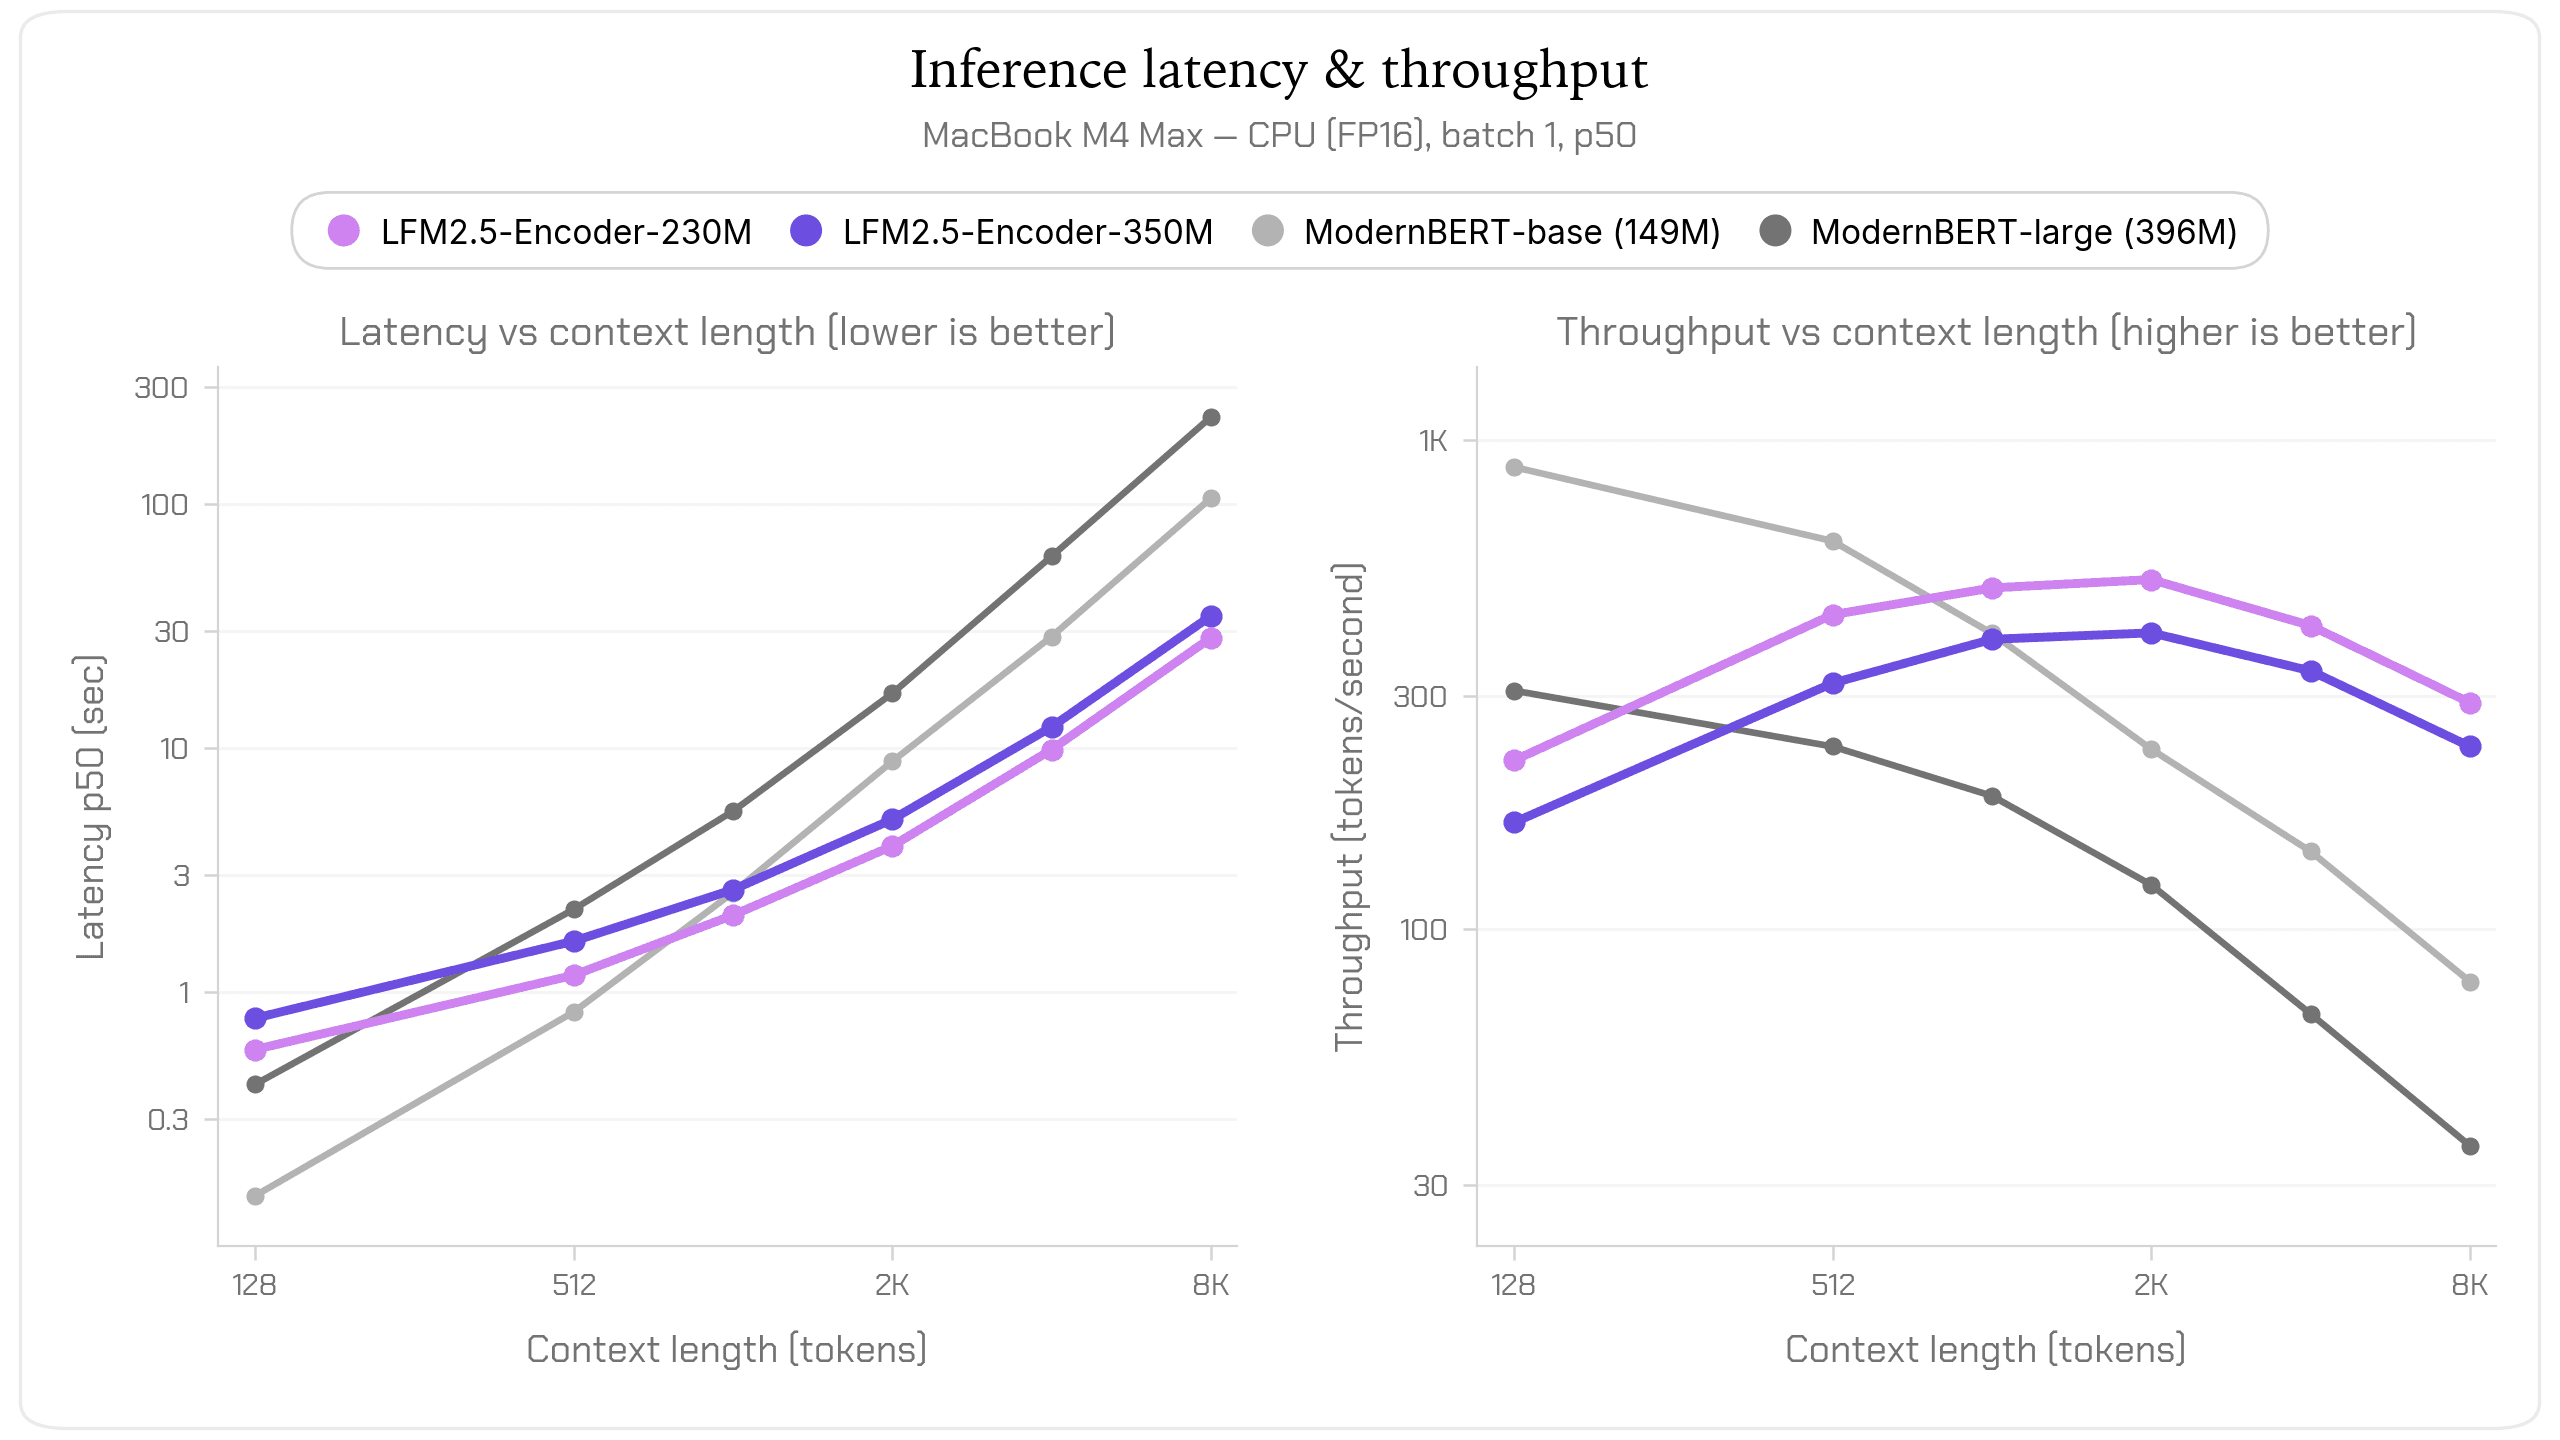
บนระบบ CPU รุ่น LFM2.5-Encoder-230M ทำความเร็วได้สูงสุดในทุกช่วงความยาวข้อมูล ขณะที่คู่แข่งอย่าง ModernBERT จะมีความเร็ว (throughput) ลดลงอย่างมากเมื่อเจอข้อมูลยาวขึ้น ที่ความยาวปลายทาง 8,192 tokens ModernBERT-base ต้องใช้เวลาประมวลผลเฉลี่ยถึง 90 วินาทีต่อรอบ แต่ LFM2.5-Encoder-230M ใช้เวลาเพียง 28 วินาที ซึ่งเร็วกว่าราว 3.7 เท่า ช่วยให้นักพัฒนาสามารถวิเคราะห์สัญญาฉบับยาวหรือบทสนทนาจำนวนมากได้ในเวลาไม่ถึงครึ่งนาทีบนแล็ปท็อปทั่วไป
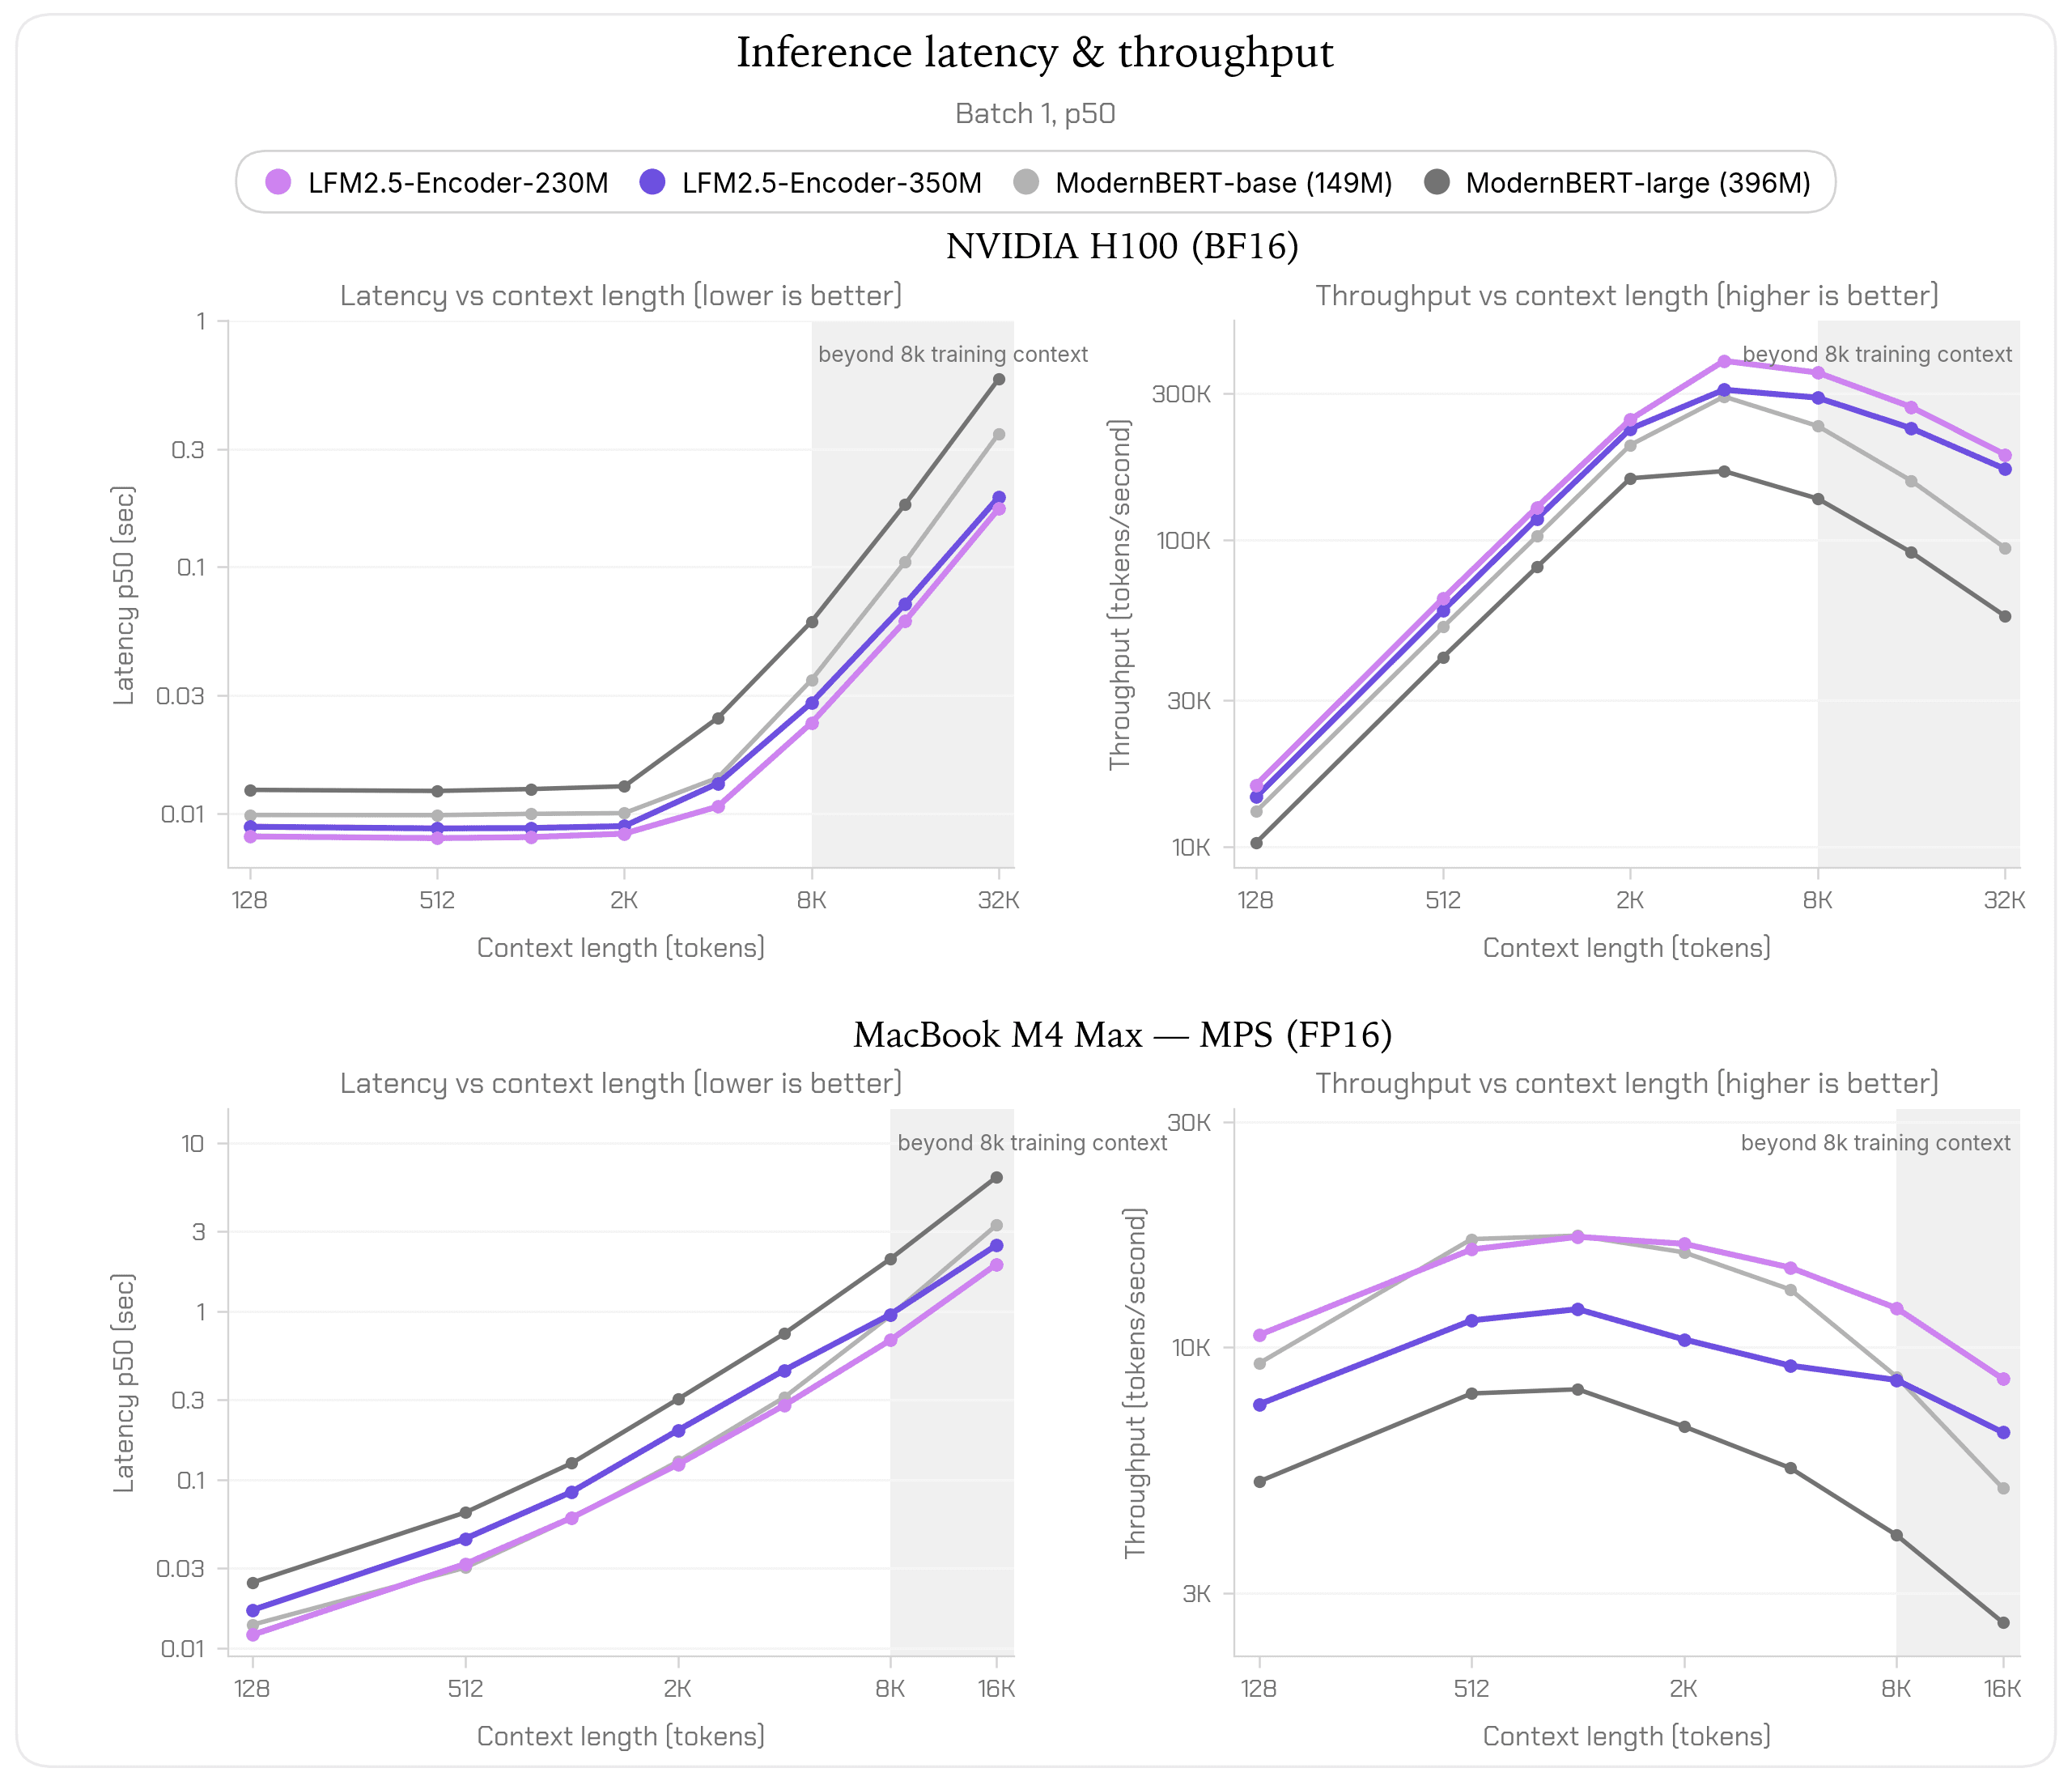
สำหรับบน GPU แม้ส่วนต่างความเร็วจะแคบลง แต่ LFM2.5-Encoders ยังคงได้เปรียบในงานที่มีอินพุตตั้งแต่ 2K tokens ขึ้นไป โดยสรุปคือหากคุณรันงานบน CPU โมเดลของเราจะมอบความเร็วที่ทิ้งห่างอย่างมหาศาล และยังเป็นตัวเลือกที่เหนือกว่าสำหรับงานอินพุตยาวบน GPU อีกด้วย
เดโมของ LFM2.5-Encoder
เราจัดเตรียมเดโมที่รันบน Hugging Face space (CPU Only) ให้คุณได้ทดลองประสิทธิภาพจริง:
- Zero-shot prompt routing: ระบบกำหนดเส้นทางคำสั่งแบบอัตโนมัติ
- Zero-shot policy linting: ตรวจสอบความสอดคล้องของนโยบายองค์กร
- Spell checking: แก้ไขคำสะกดผิดราย token
- PII detection: ตรวจจับข้อมูลส่วนบุคคล 40 ประเภทใน 16 ภาษา
- Masked-diffusion text generation: โหมดสร้างข้อความผ่านการเปิด mask ซ้ำๆ
วิธีใช้และ fine-tune LFM2.5-Encoders
หากคุณต้องการโมเดลที่ทำงานได้เร็ว ต้นทุนต่ำ และรองรับการประมวลผลข้อมูลปริมาณมากบน CPU ที่มีอยู่ LFM2.5-Encoders คือคำตอบที่คุ้มค่ากว่า generative LLM ขนาดใหญ่ โดยคุณสามารถเลือกใช้ได้ 2 รุ่นตามความเหมาะสม:
- LFM2.5-Encoder-350M: สำหรับงานที่ต้องการความแม่นยำสูงสุด
- LFM2.5-Encoder-230M: สำหรับงานที่เน้นความเร็วสูงสุดหรือมีทรัพยากรจำกัด
เริ่มต้นใช้งาน
ติดตั้งไลบรารี transformers เวอร์ชันล่าสุดได้ทาง:
pip install -U transformersและนี่คือตัวอย่างการรันการทำนาย masked-token:
from transformers import AutoModelForMaskedLM, AutoTokenizer
import torch

model_id = "LiquidAI/LFM2.5-Encoder-230M"  # หรือ "LiquidAI/LFM2.5-Encoder-350M"
tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
mlm = AutoModelForMaskedLM.from_pretrained(model_id, trust_remote_code=True)

text = f"The capital of France is {tok.mask_token}."
enc = tok(text, return_tensors="pt")
with torch.no_grad():
    logits = mlm(**enc).logits
pos = (enc["input_ids"][0] == tok.mask_token_id).nonzero()[0].item()
print([tok.decode([t]).strip() for t in logits[0, pos].topk(5).indices.tolist()])
# -> ['Paris', 'Strasbourg', 'Paris', 'Lyon', 'Versailles']
สำหรับการใช้งานในระดับโครงสร้างโมเดล:
from transformers import AutoModel

body = AutoModel.from_pretrained(model_id, trust_remote_code=True)
สำหรับผู้ใช้ GPU แนะนำให้ติดตั้ง flash-attn เพื่อประสิทธิภาพสูงสุด
การ Fine-tuning เนื่องจากโมเดลหลักเป็น base encoder คุณจึงจำเป็นต้อง fine-tune เพื่อให้เหมาะกับงานเฉพาะทางของคุณ โดยสามารถศึกษาขั้นตอนการทำได้จาก บทเรียนการ fine-tuning ที่มีการสอนจัดการเอกสารกฎหมายความยาว 8k ไว้ให้แล้ว
เริ่มต้นกับ LFM2.5-Encoders ได้เลย
โมเดลทั้งสองพร้อมให้ดาวน์โหลดแบบ open-weight แล้ววันนี้:
- ดาวน์โหลด: LFM2.5-Encoder-230M และ LFM2.5-Encoder-350M
- ทดลองใช้: ผ่านเดโมบนเบราว์เซอร์ได้ทันที
- ปรับแต่ง: ศึกษา คู่มือ fine-tuning เพื่อปรับใช้กับงานของคุณ
การอ้างอิง
หากท่านนำผลงานนี้ไปใช้ โปรดระบุแหล่งที่มาดังนี้:
@article{liquidAI2026Encoders,
  author = {Liquid AI},
  title = {LFM2.5-Encoders: Fast at Long Context, Even on CPU},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2-5-encoders},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร