
Stanford เปิดตัว TokenGate เร่งความเร็ว Prefill ใน LLM สูงสุด 11.3 เท่า
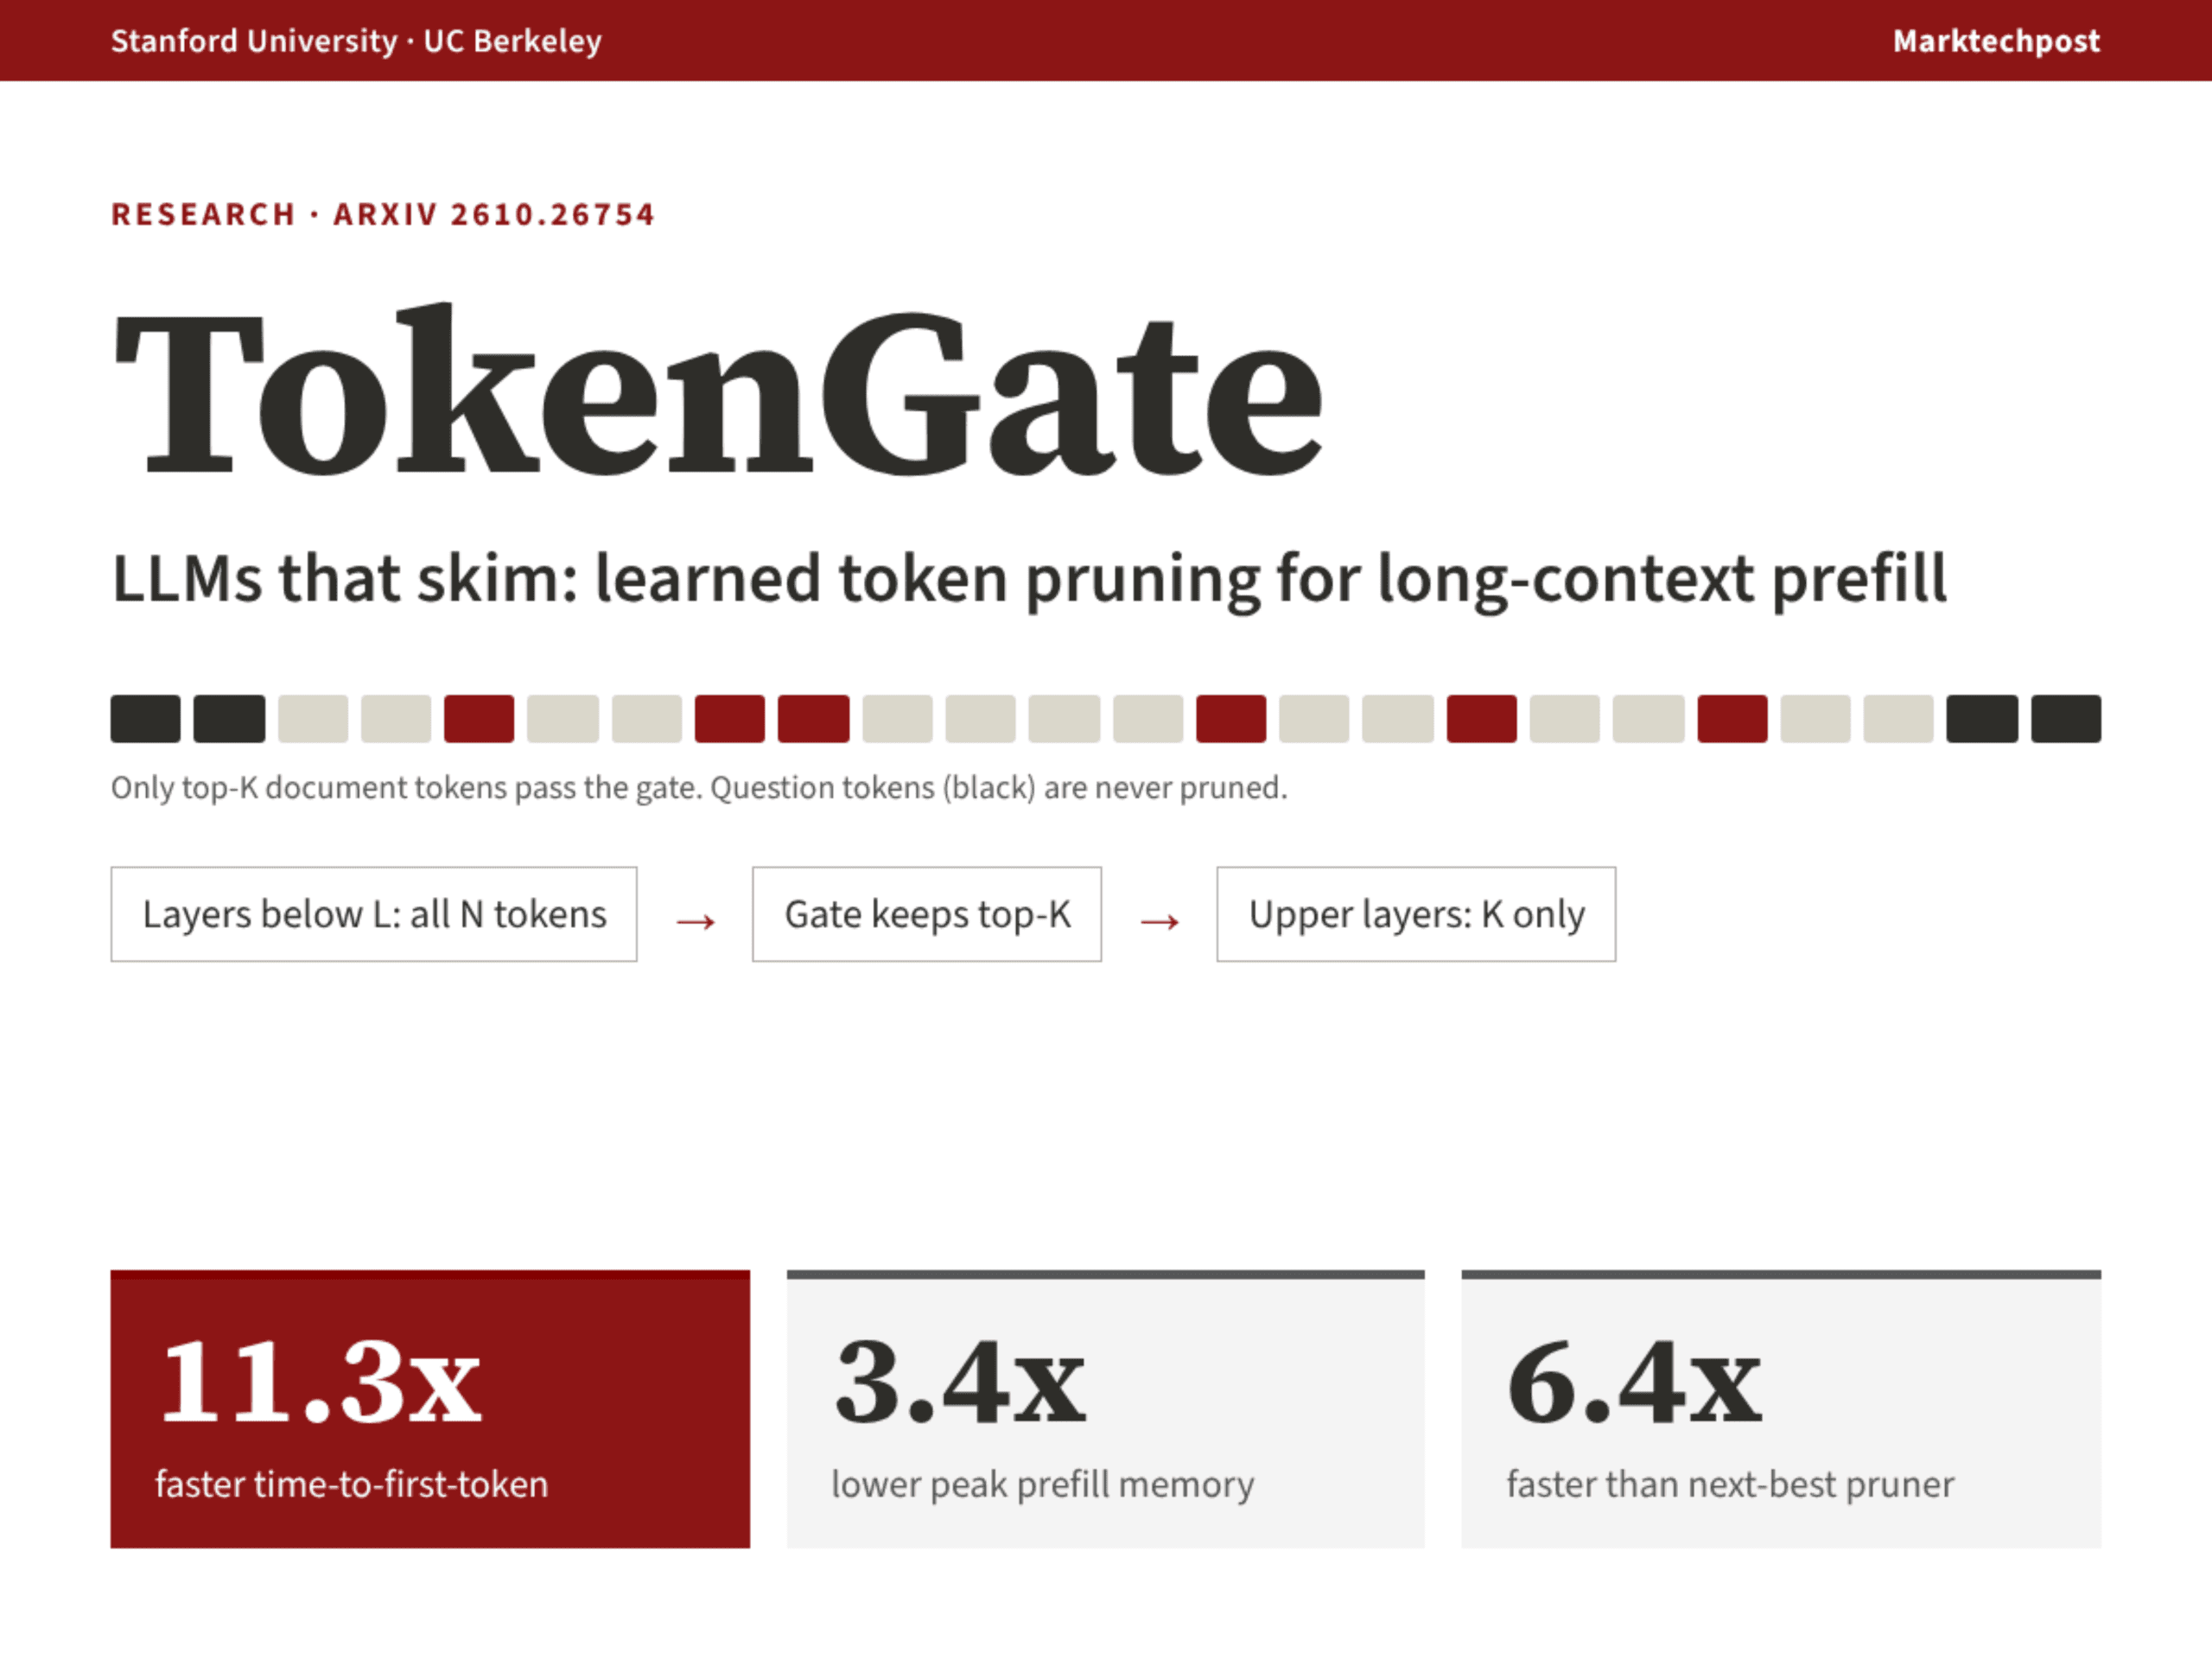
นักวิจัยจาก Stanford และ UC Berkeley เปิดตัว TokenGate โมดูลเสริมสำหรับประมวลผลบริบทขนาดยาว (long-context prefill) ที่ใช้การตัดโทเคน (token pruning) แบบเรียนรู้ได้ ระบบนี้ช่วยให้ LLM สามารถกวาดสายตาอ่านข้อมูลนำเข้าและเลือกประมวลผลเฉพาะโทเคนที่มีความสำคัญเท่านั้น
จากการทดสอบพบว่า TokenGate ช่วยให้ระยะเวลาเริ่มสร้างโทเคนแรก (time-to-first-token หรือ TTFT) เร็วขึ้น 1.4 ถึง 11.3 เท่า โดยความแม่นยำไม่ลดลง พร้อมทั้งลดการใช้หน่วยความจำในช่วง prefill ได้ 1.5 ถึง 3.4 เท่า ปัจจุบันทีมวิจัยได้เผยแพร่โค้ดและ checkpoint บน GitHub ภายใต้สัญญาอนุญาต Apache-2.0 เรียบร้อยแล้ว
สรุปประเด็นสำคัญ
- MLP gate: ติดตั้ง MLP gate ขนาดเล็กพร้อม LoRA (r=16) ในโมเดล Qwen3-1.7B และ Qwen3.5-2B รองรับบริบทสูงสุด 128k โทเคน
- ประสิทธิภาพ: รันบน A100 (batch size 1) ให้ผลลัพธ์ระดับ Pareto-optimal ใน 5 งานทดสอบเมื่อเทียบกับ 6 ผลงานอ้างอิง
- ความเร็วสูงสุด: ในงาน NIAH 16k ทำ TTFT เร็วขึ้น 11.3 เท่า และประหยัดหน่วยความจำ 3.42 เท่า โดยความเร็วพุ่งสูงถึง 13.0 เท่าที่ระยะ 128k
- ความเร็วต่ำสุด: ในบางงานทดสอบ การเร่งความเร็วจะอยู่ที่ระดับ 1.4 เท่า
TokenGate คืออะไร?
TokenGate เป็นส่วนประกอบแบบ drop-in ที่เพิ่มฟีเจอร์การตัดโทเคนแบบฝึกฝนได้ให้กับ LLM ที่ผ่านการ pre-train มาแล้ว ต่างจากโครงสร้าง Transformers ปกติที่ต้องประมวลผลทุกโทเคนผ่านทุกชั้น ทำให้ค่าใช้จ่ายด้าน attention เพิ่มขึ้นเป็นทวีคูณตามความยาว แม้การตัดโทเคนแบบไม่ต้องฝึกฝน (Training-free pruning) จะมีราคาถูก แต่ก็มักแลกมาด้วยความแม่นยำที่ลดลงหากตัดข้อมูลทิ้งมากเกินไป
กลไกการทำงานของ Learned Token Pruning
การประมวลผลแบ่งออกเป็น 3 ระยะหลัก ได้แก่:
- Standard forward: เลเยอร์ที่อยู่ต่ำกว่า gate จะประมวลผลโทเคนทั้งหมดตามปกติ
- Gate module: MLP จะให้คะแนนความสำคัญของโทเคน แล้วเลือกเฉพาะกลุ่ม Top-K ที่ได้คะแนนสูงสุดไว้
- Pruned forward: เลเยอร์ระดับบนจะประมวลผลเฉพาะโทเคนที่ถูกเลือก ทำให้ไม่ต้องสร้างค่า KV สำหรับข้อมูลที่ถูกตัดทิ้ง ทั้งนี้ ระบบจะตัดเฉพาะส่วนที่เป็นเนื้อหาเอกสารเท่านั้น โดยจะไม่ตัดโทเคนในส่วนของคำถาม (query) ออกเด็ดขาด
เทคโนโลยี Token-gated attention เนื่องจากการเลือก Top-K ปกติไม่สามารถหาอนุพันธ์ได้ ทีมวิจัยจึงนำเทคนิค router จากโครงสร้าง Mixture-of-Experts มาใช้ โดยคะแนนของโทเคนที่ถูกเก็บไว้จะกลายเป็นค่า bias บน attention logits ซึ่งช่วยให้ gradient สามารถส่งกลับไปยังตัวให้คะแนน (scorer) เพื่อการฝึกฝนได้
นอกจากนี้ยังมีการใช้ค่า gain ต่อ head และ temperature ที่เรียนรู้ได้มาช่วยปรับแต่งกรณีที่ query มองเห็น key น้อยลง การฝึกฝนจะใช้ next-token loss ตามปกติ โดย gate ที่ผ่านการฝึกแล้วเพียงตัวเดียวสามารถรองรับงบประมาณการประมวลผล (budgets) ได้หลายระดับ
ผลการทดสอบประสิทธิภาพ
ทีมวิจัยทดสอบ Qwen3-1.7B บนชุดทดสอบหลากหลาย เช่น RepoBench-P และ needle-in-a-haystack (NIAH) โดยมีผลลัพธ์ที่น่าสนใจดังนี้:
- เทียบกับ full prefill: TTFT เร็วขึ้นสูงสุด 11.3 เท่า และลดการใช้หน่วยความจำสูงสุด 3.4 เท่า
- เทียบกับ baseline อื่นๆ: ทำความเร็วได้ดีกว่าคู่แข่งอันดับรองลงมาถึง 1.2 ถึง 6.4 เท่า
- บริบทที่ยาวขึ้น: Gate ที่ฝึกบนข้อมูล 16k สามารถรักษาความเร็วที่ 12.8 ถึง 13.0 เท่า เมื่อขยายบริบทไปถึง 32k - 128k
การใช้งานกับโมเดล hybrid-attention
TokenGate สามารถทำงานร่วมกับ Qwen3.5-2B ที่ผสมผสาน Gated DeltaNet และ full-attention ได้อย่างมีประสิทธิภาพ โดยในชั้นเลเยอร์ 3 ของ NIAH 32k ระบบรันเร็วขึ้น 3.8 เท่าเทียบกับ full prefill และชนะ FastKV 2.1 เท่า เนื่องจาก FastKV ไม่สามารถตัดโทเคนในชั้น DeltaNet ได้
การติดตั้งและใช้งาน
โปรเจกต์นี้ต้องการ Python 3.10+ และ CUDA PyTorch 2.9+ โดยแนะนำให้ใช้ FlashAttention-2 key-bias kernel เพื่อประสิทธิภาพสูงสุด หากไม่มีจะสลับไปใช้ FlexAttention แทน การฝึกฝนทำได้ในรูปแบบเดียวกับ TRL/PEFT โดยใช้เวลาเฉลี่ยบน A100 ประมาณ 1.8 ชั่วโมง ซึ่งเร็วกว่าการฝึก LoRA ปกติในหลายงานทดสอบ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร