
ผู้ร่วมก่อตั้ง Anthropic คาด AI พัฒนาตัวเองได้ในปี 2027
เกณฑ์มาตรฐานใหม่ที่ชื่อว่า TasteVal วัดความสามารถของระบบ AI ในการออกแบบการทดลองด้วยตนเองและแปลผลลัพธ์ที่ได้ สิ่งที่พบคือเส้นกราฟการพัฒนาที่สูงชันอย่างผิดปกติ
ความสามารถดังกล่าวเพิ่มขึ้นประมาณสองเท่าในทุกๆ สามเดือนนับตั้งแต่เดือนธันวาคม 2025 ตามข้อมูลจาก Jack Clark ผู้ร่วมก่อตั้ง Anthropic โดยห้องปฏิบัติการวิจัย P-Zero Research เรียกสิ่งนี้ว่า "research taste" ซึ่งหมายถึงความสามารถในการเลือกการทดลองที่เหมาะสมและสรุปผลที่ถูกต้องจากสิ่งเหล่านั้น โดยโมเดลที่ดีที่สุดทำผลงานได้เหนือกว่าผู้เชี่ยวชาญที่เป็นมนุษย์ 24 คน ด้วยค่าใช้จ่ายเพียงเสี้ยวเดียว
Clark ผู้ร่วมก่อตั้ง Anthropic และผู้เขียน Import AI newsletter ระบุว่าจากตัวเลขเหล่านี้ เขาเชื่อว่า recursive self-improvement (RSI) หรือการที่ระบบ AI พัฒนาทายาทรุ่นต่อๆ ไปด้วยตนเอง อาจเป็นไปได้เร็วที่สุดในปี 2027 จากเดิมที่เคยคาดการณ์ไว้ว่าเป็นปี 2028
แม้เกณฑ์มาตรฐานนี้จะยังไม่ได้พิสูจน์ว่าระบบ AI กำลังพัฒนาตัวเองอยู่ในขณะนี้ เนื่องจากครอบคลุมเพียงส่วนแคบๆ ของงานวิจัยทางวิทยาศาสตร์ แต่มันแสดงให้เห็นถึงทิศทางการถกเถียงที่เปลี่ยนจากประสิทธิภาพดิบของโมเดล ไปสู่คำถามที่ว่าโมเดลภาษาจะสามารถรับงานวิจัยที่เป็นอิสระได้มากเพียงใด
TasteVal วัดเพียงส่วนหนึ่งของภาพรวมเท่านั้น
P-Zero Research นิยาม research taste ว่าประกอบด้วยสามความสามารถ คือ การระบุคำถามวิจัยที่คุ้มค่า การออกแบบการทดลอง และการแปลผลลัพธ์อย่างถูกต้อง ทว่า TasteVal ทดสอบเพียงสองอย่างหลังเท่านั้น โดยการตัดสินใจเลือกทิศทางวิจัยซึ่งเป็นแกนหลักของสัญชาตญาณทางวิทยาศาสตร์ได้ถูกกำหนดไว้ให้โมเดลเรียบร้อยแล้ว
แต่ละภารกิจจากทั้งหมด 8 รายการจะระบุเป้าหมายการวิจัยที่แน่นอนจากการพัฒนาโมเดล AI พร้อมคะแนนวัดผลที่ชัดเจน ครอบคลุมด้านการเลือกข้อมูลฝึกฝน (training data), การ pretraining และ fine-tuning โมเดลภาษา, การฝึกตามความชอบของมนุษย์ (human preferences) ไปจนถึงการป้องกัน adversarial prompts
โมเดลจะเป็นผู้ตัดสินใจเลือกการทดลองและใช้ผลลัพธ์กำหนดขั้นตอนถัดไป โดยมีการใช้ coding agent ที่กำหนดไว้ตายตัวเพื่อรันการทดลองบน GPU Nvidia H100 ตัวเดียว เพื่อไม่ให้ทักษะการเขียนโค้ดทำให้ผลลัพธ์คลาดเคลื่อน การรันแต่ละครั้งจะสิ้นสุดลงเมื่อใช้การประมวลผลครบ 40 GPU-hours หรือ 120 ชั่วโมงตามเวลาจริง
สำหรับเกณฑ์มาตรฐานจากมนุษย์มาจากผู้เชี่ยวชาญ 24 คนที่เคยร่วมงานกับ OpenAI, Google DeepMind, Nvidia และ Microsoft Research โดยพวกเขาจัดการกับภารกิจเดียวกัน และจะใช้ผลงานที่ดีที่สุดของมนุษย์ต่อหนึ่งภารกิจมาเป็นบรรทัดฐานในการเปรียบเทียบ
การวัด Research taste ผ่านประสิทธิภาพการประมวลผล เพื่อให้สามารถวัดปริมาณ research taste ได้ P-Zero Research จึงเปลี่ยนหน่วยเป็นประสิทธิภาพการประมวลผล (compute efficiency) เนื่องจากทรัพยากรประมวลผลในการวิจัย AI มีจำกัด การเลือกการทดลองที่ถูกต้องจึงหมายถึงการสร้างความก้าวหน้าได้มากขึ้นภายใต้งบประมาณเดิม
ห้องปฏิบัติการอ้างอิงถึง "AI Futures Model" ที่คาดการณ์ว่า compute จะกลายเป็นคอขวดสำคัญเมื่อ coding is automated ดังนั้น TasteVal จึงวัดว่าโมเดลต้องการ compute มากน้อยเพียงใดเพื่อให้ได้คะแนนเท่ากับผู้เชี่ยวชาญ หากใช้เพียงครึ่งเดียวจะถือว่ามี research taste เป็นสองเท่าตาม definition นี้ ซึ่งเรียกว่า compute multiplier
โมเดลระดับท็อปอย่าง Opus 5.5 ของ Anthropic ทำค่า compute multiplier ได้ที่ 2.3 ซึ่งทำคะแนนระดับผู้เชี่ยวชาญโดยใช้ compute น้อยกว่าครึ่งหนึ่ง อย่างไรก็ตาม ช่วงทางสถิติมีความผันผวนอยู่ที่ 1.15 ถึง 4.37 และการรันหนึ่งครั้งมีค่าใช้จ่ายเพียงประมาณ 1 ใน 30 ของค่าเฉลี่ยที่ผู้เชี่ยวชาญใช้
เมื่อพิจารณาจากโมเดลหลายเจเนอเรชัน พบว่าค่า compute multiplier เพิ่มขึ้นประมาณสองเท่าในทุกๆ สามเดือนนับตั้งแต่ธันวาคม 2025 แม้จะยังมีความไม่แน่นอนสูงโดยมีระยะเวลาการเพิ่มขึ้นตั้งแต่ 1.7 ถึง 5.0 เดือนตามรายงาน
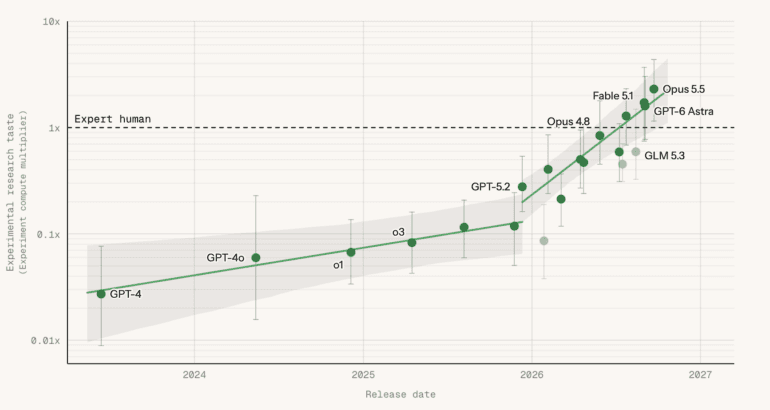
อย่างไรก็ตาม ในปีก่อนๆ research taste ของโมเดลเติบโตช้ากว่านี้มากและเพิ่งมาเร่งตัวในช่วงรอยต่อปี 2025-2026 ซึ่งยังไม่สามารถสรุปได้ว่าเป็นแนวโน้มที่ยั่งยืนหรือไม่ โดยผู้เขียนยอมรับว่าผลลัพธ์อาจประเมินความเร็วสูงเกินไป เนื่องจากภารกิจเหล่านี้ตรวจสอบได้ง่ายและกลุ่มเปรียบเทียบยังไม่ได้รวมนักวิจัยระดับแนวหน้าไว้
Clark เลื่อนระยะเวลาของเขาให้เร็วขึ้น
Clark เชื่อว่าความคิดสร้างสรรค์คือปัจจัยสำคัญที่ระบุความเร็วในการพัฒนาตัวเองของ AI แม้ช่วงต้นปีเขาจะระบุว่าโมเดลยังไม่แสดงความสามารถนี้ในระดับที่น่าตื่นเต้น แต่ปัจจุบันเขาชี้ว่าความก้าวหน้าในการบุกเบิกทางคณิตศาสตร์และเกณฑ์ TasteVal เป็นสัญญาณว่าสถานการณ์กำลังเปลี่ยนไป
ก่อนหน้านี้ในเดือนพฤษภาคม Clark เคยเสนอตัวเลขที่ระมัดระวังกว่า โดยให้โอกาสที่ระบบจะฝึกฝนทายาทที่แข็งแกร่งกว่าด้วยตนเองอยู่ที่ ประมาณ 60 เปอร์เซ็นต์ภายในสิ้นปี 2028 และ 30 เปอร์เซ็นต์ภายในปี 2027 ซึ่งการที่เขาเป็นผู้ร่วมก่อตั้งบริษัทที่ครองอันดับต้นๆ ในเกณฑ์วัด อาจเพิ่มความลำเอียง (bias) ให้กับการคาดการณ์ได้
นักวิจารณ์เคยขีดเส้นไว้ที่ความสามารถนี้พอดี
TasteVal มีความสำคัญเพราะวัดความสามารถที่กลุ่มผู้กังขาเคยระบุว่าเป็นปราการด่านสุดท้ายของ AI โดย Herbie Bradley นักวิจัย AI เคยโต้แย้งว่าแม้โมเดลจะรับงานระดับต้นได้ แต่ทักษะระดับสูงอย่าง research taste และความคิดสร้างสรรค์ยังไม่มีให้เห็น ซึ่ง TasteVal ได้เข้ามาท้าทายการประเมินดังกล่าวในส่วนของการวางแผนและประเมินการทดลอง แม้จะยังไม่ได้บอกอะไรเกี่ยวกับการเลือกแผนงานวิจัยระยะยาวก็ตาม
ช่องว่างในทางปฏิบัติยังปรากฏใน study on AI development using AI agents โดยทีมจากมหาวิทยาลัย Fudan ที่พบว่าแม้ AI agents จะมีส่วนร่วมในข้อเสนอวิจัยสูงถึง 55 เปอร์เซ็นต์ แต่มนุษย์ยังคงทำการตัดสินใจขั้นสุดท้ายกว่า 85 เปอร์เซ็นต์ ซึ่งเป็นส่วนที่ TasteVal แยกออกมาจากการทดสอบ
การถกเถียงกำลังเปลี่ยนไป
เกณฑ์มาตรฐานนี้เกิดขึ้นท่ามกลางการถกเถียงในห้องปฏิบัติการ AI รายใหญ่ โดยในเดือนมิถุนายน Anthropic ระบุว่า recursive self-improvement ยังทำไม่สำเร็จ แต่เตือนว่าอาจมาถึงเร็วกว่าที่คาด ซึ่ง Dario Amodei ซีอีโอของ Anthropic ได้ เรียกร้อง ให้มีการชะลอการพัฒนาอย่างควบคุมได้
ขณะที่ OpenAI ยอมรับว่า fully autonomous RSI ยังไม่เกิดขึ้นและควรดำเนินการต่อเมื่อมีการรับรองการควบคุมโดยมนุษย์เท่านั้น
หากแนวโน้มจาก P-Zero Research เป็นจริง ผลกระทบที่ตามมาจะทำให้การพัฒนา AI เร็วและถูกลงอย่างมาก แต่ในขณะเดียวกัน งานวิจัยจะกลายเป็นเรื่องยากสำหรับมนุษย์ในการตรวจสอบ เพราะโมเดลจะเป็นผู้วางแผนและประเมินผลการทดลองของพวกมันเองทั้งหมด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร