
Agentic RAG vs Naive RAG: เมื่อระบบค้นข้อมูลต้องคิดเองได้
Large language models เป็นตัวสร้างข้อความที่ยอดเยี่ยม แต่มีจุดอ่อนสำคัญคืออาการประสาทหลอน (hallucination) หากเข้าไม่ถึงข้อมูลที่ถูกต้องและเป็นปัจจุบัน พวกมันจะสร้างคำตอบที่ดูน่าเชื่อถืออย่างมั่นใจแต่ผิดพลาดในแง่ข้อเท็จจริง Retrieval-Augmented Generation (RAG) จึงถูกพัฒนาขึ้นเป็นโซลูชันมาตรฐาน เพื่อให้ผลลัพธ์ของ model อ้างอิงจากแหล่งความรู้ภายนอกและลดความผิดพลาดในแอปพลิเคชันระดับองค์กร
อย่างไรก็ตาม เมื่อนำระบบเหล่านี้ไปใช้ใน workflow ที่ซับซ้อนขึ้น ปัญหาใหม่ก็ปรากฏขึ้น เนื่องจากท่อส่งข้อมูล RAG มาตรฐานเป็นแบบเส้นตรง (linear) คือดึงข้อมูลครั้งเดียวแล้วสร้างคำตอบทันที แม้จะทำงานได้ดีกับคำถามง่ายๆ แต่เมื่อเจอคำถามที่ต้องใช้การเหตุผลหลายขั้นตอนหรือการสังเคราะห์ข้อมูลจากหลายแหล่ง ท่อส่งข้อมูลนี้จะเริ่มแสดงข้อจำกัดออกมา
นี่คือจุดที่ Agentic RAG เข้ามามีบทบาทสำคัญ แทนที่จะมองว่าการดึงข้อมูลเป็นขั้นตอนตายตัว ระบบนี้จะมีความสามารถในการใช้เหตุผลว่าจะค้นหาอย่างไร ประเมินสิ่งที่พบ และทำซ้ำจนกว่าจะได้คำตอบที่น่าพอใจ
บทความนี้จะเจาะลึกการทำงานของสถาปัตยกรรมทั้งสองแบบ เพื่อดูว่า Naive RAG ถึงขีดจำกัดตรงไหน และความสามารถใดที่ทำให้ Agentic RAG เหมาะกับงานที่ซับซ้อน เพื่อให้คุณมีกรอบการทำงานที่ชัดเจนในการตัดสินใจเลือกแนวทางที่ใช่สำหรับโปรเจกต์ถัดไป
The Baseline: ทำความเข้าใจ Naive RAG
ก่อนจะไปสำรวจอนาคตของระบบ retrieval เราต้องเข้าใจจุดเริ่มต้นให้ชัดเจนเสียก่อน
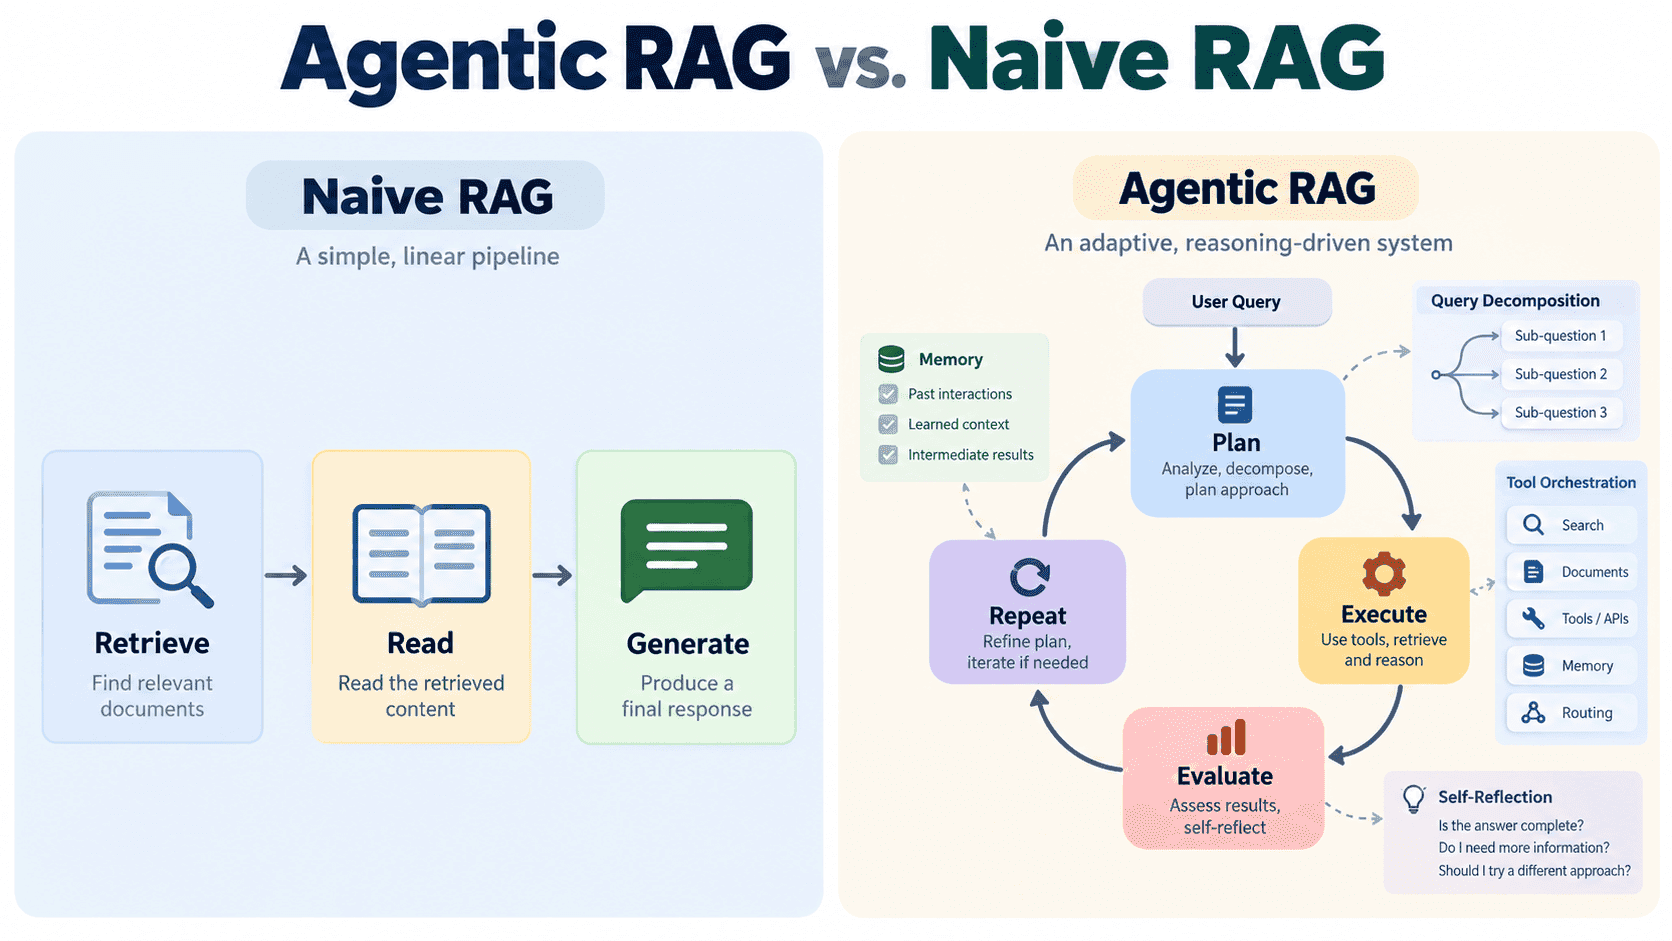
Naive RAG หรือ standard RAG ทำตามขั้นตอนแบบท่อส่งข้อมูลที่เคร่งครัดคือ Retrieve → Read → Generate เมื่อผู้ใช้ส่งคำถาม ระบบจะแปลงเป็น vector embedding เพื่อค้นหาความคล้ายคลึง (similarity search) ในฐานข้อมูล และดึงส่วนของเอกสาร (chunks) ที่เกี่ยวข้องที่สุดมาส่งให้ large language model (LLM) ใช้เป็นบริบท (context) ในการสร้างคำตอบ
ลองนึกภาพนักเรียนที่เตรียมสอบในห้องสมุด Naive RAG คือนักเรียนที่พิมพ์คำค้นหาเพียงครั้งเดียว หยิบหนังสือ 3 เล่มแรกบนชั้น แล้วเขียนเรียงความทันทีโดยไม่หยุดตรวจสอบว่าข้อมูลเหล่านั้นตอบคำถามได้ครบถ้วนหรือไม่
เบื้องหลังกระบวนการนี้ เอกสารจะถูกแบ่งเป็น chunks และแปลงเป็น dense vector โดยใช้ embedding model เพื่อเก็บไว้ในฐานข้อมูลที่รองรับ approximate nearest-neighbor search เมื่อถึงเวลาประมวลผล (inference time) คำถามจะถูกแปลงด้วย model เดียวกันเพื่อหา chunks ที่มีค่าใกล้เคียงกันที่สุดในมิติสูง (high-dimensional space) แล้วป้อนเข้าสู่ context window ของ LLM เพื่อใช้อ้างอิง
นี่คือนวัตกรรมที่เปลี่ยนโลก ทำให้เราสร้างระบบ Q&A ระดับองค์กรหรือผู้ช่วยสรุปเอกสารที่ตรวจสอบแหล่งที่มาได้ สำหรับแอปพลิเคชันทั่วไป Naive RAG ยังคงเป็นตัวเลือกที่ยอดเยี่ยมและคุ้มค่าที่สุด
The Bottleneck: จุดที่ Naive RAG ล้มเหลว
จุดอ่อนหลักของสถาปัตยกรรมนี้คือความเป็นเส้นตรง หากการดึงข้อมูลรอบเดียวล้มเหลว ระบบจะไม่มีวิธีแก้ไขเลย ไม่ว่าจะเป็นเพราะคำถามไม่ชัดเจน ข้อมูลกระจัดกระจาย หรือต้องการการใช้เหตุผลซับซ้อน
ข้อจำกัดของการดึงข้อมูลครั้งเดียว (The Single-Pass Limitation)
Naive RAG มีโอกาสดึงข้อมูลเพียงครั้งเดียว หาก embedding ไม่สามารถดึง chunks ที่ถูกต้องกลับมาได้ model จะต้องสร้างคำตอบจากบริบทที่ไม่สมบูรณ์ โดยไม่สามารถรับรู้ได้ว่าการดึงข้อมูลล้มเหลวและไม่สามารถลองใช้วิธีอื่นได้
ความล้มเหลวในการใช้เหตุผลหลายขั้นตอน (Multi-Hop Reasoning Failures)
พิจารณาคำถาม: "นโยบายกำกับดูแลใดที่บริษัทซึ่งเข้าซื้อกิจการ WhatsApp ปฏิบัติตามในสหภาพยุโรป?"
การตอบคำถามนี้ต้องใช้สองขั้นตอนคือ:
- ระบุว่า Meta เข้าซื้อ WhatsApp
- ดึงข้อมูลนโยบายของ Meta ในสหภาพยุโรป
การค้นหาแบบครั้งเดียวมักล้มเหลวในการเชื่อมโยงนี้ โดยเฉพาะหากข้อมูลอยู่คนละเอกสาร เนื่องจาก Naive RAG ไม่สามารถแยกคำถามย่อยหรือใช้คำตอบแรกมาประกอบการค้นหาครั้งที่สองได้
ความอ่อนไหวต่อการดึงข้อมูลที่ผิดพลาด (Susceptibility to Bad Retrieval)
เมื่อข้อมูลที่ดึงมาไม่เกี่ยวข้อง LLM จะตกที่นั่งลำบาก มันอาจสร้างคำตอบที่เพิกเฉยต่อบริบท (จนเกิด hallucination) หรือตอบว่าไม่มีข้อมูล ซึ่งในงานระดับองค์กรที่มีความเสี่ยงสูง ผลลัพธ์ทั้งสองแบบถือว่ายอมรับไม่ได้
Agentic RAG: การใส่สมองให้ระบบ
Agentic RAG เปลี่ยนมุมมองใหม่ โดยมองว่า LLM ไม่ใช่แค่เครื่องผลิตข้อความ (passive) แต่เป็นเครื่องยนต์การใช้เหตุผลอัตโนมัติที่คอยควบคุมกระบวนการดึงข้อมูลอย่างกระตือรือร้น
หาก Naive RAG คือท่อส่งข้อมูล Agentic RAG ก็คือวงจร (loop): Plan → Execute → Evaluate → Repeat
เปรียบเหมือนผู้ช่วยวิจัยที่ทุ่มเทซึ่งจะไม่หยิบหนังสือแค่สามเล่มแล้วจบงาน แต่จะอ่านข้อมูลเบื้องต้น ตรวจสอบสิ่งที่หายไป ค้นหาเพิ่มเติม และจะลงมือเขียนเมื่อมั่นใจในหลักฐานแล้วเท่านั้น Agentic RAG นำพฤติกรรมนี้มาใส่ในระบบดึงข้อมูล
ในระบบนี้ LLM จะเป็นผู้กำกับดูแล (orchestrator) ที่ตัดสินใจเองว่าจะค้นหาอะไร จากที่ไหน และประเมินว่าผลลัพธ์ดีพอหรือยัง สิ่งนี้เปลี่ยนการดึงข้อมูลจากการเตรียมการที่ตายตัว ให้กลายเป็นกระบวนการแบบไดนามิกที่แก้ไขตัวเองได้แบบเรียลไทม์
4 กลไกที่ทำให้ RAG กลายเป็น Agentic
ความแตกต่างของระบบ agentic เกิดจากการรวม 4 กลไกสำคัญที่เข้ามาปิดจุดอ่อนของท่อส่งข้อมูลแบบเส้นตรง:
Query Routing (การกำหนดเส้นทางคำถาม)
ระบบสามารถตัดสินใจได้ว่าจะค้นหา ที่ไหน เช่น คำถามการเงินอาจไปที่ฐานข้อมูล SQL, คำถามนโยบายใช้ semantic search, หรือเรื่องปัจจุบันใช้การค้นหาเว็บสด LLM จะเลือกเครื่องมือที่เหมาะสมที่สุด แทนที่จะบังคับให้ทุกคำถามผ่านกลไกเดียว
Query Decomposition (การแยกย่อยคำถาม)
ระบบจะย่อยคำถามซับซ้อนออกเป็นส่วนย่อยๆ เช่น ในตัวอย่าง WhatsApp ระบบจะหาชื่อผู้ซื้อกิจการก่อน (Meta) แล้วจึงนำชื่อนั้นไปค้นหานโยบายที่เกี่ยวข้องต่อ การใช้เหตุผลตามลำดับเช่นนี้ช่วยให้ได้คำตอบที่แม่นยำกว่าการค้นหาแบบกว้างๆ ครั้งเดียว
Self-Reflection and Critique (การสะท้อนความเห็นและวิพากษ์ตนเอง)
นี่คือหัวใจสำคัญ หลังจากดึงข้อมูลมาแล้ว ระบบจะหยุดประเมินว่า chunks เหล่านั้นตอบคำถามได้จริงหรือไม่ หากข้อมูลไม่เพียงพอหรือขัดแย้งกัน มันจะเขียนคำถามใหม่และเริ่มค้นหาอีกรอบจนกว่าจะมั่นใจ ช่วยป้องกันการส่งต่อข้อมูลที่ผิดพลาดไปยังตัวสร้างคำตอบ
Tool Use and Function Calling (การใช้เครื่องมือและการเรียกใช้ฟังก์ชัน)
Agentic RAG ไม่ได้จำกัดแค่ฐานข้อมูลข้อความ แต่สามารถใช้เครื่องมือภายนอกผ่าน function calling เช่น เครื่องคิดเลข, Web Search API, หรือ SQL เพื่อดึงข้อมูลที่มีโครงสร้างและข้อมูลเรียลไทม์มาประกอบกันเป็นคำตอบเดียวที่สมบูรณ์
การเลือกใช้: เมื่อไหร่ควรใช้แบบไหน
การเลือกระหว่าง Naive RAG และ Agentic RAG คือการแลกเปลี่ยนระหว่างต้นทุนและความสามารถ
Naive RAG มี latency ต่ำ ต้นทุนคาดการณ์ได้ และ debug ง่าย เพราะเรียก LLM เพียงครั้งเดียว ส่วน Agentic RAG จะมี latency และต้นทุน token สูงกว่าจากการใช้เหตุผลหลายขั้นตอน
เลือก Naive RAG เมื่อ:
- คำถามเรียบง่าย จบในขั้นตอนเดียว (single-hop)
- ต้องการความเร็วสูง เช่น แชทบอทบริการลูกค้าหรือ FAQ
- ฐานข้อมูลจัดระเบียบดีอยู่แล้ว
- มีข้อจำกัดด้านงบประมาณ
เลือก Agentic RAG เมื่อ:
- ต้องใช้เหตุผลข้ามเอกสารหรือหลายแหล่งข้อมูล
- ต้องการความแม่นยำสูงสุด (การเงิน, กฎหมาย, การแพทย์)
- คำถามของผู้ใช้ซับซ้อนและคาดเดาได้ยาก
- ต้องใช้เครื่องมือภายนอกหรือข้อมูลเรียลไทม์
สำหรับระบบที่ใช้งานจริง การใช้แนวทางแบบผสม (hybrid) อาจดีที่สุด โดยส่งคำถามทั่วไปผ่าน Naive RAG และเก็บวงจร Agentic ไว้สำหรับคำถามที่ซับซ้อนหรือมีความเสี่ยงสูง
แหล่งการเรียนรู้ที่แนะนำ
สำหรับผู้ที่ต้องการศึกษาต่อ นี่คือแหล่งข้อมูลเริ่มต้นที่สำคัญ:
- เอกสารประกอบของ LangChain และ LlamaIndex: มีคู่มือสร้าง RAG ทั้งสองแบบพร้อมการนำระบบ loop ไปใช้จริง
- "RAG Survey" โดย Gao และคณะ (2023): บทสรุปวิชาการครอบคลุมสถาปัตยกรรม RAG ทุกรูปแบบ
- หลักสูตร "Building and Evaluating Advanced RAG" ของ DeepLearning.AI: เน้นการปฏิบัติด้วยโค้ด
- เอกสาร function calling ของ Anthropic และ OpenAI: หัวใจสำคัญของการสร้างระบบ agentic
บทสรุป
ความแตกต่างระหว่าง Naive RAG และ Agentic RAG คือภาพสะท้อนของการเปลี่ยนผ่านจากท่อส่งข้อมูลที่เข้มงวดไปสู่ระบบที่ปรับตัวได้ Naive RAG ทำหน้าที่ดึงข้อมูล แต่ Agentic RAG ทำหน้าที่สืบสวน
หากงานของคุณคือการค้นหาข้อมูลทั่วไป สถาปัตยกรรมที่เรียบง่ายคือคำตอบ แต่หากต้องจัดการกับความซับซ้อนและการใช้เหตุผลระดับสูง ความคุ้มค่าของ Agentic RAG จะปรากฏให้เห็นในคุณภาพของผลลัพธ์ที่คุณได้รับ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร