
PyTorch 2.15 อัปเกรด MPS ครั้งใหญ่ เร่งสปีด LLM บน Mac
หากคุณรันโมเดลบน Mac หรือใช้ MPS เป็นเครื่องมือเร่งความเร็วหลักในการประมวลผล PyTorch 2.15 มีสิ่งที่น่าตื่นเต้นรออยู่มากมาย! ตั้งแต่การรองรับ FP8, การเพิ่มความเร็วเส้นทาง decoding ของโมเดลภาษาผ่าน linear layers และ softmax ไปจนถึงการนำ Metal kernels ใหม่มาช่วยจัดการส่วนที่มีการคำนวณสูงในงานด้านเสียง วิดีโอ และการเทรน
เราคือทีม PyTorch จาก Hugging Face ที่มุ่งเน้นพัฒนา MPS backend เพื่อให้ Mac เป็นแพลตฟอร์มระดับเฟิร์สคลาสสำหรับการรันและเทรนโมเดล จากเดิมที่การรันโมเดลบน MPS มักประสบปัญหาเรื่องประสิทธิภาพและหน่วยความจำ เราจึงทดสอบโมเดลจริงจาก Hugging Face Hub เพื่อหาจุดบกพร่องและแก้ไขด้วยการเปลี่ยนจาก MPSGraph เป็น Metal kernels เฉพาะทางมากขึ้น ซึ่งเนื้อหาเกือบทั้งหมดในเวอร์ชันนี้คือผลลัพธ์ของความพยายามดังกล่าวร่วมกับชุมชนผู้ดูแล PyTorch
TL;DR
- FP8 มาสู่ Mac: รองรับการเก็บค่า
float8_e4m3fnโดยใช้พื้นที่เพียงครึ่งเดียวของ BF16 พร้อมรองรับการคูณเมทริกซ์แบบปรับสเกล (scaled matrix multiplication) เช่นเดียวกับ CUDA/CPU - โมเดล MoE Decode เร็วขึ้น 5-6.5 เท่า: Qwen3.6-35B-A3B ทำความเร็วได้ 61.3 tokens/s บน M3 Ultra (เทียบกับ 9.4 ในเวอร์ชัน 2.14) ด้วย grouped matmul แบบเนทีฟและการลดการซิงค์ GPU-CPU
- ลดเวลาต่อ token สำหรับทุก LLM: linear layers แบบแถวเดียวใช้ matrix-vector kernels เฉพาะทาง และ softmax เร็วขึ้นประมาณ 8 เท่า
- เพิ่มประสิทธิภาพพีชคณิตเชิงเส้นบน GPU: รองรับการแก้สมการ LU และ triangular แบบ complex, ทำ inverse เมทริกซ์ขนาดเล็กได้เร็วขึ้น และแยกตัวประกอบ QR ได้ไวขึ้น
- ปรับปรุงงานเสียง วิดีโอ และการเทรน: เพิ่มความเร็ว convolutions, padding และ dropout โดยการ decode วิดีโอ VAE ของ Wan2.2 ตอนนี้ใช้หน่วยความจำสูงสุดเพียง 8 GiB จากเดิมที่เคยสูงถึง 270 GiB
- ควบคุมผ่าน Python ได้มากขึ้น: เปิดให้ใช้งาน MPS streams ต่อสาธารณะและวัดเวลาเหตุการณ์ได้แม่นยำขึ้น
- อัปเดตข้อกำหนด: MPS ต้องการ macOS 15 หรือใหม่กว่า และ PyTorch 2.15 ต้องการ Python 3.11 หรือใหม่กว่า
- แอบดู 2.16: เตรียมพบกับ attention ที่ทำงานบน Metal ทั้งหมด และการ decode LLM ที่จะเร็วยิ่งขึ้น
สิ่งนี้มีความหมายต่อคุณอย่างไร
สำหรับผู้ที่รันโมเดลด้วย transformers, diffusers หรือ ComfyUI บน Mac นี่คือการเปลี่ยนแปลงสำคัญใน PyTorch 2.15:
- LLM ในเครื่องเร็วขึ้นมาก: โมเดล Mixture-of-experts decode เร็วขึ้น 5-6.5 เท่า โดยบน M3 Ultra ร่วมกับ
torch.compileโมเดล Qwen3.6-35B-A3B เพิ่มสปีดเป็น 61.3 tokens/s ขณะที่ LFM2.5-8B-A1B พุ่งไปถึง 123.6 tokens/s (เพิ่มเติม) - สร้างวิดีโอโดยใช้หน่วยความจำน้อยลง: การ decode วิดีโอด้วย VAE ของ Wan2.2 ที่เคยใช้หน่วยความจำไดรเวอร์สูงถึง 270 GiB ปัจจุบันลดเหลือเพียง 8 GiB เท่านั้น (เพิ่มเติม)
- แก้ไขรูปภาพแม่นยำขึ้น: แก้ไขปัญหาการทำ padding ที่เคยทำให้รูปภาพจาก Qwen-Image-2.1 เสียหายบน MPS โดยการประมวลผลไปกลับตอนนี้ให้ผลลัพธ์ตรงกับ CPU ที่ 29.95 dB PSNR
- รองรับ FP8 weights: Tensors แบบ FP8 ใช้หน่วยความจำเพียงครึ่งเดียวของ BF16 โดยสามารถใช้
F.scaled_mmคูณกันได้โดยตรงบน GPU (เพิ่มเติม)
สารบัญ
- เริ่มต้นใช้งาน
- FP8 มาสู่ MPS
- การ decode language-model ที่เร็วขึ้น
- พีชคณิตเชิงเส้นได้รับการยกระดับ
- Convolutions, padding และการเทรน
- Softmax และ reductions
- การใช้หน่วยความจำที่น้อยลงมากสำหรับการ decode วิดีโอ
- การควบคุมที่มากขึ้นด้วย MPS streams
- โอเปอเรชันที่ทำงานบน MPS ได้มากขึ้น
- ข้อมูลแอบดู PyTorch 2.16
- บทสรุป
เริ่มต้นใช้งาน
คุณต้องใช้ Apple silicon Mac ที่รัน macOS 15 ขึ้นไป และ Python 3.11 ขึ้นไป หากฮาร์ดแวร์หรือซอฟต์แวร์ไม่รองรับ ระบบจะแจ้งเหตุผลให้ทราบ
สำหรับการทดลองใช้ release candidate ในสภาพแวดล้อมแยกต่างหาก สามารถติดตั้งได้ด้วยคำสั่ง:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpuFP8 มาสู่ MPS
FP8 เป็นทางเลือกใหม่ในการประหยัดหน่วยความจำ โดย PyTorch 2.15 เพิ่ม torch.float8_e4m3fn tensors บน MPS ซึ่งใช้พื้นที่เพียง 1 ไบต์ต่อค่า (ครึ่งหนึ่งของ FP16/BF16)
คุณสามารถใช้ F.scaled_mm เพื่อคูณ tensors เหล่านี้ได้โดยตรง พร้อมรองรับการปรับสเกลทั้งแบบ tensorwise และ rowwise ดังตัวอย่างนี้:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
การ decode language-model ที่เร็วขึ้น
ในระหว่างการ decode แต่ละ token จะผ่านโมเดลในลักษณะแถวเดี่ยว ทำให้การคูณเมทริกซ์ขนาดใหญ่กลายเป็น matrix-vector products ซึ่ง PyTorch 2.15 ได้เร่งความเร็วเลเยอร์สำคัญทั้ง dense linear layers และ MoE layers
Linear layers
เราได้เชื่อมต่อ GEMV kernels เข้ากับ F.linear โดยตรง ทำให้การ decode ทั่วไปขนาด [1, 1, hidden_size] มีความเร็วเพิ่มขึ้นเฉลี่ย 1.23 เท่า โดยเฉพาะการทำ projection ขนาดเล็กที่เคยใช้ memory bandwidth ไม่เต็มประสิทธิภาพ
Mixture-of-experts layers
เลเยอร์ MoE จะส่ง token ไปยังผู้เชี่ยวชาญหลายคน ซึ่ง PyTorch 2.15 ได้นำ การปรับใช้แบบเนทีฟ ของ Grouped matmul มาใช้บน MPS โดยใช้ Metal kernels ใหม่ที่อ่านค่า offsets บน GPU ได้โดยตรง
ตัวอย่างการใช้งาน:
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
ผลลัพธ์คือปริมาณการส่งข้อมูล token บน M3 Ultra ร่วมกับ torch.compile เพิ่มขึ้นประมาณ 1.3 เท่า:
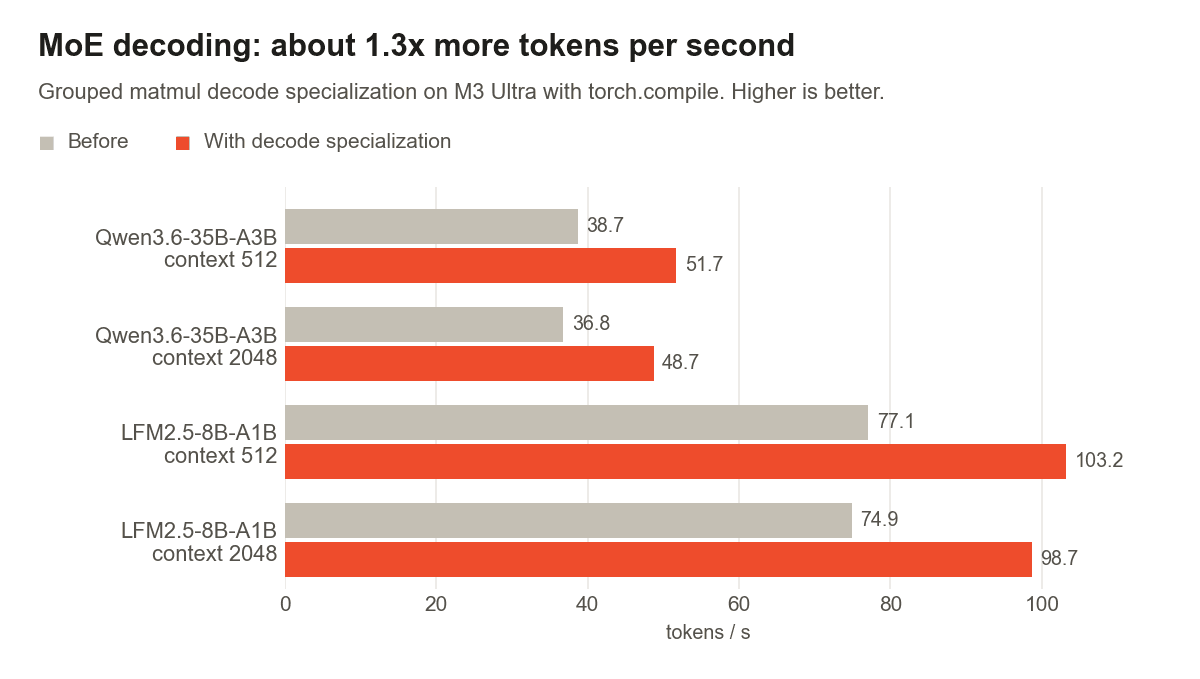
พีชคณิตเชิงเส้นได้รับการยกระดับ
การประมวลผลค่า Complex
ตอนนี้ MPS รองรับการทำ LU factorization, LU solve และ triangular solve แบบ complex64 แล้ว ซึ่งช่วยปลดล็อกงานคำนวณที่ซับซ้อน เช่น complex determinants บน GPU
เมทริกซ์ขนาดเล็กและการแก้สมการขนาดใหญ่ขึ้น
เมทริกซ์ขนาดสูงสุด 4 × 4 สำหรับงานกราฟิกได้รับ kernels ที่สามารถ ทำ inverse ใน Metal kernel เดียว ส่วนงานขนาดใหญ่อย่าง QR factorization และ triangular solves ก็ได้รับการปรับปรุงให้มีประสิทธิภาพสูงขึ้น
นอกจากนี้ SVD ยังมีความเสถียรมากขึ้นในการจัดการค่า singular values ที่เล็กมาก หรืออินพุตที่มีขนาดสุดโต่ง เพื่อให้ผลลัพธ์ของ pseudoinverse เชื่อถือได้ยิ่งขึ้น
Convolutions, padding และการเทรน
การอัปเดตครั้งนี้เพิ่มเส้นทาง Metal kernels ใหม่สำหรับหลายโอเปอเรชันสำคัญ:
| โอเปอเรชัน | สิ่งที่เปลี่ยนแปลงใน 2.15 |
|---|---|
conv1d forward | ใช้ Kernels เฉพาะทางแทน MPSGraph เหมาะสำหรับโมเดลเสียงและ streaming |
| Constant padding | ย้ายไปยัง Metal ช่วยแก้ปัญหาหน่วยความจำพุ่งสูงในการ decode วิดีโอ |
| Reflection/Replication padding | ปรับปรุงความเร็วและความถูกต้องของ backward |
| Out-of-place dropout | ใช้ fused kernel ที่มีอยู่เดิมเพื่อเพิ่มประสิทธิภาพ |
| Upsampling backward | ใช้ Metal gather kernel แทนเส้นทางเดิม |
Channels-last conv2d backward | ใช้เส้นทาง channels-last ที่มีประสิทธิภาพสูงขึ้น |
Softmax และ reductions
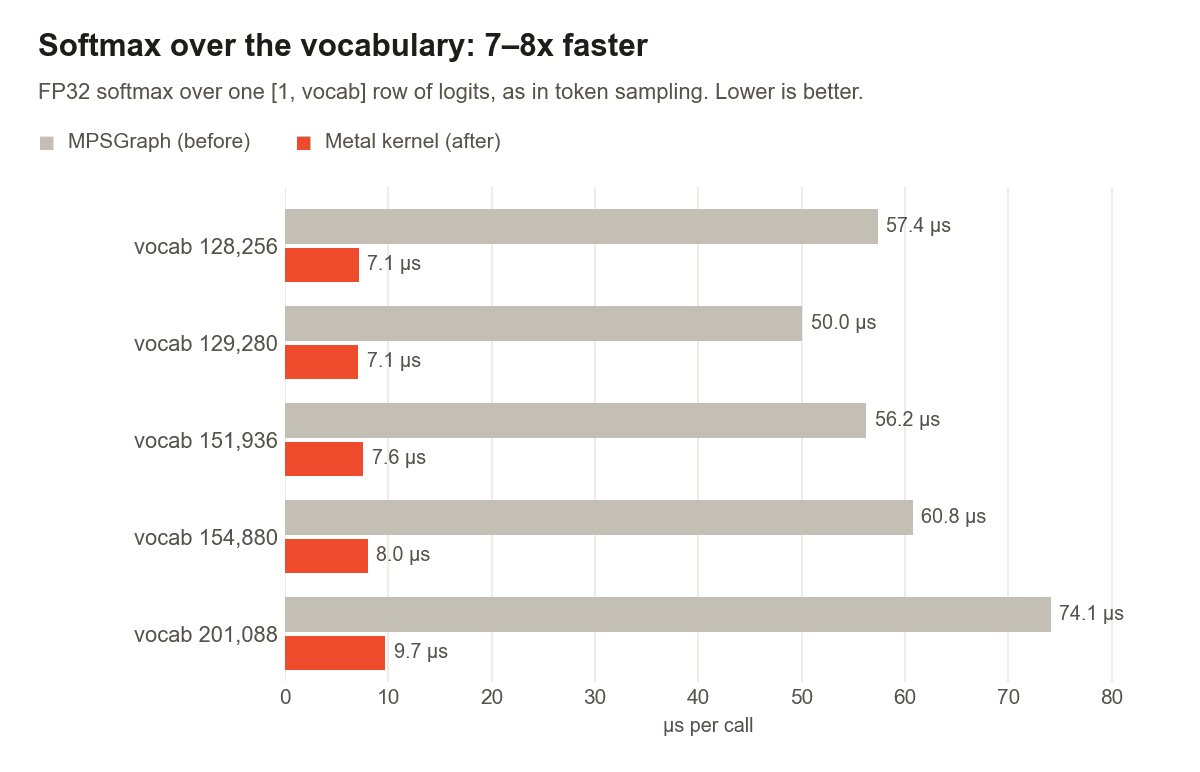
การทำ token sampling ในเวอร์ชัน 2.15 ทำได้รวดเร็วขึ้นมาก โดย softmax และ log_softmax รันบน Metal kernels เฉพาะทาง สำหรับคำศัพท์ขนาดใหญ่ เช่น [1, 128256] เวลาลดลงจาก 57 µs เหลือ 7 µs หรือเร็วขึ้นถึง 8 เท่า
การใช้หน่วยความจำที่น้อยลงมากสำหรับการ decode วิดีโอ
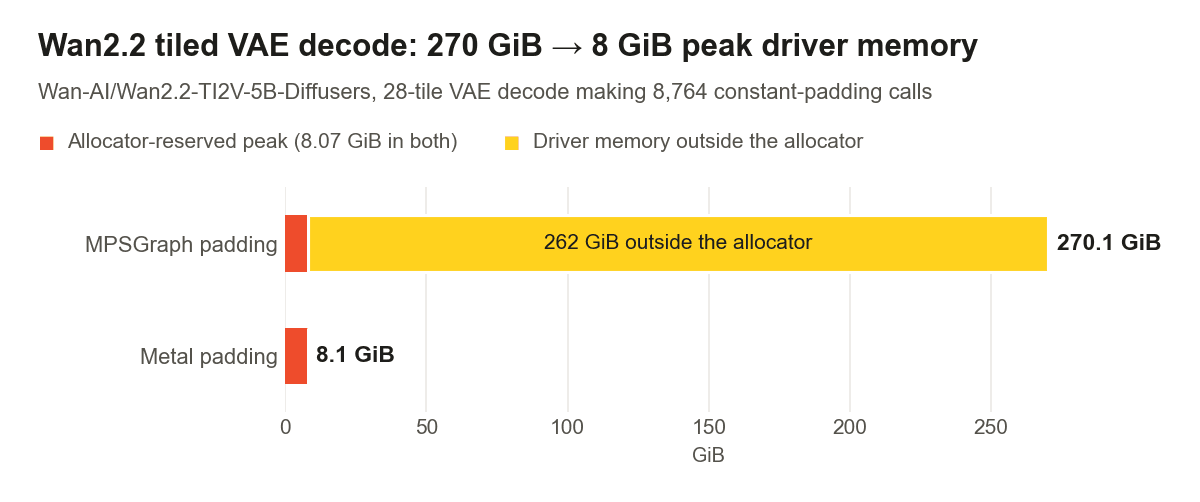
ความสำเร็จที่สำคัญคือการเปลี่ยน constant-padding ในการ decode VAE ของ Wan2.2 ที่ต้องเรียกใช้ padding กว่า 8,700 ครั้ง จากเดิมที่ใช้หน่วยความจำไดรเวอร์สูงสุด 270 GiB ตอนนี้เหลือเพียง 8.1 GiB เท่านั้น
การควบคุมที่มากขึ้นด้วย MPS streams
นักพัฒนาสามารถเลือก stream สำหรับรันงาน MPS ได้โดยตรงผ่าน Python ด้วย torch.mps.Stream และจัดการการใช้งาน tensor ข้าม stream ได้ด้วย Tensor.record_stream
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
โอเปอเรชันที่ทำงานบน MPS ได้มากขึ้น
เพิ่มการรองรับโอเปอเรชันใหม่ๆ เช่น torch.frexp, torch.logspace, torch.take, torch.heaviside และการเปรียบเทียบเลขจำนวนเต็มแบบไม่มีเครื่องหมาย นอกจากนี้ยังแก้ไขความถูกต้องของ Scaled dot-product attention ในการจัดการ batch และ head broadcasting ให้แม่นยำขึ้น
ข้อมูลแอบดู PyTorch 2.16
การพัฒนาเวอร์ชัน 2.16 กำลังดำเนินไปอย่างเข้มข้น โดยมีความคืบหน้าบางส่วนใน nightlies แล้วดังนี้:
- การ decode LLM ที่เร็วขึ้น: เพิ่มการ commit command buffer เพื่อให้ GPU ทำงานขนานไปกับ CPU ส่งผลให้โมเดลอย่าง Qwen3.6-35B-A3B เร็วขึ้นอีก 19%
- Attention บน Metal ทั้งหมด: Scaled dot-product attention จะเลิกใช้ MPSGraph โดยสิ้นเชิง ซึ่งจะช่วยลดเวลาการ decode บน M5 Pro จาก 465 µs เหลือเพียง 65 µs
- ย้ายโอเปอเรชันออกจาก MPSGraph: กำลังย้าย Batch norm, MSE loss และ
bincountไปยัง Metal โดยbincountอาจทำงานเร็วขึ้นมหาศาลจากระดับวินาทีเหลือเพียงเสี้ยวของมิลลิวินาที - ขนาดการติดตั้งที่เล็กลง: ปรับปรุงการสร้าง Shader ให้กระชับขึ้น ช่วยลดขนาด
libtorch_cpu.dylibลงประมาณ 25%
บทสรุป
PyTorch 2.15 ยกระดับการใช้งานบน Mac ไปอีกขั้น ทั้งความเร็วในการ decode LLM, การรองรับ FP8 และการย้ายการประมวลผลไปยัง Metal kernels อย่างเต็มตัวเพื่อประสิทธิภาพสูงสุด หากคุณพบจุดที่ทำงานช้าหรือมีข้อเสนอแนะ สามารถเปิด issue บน GitHub เพื่อร่วมพัฒนาไปพร้อมกับเรา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร