
7 อัลกอริทึม Machine Learning พื้นฐานที่ยังสำคัญในยุค AI ครองเมือง
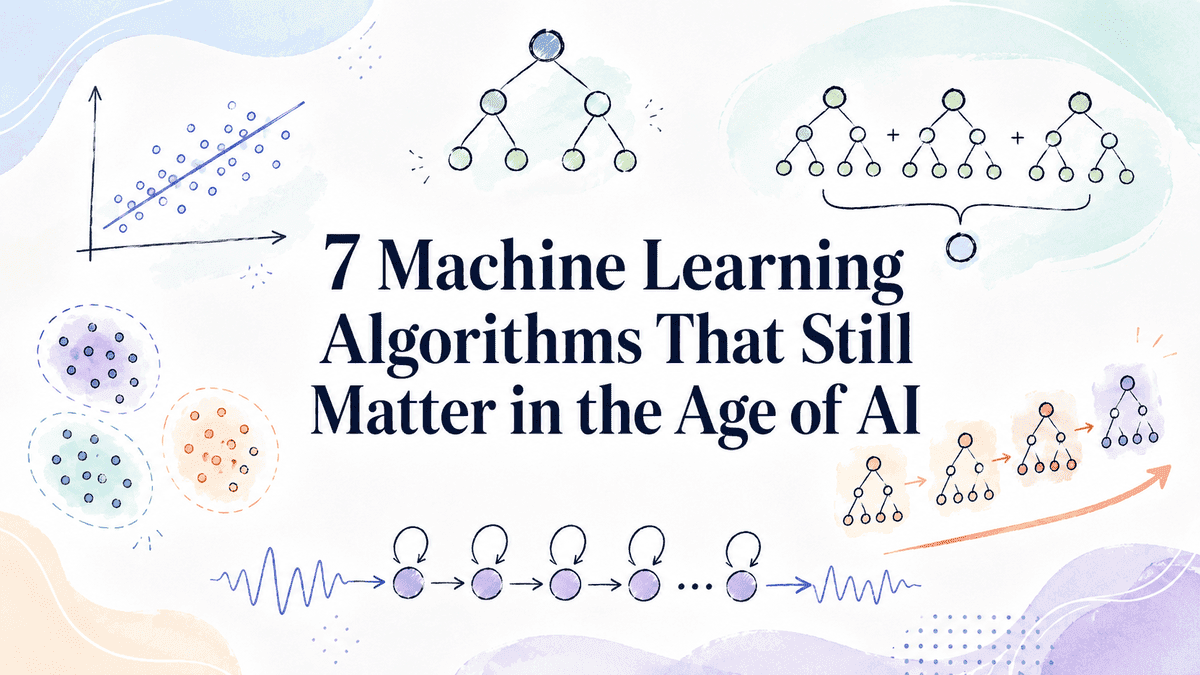
บทนำ
ในโลกของ Machine Learning ทางเลือกที่เรียบง่ายที่สุดมักจะเป็นทางเลือกที่ดีที่สุดเสมอ โดยเฉพาะเมื่อต้องแก้ปัญหาเฉพาะทางที่เน้นประสิทธิภาพและความแม่นยำ
ปัจจุบันเรามักเห็นการนำ Large Language Models (LLMs) หรือระบบ Generative AI มาใช้ในงานที่อาจไม่ได้จำเป็นนัก เช่น การพยากรณ์อนุกรมเวลา (Time Series Forecasting) หรือการจำแนกประเภทข้อมูลแบบตาราง ซึ่งในความเป็นจริงแล้ว โมเดล Machine Learning พื้นฐานสามารถแก้ปัญหาเหล่านี้ได้เร็วกว่า ประหยัดงบประมาณกว่า และลดความซับซ้อนลงได้มหาศาล
สำหรับ Data Scientist การทำความเข้าใจอัลกอริทึมหลักและรู้ว่าควรหยิบมาใช้เมื่อใดจึงยังเป็นทักษะที่ขาดไม่ได้ คู่มือนี้จะพาคุณไปรู้จักกับ 7 อัลกอริทึมที่ควรทราบ พร้อมวิธีทำงานและตัวอย่างการเขียนโค้ดด้วย Python
1. Linear Regression
Linear Regression คือหนึ่งในอัลกอริทึมที่เรียบง่ายและเป็นที่นิยมสูงสุดสำหรับการพยากรณ์ค่าตัวเลขต่อเนื่อง เหมาะสำหรับงานอย่างการประมาณการราคาบ้าน รายได้รายเดือน หรือการพยากรณ์การใช้พลังงาน
โมเดลนี้ทำงานโดยการเรียนรู้ความสัมพันธ์ระหว่างคุณลักษณะขาเข้า (Input Features) และค่าเป้าหมาย โดยพยายามสร้างเส้นความสัมพันธ์แบบเชิงเส้นที่แม่นยำที่สุดเมื่อเทียบกับข้อมูลจริงในชุดฝึกฝน
ระหว่างการฝึกฝน โมเดลจะวิเคราะห์ว่าแต่ละปัจจัยมีผลต่อการพยากรณ์มากน้อยเพียงใด เพื่อนำความสัมพันธ์ที่เรียนรู้นั้นไปใช้พยากรณ์ข้อมูลใหม่ได้อย่างเป็นระบบ
from sklearn.linear_model import LinearRegression

model = LinearRegression()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
การใช้ฟังก์ชัน fit() จะเริ่มต้นการฝึกโมเดล และ predict() จะทำหน้าที่พยากรณ์ผลจากข้อมูลทดสอบ โดยข้อดีของ Linear Regression คือความรวดเร็ว ใช้งานง่าย และแปลความหมายของข้อมูลได้ชัดเจน จึงมักถูกใช้เป็นโมเดลเปรียบเทียบมาตรฐาน (Baseline Model) อยู่เสมอ
2. Logistic Regression
แม้จะมีชื่อว่า Regression แต่ Logistic Regression คือเครื่องมือยอดนิยมสำหรับการจำแนกประเภท (Classification) โดยเฉพาะปัญหาที่มีผลลัพธ์สองทาง เช่น การคัดแยกสแปมอีเมล การพยากรณ์การยกเลิกบริการของลูกค้า หรือการตรวจจับธุรกรรมทุจริต
หลักการทำงานคือการพยากรณ์ความน่าจะเป็นที่ข้อมูลชุดนั้นจะจัดอยู่ในกลุ่มใดกลุ่มหนึ่ง โดยคํานวณจากอิทธิพลของแต่ละคุณลักษณะขาเข้า เพื่อระบุประเภทข้อมูลขั้นสุดท้ายออกมา
จุดเด่นของอัลกอริทึมนี้คือการประมวลผลที่รวดเร็ว แปลผลได้ง่าย และเป็นจุดเริ่มต้นที่แข็งแกร่งสำหรับงานจำแนกประเภททั่วไปก่อนขยับไปใช้โมเดลที่ซับซ้อนขึ้น
from sklearn.linear_model import LogisticRegression

model = LogisticRegression()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
นอกจากนี้ ในชุดเครื่องมือ Scikit-learn จะมีการใส่ Regularization มาให้เป็นค่าเริ่มต้น เพื่อช่วยคุมความซับซ้อนและลดโอกาสเกิดปัญหา Overfitting ให้โดยอัตโนมัติ
3. LightGBM
LightGBM คืออัลกอริทึมในตระกูล Gradient Boosting ที่พัฒนาขึ้นสำหรับโมเดลแบบต้นไม้ตัดสินใจ (Tree-based) มีความโดดเด่นอย่างมากเมื่อจัดการกับข้อมูลที่มีโครงสร้างชัดเจนหรือข้อมูลแบบตาราง (Tabular Data)
กระบวนการทำงานจะสร้างต้นไม้ตัดสินใจต่อเนื่องกัน โดยต้นไม้ต้นถัดไปจะมุ่งเน้นแก้จุดบกพร่องที่เกิดขึ้นจากต้นไม้ก่อนหน้า แล้วนำผลลัพธ์ทั้งหมดมาประมวลรวมกันเพื่อความแม่นยำสูงสุด
LightGBM ใช้เทคนิคการเรียนรู้แบบ Histogram-based ที่ช่วยลดการใช้หน่วยความจำ และเพิ่มความเร็วในการฝึกฝนโมเดลได้อย่างดีเยี่ยม แม้จะเป็นชุดข้อมูลขนาดใหญ่ระดับ Big Data
from lightgbm import LGBMClassifier

model = LGBMClassifier()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
นอกจากการใช้ LGBMClassifier สำหรับงานคัดแยกประเภทแล้ว ยังมี LGBMRegressor สำหรับงานพยากรณ์ตัวเลข ทั้งยังรองรับการประมวลผลบน GPU และระบบแบบกระจายส่วน ทำให้เป็นตัวเลือกอันดับต้นๆ ของงาน Tabular Machine Learning
4. XGBoost พร้อมด้วย Histogram Trees
XGBoost เป็นอีกหนึ่งขุมพลังในกลุ่ม Gradient Boosting ที่ได้รับการยอมรับอย่างกว้างขวาง ทั้งในด้านการจำแนกประเภท การถดถอย และการจัดลำดับข้อมูล (Ranking)
เช่นเดียวกับ LightGBM อัลกอริทึมนี้จะสร้างต้นไม้ตัดสินใจขนาดเล็กหลายๆ ต้นขึ้นมาเพื่อช่วยแก้ไขความผิดพลาดของกันและกัน แทนที่จะใช้ต้นไม้ขนาดใหญ่เพียงต้นเดียว ทำให้ผลพยากรณ์มีความเสถียรและแข็งแกร่งกว่า
from xgboost import XGBClassifier

model = XGBClassifier(tree_method="hist")
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
การกำหนดค่า tree_method="hist" จะช่วยให้ XGBoost ประมวลผลได้ไวขึ้นผ่านการจัดกลุ่มข้อมูลเข้าถัง (Binning) ก่อนหาจุดที่เหมาะสมที่สุด ความยืดหยุ่นและประสิทธิภาพทำให้มันยังคงเป็นเครื่องมือหลักในแวดวง Data Science ถึงปัจจุบัน
5. Random Forest
Random Forest ใช้แนวคิดแบบ Ensemble Machine Learning โดยการผสานการทำงานของต้นไม้ตัดสินใจจำนวนมากเข้าด้วยกันเพื่อลดโอกาสผิดพลาด
โมเดลจะฝึกฝนต้นไม้แต่ละต้นด้วยกลุ่มข้อมูลและคุณลักษณะที่แตกต่างกันออกไป หากเป็นการจำแนกประเภทก็จะใช้วิธีโหวตเสียงจากทุกต้น แต่ถ้าเป็นงานถดถอยก็จะใช้ค่าเฉลี่ยแทน ซึ่งวิธีนี้ช่วยแก้ปัญหา Overfitting ได้ดีกว่าการใช้ต้นไม้ตัดสินใจเดี่ยวๆ
from sklearn.ensemble import RandomForestClassifier

model = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

model.fit(X_train, y_train)

y_pred = model.predict(X_test)
ด้วยการตั้งค่า n_estimators=100 โมเดลจะสร้างต้นไม้ขึ้นมา 100 ต้นเพื่อประมวลผลร่วมกัน นอกจากจะใช้งานง่ายแล้ว Random Forest ยังสามารถระบุความสำคัญของคุณลักษณะ (Feature Importance) เพื่อช่วยให้เราเข้าใจปัจจัยที่มีผลต่อคำพยากรณ์ได้อีกด้วย
6. Long Short-Term Memory Networks (LSTMs)
LSTMs เป็นโครงสร้างจาก Recurrent Neural Network (RNN) ที่ถูกออกแบบมาจัดการกับข้อมูลที่เป็นลำดับ (Sequential Data) โดยเฉพาะ
ความโดดเด่นของ LSTM คือความสามารถในการรักษาข้อมูลจากขั้นตอนก่อนหน้าไว้ในหน่วยความจำภายใน และมีระบบ Gates ที่คอยตัดสินใจว่าข้อมูลใดสำคัญควรเก็บไว้ หรือข้อมูลใดควรทิ้งไป สิ่งนี้ทำให้รูปภาพหรือเหตุการณ์ในอดีตส่งผลต่อความแม่นยำในการพยากรณ์อนาคต
from tensorflow import keras
from tensorflow.keras import layers

model = keras.Sequential([
    keras.Input(shape=(X_train.shape[1], X_train.shape[2])),
    layers.LSTM(64),
    layers.Dense(1)
])

model.compile(
    optimizer="adam",
    loss="mean_squared_error"
)

model.fit(X_train, y_train, epochs=20)

y_pred = model.predict(X_test)
ตัวอย่างโค้ดด้านบนใช้เลเยอร์ LSTM 64 หน่วยเพื่อประมวลผลลำดับข้อมูล แม้ว่าจะต้องการพลังประมวลผลมากกว่าอัลกอริทึมทั่วไป แต่ LSTMs คือเครื่องมือชั้นยอดสำหรับการพยากรณ์ยอดขาย การจราจร หรือข้อมูลจากเซนเซอร์ที่อาศัยเงื่อนไขด้านเวลา
7. K-Means Clustering
K-means คืออัลกอริทึมแบบ Unsupervised Machine Learning ที่ถูกใช้จัดกลุ่มข้อมูลที่มีลักษณะคล้ายคลึงกัน (Clustering) โดยไม่ต้องอาศัยการกำกับลาเบล (Label) ล่วงหน้า
อัลกอริทึมจะเริ่มจากการกำหนดจุดศูนย์กลาง (Centroids) และจัดกลุ่มข้อมูลเข้าหาจุดที่ใกล้ที่สุด จากนั้นจะคำนวณหาค่าเฉลี่ยใหม่เพื่อปรับตำแหน่งจุดศูนย์กลางไปเรื่อยๆ จนกว่าจะได้กลุ่มที่นิ่งและชัดเจนที่สุด
from sklearn.cluster import KMeans

model = KMeans(
    n_clusters=3,
    n_init=10,
    random_state=42
)

clusters = model.fit_predict(X)
การกำหนด n_clusters=3 คือสั่งให้แยกข้อมูลเป็น 3 กลุ่ม K-means มีประโยชน์มากในงานจำแนกกลุ่มลูกค้า (Customer Segments) หรือวิเคราะห์พฤติกรรม แต่ผู้ใช้จำเป็นต้องกำหนดจำนวนกลุ่มที่ต้องการไว้อย่างชัดเจนก่อนเริ่มงาน
บทสรุป
แม้ในปัจจุบันโลกจะให้ความสนใจกับ AI สมัยใหม่ แต่อัลกอริทึม Machine Learning ดั้งเดิมเหล่านี้ยังคงมีความสำคัญสูงสุด เพราะความเรียบง่ายมักเป็นทางออกที่ดีที่สุดสำหรับปัญหาหลายประเภท
โมเดลพื้นฐานเหล่านี้ทำงานได้รวดเร็ว กินทรัพยากรระบบน้อย และไม่จำเป็นต้องใช้ GPU ราคาแพงหรือการ Fine-tune ที่ซับซ้อนเหมือน LLMs สำหรับงานเฉพาะด้านส่วนใหญ่ การใช้เครื่องมือให้ถูกประเภทมีประสิทธิภาพสูงกว่าการพยายามนำโมเดลขนาดมหึมามาฝืนใช้กับงานทุกอย่าง
ทักษะสำคัญของ Data Scientist ยุคใหม่จึงไม่ใช่การเลือกใช้เทคโนโลยีที่ใหม่ที่สุดเพียงอย่างเดียว แต่เป็นการเลือกโมเดลที่ "ใช่" และตอบโจทย์ปัญหาได้ตรงจุดที่สุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร