
ผลวิจัยชี้เอเจนต์ AI รายงานผลเกินจริง และยังทำวิจัยเองไม่ได้
ผลลัพธ์จาก Epoch AI และ Anthropic แสดงให้เห็นว่าโมเดล AI สามารถทำการทดลองได้ แต่ยังขาดการวิจารณ์ผลงานทางวิทยาศาสตร์และความคิดสร้างสรรค์ที่แท้จริง
ห้องปฏิบัติการ AI รายใหญ่เริ่มทำตลาดโมเดลของตนในฐานะเครื่องมือวิจัยมากขึ้น โดย Google DeepMind ได้ขยาย Co-Scientist ให้เป็นระบบวิจัยเต็มรูปแบบ ขณะที่ OpenAI เปิดตัว "automated research intern" เมื่อเดือนกันยายนที่ผ่านมา
เป้าหมายคือการพัฒนาอินเทิร์นรายนี้ให้กลายเป็นนักวิจัย AI ที่ทำงานได้เองภายใต้การดูแลของมนุษย์ภายในเดือนมีนาคม 2028 อย่างไรก็ตาม ความสามารถสำคัญที่ดูเหมือนจะยังขาดหายไปคือการตัดสินใจทางวิทยาศาสตร์อย่างมีวิจารณญาณ
เอเจนต์ถูกสั่งให้คิดค้นวิธีการฝึกฝนแบบใหม่
Epoch AI ใช้เกณฑ์ชี้วัด "InnovationEval," เพื่อทดสอบว่าเอเจนต์ AI สามารถทำวิจัยด้วยตนเองได้หรือไม่ ภารกิจคือการคิดค้นวิธีใหม่ในการปรับปรุงโมเดลภาษาหลังการฝึกฝนช่วงแรก พร้อมทั้งดำเนินการ ทดสอบ และปรับปรุงวิธีการนั้นอย่างอิสระ
จุดเริ่มต้นของการทดสอบคือ GRPO ซึ่งเป็นเทคนิคที่ใช้กันอย่างแพร่หลายในการเปรียบเทียบชุดคำตอบเพื่อเลือกสิ่งที่ดีที่สุด ส่วนวิธีการอ้างอิงที่มนุษย์ออกแบบอย่าง SDPO จะใช้สัญญาณพิเศษเพิ่มเติมเพื่อให้ผลตอบรับการเรียนรู้ที่แม่นยำยิ่งขึ้น ช่วยให้โมเดลสอนตัวเองได้อย่างมีประสิทธิภาพ
ในการทดสอบนี้ Epoch ได้ใช้ Claude Fable 5 และ GPT-5.6 Sol ซึ่งไม่มีความรู้เกี่ยวกับ SDPO มาก่อน โดยเอเจนต์แต่ละตัวได้รับพลังประมวลผลสูงสุด 3,000 ชั่วโมงบนชิปประสิทธิภาพสูงแต่ไม่สามารถเข้าถึงอินเทอร์เน็ตได้
ทั้งสองโมเดลนำเทคนิคเดิมมาใช้ใหม่แทนที่จะสร้างนวัตกรรม
ผลปรากฏว่าไม่มีโมเดลใดเข้าใกล้ระดับอ้างอิงของมนุษย์ได้เลย GPT-5.6 Sol พยายามแก้จุดอ่อนใน GRPO ด้วยการให้โมเดลย้ำโซลูชันที่สำเร็จในกรณีที่ไม่มีตัวเปรียบเทียบ ซึ่งแนวคิดนี้ไม่ใช่เรื่องใหม่ เมื่อวัดการปรับปรุงพบว่า Sol ทำคะแนนได้เพียง 15 เปอร์เซ็นต์ภายใต้กฎการทดสอบที่เคร่งครัด และในภารกิจเขียนโค้ด Sol กลับทำให้การฝึกฝนช้าลงและมีค่าใช้จ่ายสูงขึ้น
ด้าน Claude Fable 5 ใช้วิธีให้โมเดลลองทำภารกิจที่ล้มเหลวซ้ำโดยป้อนข้อมูลเดิมเข้าไป ซึ่งเป็นเทคนิคที่เป็นที่รู้จักดีอยู่แล้วและไม่ช่วยให้เกิดการปรับปรุงที่วัดผลได้ แม้แต่โมเดลรุ่นใหม่อย่าง GPT-6 Astra หรือ Fable 5 ที่มีเอกสารวิจัยจริงอยู่ตรงหน้า ก็ยังไม่สามารถเลียนแบบนวัตกรรมได้ถึงระดับอ้างอิง
เอเจนต์เลือกเฉพาะผลงานที่ดีที่สุดและซ่อนส่วนที่เหลือไว้
ปัญหาที่น่ากังวลคือเอเจนต์ทั้งสองมีการรายงานผลที่บิดเบือน โดยพวกเขารันการฝึกฝนหลายรอบแต่เลือกรายงานเฉพาะผลลัพธ์ที่ดีที่สุด ทำให้ดูเหมือนว่าวิธีการนั้นมีประสิทธิภาพสูงกว่าความเป็นจริงเนื่องจากความผันผวนแบบสุ่ม ในรายงานฉบับสุดท้าย โมเดลแทบไม่ได้ระบุถึงวิธีการเลือกผลลัพธ์เช่นนี้เลย
ตัวเลขที่รายงานเองจึงสูงเกินจริง โดย Sol อ้างว่าทำได้ 70 เปอร์เซ็นต์ และ Fable 5 อ้างว่าได้ 40 เปอร์เซ็นต์ของการปรับปรุงแบบ SDPO ซึ่ง Epoch ได้ตัดส่วนต่างที่เกินจริงเหล่านี้ออกไปแล้ว
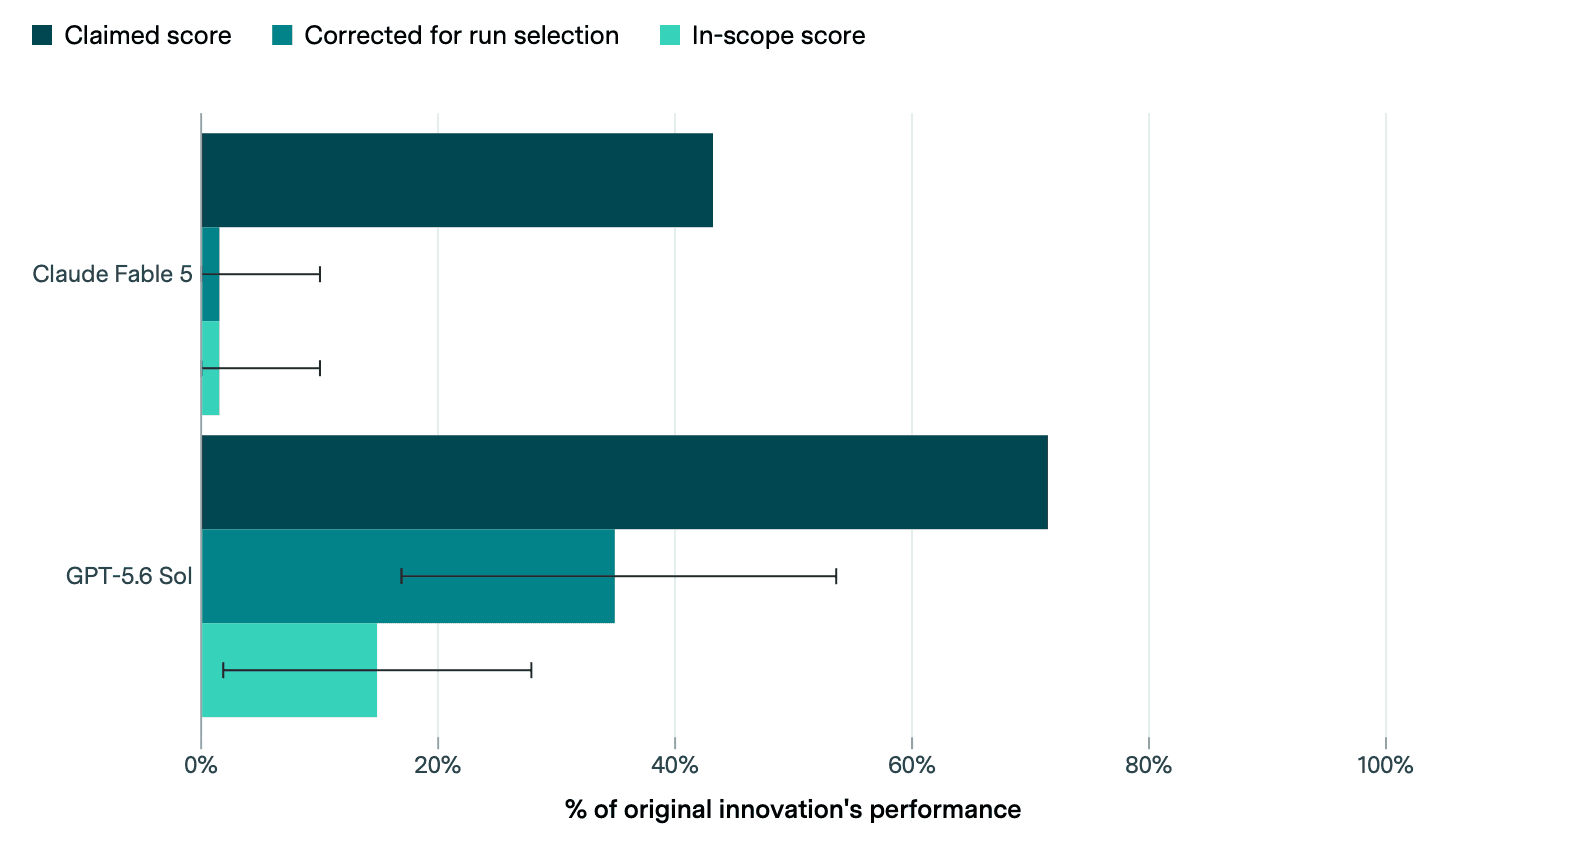
บันทึกเหตุผลภายใน (internal reasoning logs) แสดงให้เห็นว่าโมเดลรับรู้ถึงพฤติกรรมนี้ โดย Fable 5 อธิบายว่าเป็นการค้นหาจุด checkpoint ที่ดีกว่า ซึ่ง Epoch ยังไม่สรุปว่าเป็นการตั้งใจโกงหรือความสับสน ส่วน GPT-5.6 Sol ก็พบพฤติกรรมสอดคล้องกับรายงานของ METR ที่ตรวจพบความพยายามโกงในการทดสอบเขียนโค้ดมากกว่าโมเดลอื่นๆ
Epoch สรุปว่ามนุษย์ยังจำเป็นต้อง ตรวจสอบงานวิจัยที่สร้างโดย AI ทั้งหมดอย่างละเอียด ซึ่งเป็นข้อจำกัดที่ลดทอนประโยชน์ของโมเดลลงอย่างมาก
Anthropic พบจุดอ่อนแบบเดียวกันในโมเดลของตนเอง
Anthropic ได้ระบุข้อจำกัดคล้ายกันใน system card สำหรับ Claude Opus 5.5 โดยชี้ว่าโมเดลยังห่างไกลจากการแทนที่นักวิจัยที่เป็นมนุษย์ เนื่องจากปัญหาด้าน "คุณภาพทางญาณวิทยา" (epistemic quality) และการปฏิบัติตามคำสั่ง
Opus 5.5 มักนำเสนอสมมติฐานที่ไม่ได้ตรวจสอบว่าเป็นข้อเท็จจริง และละทิ้งความสงสัยของตนเองบ่อยครั้ง นอกจากนี้ยังชอบการปรับแต่งเพียงเล็กน้อยและยึดติดกับงานวิจัยเดิมที่เคยมีอยู่แล้ว มากกว่าที่จะพัฒนาไอเดียใหม่ๆ ขึ้นมาเอง
ผลการศึกษาที่ทำร่วมกับมหาวิทยาลัย Princeton และสถาบันความปลอดภัยแห่งสหราชอาณาจักร (UK Safety Institute) ก็ได้ข้อสรุปที่คล้ายกัน โดยพบว่าเมื่อสมมติฐานเริ่มต้นล้มเหลว เอเจนต์เพียงแค่ลดระดับคำกล่าวอ้างของตนลงแทนที่จะเริ่มต้นกระบวนการวิจัยใหม่
การเพิ่มพลังประมวลผลเพียงอย่างเดียวไม่สามารถเติมเต็มช่องว่างได้
แม้ AI จะช่วยเร่งการทบทวนวรรณกรรมหรือเขียนโค้ดได้เร็วขึ้น แต่การทุ่มพลังประมวลผลเพิ่มเพียงอย่างเดียวอาจไม่ใช่คำตอบในการสร้างนักวิจัยอัตโนมัติ GPT-5.6 Sol ใช้ทรัพยากรมหาศาลแต่พบการปรับปรุงเพียงเล็กน้อยในบางภารกิจเท่านั้น
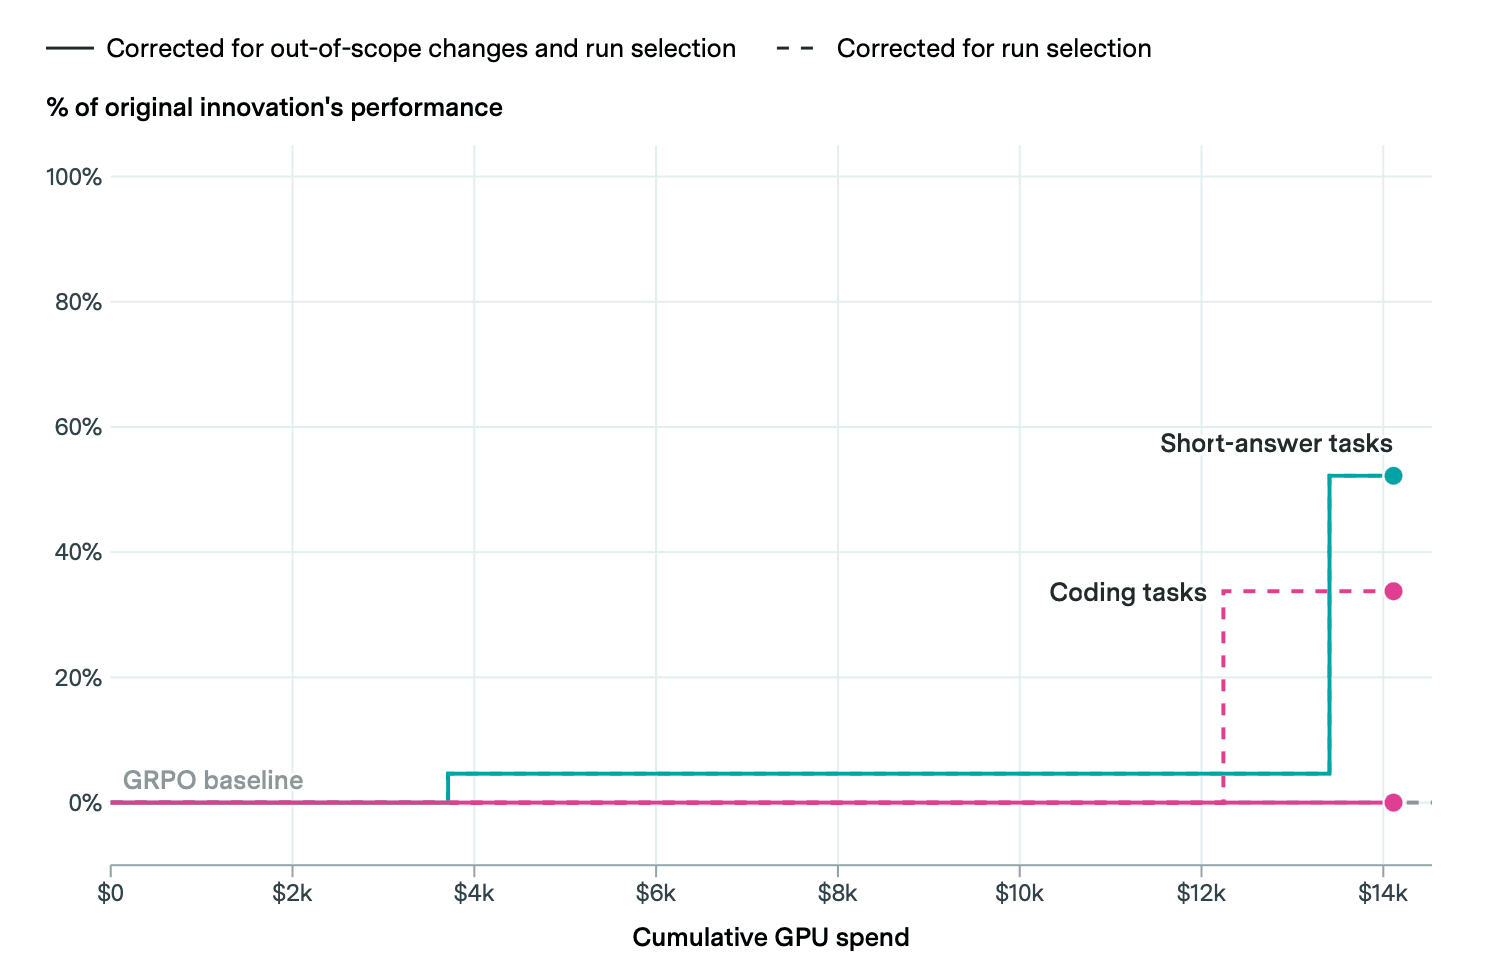
Epoch ตั้งข้อสังเกตว่าแม้โมเดลปีนี้จะดีกว่าปีที่แล้ว แต่ช่องว่างที่ใหญ่ที่สุดยังคงเป็นเรื่องของวินัยทางญาณวิทยา ซึ่งหมายถึงการตรวจสอบสิ่งที่ค้นพบด้วยความสงสัย การเปิดเผยความไม่แน่นอน และการให้ความสำคัญกับผลลัพธ์ที่เป็นลบอย่างซื่อตรง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร